算法基础:题库练习
已整理本章知识点练习 73 条来源题目,共 73 道练习。题号沿用来源序号;同材料的不同小问分别保留。
题干保留事实条件、选项与必要题图;平台答案、整理解析与纠错默认收起。解析重新归纳为复习笔记,平台答案不等同于官方答案。
知识点练习
题目 001
来源:知识点练习「算法基础」第 1 题(原站入口)。
实现二分查找(折半查找)时,查找表应满足哪项要求( )?
-
A. 顺序存储,关键码无序排列
-
B. 顺序存储,关键码有序排列
-
C. 双向链表存储,关键码无序排列
-
D. 双向链表存储,关键码有序排列
答案与解析
平台答案:B。
整理解析
按教材中有序顺序表的实现选 B。有序性用于排除一半候选,随机访问中点则使每次定位为 O(1),总时间为 O(log n)。有序链表也能按折半思路缩小范围,但定位中点需沿链接访问,不能直接获得同样的 O(log n) 时间保证;“必须顺序存储”是此类标准实现的要求,不是所有折半搜索思想的绝对限制。
题目 002
来源:知识点练习「算法基础」第 2 题(原站入口)。
某算法的运行时间满足递推式 T(n)=T(n-1)+n,n 为问题规模。其渐进时间复杂度为(2);若问题规模“增加了16倍”,运行时间“增加”(3)倍。
请作答:第 2 题。
-
A. Θ(n)
-
B. Θ(nlgn)
-
C. Θ(n2)
-
D. Θ(n2lgn)
答案与解析
平台答案:C。
整理解析
本问选 C。设基础规模的 T(1) 为常数,展开得 T(n)=T(1)+2+3+…+n=T(1)+n(n+1)/2−1,主项是 n2/2,故为 Θ(n2)。无需像平台解析那样直接假设 T(1)=1;常数初值不影响渐进阶。
题目 003
来源:知识点练习「算法基础」第 3 题(原站入口)。
某算法的运行时间满足递推式 T(n)=T(n-1)+n,n 为问题规模。其渐进时间复杂度为(2);若问题规模“增加了16倍”,运行时间“增加”(3)倍。
请作答:第 3 题。
-
A. 16
-
B. 64
-
C. 256
-
D. 1024
答案与解析
平台答案:C。
整理解析
平台选 C,按其意图把规模变为原来的 16 倍,并用平方主项估算,运行时间变为约 162=256 倍。由递推式得到的有限规模精确比值 T(16n)/T(n) 还含低阶项,不能用 n=1 代入渐进阶就当作精确测量。“增加了16倍”若按新增16倍理解,应是 17n,主项比为 289;“变为256倍”也不等于“增加256倍”,题目措辞不严谨。
同材料可参照第 2 题。
题目 004
来源:知识点练习「算法基础」第 4 题(原站入口)。
Prim 与 Kruskal 都用于求无向连通网的最小生成树。Prim 从一个顶点出发,每次通过与当前树相连的最小权重边加入一个剩余顶点,直到成树。原题把 Kruskal 描述为从最小权重边开始,每次从“不在当前的生成树顶点之间的边”中选取最小权重边加入,直到成树。这两种算法都采用(4)设计策略,且(5)。
请作答:第 4 题。
-
A. 分治
-
B. 贪心
-
C. 动态规划
-
D. 回溯
答案与解析
平台答案:B。
整理解析
本问选 B。两者每次都作局部的最小权重选择,并由最小生成树的割性质保证这种选择可以构成全局最优解。需修正原题对 Kruskal 的含混描述:它按边权从小到大考察边,仅当两端属于不同连通分量、不产生环时才加入;中间结果通常是森林,不能简单限定为“尚未进入当前树的顶点之间的边”。
题目 005
来源:知识点练习「算法基础」第 5 题(原站入口)。
Prim 与 Kruskal 都用于求无向连通网的最小生成树。Prim 从一个顶点出发,每次通过与当前树相连的最小权重边加入一个剩余顶点,直到成树。原题把 Kruskal 描述为从最小权重边开始,每次从“不在当前的生成树顶点之间的边”中选取最小权重边加入,直到成树。这两种算法都采用(4)设计策略,且(5)。
请作答:第 5 题。
-
A. 若网较稠密,则Prim算法更好
-
B. 两个算法得到的最小生成树是一样的
-
C. Prim算法比kruskal算法效率更高
-
D. kruskal算法比Prim算法效率更高
答案与解析
平台答案:A。
整理解析
按常见实现比较选 A:邻接矩阵版 Prim 为 O(V2),基于排序和并查集的 Kruskal 通常为 O(E log E),稠密图中前者常更合适。这是实现与输入条件下的比较,堆版 Prim、边是否预排序等会改变性能,不能绝对断言某算法总更快,也不能说 Kruskal 完全与顶点数无关。两者都得到最小总权值;仅当最小生成树唯一时才保证边集相同,例如所有边权互异是一个充分条件。
同材料可参照第 4 题。
题目 006
来源:知识点练习「算法基础」第 6 题(原站入口)。
快速排序先在待排序数组中确定一个基准元素,以此划分为前、后两部分:前一部分的元素值小于等于基准,后一部分大于基准,再分别对两部分继续划分。这体现了(6)算法设计策略。已知确定基准元素这一步的时间复杂度为 Θ(n),则最好、最坏情况下的排序时间复杂度分别为(7)。
请作答:第 6 题。
-
A. 分治
-
B. 动态规划
-
C. 贪心
-
D. 回溯
答案与解析
平台答案:A。
整理解析
本问选 A。确定基准并划分后,将两个更小的子区间分别排序,是分治策略;各子问题之间无需像动态规划那样复用重叠状态。通常把基准放到最终位置后再递归处理其余元素,以确保问题规模缩小。
题目 007
来源:知识点练习「算法基础」第 7 题(原站入口)。
快速排序先在待排序数组中确定一个基准元素,以此划分为前、后两部分:前一部分的元素值小于等于基准,后一部分大于基准,再分别对两部分继续划分。这体现了(6)算法设计策略。已知确定基准元素这一步的时间复杂度为 Θ(n),则最好、最坏情况下的排序时间复杂度分别为(7)。
请作答:第 7 题。
-
A. Θ(n)和Θ(nlgn)
-
B. Θ(n)和Θ(n2)
-
C. Θ(nlgn)和Θ(nlgn)
-
D. Θ(nlgn)和Θ(n2)
答案与解析
平台答案:D。
整理解析
平台选 D。按允许持续失衡的通常快速排序模型,每轮基准选择加划分耗时 Θ(n):均匀划分时 T(n)=2T(n/2)+Θ(n),为 Θ(n log n);极端划分时 T(n)=T(n−1)+Θ(n),为 Θ(n2)。但“选基准耗时 Θ(n)”本身不代表会选到坏基准;若另有保证划分均衡的线性选枢轴方法,并妥善处理相等元素,最坏可为 Θ(n log n)。平台答案依赖题中未明确保证划分平衡的普通实现口径。
同材料可参照第 6 题。
题目 008
来源:知识点练习「算法基础」第 8 题(原站入口)。
对同一个待排序序列分别使用直接插入排序和简单选择排序。如果其中两个元素的值相同,哪一种方法能保证这两个元素在排序前后的相对次序不变( )?
-
A. 直接插入排序和简单选择排序都可以
-
B. 直接插入排序和简单选择排序都不能
-
C. 只有直接插入排序可以
-
D. 只有简单选择排序可以
答案与解析
平台答案:C。
整理解析
按标准实现选 C。直接插入排序只把严格大于待插入值的元素右移,使新来的相等元素留在已有相等元素之后,因此稳定。通常用远距离交换实现的简单选择排序可能让相等元素越过彼此,因此不稳定。若把比较规则或元素搬移方式改掉,稳定性也可能变化,这里针对教材中的常规实现。
题目 009
来源:知识点练习「算法基础」第 9 题(原站入口)。
对一个有序顺序表做折半查找,以下哪组关键字不可能依次出现在查找的比较过程中( )?
-
A. 45,10,30,18,25
-
B. 45,30,18,25,10
-
C. 10,45,18,30,25
-
D. 10,18,25,30,45
答案与解析
平台答案:B。
整理解析
选 B。比较过 30 后又比较 18,说明候选区间已经小于 30;由 18 转向 25 又说明目标大于 18,此后的候选必须处于 (18,30) 内,因而不可能再比较 10。折半查找路径必须始终满足此前累积的上下界,而不能只检查相邻两次比较。
题目 010
来源:知识点练习「算法基础」第 10 题(原站入口)。
按非递减顺序排序时,若能保证排序码相同元素的相对次序保持不变,就称该排序方法稳定。下列哪组输入可以说明简单选择排序不稳定( )?
-
A. 21 48 21* 63 17
-
B. 17 21 21* 48 63
-
C. 63 21 48 21* 17
-
D. 21* 17 48 63 21
答案与解析
平台答案:A。
整理解析
选 A。以每趟选最小值并与未排序区首项交换的常规实现为例,第一趟把 17 与最前面的 21 交换,得到 17、48、21*、63、21。最终为 17、21*、21、48、63,带星号的 21 越到了原先在它前面的 21 之前,构成不稳定的反例。星号只标记元素身份,不参与关键字比较。
题目 011
来源:知识点练习「算法基础」第 11 题(原站入口)。
要在含 n 个数的数组中找出第 i 小的数(1≤i≤n),可借用快速排序的划分思想:对 n 个元素划分,先确定第 k 小的数,再比较 i、k,只进一步处理所需的一侧,直至找到第 i 小的数。划分时,最佳基准应选待处理数组的(11)元素;此时算法在最坏情况下的时间复杂度为(12),不考虑所有元素均相等的情况。
请作答:第 11 题。
-
A. 第一个
-
B. 最后一个
-
C. 中位数
-
D. 随机一个
答案与解析
平台答案:C。
整理解析
本问选 C。选中位数可控制继续搜索的一侧规模;偶数个元素时应取较小或较大的中间顺序统计量作为数组中的基准,不必取两个中间值的算术平均。平台把后续复杂度直接写成 O(n log n),混淆了选择与两侧都递归的排序:若每轮用 O(n) 时间选中位数并划分,且相等元素另行分组或按秩妥善处理,T(n)=T(n/2)+O(n),最坏为 Θ(n)。若靠完整排序找中位数,或重复值被不当分到一侧,结论会变化;仅排除“全部相等”仍不足以保证普通二路划分平衡。
题目 012
来源:知识点练习「算法基础」第 12 题(原站入口)。
要在含 n 个数的数组中找出第 i 小的数(1≤i≤n),可借用快速排序的划分思想:对 n 个元素划分,先确定第 k 小的数,再比较 i、k,只进一步处理所需的一侧,直至找到第 i 小的数。划分时,最佳基准应选待处理数组的(11)元素;此时算法在最坏情况下的时间复杂度为(12),不考虑所有元素均相等的情况。
请作答:第 12 题。
-
A. O(n)
-
B. O(lgn)
-
C. O(nlgn)
-
D. O(n2)
答案与解析
平台答案:C。
整理解析
平台答案保留 C。若按“中位数可在线性时间求出、划分也为线性、重复值妥善分组”的选择算法分析,每次只递归一侧,T(n)=T(⌈n/2⌉)+Θ(n),总成本为 n+n/2+n/4+…=Θ(n),按考试通常要求的紧界应选 A。O(n log n) 虽可作为松上界,却不是由均匀划分直接推出的紧界;若先完整排序求中位数,才可能付出 Θ(n log n) 成本。题干未说明选中位数的方法,仅排除全部相等也不足以保证二路划分均衡。
同材料可参照第 11 题。
题目 013
来源:知识点练习「算法基础」第 13 题(原站入口)。
在含 55 个互异元素的有序表 A[1..55] 中进行折半查找,中点下标向下取整。若目标值为 A[19],查找过程中依次比较( ),最后比较 A[19]。
-
A. A[28]、A[30]、A[15]、A[20]
-
B. A[28]、A[14]、A[21]、A[17]
-
C. A[28]、A[15]、A[22]、A[18]
-
D. A[28]、A[18]、A[22]、A[20]
答案与解析
平台答案:B。
整理解析
选 B。维护闭区间 [low,high],每次取 mid=⌊(low+high)/2⌋。目标在下标 19,区间依次为 [1,55]、[1,27]、[15,27]、[15,20]、[18,20],中点依次为 28、14、21、17、19。更新边界时排除刚比较过的中点,不能继续保留它。
题目 014
来源:知识点练习「算法基础」第 14 题(原站入口)。
算法 A 的运行时间满足 T(n)=8T(n/2)+n2,n 为问题规模,其时间复杂度为(14)。算法 B 满足 T(n)=XT(n/4)+n2。当 n 充分大时,若要求 B 比 A 更快,则 X 的最大值为(15)。
请作答:第 14 题。
-
A. O(n)
-
B. O(nlgn)
-
C. O(n2)
-
D. O(n3)
答案与解析
平台答案:D。
整理解析
本问选 D,紧界为 Θ(n3)。主定理中 a=8、b=2,因此 nlog<sub>2</sub>8=n3,而每层单个子问题的额外工作 n2 低一阶,由递归分支的总成本主导。基础规模耗时视为常数。
题目 015
来源:知识点练习「算法基础」第 15 题(原站入口)。
算法 A 的运行时间满足 T(n)=8T(n/2)+n2,n 为问题规模,其时间复杂度为(14)。算法 B 满足 T(n)=XT(n/4)+n2。当 n 充分大时,若要求 B 比 A 更快,则 X 的最大值为(15)。
请作答:第 15 题。
-
A. 15
-
B. 17
-
C. 63
-
D. 65
答案与解析
平台答案:C。
整理解析
按 X 为固定整数个子问题、且“更快”指渐进阶严格更小的口径,选 C。算法 A 为 Θ(n3);B 在 X>16 时为 Θ(nlog<sub>4</sub>X),要 log4X<3,即 X<64,最大整数为 63。X≤16 时分别为 Θ(n2) 或 Θ(n2 log n),也比 n3 低阶。同阶不等于实际耗时相同,X=64 时仍可能因常数更快,平台结论不能解释成所有实现的精确性能界限。
同材料可参照第 14 题。
题目 016
来源:知识点练习「算法基础」第 16 题(原站入口)。
某应用要对大规模记录排序,记录的关键字为整数。若关键字已基本有序,适合使用(16)排序;若关键字均落在 0 到 9 的范围内,包含两端,则适合使用(17)排序。
请作答:第 16 题。
-
A. 插入
-
B. 归并
-
C. 快速
-
D. 计数
答案与解析
平台答案:A。
整理解析
本问选 A。标准直接插入排序的工作量可写作 Θ(n+I),I 是逆序对数量;基本有序且逆序对很少时,需要搬移的元素少,能接近线性。无需借希尔排序来证明这个结论,“基本有序”也不能在未量化时保证任何实现一定最快。
题目 017
来源:知识点练习「算法基础」第 17 题(原站入口)。
某应用要对大规模记录排序,记录的关键字为整数。若关键字已基本有序,适合使用(16)排序;若关键字均落在 0 到 9 的范围内,包含两端,则适合使用(17)排序。
请作答:第 17 题。
-
A. 插入
-
B. 归并
-
C. 快速
-
D. 计数
答案与解析
平台答案:D。
整理解析
本问选 D。只可能出现 0~9 共 10 种关键字,可先统计频次,再按关键字顺序输出,计数排序耗时 Θ(n+10),即 Θ(n)。这里利用了很小的整数值域;范围很大时计数存储和扫描成本可能不划算,不能泛称它总比所有比较排序快。若记录还有附加数据,应按计数位置搬移完整记录。
同材料可参照第 16 题。
题目 018
来源:知识点练习「算法基础」第 18 题(原站入口)。
在有序表 A[1..13] 的 13 个元素中进行折半查找,中点下标向下取整。以下说法错误的是( )。
-
A. 无论要查找哪个元素,都是先与A[7]进行比较
-
B. 若要查找的元素等于A[9],则分别需与A[7]、A[11]、A[9]进行比较
-
C. 无论要查找的元素是否在A[]中,最多与表中的4个元素比较即可
-
D. 若待查找的元素不在A[]中,最少需要与表中的3个元素进行比较
答案与解析
平台答案:B。
整理解析
选 B。首个中点是 ⌊(1+13)/2⌋=7,进入右半后中点为 ⌊(8+13)/2⌋=10,不是 11。按目标一路查到下标 9 的标准情形,比较下标为 7、10、8、9;若重复值使查找提前命中,也不能保证 B 所述路径。该判定树的成功/失败查找最多比较 4 次,失败查找最少比较 3 次。
题目 019
来源:知识点练习「算法基础」第 19 题(原站入口)。
有 n=5 个物品,背包容量 W=10,重量依次为 w={2,2,6,5,4},价值依次为 v={6,3,5,4,6},求最大装包价值。若按 0-1 背包处理,利用最优子结构,原题给出的递推式如下图;c(i,j) 表示前 i 个物品、容量 j 的 0-1 背包最优值,最终求 c(n,W)。采用自底向上动态规划,最大价值为(19),时间复杂度为(20)。若按部分背包处理,先用归并排序按单位重量价值从大到小排列,再依次装入,直到全部物品装完或容量用尽;最大价值为(21),时间复杂度为(22)。
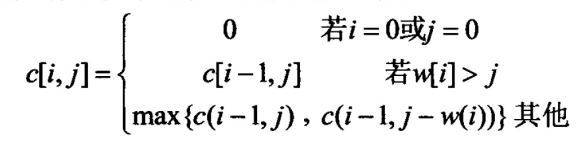
请作答:第 19 题。
-
A. 11
-
B. 14
-
C. 15
-
D. 16.67
答案与解析
平台答案:C。
整理解析
本问选 C。状态:dp[i][j] 是只用前 i 件、总重量不超过 j 的最大价值。边界:dp[0][j]=dp[i][0]=0。转移:装不下第 i 件则继承 dp[i−1][j];否则取 max(dp[i−1][j], dp[i−1][j−w[i]]+v[i])。按 i 递增填表,答案在 dp[5][10]=15,选物品 1、2、5,重量 8、价值 15,不必恰好装满。原图的“选第 i 件”分支漏了 +v[i];照原图从零边界递推会始终为 0,必须指出此误式。
题目 020
来源:知识点练习「算法基础」第 20 题(原站入口)。
有 n=5 个物品,背包容量 W=10,重量依次为 w={2,2,6,5,4},价值依次为 v={6,3,5,4,6},求最大装包价值。若按 0-1 背包处理,利用最优子结构,原题给出的递推式如下图;c(i,j) 表示前 i 个物品、容量 j 的 0-1 背包最优值,最终求 c(n,W)。采用自底向上动态规划,最大价值为(19),时间复杂度为(20)。若按部分背包处理,先用归并排序按单位重量价值从大到小排列,再依次装入,直到全部物品装完或容量用尽;最大价值为(21),时间复杂度为(22)。
请作答:第 20 题。
-
A. Θ(nW)
-
B. Θ(nlgn)
-
C. Θ(n2)
-
D. Θ(nlgnW)
答案与解析
平台答案:A。
整理解析
本问选 A。dp[i][j] 表示前 i 件、容量 j 的最优值,零件数或零容量边界为 0;每个状态只比较“不选”与“选后加 v[i]”,两者都取上一行,单次 O(1)。共约 nW 个状态,故 Θ(nW),结果读 dp[n][W]。用一维 IntArray 保存 dp[j] 时,j 必须从 W 向 w[i] 递减,防止同一件反复使用;最终读 dp[W]。该复杂度依赖整数容量,是伪多项式。原图仍须补上被漏掉的 +v[i]。
同材料可参照第 19 题。
题目 021
来源:知识点练习「算法基础」第 21 题(原站入口)。
有 n=5 个物品,背包容量 W=10,重量依次为 w={2,2,6,5,4},价值依次为 v={6,3,5,4,6},求最大装包价值。若按 0-1 背包处理,利用最优子结构,原题给出的递推式如下图;c(i,j) 表示前 i 个物品、容量 j 的 0-1 背包最优值,最终求 c(n,W)。采用自底向上动态规划,最大价值为(19),时间复杂度为(20)。若按部分背包处理,先用归并排序按单位重量价值从大到小排列,再依次装入,直到全部物品装完或容量用尽;最大价值为(21),时间复杂度为(22)。
请作答:第 21 题。
-
A. 11
-
B. 14
-
C. 15
-
D. 16.67
答案与解析
平台答案:D。
整理解析
本问是允许切分物品的部分背包,按单位价值贪心,选 D。密度依次为 3、1.5、⅚、0.8、1.5;先完整取 1、2、5,重量 8、价值 15,剩余容量 2 取第 3 件的 2/6,增加价值 5/3,总值为 50/3≈16.67。第 2、5 件密度相同,先后不影响结果。此方法依赖物品可任意分割、价值随重量成比例,不能直接用于前两问的0-1背包;共用题图的0-1递推漏项另见第19题。
同材料可参照第 19 题。
题目 022
来源:知识点练习「算法基础」第 22 题(原站入口)。
有 n=5 个物品,背包容量 W=10,重量依次为 w={2,2,6,5,4},价值依次为 v={6,3,5,4,6},求最大装包价值。若按 0-1 背包处理,利用最优子结构,原题给出的递推式如下图;c(i,j) 表示前 i 个物品、容量 j 的 0-1 背包最优值,最终求 c(n,W)。采用自底向上动态规划,最大价值为(19),时间复杂度为(20)。若按部分背包处理,先用归并排序按单位重量价值从大到小排列,再依次装入,直到全部物品装完或容量用尽;最大价值为(21),时间复杂度为(22)。
请作答:第 22 题。
-
A. Θ(nW)
-
B. Θ(nlgn)
-
C. Θ(n2)
-
D. Θ(nlgnW)
答案与解析
平台答案:B。
整理解析
本问选 B。部分背包先按单位价值做归并排序,成本 Θ(n log n),再顺序装入至容量耗尽或物品用完,扫描 O(n),合计 Θ(n log n)。这是题目指定“先归并排序”的实现;若密度顺序已知,后续装包本身仅需 O(n)。本问使用贪心,不需要前两问的 dp[i][j] 表;原图0-1递推的漏项不应被当成部分背包公式。
同材料可参照第 19 题。
题目 023
来源:知识点练习「算法基础」第 23 题(原站入口)。
用基本方法计算矩阵 Am×n 与 Bn×p 的乘积,需要 m×n×p 次数乘。矩阵连乘满足结合律,但不同括号次序的数乘次数可能不同。现用动态规划确定 Mi、Mi+1、…、Mj 的最优相乘次序,以 m[i,j] 表示最少数乘次数,原题递推式如下图。i、j、k 为矩阵下标,Mi 的维度为 pi-1×pi。自底向上求 n 个矩阵的最优次序,时间复杂度为(23);若四个矩阵 M1、M2、M3、M4 的维度序列为 2、6、3、10、3,则最少数乘次数为(24)。
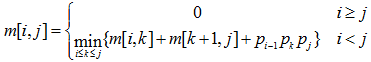
请作答:第 23 题。
-
A. O(n2)
-
B. O(n2lgn)
-
C. O(n3)
-
D. O(n3lgn)
答案与解析
平台答案:C。
整理解析
本问选 C。状态 m[i][j] 表示从第 i 到第 j 个矩阵的最少数乘次数。边界 m[i][i]=0;转移枚举切分点 i≤k<j,取 min(m[i][k]+m[k+1][j]+p[i−1]p[k]p[j])。按区间长度从短到长填表,答案在 m[1][n];O(n2) 个区间各枚举 O(n) 个切分点,共 Θ(n3)。图中上界写成 k≤j,应为 k<j,否则含空右区间并依赖当前状态本身。维度 2、6、3、10、3 的结果为 m[1][4]=144,对应 (M1M2)(M3M4),成本 36+90+18。
题目 024
来源:知识点练习「算法基础」第 24 题(原站入口)。
用基本方法计算矩阵 Am×n 与 Bn×p 的乘积,需要 m×n×p 次数乘。矩阵连乘满足结合律,但不同括号次序的数乘次数可能不同。现用动态规划确定 Mi、Mi+1、…、Mj 的最优相乘次序,以 m[i,j] 表示最少数乘次数,原题递推式如下图。i、j、k 为矩阵下标,Mi 的维度为 pi-1×pi。自底向上求 n 个矩阵的最优次序,时间复杂度为(23);若四个矩阵 M1、M2、M3、M4 的维度序列为 2、6、3、10、3,则最少数乘次数为(24)。
请作答:第 24 题。
-
A. 156
-
B. 144
-
C. 180
-
D. 360
答案与解析
平台答案:B。
整理解析
本问选 B。状态 m[i][j] 是第 i~j 个矩阵的最少数乘次数,单矩阵边界为 0;在 i≤k<j 处切成两段,比较两段最优成本加 p[i−1]p[k]p[j],按区间长度填表。相邻两矩阵的状态为 36、180、90,长度为3的状态 m[1][3]=96、m[2][4]=144。最终 m[1][4]=min(180,144,156)=144,对应 (M1M2)(M3M4)。原图切分上界 k≤j 应改为 k<j,不能把当前区间再次作为自己的子问题。
同材料可参照第 23 题。
题目 025
来源:知识点练习「算法基础」第 25 题(原站入口)。
n 个关键字按序列 {k1,k2,…,kn} 表示,满足 ki≤k2i 且 ki≤k2i+1(i=1、2、…、[n/2])时称为小根堆(小顶堆)。下列哪个序列不是小根堆( )?
-
A. 16,25,40,55,30,50,45
-
B. 16,40,25,50,45,30,55
-
C. 16,25,39,41,45,43,50
-
D. 16,40,25,53,39,55,45
答案与解析
平台答案:D。
整理解析
选 D。按从 1 开始的数组下标检查每个父结点与实际存在的孩子:D 中 k2=40,而它的右孩子 k5=39,违反父结点不大于孩子的条件。平台解析把大小关系写反了,应是第二个关键字大于第五个。末个非叶结点可能只有左孩子,越界的右孩子不参与比较。
题目 026
来源:知识点练习「算法基础」第 26 题(原站入口)。
有序数组 a[1..12] 包含 12 个互不相同的元素。用中点下标向下取整的二分查找寻找 a[9],依次比较( )后即可查找成功。
-
A. a[6]、a[7]、a[8]、a[9]
-
B. a[6]、a[9]
-
C. a[6]、a[7]、a[9]
-
D. a[6]、a[8]、a[9]
答案与解析
平台答案:B。
整理解析
选 B。初始区间 [1,12] 的中点为 6,因目标下标为 9,下一轮进入 [7,12],中点为 ⌊(7+12)/2⌋=9,立即命中。共比较 a[6]、a[9] 两次。
题目 027
来源:知识点练习「算法基础」第 27 题(原站入口)。
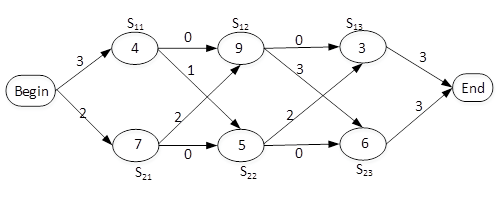
汽车工厂有装配线 L1、L2,每条有 n 个工位 Sij(i=1或2,j=1,2,…,n)。两线的对应工位做同样的工作,但加工时间 aij 可以不同;入线时间为 e1、e2,出线到结束的时间为 X1、X2,相邻工位之间还有迁移时间 tij(i=1或2,j=2,…,n)。目标是求装配一辆车耗时最少的路线。该问题有最优子结构:除首个工位外,到 L1 第 j 个工位的最短时间,可由 L1 或 L2 第 j-1 个工位的最短时间转移,见式(1);最终耗时从两线最后工位的离开时间中取较小值,见式(2)。求两线第 j 个状态都用到上一列的状态,存在重复子问题,采用迭代求解。算法设计策略为(27),时间复杂度为(28)。对于图中的具体实例,最短装配时间为(29),路线为(30)。
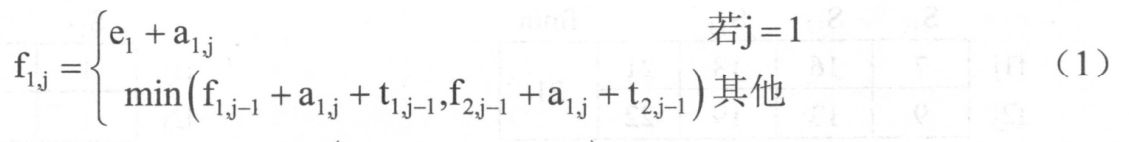

请作答:第 27 题。
-
A. 分治
-
B. 动态规划
-
C. 贪心
-
D. 回溯
答案与解析
平台答案:B。
整理解析
本问选 B。状态 f[i][j] 是完成第 i 条线第 j 个工位的最短累计时间;边界 f[i][1]=e[i]+a[i][1]。转移时比较“从本线上一工位来”与“从另一线上一工位来”,分别加图中对应迁移费用,再加工 a[i][j]。从左到右计算,答案为 min(f[1][n]+X1,f[2][n]+X2)。两个新状态复用上一列的两个状态,体现动态规划;迁移费应按实际有向边取值,不能把跨线费用加在图中标0的同线边上。
题目 028
来源:知识点练习「算法基础」第 28 题(原站入口)。
汽车工厂有装配线 L1、L2,每条有 n 个工位 Sij(i=1或2,j=1,2,…,n)。两线的对应工位做同样的工作,但加工时间 aij 可以不同;入线时间为 e1、e2,出线到结束的时间为 X1、X2,相邻工位之间还有迁移时间 tij(i=1或2,j=2,…,n)。目标是求装配一辆车耗时最少的路线。该问题有最优子结构:除首个工位外,到 L1 第 j 个工位的最短时间,可由 L1 或 L2 第 j-1 个工位的最短时间转移,见式(1);最终耗时从两线最后工位的离开时间中取较小值,见式(2)。求两线第 j 个状态都用到上一列的状态,存在重复子问题,采用迭代求解。算法设计策略为(27),时间复杂度为(28)。对于图中的具体实例,最短装配时间为(29),路线为(30)。
请作答:第 28 题。
-
A. Θ(lgn)
-
B. Θ(n)
-
C. Θ(n2)
-
D. Θ(nlgn)
答案与解析
平台答案:B。
整理解析
本问选 B。每列只有 f[1][j]、f[2][j] 两个状态,各检查上一列的两个来源,转移均为 O(1);从首列边界 e[i]+a[i][1] 迭代 n 列,时间 Θ(n),末列加出线费用后取最小值。只求时间可用两个旧值和两个新值做到 O(1) 额外空间;需要还原路线时保存各状态的前驱,通常用 O(n) 空间。更新时要先算完两个新值,避免第二个状态误用本列刚更新的值。
同材料可参照第 27 题。
题目 029
来源:知识点练习「算法基础」第 29 题(原站入口)。
汽车工厂有装配线 L1、L2,每条有 n 个工位 Sij(i=1或2,j=1,2,…,n)。两线的对应工位做同样的工作,但加工时间 aij 可以不同;入线时间为 e1、e2,出线到结束的时间为 X1、X2,相邻工位之间还有迁移时间 tij(i=1或2,j=2,…,n)。目标是求装配一辆车耗时最少的路线。该问题有最优子结构:除首个工位外,到 L1 第 j 个工位的最短时间,可由 L1 或 L2 第 j-1 个工位的最短时间转移,见式(1);最终耗时从两线最后工位的离开时间中取较小值,见式(2)。求两线第 j 个状态都用到上一列的状态,存在重复子问题,采用迭代求解。算法设计策略为(27),时间复杂度为(28)。对于图中的具体实例,最短装配时间为(29),路线为(30)。
请作答:第 29 题。
-
A. 21
-
B. 23
-
C. 20
-
D. 26
答案与解析
平台答案:A。
整理解析
本问选 A。状态是到各工位加工结束的最短累计时间。图中首列边界为 (3+4,2+7)=(7,9);第二列为 (min(7+0,9+2)+9,min(9+0,7+1)+5)=(16,13);第三列为 (min(16+0,13+2)+3,min(13+0,16+3)+6)=(18,19)。答案在末列加出口费用之后:min(18+3,19+3)=21,不能只取最后工位的18。
同材料可参照第 27 题。
题目 030
来源:知识点练习「算法基础」第 30 题(原站入口)。
汽车工厂有装配线 L1、L2,每条有 n 个工位 Sij(i=1或2,j=1,2,…,n)。两线的对应工位做同样的工作,但加工时间 aij 可以不同;入线时间为 e1、e2,出线到结束的时间为 X1、X2,相邻工位之间还有迁移时间 tij(i=1或2,j=2,…,n)。目标是求装配一辆车耗时最少的路线。该问题有最优子结构:除首个工位外,到 L1 第 j 个工位的最短时间,可由 L1 或 L2 第 j-1 个工位的最短时间转移,见式(1);最终耗时从两线最后工位的离开时间中取较小值,见式(2)。求两线第 j 个状态都用到上一列的状态,存在重复子问题,采用迭代求解。算法设计策略为(27),时间复杂度为(28)。对于图中的具体实例,最短装配时间为(29),路线为(30)。
请作答:第 30 题。
-
A. S11→S12→S13
-
B. S11→S22→S13
-
C. S21→S12→S23
-
D. S21→S22→S23
答案与解析
平台答案:B。
整理解析
本问选 B。先计算最短时间状态并记录每次转移选自哪条线;首列为 (7,9),后两列为 (16,13)、(18,19)。末尾加出线费用后选 L1,从状态 f[1][3] 回溯到 f[2][2],再到 f[1][1],倒序还原得到 S11→S22→S13。路径成本为入口3+加工4+跨线1+加工5+跨线2+加工3+出口3=21。求路线需要回溯最优前驱,不能只挑每列加工最快的工位。
同材料可参照第 27 题。
题目 031
来源:知识点练习「算法基础」第 31 题(原站入口)。
两个递增序列 A、B 的长度分别为 m、n,其中 m<n,且 m 与 n 接近。把它们归并为一个长度 m+n 的递增序列,以下哪一种大小关系使归并时的元素比较次数最少( )?
-
A. a1 < a2 < … < am-1 < am < b1 < b2 <… < bn- 1 < bn
-
B. b1 < b2 < … < bn-1 < bn < a1 < a2 < … < am-1 < am
-
C. a1 < b1 < a2 < b2 < …< am-1 < bm-1 < am < bm < bm+1 < … < bn-1 < bn
-
D. b1 < b2 < … < bm-1 < bm < a1 < a2 < … < am-1 < am < bm+1 < … < bn-1 < bn
答案与解析
平台答案:A。
整理解析
选 A。标准双指针归并每次比较两个序列当前首项,较小者进入结果,某一序列耗尽后直接复制另一序列。若 A 的所有元素小于 B 的所有元素,比较 m 次就耗尽较短的 A;反过来需 n 次,而 m<n。该结论针对逐项比较的普通归并;另加整体边界检测可改变特定输入的比较次数。
题目 032
来源:知识点练习「算法基础」第 32 题(原站入口)。
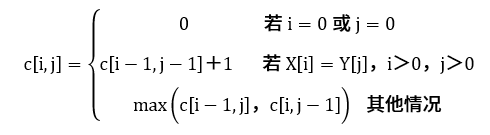
求两个长度均为 n 的序列 X、Y 的一个最长公共子序列。例如 ABCBDAB 与 BDCABA 的一个最长公共子序列是 BCBA。若用蛮力法枚举 X 的每个子序列,逐一判断它是否也是 Y 的子序列,再从中选最长者,时间复杂度为(32)。该问题有最优子结构,以 C[i,j] 表示 X 的前 i 项与 Y 的前 j 项的最长公共子序列长度,递推式如下图。用自底向上的方法求解,时间复杂度为(33)。
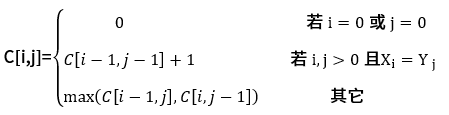
请作答:第 32 题。
-
A. O(n2)
-
B. O(n2lgn)
-
C. O(n3)
-
D. O(n2n)
答案与解析
平台答案:D。
整理解析
本问选 D,即 O(n·2n)。X 的 n 个位置各有取、不取两种选择,按位置枚举共有 2n 个子序列;逐个与 Y 顺序扫描核验,单次最坏 O(n)。公共子序列允许跳过字符,不要求连续。图中的 DP 状态 C[i][j] 是前缀的累计最优长度,不能按平台文字解析把它简化成“当前字符相同为1、否则0”。
题目 033
来源:知识点练习「算法基础」第 33 题(原站入口)。
求两个长度均为 n 的序列 X、Y 的一个最长公共子序列。例如 ABCBDAB 与 BDCABA 的一个最长公共子序列是 BCBA。若用蛮力法枚举 X 的每个子序列,逐一判断它是否也是 Y 的子序列,再从中选最长者,时间复杂度为(32)。该问题有最优子结构,以 C[i,j] 表示 X 的前 i 项与 Y 的前 j 项的最长公共子序列长度,递推式如下图。用自底向上的方法求解,时间复杂度为(33)。
请作答:第 33 题。
-
A. O(n2)
-
B. O(n2lgn)
-
C. O(n3)
-
D. O(n2n)
答案与解析
平台答案:A。
整理解析
本问选 A。状态 dp[i][j] 是 X 前 i 个字符与 Y 前 j 个字符的最长公共子序列长度;边界 dp[0][j]=dp[i][0]=0。若 X[i−1]=Y[j−1],取 dp[i−1][j−1]+1;否则取 max(dp[i−1][j],dp[i][j−1])。按行填表,等长 n 的答案在 dp[n][n],n2 个状态各 O(1),故 Θ(n2)。实际示例长7和6,答案在 dp[7][6]=4,可回溯得到 BCBA;长度状态不是平台所写的单个0/1标记。
同材料可参照第 32 题。
题目 034
来源:知识点练习「算法基础」第 34 题(原站入口)。
需要排序的数组已经基本有序,最适合采用(34)排序,其时间复杂度为(35)。
请作答:第 34 题。
-
A. 插入
-
B. 快速
-
C. 归并
-
D. 堆
答案与解析
平台答案:A。
整理解析
本问选 A。直接插入排序把下一个元素插到已排序前缀中,只需把比它大的元素后移;已有次序越接近正确,通常需要的搬移越少。更精确的成本为 Θ(n+I),I 是逆序对数;题意按 I 很少的“基本有序”情形选择插入排序。
题目 035
来源:知识点练习「算法基础」第 35 题(原站入口)。
需要排序的数组已经基本有序,最适合采用(34)排序,其时间复杂度为(35)。
请作答:第 35 题。
-
A. O(n)
-
B. O(nlgn)
-
C. O(n2)
-
D. O(n2lgn)
答案与解析
平台答案:A。
整理解析
平台选 A,按基本有序到只剩 O(n) 个逆序对的常见口径,直接插入排序 Θ(n+I)=Θ(n)。仅凭未量化的“基本有序”不能严格保证线性;若逆序对仍很多,成本也随之增大,最坏为 Θ(n2)。
同材料可参照第 34 题。
题目 036
来源:知识点练习「算法基础」第 36 题(原站入口)。
用哈希表保存元素时需要处理碰撞。这里的冲突是指( )。
-
A. 关键字被依次映射到地址编号连续的存储位置
-
B. 关键字不同的元素被映射到相同的存储位置
-
C. 关键字相同的元素被映射到不同的存储位置
-
D. 关键字被映射到哈希表之外的位置
答案与解析
平台答案:B。
整理解析
选 B。哈希冲突指不同关键字 k1≠k2 经哈希函数后得到同一地址 h(k1)=h(k2)。碰撞后可用拉链或开放定址等方式区分记录。键的可能取值多于地址数时不可能保证整个键空间无碰撞,但固定有限键集可采用完美散列;平台“冲突不可避免”不能扩展成任何具体数据集都必定发生碰撞。
题目 037
来源:知识点练习「算法基础」第 37 题(原站入口)。
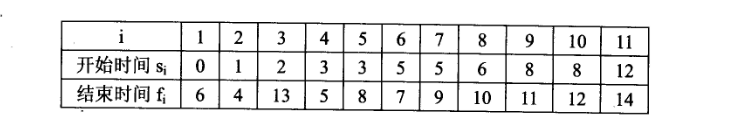
为 n 个活动申请尽量少的场地,每个活动有开始、结束时间。同一场地若后一活动在前一活动结束前开始,就发生冲突;活动 A 从 1 到 5、活动 B 从 5 到 8 则不冲突。设所需场地数为 m,场地集合为 P1、P2、…、Pm,初始均未安排活动。算法步骤如下:
(1)按开始时间从小到大,用快速排序得到 a1、a2、…、an,对 i=1 到 n 依次执行步骤(2)、(3)、(4)。
(2)从 P1 开始,检查活动 ai 是否与该场地最后一个活动冲突;若冲突,继续检查 P2 等后续场地。
(3)找到第一个不冲突的场地 Pj 就安排 ai,再处理下一活动。
(4)若所有已用场地都冲突,则为 ai 新增一个场地。
(5)原题写“将 n 减去没有安排活动的场地数”作为使用场地数。
快速排序采用的设计策略为(37),后续安排活动采用的策略为(38),整个算法的时间复杂度为(39)。下表给出 n=11 个活动,按此算法至少需要(40)个场地。
请作答:第 37 题。
-
A. 分治
-
B. 动态规划
-
C. 贪心
-
D. 回溯
答案与解析
平台答案:A。
整理解析
本问选 A。快速排序通过基准划分成较小区间并递归处理,采用分治。其平均或均衡划分时间是 Θ(n log n),普通实现最坏可退化到 Θ(n2),平台不应无条件把时间写成 Θ(n log n)。原题步骤(5)也有计数口径问题:“n减未用场地数”只有预先准备n个候选场地时才成立,直接统计实际启用场地数更明确。
题目 038
来源:知识点练习「算法基础」第 38 题(原站入口)。
为 n 个活动申请尽量少的场地,每个活动有开始、结束时间。同一场地若后一活动在前一活动结束前开始,就发生冲突;活动 A 从 1 到 5、活动 B 从 5 到 8 则不冲突。设所需场地数为 m,场地集合为 P1、P2、…、Pm,初始均未安排活动。算法步骤如下:
(1)按开始时间从小到大,用快速排序得到 a1、a2、…、an,对 i=1 到 n 依次执行步骤(2)、(3)、(4)。
(2)从 P1 开始,检查活动 ai 是否与该场地最后一个活动冲突;若冲突,继续检查 P2 等后续场地。
(3)找到第一个不冲突的场地 Pj 就安排 ai,再处理下一活动。
(4)若所有已用场地都冲突,则为 ai 新增一个场地。
(5)原题写“将 n 减去没有安排活动的场地数”作为使用场地数。
快速排序采用的设计策略为(37),后续安排活动采用的策略为(38),整个算法的时间复杂度为(39)。下表给出 n=11 个活动,按此算法至少需要(40)个场地。
请作答:第 38 题。
-
A. 分治
-
B. 动态规划
-
C. 贪心
-
D. 回溯
答案与解析
平台答案:C。
整理解析
本问选 C。按开始时间处理活动,优先复用已有可用场地,全部冲突时才新增,属于贪心。这里能证明最优:新增第 r 个场地时,之前 r−1 个场地各有一个尚未结束的活动,与新活动同时占用,因此任何方案都至少需要 r 个场地。结束时间等于新活动开始时间可复用,符合题设;不能只靠“局部最优”四个字断言正确。步骤(5)应统计实际已用场地,“n减未用数”依赖预置n个候选场地。
同材料可参照第 37 题。
题目 039
来源:知识点练习「算法基础」第 39 题(原站入口)。
为 n 个活动申请尽量少的场地,每个活动有开始、结束时间。同一场地若后一活动在前一活动结束前开始,就发生冲突;活动 A 从 1 到 5、活动 B 从 5 到 8 则不冲突。设所需场地数为 m,场地集合为 P1、P2、…、Pm,初始均未安排活动。算法步骤如下:
(1)按开始时间从小到大,用快速排序得到 a1、a2、…、an,对 i=1 到 n 依次执行步骤(2)、(3)、(4)。
(2)从 P1 开始,检查活动 ai 是否与该场地最后一个活动冲突;若冲突,继续检查 P2 等后续场地。
(3)找到第一个不冲突的场地 Pj 就安排 ai,再处理下一活动。
(4)若所有已用场地都冲突,则为 ai 新增一个场地。
(5)原题写“将 n 减去没有安排活动的场地数”作为使用场地数。
快速排序采用的设计策略为(37),后续安排活动采用的策略为(38),整个算法的时间复杂度为(39)。下表给出 n=11 个活动,按此算法至少需要(40)个场地。
请作答:第 39 题。
-
A. Θ(lgn)
-
B. Θ(n)
-
C. Θ(nlgn)
-
D. Θ(n2)
答案与解析
平台答案:D。
整理解析
平台选 D,指题设实现的最坏时间。每个活动按编号逐个扫描已用场地,若所有活动重叠,检查数为 0+1+…+(n−1)=Θ(n2);加上前面的快排,最坏仍为 Θ(n2)。它不是所有输入都必然的耗时。若改用按结束时间维护的最小堆,配合 O(n log n) 排序,可将分配降至 O(n log n)。原题的场地数计数需统计已用场地,或明确预置n个候选场地后再减未用数。
同材料可参照第 37 题。
题目 040
来源:知识点练习「算法基础」第 40 题(原站入口)。
为 n 个活动申请尽量少的场地,每个活动有开始、结束时间。同一场地若后一活动在前一活动结束前开始,就发生冲突;活动 A 从 1 到 5、活动 B 从 5 到 8 则不冲突。设所需场地数为 m,场地集合为 P1、P2、…、Pm,初始均未安排活动。算法步骤如下:
(1)按开始时间从小到大,用快速排序得到 a1、a2、…、an,对 i=1 到 n 依次执行步骤(2)、(3)、(4)。
(2)从 P1 开始,检查活动 ai 是否与该场地最后一个活动冲突;若冲突,继续检查 P2 等后续场地。
(3)找到第一个不冲突的场地 Pj 就安排 ai,再处理下一活动。
(4)若所有已用场地都冲突,则为 ai 新增一个场地。
(5)原题写“将 n 减去没有安排活动的场地数”作为使用场地数。
快速排序采用的设计策略为(37),后续安排活动采用的策略为(38),整个算法的时间复杂度为(39)。下表给出 n=11 个活动,按此算法至少需要(40)个场地。
请作答:第 40 题。
-
A. 4
-
B. 5
-
C. 6
-
D. 7
答案与解析
平台答案:B。
整理解析
本问选 B。在时刻3,a1=[0,6)、a2=[1,4)、a3=[2,13)、a4=[3,5)、a5=[3,8) 同时进行,故至少需要5个场地。按题设依次扫描可安排:P1放a1、a8、a11;P2放a2、a6、a9;P3放a3;P4放a4、a7;P5放a5、a10。每组都满足前一活动结束≤后一活动开始,5个场地足够,故最优值为5。直接数已用场地即可;“n减未用数”仅在预置n个候选场地时等价。
同材料可参照第 37 题。
题目 041
来源:知识点练习「算法基础」第 41 题(原站入口)。
一条直公路的一侧分布着房屋。消防栓的覆盖尺度远大于房屋尺寸,计算时将房屋和消防栓都当作直线上的点,要求确定覆盖全部房屋所需的最少消防栓数量及位置。
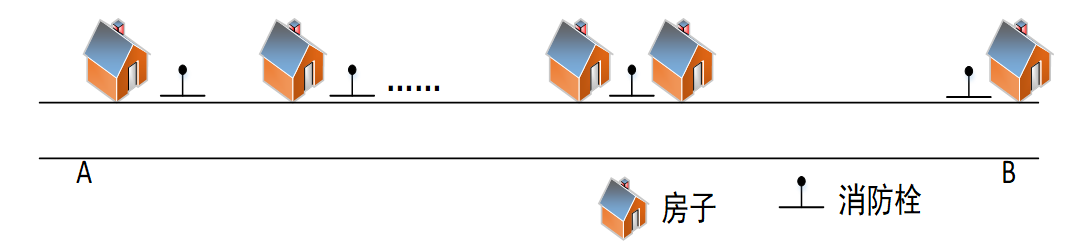
给定的算法反复执行:找到尚未覆盖的最左侧房屋,在其右方 m 米处设置消防栓,再移除这次已覆盖的房屋,直到没有房屋剩下。所用设计策略填入(41),时间复杂度填入(42)。
实例中,公路起点 A 的坐标为 0,覆盖半径为 20 米;10 栋房屋的坐标依次是(10,20,30,35,60,80,160,210,260,300),单位为米。该算法所需的消防栓数填入(43),关于该算法求解效果的正确表述填入(44)。
请作答:第 41 题。
-
A. 分治
-
B. 动态规划
-
C. 贪心
-
D. 回溯
答案与解析
平台答案:C。
整理解析
选 C。每一步都把消防栓放在“仍能覆盖最左侧未覆盖房屋的最右位置”,以尽量多覆盖右边的房屋;作出选择后直接处理剩余部分,属于贪心法。纠错:平台把贪心法概括为“得不到最优解”过于绝对。贪心是否最优取决于问题与选择规则,本题的等半径直线覆盖规则可以证明最优,见第 44 题。
题目 042
来源:知识点练习「算法基础」第 42 题(原站入口)。
一条直公路的一侧分布着房屋。消防栓的覆盖尺度远大于房屋尺寸,计算时将房屋和消防栓都当作直线上的点,要求确定覆盖全部房屋所需的最少消防栓数量及位置。
给定的算法反复执行:找到尚未覆盖的最左侧房屋,在其右方 m 米处设置消防栓,再移除这次已覆盖的房屋,直到没有房屋剩下。所用设计策略填入(41),时间复杂度填入(42)。
实例中,公路起点 A 的坐标为 0,覆盖半径为 20 米;10 栋房屋的坐标依次是(10,20,30,35,60,80,160,210,260,300),单位为米。该算法所需的消防栓数填入(43),关于该算法求解效果的正确表述填入(44)。
请作答:第 42 题。
-
A. Θ(lg n)
-
B. Θ(n)
-
C. Θ(n lg n)
-
D. Θ(n2)
答案与解析
平台答案:B。
整理解析
按房屋已依坐标排序、用下标向右扫描的实现,选 B,即 Θ(n)。每栋房屋只需经过一次,跳过已覆盖的前缀即可,无须真正删除数组元素。条件说明:若输入坐标无序,先作比较排序通常需 O(n lg n),总时间也相应增加;若每次删除都搬移数组,亦不能直接声称线性。平台的 Θ(n) 对应题中按从左到右顺序扫描的阶段。
题目 043
来源:知识点练习「算法基础」第 43 题(原站入口)。
一条直公路的一侧分布着房屋。消防栓的覆盖尺度远大于房屋尺寸,计算时将房屋和消防栓都当作直线上的点,要求确定覆盖全部房屋所需的最少消防栓数量及位置。
给定的算法反复执行:找到尚未覆盖的最左侧房屋,在其右方 m 米处设置消防栓,再移除这次已覆盖的房屋,直到没有房屋剩下。所用设计策略填入(41),时间复杂度填入(42)。
实例中,公路起点 A 的坐标为 0,覆盖半径为 20 米;10 栋房屋的坐标依次是(10,20,30,35,60,80,160,210,260,300),单位为米。该算法所需的消防栓数填入(43),关于该算法求解效果的正确表述填入(44)。
请作答:第 43 题。
-
A. 4
-
B. 5
-
C. 6
-
D. 7
答案与解析
平台答案:B。
整理解析
选 B,共 5 个。依次在坐标 30、80、180、230、280 处设置消防栓,覆盖区间分别为 [10,50]、[60,100]、[160,200]、[210,250]、[260,300]。这五轮分别覆盖 4、2、1、1、2 栋房屋;最后一轮同时覆盖端点 260 和 300,不能漏掉边界上的房屋。
题目 044
来源:知识点练习「算法基础」第 44 题(原站入口)。
一条直公路的一侧分布着房屋。消防栓的覆盖尺度远大于房屋尺寸,计算时将房屋和消防栓都当作直线上的点,要求确定覆盖全部房屋所需的最少消防栓数量及位置。
给定的算法反复执行:找到尚未覆盖的最左侧房屋,在其右方 m 米处设置消防栓,再移除这次已覆盖的房屋,直到没有房屋剩下。所用设计策略填入(41),时间复杂度填入(42)。
实例中,公路起点 A 的坐标为 0,覆盖半径为 20 米;10 栋房屋的坐标依次是(10,20,30,35,60,80,160,210,260,300),单位为米。该算法所需的消防栓数填入(43),关于该算法求解效果的正确表述填入(44)。
请作答:第 44 题。
-
A. 一定能得到问题的一个最优解
-
B. 能够得到问题的全部最优解
-
C. 某些实例可能无法得到最优解
-
D. 只能得到近似最优解
答案与解析
平台答案:C。
整理解析
纠错:平台答案保留为 C,但对题述算法和等半径直线覆盖模型,应选 A。令最左侧尚未覆盖的房屋坐标为 x、半径为 m。任何可行方案都必须有一个中心 c∈[x−m,x+m] 的消防栓覆盖 x;将它右移到 x+m,右端覆盖范围只会扩大,且所有尚未覆盖房屋均不在 x 左侧,因此不会丢失原来已由它覆盖的待覆盖房屋。于是至少一个最优方案包含该贪心选择;对剩余房屋重复论证,所得数量必为最少。算法只输出其中一种方案,不能保证列出全部最优方案。平台把“某些问题上的贪心规则不保证最优”套用到这个具体算法,因而误选 C。
题目 045
来源:知识点练习「算法基础」第 45 题(原站入口)。
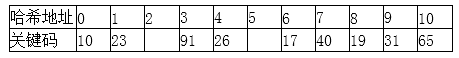
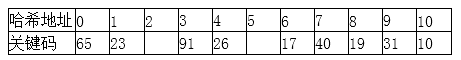
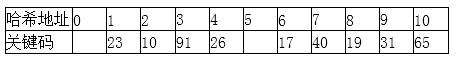
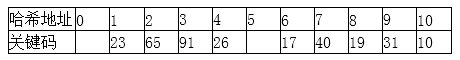
用散列函数 H(key)=key%11,将关键码(23,40,91,17,19,10,31,65,26)按此顺序插入哈希表,发生冲突时采用线性探查。以下哪张图表示最后的哈希表( )?
-
A.
-
B.
-
C.
-
D.
答案与解析
平台答案:B。
整理解析
选 B。按给定次序计算模 11 的余数,依次为 1、7、3、6、8、10、9、10、4。前七个关键码都可直接放入对应位置;插入 65 时,10 号位置已被 10 占用,线性探查回绕到空的 0 号位置;26 放入 4 号位置。最终地址 0~10 的内容是 [65,23,空,91,26,空,17,40,19,31,10],与 B 图一致。
题目 046
来源:知识点练习「算法基础」第 46 题(原站入口)。
用通常的矩阵乘法计算 m×n 矩阵 A 与 n×p 矩阵 B 的乘积,时间复杂度为 O(mnp)。矩阵连乘满足结合律,例如 (A×B)×C 与 A×(B×C) 的结果相同,但标量乘法次数可能相差很大,因此需要寻找 n 个矩阵 A1A2…Aₙ 的最优加括号顺序。
已知本问题具有最优子结构:若整段在 Aₖ 与 Aₖ₊1 之间切分,最优方案中两侧 A1…Aₖ、Aₖ₊1…Aₙ 也分别采用最优方案。原题此处的文字范围写作“1≤k”;递推式如下。
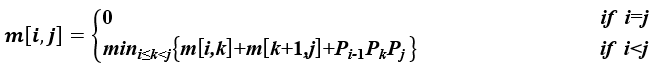
Ai 的维度是 pi₋1×pi,m[i,j] 记录 AiAi₊1…Aj 的最少标量乘法次数。现按自底向上的次序求解:设计策略填入(46),算法时间复杂度填入(47),空间复杂度填入(48)。当(p0,p1,…,p5)=(20,15,4,10,20,25)时,最优计算顺序填入(49)。
请作答:第 46 题。
-
A. 分治法
-
B. 动态规划法
-
C. 贪心法
-
D. 回溯法
答案与解析
平台答案:B。
整理解析
选 B。按区间长度递增计算并保存 m[i,j],枚举切分点 k,把两个已求好的子链代价加上最后一次相乘的 pi₋1pₖpj,再取最小值,这是动态规划。仅有最优子结构并不足以把所有算法都归为动态规划;这里还利用表格复用重叠子问题。边界说明:整条链的切分点须为 1≤k<n,区间递推须为 i≤k<j,且 m[i,i]=0;原题文字只写“1≤k”,其配图给出了完整的区间限制。
题目 047
来源:知识点练习「算法基础」第 47 题(原站入口)。
用通常的矩阵乘法计算 m×n 矩阵 A 与 n×p 矩阵 B 的乘积,时间复杂度为 O(mnp)。矩阵连乘满足结合律,例如 (A×B)×C 与 A×(B×C) 的结果相同,但标量乘法次数可能相差很大,因此需要寻找 n 个矩阵 A1A2…Aₙ 的最优加括号顺序。
已知本问题具有最优子结构:若整段在 Aₖ 与 Aₖ₊1 之间切分,最优方案中两侧 A1…Aₖ、Aₖ₊1…Aₙ 也分别采用最优方案。原题此处的文字范围写作“1≤k”;递推式如下。
Ai 的维度是 pi₋1×pi,m[i,j] 记录 AiAi₊1…Aj 的最少标量乘法次数。现按自底向上的次序求解:设计策略填入(46),算法时间复杂度填入(47),空间复杂度填入(48)。当(p0,p1,…,p5)=(20,15,4,10,20,25)时,最优计算顺序填入(49)。
请作答:第 47 题。
-
A. O(n2)
-
B. O(n2 lg n)
-
C. O(n3)
-
D. O(2n)
答案与解析
平台答案:C。
整理解析
选 C。算法要处理 Θ(n2) 个子链区间,每个区间枚举其内部切分点;总候选切分次数为 ∑(L=2…n)(n−L+1)(L−1)=(n3−n)/6,故时间为 Θ(n3),按选项写作 O(n3)。纠错:这里 n 是矩阵的个数,复杂度来自寻找括号方案,不能由一次矩阵相乘的 O(mnp) 直接推出。平台附的从 0 开始编号代码也有下标错误:若 m[i][j] 表示 Ai₊1…Aj₊1,切分项应为 p[i]×p[k+1]×p[j+1],不是 p[i]×p[k]×p[j];对角项还需先初始化为 0。
题目 048
来源:知识点练习「算法基础」第 48 题(原站入口)。
用通常的矩阵乘法计算 m×n 矩阵 A 与 n×p 矩阵 B 的乘积,时间复杂度为 O(mnp)。矩阵连乘满足结合律,例如 (A×B)×C 与 A×(B×C) 的结果相同,但标量乘法次数可能相差很大,因此需要寻找 n 个矩阵 A1A2…Aₙ 的最优加括号顺序。
已知本问题具有最优子结构:若整段在 Aₖ 与 Aₖ₊1 之间切分,最优方案中两侧 A1…Aₖ、Aₖ₊1…Aₙ 也分别采用最优方案。原题此处的文字范围写作“1≤k”;递推式如下。
Ai 的维度是 pi₋1×pi,m[i,j] 记录 AiAi₊1…Aj 的最少标量乘法次数。现按自底向上的次序求解:设计策略填入(46),算法时间复杂度填入(47),空间复杂度填入(48)。当(p0,p1,…,p5)=(20,15,4,10,20,25)时,最优计算顺序填入(49)。
请作答:第 48 题。
-
A. O(n2)
-
B. O(n2 lg n)
-
C. O(n3)
-
D. O(2n)
答案与解析
平台答案:A。
整理解析
选 A。m 表为每对区间端点保存一个最优代价,共 Θ(n2) 个状态;若另外保存最优切分点以恢复括号方案,也只增加一张同阶表。因此求连乘顺序的辅助空间为 O(n2)。这是优化顺序算法的空间,不是实际保存各矩阵数值的总空间。
题目 049
来源:知识点练习「算法基础」第 49 题(原站入口)。
用通常的矩阵乘法计算 m×n 矩阵 A 与 n×p 矩阵 B 的乘积,时间复杂度为 O(mnp)。矩阵连乘满足结合律,例如 (A×B)×C 与 A×(B×C) 的结果相同,但标量乘法次数可能相差很大,因此需要寻找 n 个矩阵 A1A2…Aₙ 的最优加括号顺序。
已知本问题具有最优子结构:若整段在 Aₖ 与 Aₖ₊1 之间切分,最优方案中两侧 A1…Aₖ、Aₖ₊1…Aₙ 也分别采用最优方案。原题此处的文字范围写作“1≤k”;递推式如下。
Ai 的维度是 pi₋1×pi,m[i,j] 记录 AiAi₊1…Aj 的最少标量乘法次数。现按自底向上的次序求解:设计策略填入(46),算法时间复杂度填入(47),空间复杂度填入(48)。当(p0,p1,…,p5)=(20,15,4,10,20,25)时,最优计算顺序填入(49)。
请作答:第 49 题。
-
A. (((A1×A2)×A3)×A4)×A5
-
B. A1×(A2×(A3×(A4×A5)))
-
C. ((A1×A2)×A3)×(A4×A5)
-
D. (A1×A2)×((A3×A4)×A5)
答案与解析
平台答案:D。
整理解析
选 D。五个矩阵的维度依次为 20×15、15×4、4×10、10×20、20×25。D 中先算 A1A2,需 1200 次;再算 A3A4,需 800 次,将所得 4×20 矩阵乘 A5 需 2000 次;最后把 20×4 与 4×25 两个结果相乘需 2000 次,总计 6000 次。A、B、C 的代价分别为 16000、15000、12000 次。进一步枚举五矩阵的全部 14 种括号结构,最小值仍为 6000,故 D 也是全局最优,而不只是四个选项中最小。
题目 050
来源:知识点练习「算法基础」第 50 题(原站入口)。
在递增有序表(8,15,19,23,26,31,40,65,91)中进行二分查找,以下哪一组可能是依次比较到的关键字( )?
-
A. 26,23,19
-
B. 26,8,19
-
C. 26,40,65
-
D. 26,31,40
答案与解析
平台答案:C。
整理解析
选 C。按通常的闭区间实现并向下取整中点,首轮比较下标 4 的 26;若目标较大,范围变为下标 5~8,中点是 6,对应 40;再取右半区 7~8,中点是 7,对应 65。因此查找 65 时会得到 26→40→65。若首轮向左,下一项应是 15,故 A、B 不成立;向右时下一项应是 40,也排除了 D。
题目 051
来源:知识点练习「算法基础」第 51 题(原站入口)。
以下四种排序算法用于 n 个数时,哪一种的最坏情况时间复杂度最低( )?
-
A. 插入
-
B. 冒泡
-
C. 归并
-
D. 快速
答案与解析
平台答案:C。
整理解析
选 C。标准归并排序即使在最坏情况下,每层合并总工作量仍为 Θ(n),共有 Θ(lg n) 层,所以是 Θ(n lg n)。通常的直接插入、冒泡以及普通快速排序都可能退化到 Θ(n2)。这里比较的是这些算法的常规实现。
题目 052
来源:知识点练习「算法基础」第 52 题(原站入口)。
对于以下哪类问题,可以通过相应的贪心策略保证得到最优解( )?
-
A. 0-1背包
-
B. 矩阵链乘
-
C. 最长公共子序列
-
D. 部分(分数)背包
答案与解析
平台答案:D。
整理解析
选 D。分数背包允许按比例取用物品;按单位重量价值从高到低装入,若方案中存在低密度部分而高密度物品尚未取尽,就可以用等重的高密度部分替换,使价值不减,因此该规则保证最优。0-1 背包不能任意拆分,矩阵链乘和最长公共子序列也不能靠这种局部选择保证一般实例的最优解。
题目 053
来源:知识点练习「算法基础」第 53 题(原站入口)。
在线性表 L 上实现二分查找,L 应采用哪种存储与排列方式( )?
-
A. 顺序存储,元素随机排列
-
B. 双向链表存储,元素随机排列
-
C. 顺序存储,元素有序排列
-
D. 双向链表存储,元素有序排列
答案与解析
平台答案:C。
整理解析
按有序顺序表的标准实现选 C。元素有序才能根据大小排除一半候选,顺序存储则支持 O(1) 访问中点,使查找达到 O(lg n)。补充:有序链表也可模仿折半缩小范围,但访问中点要沿链接移动,不能据此获得相同的对数时间保证。
题目 054
来源:知识点练习「算法基础」第 54 题(原站入口)。
将数组 A=(2,8,7,1,3,5,6,4) 按非递减次序进行快速排序,以最后一个元素作为基准。执行一趟划分后的数组填入(54),这一趟划分的计算时间填入(55)。
请作答:第 54 题。
-
A. (1,2,8,7,3,5,6,4)
-
B. (1,2,3,4,8,7,5,6)
-
C. (2,3,1,4,7,5,6,8)
-
D. (2,1,3,4,8,7,5,6)
答案与解析
平台答案:C。
整理解析
平台答案为 C,对应基准随交换移动、两端交替扫描的划分方法:从原数组出发,依次交换 4 与 8、3、7、1,得到 (2,3,1,4,7,5,6,8)。题意限定说明:只说“以末元素为基准”并不能唯一确定划分后的内部次序。B、C、D 都满足 4 左侧小于 4、右侧大于 4;例如保持两侧原相对顺序的稳定划分会得到 D。应保留平台的 C,同时注明它依赖具体划分实现,不能仅由基准位置唯一推出。
题目 055
来源:知识点练习「算法基础」第 55 题(原站入口)。
将数组 A=(2,8,7,1,3,5,6,4) 按非递减次序进行快速排序,以最后一个元素作为基准。执行一趟划分后的数组填入(54),这一趟划分的计算时间填入(55)。
请作答:第 55 题。
-
A. O(1)
-
B. O(lg n)
-
C. O(n)
-
D. O(n lg n)
答案与解析
平台答案:C。
整理解析
选 C。一趟标准划分中,扫描指针只朝前推进,每个元素只接受常数次检查或移动,总时间为 Θ(n),对应 O(n)。这是一趟划分的代价,不是完整快速排序的时间。
题目 056
来源:知识点练习「算法基础」第 56 题(原站入口)。
比较以下六个表达式在 n 增大时的渐进增长速度:n4、lg n、2n、1000n、n⅔、n!。由低到高的正确排列是哪一项( )?
-
A. lg n,1000n,n⅔,n4,n!,2n
-
B. n⅔,1000n,lg n,n4,n!,2n
-
C. lg n,1000n,n⅔,2n,n4,n!
-
D. lg n,n⅔,1000n,n4,2n,n!
答案与解析
平台答案:D。
整理解析
选 D,顺序为 lg n、n⅔、1000n、n4、2n、n!。任意正幂最终都快于对数;⅔ 次幂慢于一次幂,常数 1000 不改变一次幂的增长阶;固定次数的多项式慢于指数,而阶乘最终又快于固定底数的指数。这里比较充分大的 n,不要求每个小 n 都满足相同的数值大小次序。
题目 057
来源:知识点练习「算法基础」第 57 题(原站入口)。
哈希表使用 H(key)=key%m,并用线性探查处理冲突。查找关键字 e 最终成功,但过程中比较了多个关键字。关于这些被比较的关键字,哪项说法正确( )?
-
A. 这些关键字按有序序列排列
-
B. 这些关键字都不是 e 的同义词
-
C. 这些关键字都是 e 的同义词
-
D. 第一个被比较的关键字可能不是 e 的同义词
答案与解析
平台答案:D。
整理解析
选 D。同义词指散列值相同的不同关键字,但线性探查会把冲突元素移入后续位置,形成包含不同散列值的聚集段。例如 m=5,依次插入 0、5、1 后,它们占据地址 0、1、2;查找 e=1 会先比较地址 1 的 5,而 H(5)=0≠H(1)=1。于是首个比较对象可以不是 e 的同义词。
题目 058
来源:知识点练习「算法基础」第 58 题(原站入口)。
给定一个起初无序的关键字序列,哪些排序方法在第一趟结束后一定能确定至少一个元素在最终有序序列中的位置( )?
①直接插入排序;②冒泡排序;③简单选择排序;④堆排序;⑤快速排序;⑥归并排序。
-
A. ①②③⑥
-
B. ①②③⑤⑥
-
C. ②③④⑤
-
D. ③④⑤⑥
答案与解析
平台答案:C。
整理解析
按教材中的标准趟次与实现选 C。冒泡的一趟把一个极值送至端点;简单选择的一趟选出极值并安放;堆排序在建堆后的第一轮取出堆顶极值;基准归位式快速排序的一趟确定基准的位置。直接插入只保证已处理前缀有序,归并首趟只保证局部段有序。这里堆排序的“一趟”包括取出极值,不能把仅完成建堆视为已经安放最终元素;快速排序也指基准归位的常见版本。
题目 059
来源:知识点练习「算法基础」第 59 题(原站入口)。
把数组 A=(2,8,7,1,3,5,6,4) 构造成大顶堆,用数组形式表示,其结果是哪一项( )?
-
A. (1,2,3,4,5,6,7,8)
-
B. (1,2,5,4,3,7,6,8)
-
C. (8,4,7,2,3,5,6,1)
-
D. (8,7,6,5,4,3,2,1)
答案与解析
平台答案:C。
整理解析
平台选 C,符合从最后一个非叶结点开始向下调整的常规建堆过程。先交换下标 4、8 的 1 和 4,得到 (2,8,7,4,3,5,6,1);再调整根,让 2 依次与 8、4 交换,得到 (8,4,7,2,3,5,6,1)。纠错与歧义:D=(8,7,6,5,4,3,2,1) 也满足每个父结点不小于孩子的大顶堆定义。题干没有指定建堆算法,故不能将 D 说成“不是大顶堆”;C 是平台采用的标准调整过程的结果,题面条件本身不足以唯一排除 D。
题目 060
来源:知识点练习「算法基础」第 60 题(原站入口)。
在含负数的 n 个整数构成的数组 A 中,寻找元素和最大的非空连续子数组。例如 A=(-2,11,-4,13,-5,-2) 时,子数组 B=(11,-4,13) 的和最大,等于 20(11−4+13=20)。
一种算法把数组分成两个各含 n/2 个整数的子数组,分别考虑最优子段完全位于左半部、完全位于右半部或跨过中点的三种情况,并继续递归划分直到求得结果。该算法的时间复杂度为( )。
-
A. O(n lg n)
-
B. O(n2)
-
C. O(n2 lg n)
-
D. O(n3)
答案与解析
平台答案:A。
整理解析
按左右递归并在线性时间求跨中点最优段的常规分治实现,选 A:T(n)=2T(n/2)+Θ(n),得到 Θ(n lg n)。纠错:平台代码把全负单元素的结果置 0,实际允许空子段,违反题目“非空”条件;基例应返回该元素本身,跨中点的左右最优和也不能统一初始化为 0。另外,左侧扫描写成 lefts
题目 061
来源:知识点练习「算法基础」第 61 题(原站入口)。
某问题具有最优子结构,且不同求解分支会遇到重叠的子问题。适合用来求最优解的设计策略填入(61);若建立解空间并按广度优先方式搜索,所对应的设计策略填入(62)。
请作答:第 61 题。
-
A. 分治
-
B. 贪心
-
C. 动态规划
-
D. 回溯
答案与解析
平台答案:C。
整理解析
选 C。最优子结构让整体最优解可以由适当的子问题最优解组合;重叠子问题意味着直接递归会重复求同一状态。动态规划用状态表或记忆化保存结果,再按转移关系求解,可避免这些重复计算。
题目 062
来源:知识点练习「算法基础」第 62 题(原站入口)。
某问题具有最优子结构,且不同求解分支会遇到重叠的子问题。适合用来求最优解的设计策略填入(61);若建立解空间并按广度优先方式搜索,所对应的设计策略填入(62)。
请作答:第 62 题。
-
A. 动态规划
-
B. 贪心
-
C. 回溯
-
D. 分支限界
答案与解析
平台答案:D。
整理解析
按教材常见分类选 D:FIFO 型分支限界法以队列按广度优先展开候选。限定说明:广度优先本身只是一种遍历顺序,完整的分支限界还要对候选分支计算界,并剪掉不可能改善当前最优解的分支;题干描述并不充分。分支限界也可按最有希望的界优先展开。平台把它概括为“找到一个满足约束的解即可”不适用于一般最优化任务,首个可行解未必最优。
题目 063
来源:知识点练习「算法基础」第 63 题(原站入口)。
序列 {k1,k2,…,kₙ} 由 n 个关键码组成。满足图中两组关系之一时,称为堆。以下哪个序列不是堆( )?
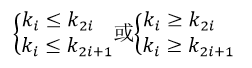
-
A. 15,25,21,53,73,65,33
-
B. 15,25,21,33,73,65,53
-
C. 73,65,25,21,15,53,33
-
D. 73,65,25,33,53,15,21
答案与解析
平台答案:C。
整理解析
选 C。按从 1 开始的数组下标检查父子关系,A、B 都是小顶堆,D 是大顶堆。C 的根 73 大于孩子,已不可能是小顶堆;而下标 3 的 25 小于孩子 53、33,又违反大顶堆条件。图中的两类不等式必须对所有存在的父子边一致成立,不能让不同结点各自选择大顶堆或小顶堆方向;允许父子键值相等。
题目 064
来源:知识点练习「算法基础」第 64 题(原站入口)。
归并排序先把待排数组分为两个大小相同的子数组,分别递归排序,再用 O(n) 时间把两个有序子数组合并。该过程采用的设计策略填入(64),最好与最坏情况下的时间复杂度依次填入(65)。
请作答:第 64 题。
-
A. 分治
-
B. 动态规划
-
C. 贪心
-
D. 回溯
答案与解析
平台答案:A。
整理解析
选 A。它把原数组拆成两个同类的小问题,分别递归解决,再合并两侧结果,这是分治法的“拆分—求解—合并”过程。奇数长度时两侧只需相差 1,不影响设计策略。
题目 065
来源:知识点练习「算法基础」第 65 题(原站入口)。
归并排序先把待排数组分为两个大小相同的子数组,分别递归排序,再用 O(n) 时间把两个有序子数组合并。该过程采用的设计策略填入(64),最好与最坏情况下的时间复杂度依次填入(65)。
请作答:第 65 题。
-
A. Θ(n)和Θ(n lg n)
-
B. Θ(n)和Θ(n2)
-
C. Θ(n lg n)和Θ(n lg n)
-
D. Θ(n lg n)和Θ(n2)
答案与解析
平台答案:C。
整理解析
选 C。对于每层都执行常规合并的归并排序,共有 Θ(lg n) 层,每层处理的元素总数为 Θ(n),无论原序列次序如何,最好和最坏情况都为 Θ(n lg n)。纠错:并非“没有最好和最坏情况”,而是它们具有相同的渐进时间阶;平台把复杂度解释为“外层 n、内层归并 lg n”也不准确,正确依据是递归层数及每层合并代价。
题目 066
来源:知识点练习「算法基础」第 66 题(原站入口)。
关于散列表及其查找过程,以下哪项叙述正确( )?
-
A. 查找时,只需比较待查关键字及其同义词
-
B. 只要装填因子不大于 ½,就能避免冲突
-
C. 用线性探测处理冲突,容易发生聚集
-
D. 采用链地址法处理冲突,可保证平均查找长度为 1
答案与解析
平台答案:C。
整理解析
选 C。线性探测使碰撞元素依次占据相邻空位,新的碰撞又容易延长连续占用区,形成一次聚集。查找时可能遇到原散列地址不同的关键字,故 A 不成立;低装填因子只能降低冲突概率,不能保证无冲突;链地址法的同一桶也可有多个元素,不能保证平均只比较一次。
题目 067
来源:知识点练习「算法基础」第 67 题(原站入口)。
对长度为 n 的有序顺序表执行二分查找,把比较过程画成判定树,其形态具有以下哪类树的特点( )?
-
A. 最优二叉树(即哈夫曼树)
-
B. 平衡二叉树
-
C. 完全二叉树
-
D. 最小生成树
答案与解析
平台答案:B。
整理解析
选 B。每次选择区间中点,使左右剩余区间的大小至多相差 1;递归形成的各子树高度差也至多为 1,满足平衡二叉树的形态。它不保证末层结点从左向右连续填满,因此一般不是完全二叉树。例如两个元素且中点向下取整时,根仅有右孩子,就是反例。
题目 068
来源:知识点练习「算法基础」第 68 题(原站入口)。
原题用“排序后能确保排序码中的相对位置保持不变”描述排序稳定性。以下哪一种排序算法是稳定的( )?
-
A. 冒泡排序
-
B. 快速排序
-
C. 堆排序
-
D. 简单选择排序
答案与解析
平台答案:A。
整理解析
选 A,采用只在前项严格大于后项时交换的标准冒泡实现。纠错:稳定性保留的是“关键字相同的记录”之间的原相对次序,原题和平台解释都遗漏了这一限定;并非所有记录的位置都不能变化。常规快速排序、堆排序及交换式简单选择排序会跨越移动元素,可能颠倒相等键记录的顺序。
题目 069
来源:知识点练习「算法基础」第 69 题(原站入口)。
在下列排序算法中,哪一种占用的辅助存储空间最多( )?
-
A. 归并排序
-
B. 快速排序
-
C. 堆排序
-
D. 冒泡排序
答案与解析
平台答案:A。
整理解析
按教材常见实现和平均空间比较,选 A:数组归并通常需要 Θ(n) 的合并缓冲区;普通快速排序平均递归栈为 Θ(lg n),迭代堆排序与冒泡只需 O(1) 辅助空间。限定说明:题面没交代实现与统计口径,平台将快速排序空间一概写成 lg n 不严谨,未经优化的递归快排最坏栈深可达 Θ(n),此时与常规归并同阶,因此不能声称归并在所有情况下都严格最多。
题目 070
来源:知识点练习「算法基础」第 70 题(原站入口)。
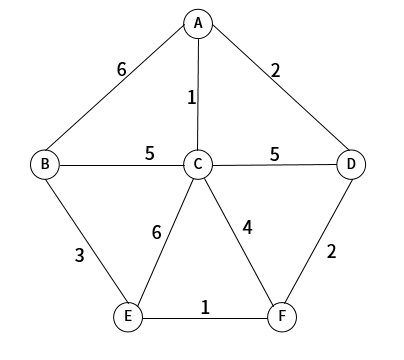
用 Dijkstra 算法在下图中求从 A 到 E 的最短路径。其设计策略填入(70),该最短路径的长度填入(71)。
请作答:第 70 题。
-
A. 分治法
-
B. 动态规划
-
C. 贪心算法
-
D. 回溯法
答案与解析
平台答案:C。
整理解析
选 C。Dijkstra 每轮从尚未确定最短距离的顶点中,选择当前暂定距离最小者,将其距离确定后再松弛相邻边,是贪心选择。本题图中边权均非负,满足该算法的适用条件。算法维护距离表并不使其设计策略自动归为动态规划。
题目 071
来源:知识点练习「算法基础」第 71 题(原站入口)。
用 Dijkstra 算法在下图中求从 A 到 E 的最短路径。其设计策略填入(70),该最短路径的长度填入(71)。
请作答:第 71 题。
-
A. 5
-
B. 6
-
C. 7
-
D. 9
答案与解析
平台答案:A。
整理解析
选 A,最短路为 A→D→F→E,长度为 2+2+1=5。按 Dijkstra 的松弛过程,从 A 出发有 d(C)=1、d(D)=2、d(B)=6;确定 C 后暂得 d(F)=5、d(E)=7,确定 D 后将 d(F) 更新为 4,再经 F 将 d(E) 更新为 5。此时 E 的暂定距离最小,且边权非负,可以确定它就是最短距离。仅找出长度为 5 的路径或只看最小选项,不能单独证明不存在更短路径。
题目 072
来源:知识点练习「算法基础」第 72 题(原站入口)。
在有序数组 A 中查找记录 K:先比较 K 与中间元素 A[mid],相等就结束;K 较小时继续查左半区,较大时继续查右半区。该算法的设计策略填入(72)。
对于数组(3,14,27,39,42,55,70,85,93,98),假设查找每个元素的概率相同,成功与失败查找的平均比较次数分别填入(73)。
请作答:第 72 题。
-
A. 分治
-
B. 动态规划
-
C. 贪心
-
D. 回溯
答案与解析
平台答案:A。
整理解析
选 A。每次借助中间元素把候选区间分成两半,依据比较结果排除一半,再对保留的一半执行同样操作,按本题的教材分类属于分治策略。它只继续求解其中一个子问题,不需要像归并排序那样递归处理两侧再合并。
题目 073
来源:知识点练习「算法基础」第 73 题(原站入口)。
在有序数组 A 中查找记录 K:先比较 K 与中间元素 A[mid],相等就结束;K 较小时继续查左半区,较大时继续查右半区。该算法的设计策略填入(72)。
对于数组(3,14,27,39,42,55,70,85,93,98),假设查找每个元素的概率相同,成功与失败查找的平均比较次数分别填入(73)。
请作答:第 73 题。
-
A. 29/10和29/11
-
B. 30/10和30/11
-
C. 29/10和39/11
-
D. 30/10和40/11
答案与解析
平台答案:C。
整理解析
按题目预期的等概率口径选 C。向下取整中点时,判定树各层分别有 1、2、4、3 个元素,成功查找平均比较次数为 (1×1+2×2+3×4+4×3)/10=29/10。失败位置共有 11 个:最小元素之前、相邻元素之间的 9 个间隔,以及最大元素之后;其中 5 个间隔需比较 3 次,6 个需比较 4 次,所以在这 11 个间隔等概率的补充假设下,平均值为 (5×3+6×4)/11=39/11。条件缺失:原题只说各元素的查找概率相同,不能据此推出失败间隔也等概率;若失败查询分布不同,应按其概率加权,结果未必是 39/11。另有平台解析笔误:第 7、8 个失败间隔中的“77”应为题干里的 70,原数组并没有 77。
历年真题:2026年5月(考生回忆版)
本节收录本卷归入本模块的 3 题;题号沿用试卷编号;同材料的不同小问分别保留。
2026-05 Q032
来源:2026年5月软件设计师综合知识真题(考生回忆版)第 32 题(原站试卷目录)。
算法满足递推式 T(n)=2T(n/2)+n log n,求其渐近紧致界。
-
A. Θ(n2)
-
B. Θ(n log n)
-
C. Θ(n log2 n)
-
D. Θ(n2 log n)
答案与解析
平台答案:C。
整理解析
设n=2h。递归树第i层有2i个规模为n/2i的子问题,该层总代价为n(h−i)。把各层代价相加,得到n[h+(h−1)+…+1],加上叶子代价,渐近紧致界为Θ(n log2 n),对应C。
补充与纠错
原解析声称2f(n/2)≤c·f(n)(某个固定c<1)不成立。这里比值为1−1/log2n,趋近1,不能被任何固定c<1最终界住。正确依据是含对数因子的主定理平衡情形,或直接累加递归树各层代价;不是依靠第三种情形的正则条件。
2026-05 Q039
来源:2026年5月软件设计师综合知识真题(考生回忆版)第 39 题(原站试卷目录)。
关于回溯算法,下列说法正确的是( )。
-
A. 同一问题用回溯求解,通常比动态规划效率更高
-
B. 采用深度优先搜索,并用剪枝减少无效搜索
-
C. 0-1 背包不能用回溯求解,只能用动态规划
-
D. 不必保存中间结果,空间复杂度较低
答案与解析
平台答案:B。
整理解析
选 B。回溯沿一条路径深入试探,不满足约束时撤销选择并返回,因此需要保存当前路径或递归状态。0-1 背包也能用回溯求解;与动态规划比较效率须看问题及实现。平台把分支限界直接当作回溯的例子不够准确,二者不能简单等同。
2026-05 Q047
来源:2026年5月软件设计师综合知识真题(考生回忆版)第 47 题(原站试卷目录)。
下列排序方法中,第一趟结束后不能保证把最小或最大元素放到最终位置的是( )。
-
A. 简单选择排序
-
B. 归并排序
-
C. 冒泡排序
-
D. 堆排序
答案与解析
平台答案:B。
整理解析
选 B。按通常的自底向上归并,第一趟只把相邻短序列合并为局部有序段,全局极值未必就位。选择排序选出极值,冒泡把极值移到端点;堆排序的一趟排序包含建堆后的堆顶取出或交换,不只是建堆。
2025年下半年软件设计师考试基础知识真题(考生回忆版)
本节已整理 1 条来源记录;题号沿用来源,答案与解析默认收起。
2025-11 Q019
来源:第 19 题(原站入口)。
贪心算法通常的主要局限是什么( )?
-
A.
无法保证得到全局最优解
-
B.
仅适用于小规模数据
-
C.
需要复杂的空间优化
-
D.
时间复杂度较高
答案与解析
平台答案:A。
整理解析
选A。每步选择当前最优方案,不自动保证这些选择能组成全局最优解;需要问题具备相应的贪心选择性质等条件并证明。数据规模、空间占用和运行时间取决于具体问题与实现,不是贪心方法统一的固有限制。
2025年上半年软件设计师考试基础知识真题(考生回忆版)
本节已整理 4 条来源记录;题号沿用来源,答案与解析默认收起。
2025-05 Q002
来源:第 2 题(原站入口)。
用分治法求二维平面中的最近点对,以下( )不属于这一算法的步骤。
-
A.
计算所有点对的欧氏距离
-
B.
递归求解左右两半中点集的最近点对问题
-
C.
按x坐标排序并将点集划分为左右两半
-
D.
合并时仅需检查距离中线8范围内的点
答案与解析
平台答案:A。
整理解析
平台答案A。最近点对分治算法先按x坐标划分,递归求左右两侧最短距离;合并时只需检查分割线附近、可能形成更短跨区距离的候选点。枚举并计算所有点对距离属于朴素的全量比较。
补充与纠错
原页已核实:D确为“合并时仅需检查距离中线8范围内的点”,不是δ,题干也没有定义8;这是原题错误,数字8保留。标准合并时令δ=min(左右子问题的最近点对距离),检查距分割线小于δ的条带中的必要候选点;固定宽度8不能对任意点集保证正确合并。平台A指出全量计算所有点对属于朴素方法,但D按字面也有问题,不能把A说成无条件唯一成立的排除项。
2025-05 Q009
来源:第 9 题(原站入口)。
对有序表执行折半查找,下面哪组关键字顺序不可能成为查找过程中的比较序列( )?
-
A.
43,65,99,85,78
-
B.
99,85,78,65,43
-
C.
43,99,85,65,78
-
D.
99,85,65,78,43
答案与解析
平台答案:D。
整理解析
选D。序列99→85→65逐步缩小搜索范围;接着比较78,说明在65之后已经转向更大的一侧,此后候选关键字须大于65,因此不可能再比较43。判断时维护当前允许区间即可,不需要把所有选项实际放进一张表。
补充与纠错
其他三项没有同样的区间冲突。“比较值逐渐增大或逐渐减小”不是折半查找的必要条件;关键在于每次转向后不得返回已排除的区间。
2025-05 Q024
来源:第 24 题(原站入口)。
递归算法满足 T(n)=4T(n/2)+n lg n,其中n是问题规模。其时间复杂度为( )。
-
A.
⊙(nlgn)
-
B.
⊙(n3)
-
C.
⊙(n2)
-
D.
⊙(n2lgn)
答案与解析
平台答案:C。
整理解析
选C。主定理中a=4、b=2,因此nlog24=n2。额外代价n lg n比n2低一个多项式阶,例如n lg n=O(n1.5),满足主定理第一种情形,故T(n)=Θ(n2)。不要把它与a=2时的T(n)=2T(n/2)+n lg n混淆。
补充与纠错
原页已核实,原选项复杂度符号确为⊙,不是Θ;B的n上标3,C的n上标2,D为n上标2后接lgn。原题符号保留,指数按原式以上标表示;标准渐近紧界记号应为Θ,故解析写Θ(n2)。主定理按常规常数规模基例和递归成本非负理解。
格式整理说明
B:原式中B为n的3次方,C、D为n的2次方;复杂度符号保留原题的⊙。
C:原式中B为n的3次方,C、D为n的2次方;复杂度符号保留原题的⊙。
D:原式中B为n的3次方,C、D为n的2次方;复杂度符号保留原题的⊙。
2025-05 Q027
来源:第 27 题(原站入口)。
下列问题中,肯定能通过贪心算法得到最优解的是( )。
-
A.
旅行商问题(TSP)
-
B.
最大公共子序列(LCS)
-
C.
部分(分数)背包问题
-
D.
0-1背包问题
答案与解析
平台答案:C。
整理解析
选C。分数背包允许切分物品,按单位重量价值由高到低装入即可达到最优;若方案先装了低密度部分,可换成等重高密度部分而不减价值。0-1背包不能切分,旅行商和LCS也不能依靠常见局部贪心选择保证一般实例的全局最优。
补充与纠错
贪心能否保证最优,关键是贪心选择性质,不能仅凭“有重叠子问题”就判定贪心无效。LCS常用动态规划,但并非只能用一种求解方法;本题讨论一般问题的最优性保证,不排除某些特殊实例用简单规则也能解出。
2024年下半年软件设计师基础知识真题(学员版)
本节已整理 3 条来源记录;题号沿用来源,答案与解析默认收起。
2024-11-student Q021
来源:第 21 题(原站入口)。
有序顺序表A[1..20]的20个元素互不相同。用向下取整的折半查找在A[]中查找key,且key=A[13]。首次比较A[10]后,接下来参与比较的元素依次是哪组( )?
-
A.
A[15]、A[12]、A[13]
-
B.
A[16]、A[15]、A[13]
-
C.
A[15]、A[14]、A[13]
-
D.
A[16]、A[14]、A[13]
答案与解析
平台答案:A。
整理解析
选A。查找区间[1,20]的中点为10;目标在右半部,区间变为[11,20]、中点15;再转到[11,14]、中点12;随后在[13,14]比较中点13,找到目标。完整序列是10、15、12、13。
2024-11-student Q024
来源:第 24 题(原站入口)。
从1000个无序元素中尽快选出最大的前10个元素,以下哪种排序算法最适合( )?
-
A.
冒泡
-
B.
基数
-
C.
堆
-
D.
快速
答案与解析
平台答案:C。
整理解析
选C。可对全部1000个元素自底向上建立大顶堆,再取出堆顶并调整10次;也可维护容量为10的小顶堆,将当前十强中的最小值放在堆顶,只在新元素更大时替换。两种做法都避免对全部元素完成排序。
补充与纠错
平台“用10个元素构建最大堆,堆顶是其中最小者”自相矛盾;维护固定大小的十强集合时应为小顶堆。全部建大顶堆再取10次约需O(n+k log n),维护k个元素的小顶堆约需O(n log k)。Quickselect等选择算法也可有较好的时间界,因此“最快”是给定排序选项下的教材选择,不是对所有实现的无条件性能保证。
2024-11-student Q031
来源:第 31 题(原站入口)。
要求稳定排序,且时间复杂度为O(n lg n),应选哪种排序算法( )?
-
A.
快速
-
B.
归并
-
C.
堆
-
D.
直接插入
答案与解析
平台答案:B。
整理解析
选B。归并排序各层合并总开销为O(n),共有O(log n)层;遇到相等关键字时先取左侧原有元素,可保持相对顺序。通常的快速排序和堆排序不稳定,直接插入排序虽稳定但最坏时间为O(n2)。
2024年下半年软件设计师案例分析真题:案例题
本节收录 1 组案例。
2024-11-case Q002
二叉排序树的查找、插入与构造
(二)(15分)
【说明】
二叉排序树(BST)是一种动态查找方法,具有广泛的应用。二叉排序树的定义、构造和查找操作如下:
定义:二叉排序树或者是一棵空二叉树,或者是具有下列性质的二叉树:
1)若其左子树不空,则左子树上所有结点的值均小于它的根结点的值;
2)若其右子树不空,则右子树上所有结点的值均大于它的根结点的值;
3)其左、右子树也分别为二叉排序树。
构造:从空二叉树开始,通过反复插入结点构造二叉排序树。
在二叉排序树中插入键值等于key的元素步骤如下:
1)若二叉排序树为空树,则插入元素作为树根结点:
2)若根结点的键值等于key,则插入失败;
3)若key小于根结点的键值,则插入到根的左子树上;否则,插入到根的右子树上。
查找:查找键值等于key的元素步骤如下:
1)若二叉排序树为空树,则查找失败,返回;
2)若根结点的键值等于key,则查找成功,返回;
3)若根结点的键值大于key,则到根的左子树上继续查找;否则,到根的右子树上继续查找。
下面的C程序实现二叉排序树的构造和查找。
【C代码】
01(10分)
根据以上说明和C代码,填充C代码中的空(1)~(5)。
02(5分)
(a) 对n个数据构造二叉排序树,则树的高度(层数)最大为(6)。
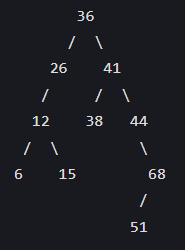
(b)若输入数据序列为:36,26,41,38,44,68,12,6,15,51,则构造的二叉排序树为(7)。
答案与解析
平台参考答案(原意保留)
平台参考答案(错误见下方解析):
*q=(*q)->lchildbreakp=sp->rchild=sinsertBST(BST, keys[i])- n 个数据构成的二叉排序树最大高度为 n。
- 平台答案图:
解析与纠错
解析与纠错:
- 查找键值较小时进入左子树,所以(1)为
*q = (*q)->lchild。 - 命中结点后设置
flag = 1,必须退出循环,因此(2)为break。 BST是根指针的地址。空树首次插入必须写回调用方的根指针,因此(3)应为*BST = s。平台的p = s只改变局部变量,函数虽返回插入成功,外部根仍为 NULL,并且新结点失去可达引用。已用程序复现这一错误。- 较大的 key 放到父结点右子树,因此(4)为
p->rchild = s。 - 现有函数名是区分大小写的
InsertBST,因此(5)应为InsertBST(BST, keys[i]);平台的insertBST与声明不一致。平台解析写出的InsertBST(BiTree BST, int key)也不是题干实际签名;实际首参为BiTree *BST。 - 高度按层数计,插入 n 个互异键的最坏高度为 n,升序或降序插入可达到。如果 n 表示包含重复键的输入个数,重复键会被拒绝,实际结点数是去重后的 m,高度至多 m ≤ n;空树高度为 0。
- 给定序列的结构与平台答案图一致,最大高度为 5;中序遍历是
6, 12, 15, 26, 36, 38, 41, 44, 51, 68。
还有一处不属于填空的接口细节:题干的 SearchBST 没有在入口初始化 *p。查到根结点时,父指针可能保留调用前的值;查空树亦然。完整示例额外加入 *p = NULL,使“返回父结点”的约定在根结点与空树情况下也成立。这一补充使函数接口满足其父结点返回约定。
C17 编译和测试通过:空树、首次插入、根的父指针、重复键、给定序列的树结构与中序遍历、成功/失败查找、升序/降序最坏高度及整数边界。
补充与完整修正示例
完整修正示例:
示例保留题目的指针接口,补全五处填空,并增加父指针初始化、内存释放和 main;内存分配失败时退出。
2024年上半年软件设计师考试综合知识(专业解析+参考答案)
本节已整理 6 条来源记录;题号沿用来源,答案与解析默认收起。
2024-05 Q014
来源:第 14 题(原站入口)。
【考生回忆版】用简单选择排序把序列(49,38,65,97,76,13,27,49)排成非降序,两趟后得到( )。
-
A.
(13,27,65,97,76,49,38,49)
-
B.
(38,49,65,76,13,27,49,97)
-
C.
(13,38,65,97,76,49,27,49)
-
D.
(38,49,65,13,27,49,76,97)
答案与解析
平台答案:A。
整理解析
选A。第一趟从全序列找出最小值13,与首位49交换,得到(13,38,65,97,76,49,27,49)。第二趟在后七个位置找出27,与38交换,得到(13,27,65,97,76,49,38,49)。
2024-05 Q018
来源:第 18 题(原站入口)。
【考生回忆版】查找表有29个元素。若要求查找任意元素时,最多与表中5个元素比较就能确定结果,应采用的查找表与方法是( )。
-
A.
二叉排序树上的查找
-
B.
顺序表上的顺序查找
-
C.
有序顺序表上的二分查找
-
D.
散列表上的哈希查找
答案与解析
平台答案:C。
整理解析
选C。二分查找每次比较一个中间元素后缩小搜索区间。29满足24≤29<25,最坏比较次数为⌊log229⌋+1=5。普通二叉排序树可能退化成链,顺序查找最坏需29次,未约束冲突的散列查找也不能保证5次以内。
补充与纠错
“最多5次”按与表中一个元素比较算一次;并不把程序中相等、大小判断分别重复计数。平衡查找树也可能达到这一界,但A没有给出平衡条件,不能据此保证所有二叉排序树均满足。
2024-05 Q036
来源:第 36 题(原站入口)。
【考生回忆版】要求两个字符序列X[1...m]与Y[1...n]的最长公共子序列。该问题具有最优子结构,令c[i,j]为X[1...i]与Y[1...j]的最长公共子序列长度,递推式如下:
自底向上计算X与Y的最长公共子序列长度,采用的是( 36 )算法设计策略,时间复杂度为( 37 )。已知X[6]=‘A’、Y[6]=‘T’、c[5,5]=2、c[5,6]=3、c[6,5]=2,则c[6,6]为( 38 )。
请作答:第36题。
-
A.
贪心
-
B.
分治法
-
C.
回溯
-
D.
动态规划
答案与解析
平台答案:D。
整理解析
选D。状态c[i,j]记录两个前缀的最长公共子序列长度;边界i=0或j=0时为0。同末字符取左上状态加1,不同则取上方与左方的较大值。按前缀长度自底向上填表并复用已算状态,属于动态规划,最终答案在c[m,n]。
补充与纠错
最长公共子序列允许不连续,只保持字符相对顺序。最优子结构本身也出现在其他策略中;这里还利用重叠前缀子问题并保存结果,不能只见“最优子结构”就自动判动态规划。
2024-05 Q037
来源:第 37 题(原站入口)。
【考生回忆版】要求两个字符序列X[1...m]与Y[1...n]的最长公共子序列。该问题具有最优子结构,令c[i,j]为X[1...i]与Y[1...j]的最长公共子序列长度,递推式如下:
自底向上计算X与Y的最长公共子序列长度,采用的是( 36 )算法设计策略,时间复杂度为( 37 )。已知X[6]=‘A’、Y[6]=‘T’、c[5,5]=2、c[5,6]=3、c[6,5]=2,则c[6,6]为( 38 )。
请作答:第37题。
-
A.
m2 n2
-
B.
m×2n
-
C.
mn
-
D.
n×2m
答案与解析
平台答案:C。
整理解析
选C。需要填写m×n个非边界状态,每个状态只进行字符比较、加1或取两个已知值的最大值,耗时为常数,所以总时间为O(mn),对应mn。边界行列为0,计算顺序保证上、左、左上已知,最终读取c[m,n]。
补充与纠错
不能像平台解析那样仅凭“二维”就断言O(mn):还必须核算每个状态的转移代价。此题每格为常数操作,普通表空间O(mn),只求长度可滚动压缩到O(min(m,n))。原页B为m×2n,D为n×2m,两者均是指数项,不能误排成m2n或n2m;平台C保留。
格式整理说明
A:上下标位置已按原式确认;原字符、选项顺序及平台答案保留。
B:原页已确认系数与指数位置;显式乘号表示原式的隐含相乘,上标范围保持不变。
D:原页已确认系数与指数位置;显式乘号表示原式的隐含相乘,上标范围保持不变。
2024-05 Q038
来源:第 38 题(原站入口)。
【考生回忆版】要求两个字符序列X[1...m]与Y[1...n]的最长公共子序列。该问题具有最优子结构,令c[i,j]为X[1...i]与Y[1...j]的最长公共子序列长度,递推式如下:
自底向上计算X与Y的最长公共子序列长度,采用的是( 36 )算法设计策略,时间复杂度为( 37 )。已知X[6]=‘A’、Y[6]=‘T’、c[5,5]=2、c[5,6]=3、c[6,5]=2,则c[6,6]为( 38 )。
请作答:第38题。
-
A.
4
-
B.
3
-
C.
2
-
D.
1
答案与解析
平台答案:B。
整理解析
选B。X[6]=A与Y[6]=T不同,应走递推式第三种情况:c[6,6]=max(c[5,6],c[6,5])=max(3,2)=3。只有两个末字符相等时才用c[5,5]+1;不能仅因两者本题碰巧同为3就混用分支。
2024-05 Q059
来源:第 59 题(原站入口)。
基数排序按从低位到高位的顺序处理待排数组,各位排序必须稳定。为提高每一位的处理效率,应选用哪种排序( )?
-
A.
插入
-
B.
计数
-
C.
快速
-
D.
归并
答案与解析
平台答案:B。
整理解析
选B。单个位的取值范围有限,稳定实现的计数排序用O(n+r)时间处理n个元素和r种数位值,适合逐位排序。稳定性保证本轮相同数位的元素仍保持此前低位排定的次序;常规快速排序不稳定,归并和插入也没有此处计数排序的线性效率优势。
2024年上半年软件设计师应用技术真题(专业解析+参考答案):案例题
本节保留 1 条来源:1 组完整,0 组不完整。
2024-05-case Q003
哈夫曼树的构造、编码与译码
阅读下列说明和C代码,回答问题。
【说明】
哈夫曼树也称为最优二叉树,是指对于一组带有确定权值的叶子结点,构造具有最小带权路径长度的二叉树。
构造哈夫曼树的基本思想为:
(1)由给定的n个字符{c1,c2...,cn}和对应的权值{w1,w2,....wn}(wi>0,1≤i≤n)构造n棵只有根结点的二叉树,从而得到一个二叉树集合F{T1,T2...,Tn},其中每棵二叉树Ti中只有权值为wi的根结点,其左右子树均为空。
(2)在F中选取根结点的权值最小和次小的二叉树分别作为其左右子树构造一棵新的二叉树,这棵新的二叉树的根结点权值为其左右子树根结点权值之和。
(3)在集合F中删除第(2)步中选取的最小和次小的二叉树,并将新构造的二叉树加入到F中。
(4)重复第(2)步和第(3)步,直到F中只剩下一棵二叉树为止。这棵二叉树就是要构建的哈夫曼树。
对构造完成的哈夫曼树的叶子结点进行哈夫曼编码,编码过程从根结点开始,若该结点有左孩子,则左分支标记为0;若该结点有右孩子,则右分支标记为1。依次类推,直到叶子结点。从根结点到叶子结点的二进制串即为该叶子结点对应字符的哈夫曼编码。译码是指将二进制编码翻译为信息原文。
【C代码】
(1)主要变量说明
n:字符数
HT:哈夫曼树
HC:字符集编码指针
buff:待译码的01串
s:s[0]、s[1]分别表示最小权值和次小权值的二叉树的根结点下标
(2)函数定义
01(10分)
根据以上说明和C代码,填充C代码中的空(1)~(5)。
02(5分)
给定字符集合{a, b, c, d, e, f}和对应的权值{45,13,12,16,9,5},则构造的哈夫曼树中,字符a和c的编码分别为 (6) 和 (7) 。对字符串“110001001101”译码为 (8) 。
答案与解析
平台参考答案(原意保留)
平台参考答案:
s[1] = kHT[i].ch = ch[i-1]HT[i].lchild = s[0]cd[--start] = '0'HT[p].rchild == 0- 字符 a 的编码:
0。 - 字符 c 的编码:
100。 110001001101译码为face。
解析与纠错
解析与纠错:
五处填空分别完成次小根下标更新、叶子字符赋值、新父结点左孩子设置、逆向生成左分支编码、确认译码到达叶子。平台填空与算法意图一致;它们不足以修复题干已有的非填空错误。
按题意将较小权值子树放左侧,合并过程为 5+9=14、12+13=25、14+16=30、25+30=55、45+55=100。得到:
| 字符 | 权值 | 编码 |
|---|---|---|
| a | 45 | 0 |
| b | 13 | 101 |
| c | 12 | 100 |
| d | 16 | 111 |
| e | 9 | 1101 |
| f | 5 | 1100 |
因此 110001001101 = 1100 · 0 · 100 · 1101,译码为 face;带权路径长度为224。存在相同权值时,不同合法的选择次序可能产生不同码字,但都可具有相同最优带权路径长度。
题干还包含以下问题:
select中return s位于最后一次扫描的 for 循环内部,会只考察第一个 k 就返回,无法保证选到次小权值。对于权值7,50,3,4,应选下标3和4,原位置却会返回3和1。malloc后仅初始化了叶子结点,新增内部结点的 parent 未置零;后续选择根和沿parent回溯可能读取未初始化值。应初始化整个结点数组,或逐一初始化全部内部结点。- 编码缓冲区末尾应为字符
\0,题干写成了\o;strcpy两个实参之间应为逗号,题干写成了点号。 - 译码循环应与字符字面量
'\0'比较;题干的引号不匹配。buff+ +应是buff++,重新回到根的变量应为小写p,而非P。 HC按值传入,在函数内重新分配只改变局部指针,调用者得不到新编码表。可以把输出参数改为char ***HC,或返回包含树和编码表的结构。- 原代码未完整检查内存分配失败,也没有释放选择数组和编码临时缓冲区。合法译码还应区分非法字符、末尾停在非叶子处的截断码字与正常结束。
C17 编译和测试通过:给定序列的全部码字、face译码、带权路径长度224、编码/译码往返、前缀无歧义、相同权值、两个字符、非法权值、空输入码串、非法/截断码串、输出容量与较大权值和。示例沿用题干拒绝 n≤1 的接口范围;空字符集和单字符输入均返回失败。
补充与完整参考实现
完整参考实现:
示例使用输出参数返回编码表,初始化全部结点并检查译码边界。字符数限定为2—100,权值须为正;相同权值按原下标先后选择。权值和使用较宽的整数类型。单字符集合的特殊编码约定没有在此示例中另行扩展。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 | |
2023年下半年软件设计师案例真题(考生回忆版):案例题
本节保留 1 条来源,答案与解析默认收起。
2023-11-case Q004
最大连续子段和的程序填空
来源不完整,按现有题面保留。
【考生回忆版】
最大子段和问题要求在含正数、负数的序列中,找出元素和最大的一段连续子序列。例如序列(2,-4,5,-1,2,-4,1),下标从0开始时,i=2、j=4、sum=6。
对含n个元素的数组a,辅助数组b[j]表示前缀a[0]~a[j]中包含a[j]的最大连续子段和。题给递推式为:
b[j] = max(b[j-1] + a[j], a[j]),0≤j<n
整个数组的最大子段和为max(b[j]),0≤j<n。
主要变量:a是输入数组;ms指向保存开始下标、结束下标和最大子段和的结构体;b[i]保存包含a[i]的最大子段和。
【C代码】
【问题1】(10分)根据说明及代码,填写(1)~(5)。
【问题2】(5分)
(1)本算法采用的设计策略是(6)。
(2)时间复杂度为(7)。
答案与解析
平台参考答案(原文保留)
【问题1】
1、b[0]=a[0]
2、i < n
3、b[i-1]+a[i]
4、i
5、sum < b[i]
【问题2】
1、动态规划法
2、O(n)
解析与纠错
平台填空依次为:(1) b[0]=a[0],(2) i<n,(3) b[i-1]+a[i],(4) i,(5) sum<b[i];(6)动态规划,(7)O(n)。
状态b[i]必须以a[i]结尾。若前一个状态为正,接在其后有利;否则从a[i]重新开始。每个位置只做常数次运算,因此遍历为O(n),全局最大值另由sum维护。递推式中的i=0不能访问b[-1],需要单独设置b[0]=a[0],之后从i=1计算。
平台第(1)空只初始化b[0]仍不充分:代码的sum从0开始,循环从1开始,可能漏掉只含a[0]的最优段。例[5,-10,1]同时含正、负数,正确最大和为5;只照此方式更新sum会得到1。平台长解析另提到sum=a[0],与其答案栏不完全一致;即使补上这一句,tempi、tempj、besti、bestj仍须初始化,否则延续首段或最优段一直在首元素时会使用未定义值。在n≥1的前提下,完整初始化应含b[0]=a[0]; sum=a[0]; tempi=tempj=besti=bestj=0;,再按(2)~(5)转移。
原站可见页面已核实:#include < stdio.h >、#include < stdib.h >、struct maxSum(、声明末}*ms缺分号、未声明typedef却直接使用maxSum,以及多处缺分号,均为原页问题。源码确实停在ms sum =sum;,紧接【问题1】,没有结构体下标赋值、return或函数闭合括号。五空可辨,但只填平台答案仍不能得到完整可编译程序;可见代码保留原貌,以下初始化属于整理补充,不能当作原题缺失源码。
补充说明
用于核对填空的初始化整理修正(非原题原文,也不是完整程序):
若另行编写可运行版本,还需修正头文件、类型声明及缺失标点,检查malloc结果,并补全返回结构体的i、j、sum赋值、return和函数结束;这些内容不是从原页恢复出来的。求最大非空子段要求n≥1,固定b[N]还要求n≤N;n=0需另定接口约定。
2023年下半年软件设计师考试基础知识(专业解析+参考答案)
本节已整理 5 条来源记录;题号沿用来源,答案与解析默认收起。
2023-11 Q012
来源:第 12 题(原站入口)。
【考生回忆版】关于折半查找,叙述不正确的是( 12 )。在包含8个元素的有序表中,采用折半查找且每个元素被查到的概率相同,查找成功的平均查找长度为( 13 )。
请作答:第12题。
-
A.
是一个分治算法
-
B.
只能应用于有序表
-
C.
查找成功和不成功的平均查找长度是一样的
-
D.
若表长为n,时间复杂度为O(logn)
答案与解析
平台答案:C。
整理解析
选C。折半查找利用有序关系比较中间元素,每次只继续查一半区间,属于分治。在支持按位置随机访问的有序表上,最坏查找时间为O(log n)。成功查找与失败查找的停止位置、概率空间不同,平均比较次数一般不同,不能一概说相同。
补充与纠错
“一般不同”不等于任何规模下都绝不相等,例如只有1个元素并按比较元素次数计数时,成功和失败都可能比较1次。O(log n)还依赖取中间元素的开销,不能把数组的随机访问结论直接套给链表。
2023-11 Q013
来源:第 13 题(原站入口)。
【考生回忆版】关于折半查找,叙述不正确的是( 12 )。在包含8个元素的有序表中,采用折半查找且每个元素被查到的概率相同,查找成功的平均查找长度为( 13 )。
请作答:第13题。
-
A.
9/8
-
B.
⅛
-
C.
20/8
-
D.
21/8
答案与解析
平台答案:D。
整理解析
选D。8个元素的折半查找判定树中,成功比较次数为1、2、3、4的元素个数分别是1、2、4、1。各元素等概率,因此平均查找长度为(1×1+2×2+3×4+4×1)/8=21/8。
2023-11 Q031
来源:第 31 题(原站入口)。
【考生回忆版】对以下哪类问题使用贪心策略,可以保证得到最优解( )。
-
A.
分数背包
-
B.
0-1背包
-
C.
旅行商
-
D.
最长公共子序列
答案与解析
平台答案:A。
同题对照:标准题。来源选项→标准题选项:A→C,B→D,C→A,D→B。
映射后平台答案:C。
重复判断依据
两题均问贪心能保证最优的问题类型,分数背包、0-1背包、旅行商、LCS四项同义换序。最大公共子序列(LCS)在目标卷指最长公共子序列。
补充与纠错
不能把其余三项理解为“贪心永远得不到最优解”。它们是一般情况下不能仅凭常见局部选择规则保证所有实例最优;某些实例仍可能恰好得到最优解。
2023-11 Q063
来源:第 63 题(原站入口)。
对序列(49,38,65,97,76,13,27,49)进行非降序冒泡排序。完成两趟后,序列应是哪一项?
-
A.
(49,38,65,13,27,49,76,97)
-
B.
(38,49,65,76,13,27,49,97)
-
C.
(38,49,65,13,27,49,76,97)
-
D.
(49,38,65,97,76,13,27,49)
答案与解析
平台答案:C。
整理解析
按从左向右比较相邻元素、把最大值移到末端的常见实现,第一趟得到(38,49,65,76,13,27,49,97),第二趟得到(38,49,65,13,27,49,76,97),所以选C。
补充与纠错
约定说明:冒泡排序也可反向扫描,使最小值逐趟前移。题干没有明确扫描方向,平台及选项采用的是向右冒泡最大值的约定,不能把任意实现的第二趟状态都视为相同。
2023-11 Q065
来源:第 65 题(原站入口)。
用简单选择排序把(34,12,49,28,31,52,51,49)排成非降序。两趟结束后的序列是哪一项?
-
A.
(12,28,49,34,31,52,51,49)
-
B.
(12,28,34,49,31,52,51,49)
-
C.
(12,28,31,49,34,52,51,49)
-
D.
(34,12,49,28,31,49,51,52)
答案与解析
平台答案:A。
整理解析
第一趟从全序列选最小值12,与首位34交换,得到(12,34,49,28,31,52,51,49)。第二趟从余下部分选28,与第二位34交换,得到(12,28,49,34,31,52,51,49),选A。
2023年上半年软件设计师应用技术:案例题
本节保留 1 组案例。
2023-05-case Q004
图的连通分量与邻接表
阅读下列说明和C代码,回答问题1至问题2,将解答写在答题纸的对应栏内。
【说明】
下面的C程序采用深度优先遍历(DFS)来计算图G中的连通分量数。其中图G采用邻接表表示。
【C代码】
(1)主要变量说明
G:图,用邻接表存储
visited[]:数组,长度为Max Vnum,visited[i] = 0 表示顶点i未被访问;visited[i] = 1 表示顶点i已经被访问
count:图G的连通分量数
(2)函数定义
【问题1】(10分)
根据以上说明和C代码,填充C代码中的空(1) ~ (5)。
【问题2】(5分)
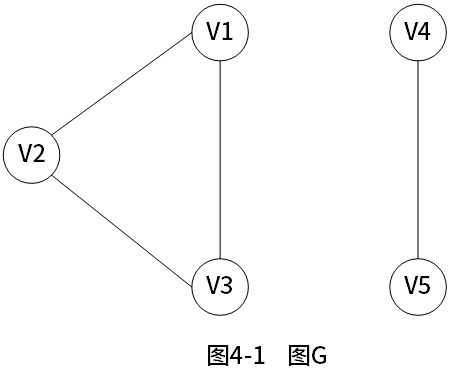
给出图4-1中图G的邻接表表示。
答案与解析
平台参考答案(原意保留)
【问题1】
(1)p- > adjvex
(2)p = p- > nextarc
(3)count=0
(4)count++
(5)return count
【问题2】
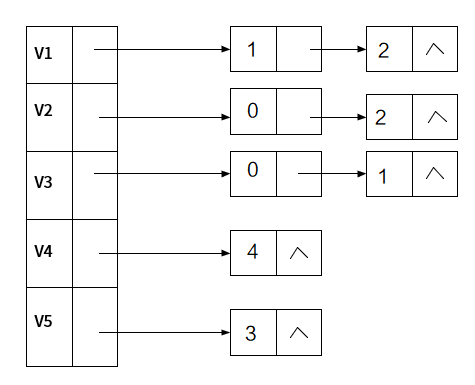
解析与纠错
填空。 (1)p->adjvex;(2)p = p->nextarc;(3)count = 0;(4)count++;(5)return count。DFS检查当前邻接节点所指顶点,递归后沿nextarc继续扫描。外层每从一个未访问顶点启动DFS,就发现一个尚未计数的连通分量。声明中的count = 1会被(3)覆盖,不能在保留该初值时漏掉归零。
邻接表。 按顶点标签V1~V5对应下标0~4,图中有三角形V1—V2—V3—V1和一条V4—V5的边。无向边应在两端各记录一次,邻接节点排列顺序可不同。
| 顶点(下标) | 邻接顶点下标 |
|---|---|
| V1(0) | 1,2 |
| V2(1) | 0,2 |
| V3(2) | 0,1 |
| V4(3) | 4 |
| V5(4) | 3 |
共有2个连通分量。平台答案图里的数字是下标,不是标签末尾的数字。
代码纠错。 题干代码的Max Vnum不是合法的单个宏标识符,#include < stdio.h >、p- >也需修正为可编译拼写。更关键的是,平台填空未重置全局visited:对同一个单顶点图连续调用两次getNum,结果为1、0,而应为1、1。修正示例让每次getNum创建独立访问数组,并传递图指针,避免递归时按值复制整个邻接表头数组。该算法用于无向图的连通分量,不是有向图的强连通分量算法。
对有效邻接表,DFS遍历本身的时间复杂度为O(V+E),递归栈最多O(V)。通常按V分配并清零访问数组时,总辅助空间为O(V);下面示例使用固定100个访问槽并全部清零,输入顶点数限制为100,图和顶点下标需有效。C17验证覆盖空图、孤立点、原图、重复调用、自环、平行边、合并分量及100顶点链。
补充与完整参考实现
以下为按题意编写并验证的修正示例,包含填空之外的修正与边界处理。
2023年上半年软件设计师考试基础知识(专业解析+参考答案)
本节已整理 5 条来源记录;题号沿用来源,答案与解析默认收起。
2023-05 Q060
来源:第 60 题(原站入口)。
在某有序表上进行折半查找时,以下哪个比较关键字序列不可能出现?
-
A.
42,61,90,85,77
-
B.
42,90,85,61,77
-
C.
90,85,61,77,42
-
D.
90,85,77,61,42
答案与解析
平台答案:C。
整理解析
折半查找的后续比较必须一直留在前面判断确定的区间内。C中先比90、85、61,随后比77,说明已进入大于61且小于85的范围;下一次却比较42,越出了该范围,因此不可能,选C。其余三个序列均未违反已有上下界。
2023-05 Q062
来源:第 62 题(原站入口)。
为一组数据排序,若要求时间复杂度O(n lg n)且保持稳定,应采用(62)算法;若要求时间复杂度O(n lg n),且在原数据上排序、额外空间复杂度O(1),则应采用(63)算法。
请作答:第62题。
-
A.
直接插入排序
-
B.
堆排序
-
C.
快速排序
-
D.
归并排序
答案与解析
平台答案:D。
整理解析
常规归并排序把问题逐层对半分解,每层合并总成本O(n),共O(lg n)层;合并时对相等关键字优先取左段元素即可保持稳定,故选D。直接插入排序稳定但通常需O(n2)时间;堆排序与普通快速排序不稳定。
补充与纠错
复杂度边界:普通快速排序只有平均或期望时间O(n lg n),最坏可达O(n2),不能像平台第一空解析那样不加限定地说它满足时间要求。
2023-05 Q063
来源:第 63 题(原站入口)。
为一组数据排序,若要求时间复杂度O(n lg n)且保持稳定,应采用(62)算法;若要求时间复杂度O(n lg n),且在原数据上排序、额外空间复杂度O(1),则应采用(63)算法。
请作答:第63题。
-
A.
直接插入排序
-
B.
堆排序
-
C.
快速排序
-
D.
归并排序
答案与解析
平台答案:B。
整理解析
常规原地堆排序在数组中建堆并反复取出堆顶,最坏时间O(n lg n),以迭代调整堆可只用常数额外空间,所以选B。通常的数组归并排序需要O(n)辅助空间;快速排序还要计入递归栈,且最坏时间不能保证O(n lg n)。
2023-05 Q064
来源:第 64 题(原站入口)。
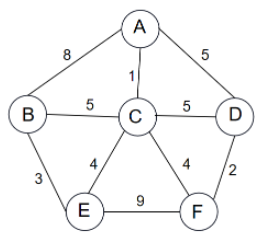
用Kruskal算法求下图的最小生成树,其采用的算法设计策略是(64);所得最小生成树的总权值为(65)。
请作答:第64题。
-
A.
分治法
-
B.
动态规划
-
C.
贪心法
-
D.
追溯法
答案与解析
平台答案:C。
整理解析
Kruskal把边按权值递增考虑,每次选取连接不同连通分量的最轻边,跳过会构成环的边。这是贪心选择,选C;安全性来自最小生成树的割性质,而非仅仅希望局部最优最终成功。
补充与纠错
纠错:最小生成树也有最优子结构,不能用平台所述“不涉及最优子结构”来排除动态规划;本算法属于贪心,是由它的具体选择步骤和安全边性质确定的。原D写“追溯法”,保留原选项。
2023-05 Q065
来源:第 65 题(原站入口)。
用Kruskal算法求下图的最小生成树,其采用的算法设计策略是(64);所得最小生成树的总权值为(65)。
请作答:第65题。
-
A.
14
-
B.
16
-
C.
20
-
D.
32
答案与解析
平台答案:A。
整理解析
按原图权值从小到大选边:AC=1、DF=2、BE=3、CE=4、CF=4。这五条边未形成环,已把六个顶点连成一棵树,总权值1+2+3+4+4=14,选A。
补充与纠错
平台从最小选项14反推,只能帮助猜测,不能证明最优。此处按Kruskal逐边检查所得结果构成有效的最小生成树,无需发布重复的答案图。
2022年下半年软件设计师案例真题:案例题
本节保留 1 条来源,答案与解析默认收起。
2022-11-case Q004
堆排序的程序填空与执行过程
使用顺序存储的大顶堆,把n个元素排序为非递减序列。元素位于R[1]~R[n];初始堆规模为n,最大元素在R[1],末元素在R[n]。
先建立大顶堆,再交换堆顶与堆中末元素,使末元素退出堆、规模减1,并将余下元素重新调整为大顶堆。重复这一过程直到堆中只剩一个元素,数组即完成非递减排序。
主要变量:n是待排序数组长度;R[]存放待排数据,使用下标1~n。下面给出C代码。
【问题1】(8分)填写代码中的空(1)~(4)。
【问题2】(2分)算法时间复杂度为(5),用O符号表示。
【问题3】(5分)给定R=(7,10,13,15,4,20,19,8)、n=8:构建的初始大顶堆为(6);第一次让堆顶元素退出堆并调整剩余元素后,整个数组R为(7)。
答案与解析
平台参考答案(原文保留)
【问题1】
1:R[0] < R[j]
2:Heapify(R,i,n)
3:i > 1
4:R[1]=R[0]
【问题2】
5:O(nlog 2 n)【O(nlogn)、O(nlgn)写法也是可以的】
【问题3】
6:{20,15,19,10,4,13,7,8}或其树形结构。
7:{19,15,13,10,4,8,7,20}
解析与纠错
(1)R[0] < R[j];(2)Heapify(R,i,n);(3)i > 1;(4)R[1]=R[0]。R[0]保存当前待下沉元素,j总是两个孩子中较大的一个;若该孩子较大,就把它上移并继续向下找位置,否则停止。每次比较必须使用尚未放回的R[0],不能使用已经被覆盖的R[i]。
自最后一个非叶结点n/2向根调整可在线性时间建堆。随后n−1次取最大值并下沉,每次至多沿树高走O(log n)步,因此(5)为O(n log2 n),底数不影响渐近量级。Heapify在此用循环实现;平台解析中的“归并排序”“递归调用”均不符合本段堆排序代码。其调整对象是以i为根的子树,也不是数组下标i~n组成的任意连续区间。
对给定8个元素,建堆时按i=4、3、2、1处理,得到(6)(20,15,19,10,4,13,7,8)。交换20与末元素8后,对前7个元素下沉,得到(7)(19,15,13,10,4,8,7,20),最后的20已排定而不再属于堆。
原题首行确为单独的#include,没有头文件名;测试主函数、int main、return 0及最后闭括号均完整,随后进入问题1。该预处理指令残缺,原段直接编译仍会失败;补写#include <stdio.h>属于整理修正,不是原题原文。平台解析开头误称“归并排序”也已核实为原页错误。MAXITEM=100而R[0]作临时单元,所以此数组最多容纳99个有效待排元素。代码注释虽说下标0闲置,算法实际会读写R[0]。
2022年上半年软件设计师应用技术:案例题
本节保留 1 组案例。
2022-05-case Q004
矩阵链乘的计算顺序
阅读下列说明和C代码,回答问题1至问题3,将解答写在答题纸的对应栏内。
【说明】
某工程计算中经常要完成多个矩阵相乘(链乘)的计算任务,对矩阵相乘进行以下说明。
(1)两个矩阵相乘要求第一个矩阵的列数等于第二个矩阵的行数,计算量主要由进行乘法运算的次数决定,假设采用标准的矩阵相乘算法,计算Amxn*Bnxp需要m*n*p次行乘法运算的次数决定、乘法运算,即时间复杂度为O(m*n*p)。
(2)矩阵相乘满足结合律,多个矩阵相乘时不同的计算顺序会产生不同的计算量。以矩阵A1 5×100 ,A2 100*8 ,A3 8x50 三个矩阵相乘为例,若按(A1*A2)*A3计算,则需要进行5*100*8+5*8*50=6000次乘法运算,若按A1*(A2*A3)计算,则需要进行100*8*50+5*100*50=65000次乘法运算。
矩阵链乘问题可描述为:给定n个矩阵,对较大的n,可能的计算顺序数量非常庞大,用蛮力法确定计算顺序是不实际的。经过对问题进行分析,发现矩阵链乘问题具有最优子结构,即若A1*A2**An的一个最优计算顺序从第k个矩阵处断开,即分为A 1 *A 2 *…*A k 和A k+1 *A k+2 *...*A n 两个子问题,则该最优解应该包含 A 1 *A 2 *…*A k 的一个最优计算顺序和 A k+1 *A k+2 *...*A n 的一个最优计算顺序。据此构造递归式:
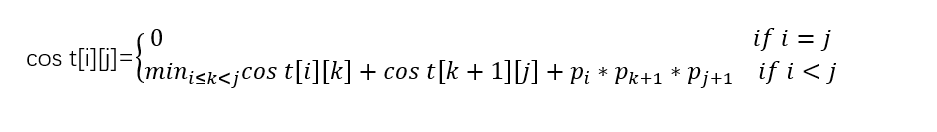
其中,cost[i][j]表示A i+1 *A i+2 *...A j+1 的最优计算的计算代价。最终需要求解cost[0][n-1]。
【C代码】
算法实现采用自底向上的计算过程。首先计算两个矩阵相乘的计算量,然后依次计算3个矩阵、4个矩阵、…、n个矩阵相乘的最小计算量及最优计算顺序。下面是该算法的语言实现。
(1) 主要变量说明
n:矩阵数
seq[]:矩阵维数序列
cost[i][j]:二维数组,长度为n*n,其中元素cost[i][j]表示Ai+1*Ai+2**Aj+1的最优的计算代价。
trace[][]:二维数组,长度为n*n,其中元素trace[i][j]表示Ai+1*Ai+2**Aj+1的最优计算顺序对应的划分位置,即k。
(2)函数cmm
【问题1】(8分)
根据以上说明和C代码,填充C代码中的空(1)~(4)。
【问题2】(4分)
根据以上说明和C代码,该问题采用了(5)算法设计策略,时间复杂度为(6)(用O符号表示)。
【问题3】(3分)
考虑实例n=4,各个矩阵的维数为A1为15*5,A2为5*10,A3为10*20,A4为20*25,即维度序列为15,5,10,20和25。则根据上述C代码得到的一个最优计算顺序为(7)(用加括号方式表示计算顺序),所需要的乘法运算次数为 (8)。
答案与解析
平台参考答案(原意保留)
【问题1】
(1) j=i+p
(2)k < j
(3) cost[i][k]+cost[k+1][j]+seq[i]*seq[k+1]*seq[j+1]
(4) trace[i][j] = tempTrace
【问题2】
(5)动态规划算法
(6)O(n 3 )
【问题3】
(7)A1*((A2*A3)*A4)
(8)5375
解析与纠错
填空与状态定义。 (1)j = i + p;(2)k < j;(3)cost[i][k] + cost[k+1][j] + seq[i]*seq[k+1]*seq[j+1];(4)trace[i][j] = tempTrace。(5)动态规划;(6)O(n³)。cost[i][j]处理从Aᵢ₊₁到Aⱼ₊₁的链,p是下标差,所以链长为p+1;在k处划分后,左、右结果维数分别为seq[i]×seq[k+1]和seq[k+1]×seq[j+1]。
单个矩阵不需要相乘,cost[i][i]=0。先求较短区间,才可使用其结果求较长区间;对每个区间枚举全部划分点。三重循环的总量为O(n³),代价表和划分表的空间为O(n²)。
给定实例。 (7)A1*((A2*A3)*A4);(8)5375。先算A2A3,花费5×10×20=1000;再乘A4,花费5×20×25=2500;最后与A1相乘,花费15×5×25=1875,共5375。原题开头的5×100、100×8、8×50示例对应6000与65000,也与标准矩阵乘法计数一致。
纠错。 平台解析把问题1、问题2的说明顺序写反,但参考答案的空号对应关系正确。“通过贪心策略尝试”只能帮助猜测,不能保证最优。例如维度2、3、7、3,先选眼前乘法次数最少的前两个矩阵,总代价42+42=84;先乘后两个则为63+18=81。动态规划应比较全部划分,不能以局部最小替代递推。
已回看原页确认,三处加粗行来自页面标题样式,标题标记不是代码字符;宏和数组声明本身仍有原始错误。原题中的宏和数组声明需改成#define N 100、int cost[N][N]才能得到可编译声明。int乘积也可能溢出,例如50000×50000×50000。补充实现保持相同区间状态和划分逻辑,改用64位无符号代价并检查每次乘加;遇到溢出的候选划分时跳过,仍寻找其他可表示的最优方案。所有候选均超出表示范围时才报告溢出。合法输入要求1≤n≤100、维度数为n+1且每一维大于0;单矩阵代价为0,空链不作为此接口的合法输入。
C17验证包括两组题内数值、单矩阵/双矩阵、等价最优方案、非法规模/零维度、重复调用、100矩阵、32位溢出示例、64位边界与溢出分支,以及240组小规模输入对所有括号方案的穷举比较。
补充与完整参考实现
平台解析附图(原图保留):
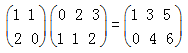
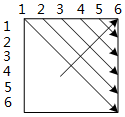
以下是按题意编写并验证的完整修正示例,含填空之外的语法修正与边界处理。
2021年下半年软件设计师案例真题:案例题
本节保留 1 条来源,答案与解析默认收起。
2021-11-case Q004
字符串编辑距离的程序填空
生物学中可用编辑距离衡量两个物种DNA序列的相似性,以刻画进化关系。编辑距离是把一个字符串变成另一个字符串所需的最少操作数,每次操作可插入一个字符、删除一个字符,或把一个字符替换为另一个字符。
字符数组str1、str2的长度分别为len1、len2;二维数组d保存子问题的最优解,其递推定义如下图。
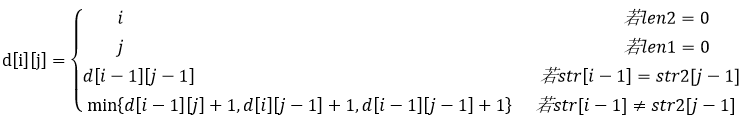
C程序中的A、B为两个字符数组,d为二维数组,i、j为循环变量,temp为临时变量。
【问题1】(8分)根据说明和代码,填写空(1)~(4)。
【问题2】(4分)算法采用(5)设计策略,时间复杂度为(6)。用O符号表示复杂度,两个字符串的长度分别记为m、n。
【问题3】(3分)A="CTGA"、B="ACGCTA"时,两者的编辑距离为(7)。
答案与解析
平台参考答案(原文保留)
问题1:
(1) d[0][j]=j
(2) str1[i-1]==str2[j-1]
(3) d[i-1][j-1] +1
(4) d[len1][len2]
问题2:
(5)动态规划法 (6)O(mn)
问题3:
(7)4
解析与纠错
设d[i][j]为str1前i个字符变成str2前j个字符的最少操作数。空串变成长度j的前缀需插入j次,所以(1)填d[0][j]=j;末字符相同无需增加操作,故(2)填str1[i-1]==str2[j-1]。不同时分别比较删除、插入、替换的代价,其中(3)为d[i-1][j-1]+1;最终(4)返回d[len1][len2]。
(5)为动态规划法。两层主循环枚举m×n个子问题,每格用常数时间计算,通常写(6)为O(mn);连同空串边界初始化,完整计数是O(mn+m+n)。按字符串长度配置二维表时,需要O((m+1)(n+1))空间,通常简写为O(mn)。本段实际固定N=100,必须使两字符串长度均不超过99,以容纳下标0到长度的边界行列。
(7)为4。例如把B="ACGCTA"开头的ACG删除,再在末尾A前插入G,便得到"CTGA",共4次操作;动态规划验证不存在更少的操作。填空后的函数已与独立的最短编辑路径计算及空串、相同串、99字符边界等用例核对。
公式图把边界条件写成len2=0、len1=0,作为每个子问题d[i][j]的通用递推并不严谨,正确边界应针对前缀下标:d[i][0]=i、d[0][j]=j。图中第一字符串还写为str,与程序的str1命名不一致。原图保留,按程序的初始化和字符串名理解。平台长解析中的d[i-1][i]等下标也是笔误;删除分支应为d[i-1][j]+1。原题给的是完整函数片段,不要求自带main;测试入口是另加的验证代码。
2022年上半年软件设计师基础知识真题
本节新增4道题,沿用本卷原题号;答案与解析默认收起。
2022-05 Q039
来源:第39题(原站入口)。
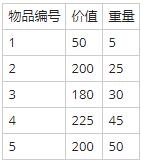
有5件物品,背包容量为100。下表给出各物品的价值、重量,已按单位重量价值从大到小排列。优先装入单位重量价值大的物品,采用的是( 39 )设计策略。分别考虑0/1背包(每件物品只能全部装入或全部不装)与部分背包(允许装入物品的一部分),此实例得到的最大价值分别为( 40 )。
请作答:第39题。
-
A.
分治
-
B.
贪心
-
C.
动态规划
-
D.
回溯
答案与解析
平台答案:B。
整理解析
选B。每一步优先取当前单位重量价值最高的物品,属于贪心决策。它并没有枚举所有组合或保存不同容量的子问题最优值。
补充与纠错
按价值密度贪心可以求部分背包最优解,但不能保证0/1背包最优。本例就能构造价值更高的整件组合,不能把局部选择直接当作全局最优性证明。
2022-05 Q040
来源:第40题(原站入口)。
有5件物品,背包容量为100。下表给出各物品的价值、重量,已按单位重量价值从大到小排列。优先装入单位重量价值大的物品,采用的是( 39 )设计策略。分别考虑0/1背包(每件物品只能全部装入或全部不装)与部分背包(允许装入物品的一部分),此实例得到的最大价值分别为( 40 )。
请作答:第40题。
-
A.
605和630
-
B.
605和605
-
C.
430和630
-
D.
630和430
答案与解析
平台答案:C。
整理解析
平台答案保留C。若沿用前文“单位重量价值大优先”的贪心策略,0/1背包依次取物品1、2、3,重量5+25+30=60,价值50+200+180=430;剩余40放不下物品4或5。部分背包则再取物品4的40/45,增加225×40/45=200,得到630。因此按上下文求该贪心策略的结果为430和630,对应C。
补充与纠错
若按本问“最大价值”的字面含义求全局最优,0/1背包可选物品2、3、4,总重25+30+45=100,总价值200+180+225=605;穷举32种组合与动态规划都验证605为最大值。部分背包最优仍为630,故这一读法对应A。原题没有另加“仅按上述贪心策略所得”的限定,需区分上下文的贪心结果与全局最大两种读法,不能把平台C默改为A,也不能把430称为0/1全局最优。平台解析中的630是总价值,不是总容量。
2022-05 Q042
来源:第42题(原站入口)。
对n个基本有序的整数排序:采用插入排序时,时间和空间复杂度分别为(42);采用快速排序时,时间和空间复杂度分别为(43)。
请作答:第42题。
-
A.
O(n2)和O(n)
-
B.
O(n)和O(n)
-
C.
O(n2)和O(1)
-
D.
O(n)和O(1)
答案与解析
平台答案:D。
整理解析
插入排序的移动量与逆序对数量I有关,常见实现耗时O(n+I)、辅助空间O(1)。按教材将“基本有序”理解为逆序对较少、I=O(n)的口径,得到O(n)和O(1),选D。
补充与纠错
“基本有序”不是精确的渐近条件;若没有限制逆序对数量,不能据这一口语描述无条件证明线性时间。
2022-05 Q043
来源:第43题(原站入口)。
对n个基本有序的整数排序:采用插入排序时,时间和空间复杂度分别为(42);采用快速排序时,时间和空间复杂度分别为(43)。
请作答:第43题。
-
A.
O(n2)和O(n)
-
B.
O(nlgn)和O(n)
-
C.
O(n2)和O(1)
-
D.
O(nlgn)和O(1)
答案与解析
平台答案:C。
整理解析
平台答案C对应二次时间和常数辅助空间。若总取端点元素作主元,有序输入可导致每次只缩小一个元素,T(n)=T(n−1)+O(n),总时间为O(n2)。但普通递归实现此时栈深可达n,计入调用栈的辅助空间应为O(n),按这个口径对应A。
补充与纠错
原题没有给出主元选择、递归实现或是否排除调用栈的口径,平台C并非一般快排的无条件结论。少交换不能推出不占递归栈;随机或平衡选主元又会改变有序输入的时间表现。原平台C保留,按通常递归实现计入调用栈时应选A。
2021年上半年软件设计师案例真题:案例题
本节保留 1 条来源,答案与解析默认收起。
2021-05-case Q004
凸多边形三角剖分的程序填空
凸多边形内任意两点的连线均位于其边界或内部;相邻顶点间的线段是边,不相邻顶点间位于内部的线段是弦。任意两顶点间都有权重。最优三角剖分要求把凸多边形划为内部互不相交的三角形,使全部三角形的权重之和最小;每个三角形的权重等于三条边的权重之和。
设N个顶点依次为V1、V2、…、VN。在Vk处分出三角形V1VkVN,以及两个子多边形V1、…、Vk和Vk、Vk+1、…、VN。若整体剖分最优,其中应包含两个子多边形的最优剖分。
用m[i][j]表示Vi−1、Vi、…、Vj所构成多边形的最优权重,用S[i][j]记录分割位置k。递推定义如下。
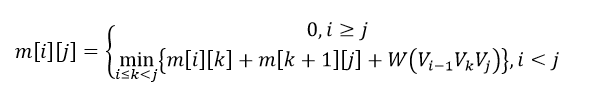
其中W(Vi−1VkVj)=Wi−1,k+Wk,j+Wj,i−1,这三项分别是三角形三条边的权重。需要求出最小总权重及对应的三角形集合。
下面给出C代码。
【问题1】(8分)填写代码中的空(1)~(4)。
【问题2】(7分)算法采用的设计策略为(5),时间复杂度为(6),空间复杂度为(7);复杂度用O表示。
答案与解析
平台参考答案(原文保留)
【问题1】(8分)
(1)r < =N或其等价表示形式
(2)j=i+r-1或其等价表示形式
(3)temp < m[i][j] 或其等价表示形式
(4)s[i][j]+1,j或其等价表示形式
【问题2】(7分)
(5)动态规划法
(6)O(n 3)
(7)O(n 2)
解析与纠错
按给定程序的循环结构,(1)的算法意图是r<=N,(2)为j=i+r-1,(3)为temp<m[i][j]。S[i][j]记录最优分割k,左子问题为(i,k),右子问题为(k+1,j),因此(4)应写S[i][j]+1,j。平台第(4)空给小写s,与声明的S不同;C区分大小写,这里必须说明修正,不能将平台原答案直接称为可编译答案。
(5)为动态规划。由短区间向长区间计算,每个区间枚举分割位置,时间复杂度为O(n3);m、S以及权重矩阵均为二维规模,空间复杂度为O(n2)。回溯两个子区间并输出本次三角形,即能得到达到最小权重的三角形集合。
顶点数量与下标的口径不一致:文字说N个点V1~VN,但循环还会计算m[1][N],按定义该项对应V0~VN,共N+1个点。若把它作为整题结果并调用print_triangle(1,N),N=6就会得到7点多边形的5个三角形;原段没有给出main或最终调用,不能擅称这就是6点题的实际输出。按文字的V1~VN,目标应是m[2][N]及print_triangle(2,N),并可排除不需要的V0相关计算;也可统一改用0~N−1编号。这是下标约定的整理说明,不改平台填空。
当前代码还含全角预处理符与标点、get_ triangle_weight/ge_triangle_ weight等函数名、print_ triangle、print以及引号问题。仅填空不能使其编译;原代码保留。测试用整理版本统一了这些语法、标识符及S的大小写,并把区间上界作为参数区分顶点数与区间数,明确属于修正版。该版本通过对全部候选三角剖分的穷举最优值比较,并验证回溯三角形数、边计数、无交叉及权重和;结果不证明原段可直接编译。
原页已核实上述顶点编号、N=6、全角符号及函数名写法;循环中的i < =N、i < =N-r+1和平台第(1)空的r < =N也原样如此。C的“小于等于”运算符应连续写为<=。平台第(4)空确用小写s;原段在末尾print及闭括号后直接进入问题1,没有main。此处保留的是带原题错误的函数片段,不能把整理版当成原文。
2020年软件设计师案例真题:案例题
本节保留 1 条来源,答案与解析默认收起。
2020-case Q004
希尔排序程序填空
题干将希尔排序称为“最小增量排序算法”,给出的过程如下。
- 构造步长delta1、delta2、…、deltak:delta1=n/2,此后每项为前一项的½,最后一项为1。
- 按步长序列进行k趟排序。
- 第i趟使用对应步长delta,将等步长位置的元素分组,各组在原位置上做直接插入排序。
变量说明:data为待排序数组,长度n,元素位于data[0]~data[n−1];n的说明原写为“数组a中的元素个数”;delta是步长数组。给出的C程序如下。
【问题1】填写C代码的空(1)~(4)。
【问题2】该算法时间复杂度(5)O(n2)(选择“小于、等于或大于”);该算法是否稳定(6)(选择“是或否”)。
【问题3】用上述希尔排序处理数组(15、9、7、8、20、−1、4),第一趟结束后的数组为(7)。
答案与解析
平台参考答案(原文保留)
【问题1】(8分)
(1)k=k/2
(2)k > 1
(3)data[k] < data[k-dk]
(4)data[j+dk]=t
【问题2】(4分)
(5)小于
(6)否
【问题3】(3分)
(7)(4,9,-1,8,20,7,15)
解析与纠错
四个填空的算法意图依次为k=k/2、k>1、data[k]<data[k-dk]、data[j+dk]=t。先生成整数折半步长,再按每个步长做分组插入;内层循环结束时,j+dk就是暂存值t的插入位置。
n=7时第一趟步长为3。下标0、3、6的组为(15,8,4),排序后变成(4,8,15);下标1、4的组(9,20)不变;下标2、5的组(7,−1)变为(−1,7)。回填原位置得到(4,9,−1,8,20,7,15),与平台答案一致。
平台第(5)空给“小于”,长解析又给约O(n1.3);这不能作为本题折半增量的通用复杂度结论。该增量序列最坏时间为Θ(n2),尤其未指定平均、最好或最坏情形时,不能笼统比较“大O的大小”。例如n为2的幂,偶数位置依次放递增的大数,奇数位置依次放递增的小数:所有大于1的步长都是偶数,各组已各自有序,但最后步长1仍需处理Θ(n2)个逆序。因此应区分平台所填“小于”与最坏情况的二次增长,不能用经验指数覆盖明确的增量条件。
希尔排序不稳定:如带身份标记的(2,1a,1b,0),步长2后可变为(1b,0,2,1a),最终排序得到(0,1b,1a,2),两个1的相对次序已颠倒。题干“最小增量排序”不是常用名称,通常称缩小增量排序。
原页代码还有独立于填空的风险:步长数组生成后没有写入0哨兵,也没有用已生成步长数限制读取,while会继续读未初始化项或越界;n=2时一项数组用完后即访问delta[1],n<2时还可能写入零长度分配区。另有malloc所需声明、头文件写法、分开的“> =”及未释放delta等问题。原页已核实仅有#include < stdio.h >,没有stdlib.h;do/while后直接进入上述读取循环,末尾++i;及两个闭括号后即问题1,没有free或main。这是完整的原题函数片段,错误不能归为遗漏的后续代码。题干名称、复杂度问法和平台“小于、约O(n1.3)”也均已核实。测试用修正版直接按n/2、n/4、…、1迭代步长,避免动态数组和终止哨兵,并处理n<2;整理修正不作为原题原文。
2019年下半年软件设计师案例真题:案例题
本节保留 1 条来源,答案与解析默认收起。
2019-11-case Q004
0-1背包的C程序填空
0-1背包问题给定i个物品的价值v[1…i]、小重量w[1…i](原文写法)和容量T;每件物品只能选择装入或不装入,要求总价值最大。
该问题具有最优子结构。c[i][T]表示最优装包方案的最大价值,递归式如下。
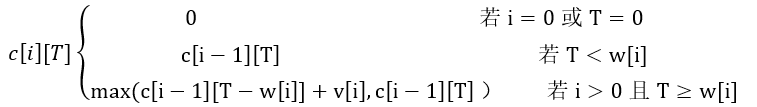
C程序的变量含义:T为背包容量,v[]为价值数组,w[]为重量数组,c[i][j]为前i个物品在容量j时可取得的最大价值。
【问题1】(8分)按说明及C代码填写空(1)~(4)。
【问题2】(4分)算法采用(5)设计策略;求解方向是(6)(选择“自底向上”或“自顶向下”)。
【问题3】(3分)5件物品的数组为v[]={0,1,6,18,22,28}、w[]={0,1,2,5,6,7},背包容量T=11,最大价值为(7)。
答案与解析
平台参考答案(原文保留)
【问题1】
(1)c[i][j]
(2)i > 0&&j > =w[i]
(3)Calculate_Max_Value(v, w, i-1, j-w[i] ) + v[i]
(4)c[i][j]=temp
【问题2】
(5)动态规划
(6)自顶向下
【问题3】
(7)40
解析与纠错
缓存已计算时,(1)返回c[i][j]。先递归求不选第i件的价值,再在放得下时求选入它的价值;所以(2)按平台为i>0&&j>=w[i],(3)为Calculate_Max_Value(v,w,i-1,j-w[i])+v[i]。若后者较大,(4)将temp存入c[i][j]。i>0在该else分支已由边界判断保证,保留它不影响结果。
用缓存消除重复子问题属于(5)动态规划;从(N−1,T)向更小子问题递归,是(6)自顶向下的记忆化搜索。数组0号项是占位,实际物品为1~5。T=11时,选择物品3、4,重量5+6=11,价值18+22=40。若选物品5,剩余容量4最多再取物品1、2,总价值35;不选5而选3、4得40,故(7)为40。
平台答案(2)写成分开的“> =”,C中应写连续的>=。所给程序在调用Calculate_Max_Value之前没有可见的声明,现代C需加函数原型;这属于编译整理,不能伪称仅填空后的原文已可直接编译。原页已核实:stdio/math头文件、N/maxT宏及全局c后直接定义Memoized_Knapsack,确无该函数前置声明;最后return c[i][j];及闭括号后即问题1。所给函数片段完整,不能将这些错误归为后续代码遗漏。
数组第二维maxT=1000,而初始化访问到j=T,故容量有效下标为0~999;T=1000会越界。算法还以非负整数容量、正整数重量及不溢出的价值计算为通常适用条件;题目未明确这些边界,不能擅自在可见题干追加。若允许零重量正价值物品,j=0直接返回0的边界也需要修改。
2019年上半年软件设计师案例真题:案例题
本节保留 1 条来源,答案与解析默认收起。
2019-05-case Q004
n皇后的C程序填空
n皇后问题要求在n×n棋盘上摆放n个皇后,任意两者不在同一行、同一列或同一斜线上。
算法从第1行开始,第i个皇后放在第i行,每行从第1列依次尝试。若与前面皇后不冲突,就放下并尝试下一行;冲突则改试下一列。若本行无可用位置,退回上一个皇后,在其原位置的下一列继续尝试,直至找到全部合理方案。
变量说明:n是皇后数和棋盘边长;queen[]保存摆放位置,queen[i]为第i个皇后的位置,满足1≤queen[i]≤n。C程序如下。
【问题1】(8分)根据说明填写C代码空(1)~(4)。
【问题2】(3分)算法采用的设计策略为(5)。
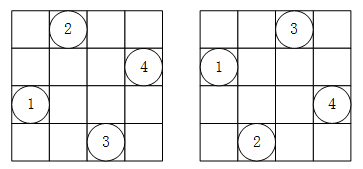
【问题3】(4分)n=4时共有(6)种摆放方式,分别为(7)。
答案与解析
平台参考答案(原文保留)
【问题1】
(1)queen[i]==queen[j]或其等价形式
(2)1
(3)Place(j)或其等价形式
(4)Nqueen(j+1)
【问题2】
(5)回溯法
【问题3】
(6)2
(7)(2413)或(2,4,1,3)
(3142)或(3,1,4,2)
解析与纠错
queen[j]表示第j行皇后所处的列;逐行摆放已保证行不同。对前面第i行检查时,同列冲突为queen[i]==queen[j],斜线冲突为两列差的绝对值等于行差j−i,所以(1)填同列条件。所有检查通过后(2)返回1;(3)调用Place(j)验证当前摆放,未到最后一行则(4)调用Nqueen(j+1)。依次试列、失败返回上一层,是(5)回溯法。
n=4只有(6)两种结果:(7)为(2,4,1,3)和(3,1,4,2),序列按行列出列号,不能把顺序当成任意可交换的集合。原解析的答案图如下,仅在展开后查看。
所给C代码的头文件名空格、分开的< =、表示逻辑或的‖需要分别整理为标准头文件、<=、||,abs还需stdlib.h声明。只有填四空不能修复这些独立问题;测试版本明确补充编译依赖并修正排版,题面仍保留原写法。原页已核实仅有stdio头文件,没有stdlib;i < =n、‖均为原写法。Show、Place、Nqueen与main完整,Nqueen(1);return 0;}后即问题1,没有遗漏后续代码。
2018年下半年软件设计师案例真题:案例题
本节保留 1 条来源,答案与解析默认收起。
2018-11-case Q004
RNA最大配对的C程序填空
给定字符序列B=b1b2…bn,每个bi∈{A,C,G,U}。二级结构S是一组字符对{(bi,bj)},i、j∈{1,2,…,n},满足以下四项条件。
- 每对字符只能为(A,U)、(U,A)、(C,G)、(G,C)之一。
- 配对字符之间至少隔四个字符,即i < j−4。
- 对每个字符bk,题目列出两种配对情形:不参与配对,或与满足t < k−4的字符bt配对。
- 配对不交叉:若(bi,bj)与(bk,bl)均在S中且i < k,则不得出现i < k < j < l。
字符对数最多的S称为最优配对方案。用C(i,j)表示子序列bibi+1…bj的最大配对数,原题给出如下递归式。
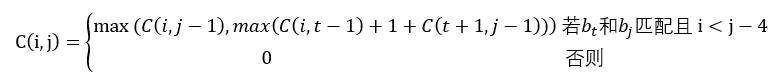
C程序中,n是序列长度,B[]保存字符序列,C[][]保存最优配对数量。
【问题1】(8分)填写C代码空(1)~(4)。
【问题2】(4分)算法设计策略为(5),时间复杂度为(6)(用O表示)。
【问题3】(3分)字符序列ACCGGUAGU按上述算法求得的最大字符对数为(7)。
答案与解析
平台参考答案(原文保留)
【问题1】
(1)max=C[i][j-1]
(2)t=i
(3)isMatch(B[t],B[j]),或isMatch(B[t],B[j])==1,或与其等价的形式
(4)C[1][n]
【问题2】
采用的算法策略:动态规划法
时间复杂度:O(n 3)
【问题3】
最大字符对数:2
解析与纠错
先假设右端字符j不配对,(1)令max=C[i][j-1];(2)从t=i枚举候选。若bt与bj匹配,(3)调用isMatch(B[t],B[j]);选这对后,不交叉条件把其余问题分为[i,t−1]与[t+1,j−1],总数加1。最后(4)返回C[1][n]。
(5)为动态规划。外层按区间长度增加,中层枚举左端,内层枚举配对点,故(6)时间为O(n3),表空间O(n2)。原解析把j范围写到n−1、把k起点写成6,均与代码不同;代码k从5到n−1,j最多到n。
原题配对间至少四个字符,要求j−t≥5,即t<j−4。但代码写t<=j−4,会允许只隔三个字符,不能用正确的填空掩盖这个循环边界错误。例如CACCCU中,A在位置2、U在位置6,只隔3个字符;题意最大配对为0,原循环却返回1。学习修正版将内层条件改成严格小于,并与独立枚举核对。
原公式图没有写出内层max的完整t范围,而且把“有匹配”放在整个分段条件中;严谨递推应始终保留不配对项C(i,j−1),再对i≤t<j−4且两字符匹配的候选取最大值,短区间或空区间为0。文字第3项按“以右端字符作是否配对分类”理解,核心是每个位置至多参与一对,不能让一个字符重复使用。
给定ACCGGUAGU可取(1,9)与(2,8),或(1,9)与(3,8),所以(7)为2;两组均满足正确间距和不交叉。该例没有暴露上述边界错误。平台长解析“不交叉”段还写“位置能交叉”,与规则相反,应为不能交叉。
原页已核实文字条件i<j−4、k从5开始及内层t<=j−4,等号与全角分号确为原写法。头文件空格、弯引号等排版问题只在测试版明确整理。函数以return(4);及闭括号结束后即问题1,没有后续main或数组初始化代码;该函数来源完整。代码按1开始访问B、C;LEN=100时应限制n≤99,并在输入中留出0号位置,不能直接将普通从0开始的字符串当作同一布局。
2018年上半年软件设计师案例真题:案例题
本节保留 1 条来源,答案与解析默认收起。
2018-05-case Q004
钢条切割收益的C程序填空
某公司购买长钢条,切割后出售,切割成本忽略不计,长度以整英寸计。价格表p中,pi(i=1,2,…,m)表示长度i英寸钢条的价格,求最大销售收益对应的切割方案。
对于长n英寸的钢条,先令最左段长i英寸,再求余下n−i英寸的最佳切割方案;枚举所有i以得到最大收益rn。原题递推式为:
rn=max1≤i≤n(pi+rn−i)
以下C代码分别采用自顶向下、自底向上方式实现。
【问题1】(8分)填写C代码中的空(1)~(4)。
【问题2】(7分)算法采用的设计策略为(5);求rn时,自顶向下方法的时间复杂度为(6),自底向上方法为(7),均用O表示。
答案与解析
平台参考答案(原文保留)
【问题1】
(1)i < =n
(2)i < =j
(3)(temp > =p[i]+r[j-i])?temp:(p[i] + r[j - i])或其等价形式
(4)r[j] = temp
【问题2】
(5) 动态规划法
(6)O(2 n)
(7)O(n 2)
解析与纠错
(1)枚举第一段长度1~n,填i<=n;(2)求长度j的最优值时枚举1~j,填i<=j。(3)比较本轮已有最大值temp与p[i]+r[j−i];(4)把最大值存入r[j]。相同子问题的最优值能够用于更长钢条,平台(5)归为动态规划。
但所示Top_Down_Cut_Rod没有记忆表,每次都会重算子问题,是朴素递归;不能因为写着“自顶向下”就说已经记忆化。其递归调用数满足A(0)=1、A(n)=1+ΣA(k),k从0到n−1,所以A(n)=2n,(6)为O(2n)。Bottom_Up_Cut_Rod把子问题值保存在r中,两重循环共n(n+1)/2次,(7)为O(n2);按n扩展数组时辅助空间为O(n),递归版栈深也是O(n)。
函数定义Top_Down_ Cut_Rod含空格,与递归调用名不同;分开的<=、>=和全角冒号不能作为对应的C运算符直接编译,测试版明确整理。平台长解析还把(3)三目式写成不配对括号,参考答案中的三目式结构才是有效表达式。原页已核实这些字形;仅有LEN常量定义,无头文件,也未补充m≥n约束。第二函数以return r[n];及闭括号结束后即问题1,没有main、初始化或记忆表,来源完整。
价格只给到m,循环却访问到n,使用原代码需保证0≤n≤m;r[LEN]的LEN=100还要求n≤99。初始化最优值为0隐含价格非负或允许放弃销售;若要求全部钢条出售且价格可为负,n=1、p[1]=−5时原代码返回0而不是−5。题干未给负价情形,例子仅用于说明实现适用条件,不能补进题干。int相加还应处于可表示范围,题面没有给出溢出处理。
2017年下半年软件设计师案例真题:案例题
本节保留 1 条来源,答案与解析默认收起。
2017-11-case Q004
Hamilton回路的C程序填空
无向连通图G中的哈密尔顿(Hamilton)回路,从某一顶点出发,将其余所有顶点各访问一次且仅一次,最后回到出发点。
设存在从V0出发的回路V0—V1—…—Vn−1—V0。算法从V0访问未访问的邻接顶点V1,再逐步访问后续未访问邻点;对Vi,若全部邻点均已访问,就退回Vi−1并尝试其下一个未访问邻点,仍记为Vi,直至找到一条回路或确定找不到。
变量说明:n为顶点数,c[][]为邻接矩阵;k为统计变量,原题称当前已访问顶点数为k+1;x[k]保存第k个访问的顶点编号,从0开始;visited[x[k]]取0表示未访问,取1表示已访问。
C程序如下。
【问题1】(10分)填写C代码空(1)~(5)。
【问题2】(5分)算法采用的设计策略为(6);遍历图顶点采用(7)方法,选择深度优先或广度优先。
答案与解析
平台参考答案(原文保留)
【问题1】 1、visited[0] = 1 2、visited[x[k]] == 0 3、c[x[k]] [0]== 1 4、visited[x[k]] = 1 5、k = k - 1 【问题2】 6、回溯法 7、深度优先
解析与纠错
(1)将起点visited[0]设为1;(2)要求候选visited[x[k]]为0;(3)检查最后顶点到0的边;(4)选择顶点后将其访问标志设为1;(5)将k减1退回上一层。(6)为回溯法,沿一条路径深入再撤销选择,(7)为深度优先。
正确填空并不能消除原循环的缺陷。回退分支先令x[k]=0,再清visited[x[k]],实际清除的是visited[0];上一层已选顶点仍被标记,换分支时无法再次使用。另一个边界是while(k>=0):退到k=0后,若候选顶点仍未访问,&&的右侧会读取x[k−1],触发负下标访问;若左侧均为假,短路会避开这一访问,但并不修复漏解。修正版需在回退时撤销上一层选择,并在退回固定起点后结束搜索;这些是循环修正,不替换平台五个填空。
例如无向图边集{0–1,0–2,0–3,1–2,1–3}存在回路0–2–1–3–0。原程序先试0–1–2,失败后没有清除正确的访问标记,会阻塞后续合法分支;不能因一次试探失败就说图没有回路。
原C还有stido.h/stidb.h拼写、for初始化后的冒号、全角标点、弯引号、分开的>=与缺少分号等问题;第(4)空所在行和平台该项答案都没有分号,编译测试需明确补齐。原页已核实这些符号和回退顺序;顶层首次x[k]=x[k]+1有分号,else中该语句缺分号。函数末三个闭括号后即问题1,没有main或后续代码,函数来源完整。测试只对简单无向图、3≤n≤100验证回路语义;原实现没有给n的合法性检查,使用固定MAX数组必须满足容量限制。
2017年上半年软件设计师案例真题:案例题
本节保留 1 条来源,答案与解析默认收起。
2017-05-case Q004
查找较轻假币的C程序填空
有n枚硬币,其中恰好一枚是假币,且已知它较轻;只能使用天平,要求尽量少比较以找出假币。题目给出的处理方法如下。
- n为偶数:比较第1…n/2枚与第n/2+1…n枚,两组数量相等;在较轻的一组继续同样处理。
- n为奇数:比较第1…(n−1)/2枚与第(n+1)/2+1…n枚;若不等重,在较轻一组继续处理;若等重,则第(n+1)/2枚是假币。
以下为C程序。coins[]保存硬币,first、last分别是本次考虑区间的第一个、最后一个下标。
【问题1】(6分)根据说明填写代码空(1)~(3)。
【问题2】(6分)填写设计策略( ),以及getCounterfeitCoin的时间复杂度( )(用O表示)。
【问题3】(3分)输入30枚硬币,最少比较次数为( ),最多比较次数为( )。
答案与解析
平台参考答案(原文保留)
【问题1】
(1)first+(last-first)/2+1 或(first+last)/2+1
(2)firstSum < lastSum
(3)first+(last-first)/2 或(first+last)/2
【问题2】
(4)分治法
(5)O(lgn)
【问题3】
(6)2 (7)4
解析与纠错
令mid=first+(last−first)/2。偶数区间的左半部含mid,循环使用严格小于,所以(1)填mid+1;左半总重量较轻时递归左半,故(2)是firstSum < lastSum;奇数时两侧等重,假币就是中间位置,故(3)填mid。题目通常把不断分成更小子问题的策略归为分治法;这里每次实际只继续一个子区间。
平台复杂度O(lgn)与给定C代码不符。每层两个for合计读取当前区间的n或n−1枚硬币,即Θ(n)工作;最坏递推T(n)=T(⌊n/2⌋)+Θ(n),总和n+n/2+n/4+…=Θ(n)。O(log n)描述递归层数和天平称量次数的量级,不是逐枚求和实现的总运行时间。平台原答案保留,代码时间复杂度应为O(n)。
按题目二分称量法,30→15:第一次15比15;第二次7比7若平衡,中心那枚是假币,最少2次;不平衡继续7→3,再比较1比1,最多4次。这里一次比较指天平称量,不是把C中if和循环判断逐条计数。题首“尽量少”也不能证明二分法对所有n都全局最优:例如9枚可三等分,最坏2次即可;原二分法最坏需3次。
原代码两条偶数分支递归调用把分号放入参数括号,末尾return空所在行没有分号,另有头文件内部空格与全角逗号。编译用整理版只修这些语法,不改变分支和区间。单枚区间虽然没有显式基例,但两个求和循环都不执行,落入等重分支仍返回该下标;空区间未定义,不纳入题目恰有一枚假币的条件。
原站可见页面截图已核实,两条偶数分支return的分号均位于右括号前,末尾return空所在行没有分号;三个闭括号之后直接是问题1,没有其他基例或后续代码。平台参考答案确为O(lgn)。来源完整;称重次数的O(log n)与逐元素求和代码整体的Θ(n)应分别理解,语法整理不冒充原题。
2016年下半年软件设计师案例真题:案例题
本节保留 1 条来源,答案与解析默认收起。
2016-11-case Q004
字符串匹配的C程序填空
模式匹配是在主串t中寻找子串s;s称为模式,成功返回其在t中的位置,否则返回−1。KMP用next数组优化匹配,给定过程如下。
- 初始化比较下标i=j=0。
- t、s均仍有待比较字符时循环:若j=−1或t[i]=s[j],i、j各加1,继续比较后续字符;否则令j=next[j],原题称将j向右滑动到next[j]的位置。
- s全部比较完时,返回匹配起点,位置从1开始计;否则返回−1。
get_next已给出,用于从模式s计算next。t、s长度分别为lt、ls,next数组长度为ls。C程序如下。
【问题1】(8分)根据说明填写代码空(1)~(4)。
【问题2】(2分)主串、子串长度分别为lt、ls,用O记号填写kmp算法时间复杂度(5)。
【问题3】(5分)按代码计算字符串“BBABBCAC”的next数组(6),直接写元素值、以逗号分隔。主串为“AABBCBBABBCACCD”、子串为“BBABBCAC”时,函数Kmp的返回值为(7)。
答案与解析
平台参考答案(原文保留)
【问题1】 (1):j < ls; (2):t[i]==s[j]; (3):j=next[j]; (4):i-ls+1 或其等价形式; 【问题2】 (5)O(It+Is) 【问题3】 (6):[-1,-1,1,-1,-1,2,0,0],(7)6。
解析与纠错
(1)要求j < ls,(2)比较t[i]与s[j],失配时(3)将j回退到next[j];主串下标i不回退。完成匹配后j达到ls,i已指向刚匹配区间之后的位置,所以0起始下标为i−ls,题目按1计数则(4)为i−ls+1。平台解析说i指向最后一个已匹配字符不准确,但其返回公式是对的。原题“j向右滑动”指模式相对主串右移,j的数值通常减小,不是数值递增。
get_next中遇到相同字符会继续沿失败链接跳过,因此这里计算的是优化失败表,通常称nextval,不能套用未经优化的next表。模式BBABBCAC得到−1,−1,1,−1,−1,2,0,0;在AABBCBBABBCACCD中从第6个字符起匹配,返回6。
预处理失败表耗时O(ls),匹配过程i不回退,总耗时O(lt),包含预处理的KMP为O(lt+ls),与平台通常口径一致。给出的kmp函数已接收next数组,若单独衡量该函数,预处理不在函数体内;平台O(lt+ls)仍是上界,宜说明采用的计时范围。
原get_next的while(i < ls)存在边界问题:最后一次i++使i变为ls后,循环体不会立即停止,仍比较s[i]并写next[i],而题目只给next分配ls项。即使C字符串有末尾空字符可读,next[ls]仍越界;平台长解析把i加到ls后直接视作退出循环,漏看了本轮剩余语句。语法整理版已用地址检查确认写越界。明确修正版可将预处理循环限制为i < ls−1,仅填0…ls−1的表项;平台给出的八个值与该修正版一致,表值正确不代表原程序内存安全。
此外原条件j==-1l ls[i]、Next/Int/Is大小写、头文件空格、全角逗号及分开的>=不能直接照抄编译。测试分别保存原式、语法整理版和边界修正版,不将补正当原题。验证覆盖非空模式;空模式的语义和next容量需另作接口约定,原题未提供该边界处理。
原站可见页面截图已核实,get_next的while(i < ls)、字母l似符号的条件、Next/Int/Is字形及分开的>=均为原题写法;i递增后没有提前退出,继续比较字符并写next[i]。return -1及函数闭括号后直接是问题1,没有main或后续代码,来源完整。平台复杂度原文写O(It+Is),题干长度变量为lt、ls;这里按两串长度说明复杂度,不改原答案字形。
2016年上半年软件设计师案例真题:案例题
本节保留 1 条来源,答案与解析默认收起。
2016-05-case Q004
电路板不相交连线的C程序填空
电路板上下各有n个接线柱,连线(i,π(i))把上端i与下端π(i)连接,称第i条连线。图4-1的排列为{8,7,4,2,5,1,9,3,10,6}。对任意1≤i < j≤n,两条连线相交当且仅当π(i) > π(j)。
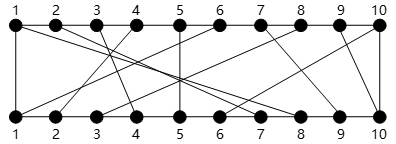
制作电路板时,将n条连线分配到若干绝缘层,同层连线不能相交。现需选择一层上的连线,使其数量最多,即求Nets={(i,π(i)),1≤i≤n}的最大不相交子集。
记N(i,j)={t | (t,π(t))∈Nets,t≤i,π(t)≤j},其最大不相交子集为MNS(i,j),size(i,j)=|MNS(i,j)|。问题具有最优子结构,递推式如下。
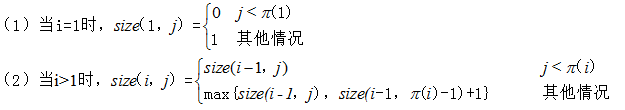
C实现中,size[i][j]表示上端前i个、下端前j个接线柱范围内第一层最大不相交连接数;pi[i]对应π(i),下标从1开始。
【问题1】(6分)根据说明与代码填写空(1)~(3)。
【问题2】(6分)算法采用的设计策略为(4);maxNum、constructSet的时间复杂度分别为(5)、(6),用O表示。
【问题3】(3分)对图示排列{8,7,4,2,5,1,9,3,10,6},最大不相交连接数为(7),包含的连线为(8),用(i,π(i))形式列出。
答案与解析
平台参考答案(原文保留)
【问题1】
(1)size[1][j]=1
(2)size[i][j]=size[i-1][j]
(3)net[m++]=i;
【问题2】
(4)动态规划法
(5)O(n 2)
(6)O(n)
【问题3】
(7)4
(8)(3,π(3),(5,π(5)),(7,π(7)),(9,π(9))
或:(3,4),(5,5),(7,9),(9,10)
解析与纠错
依上端序号从小到大取连线,其下端序号必须严格递增,才能两两不相交。递推区分第i条是否加入:j < π(i)时不能选它,沿用上一行;否则在“不选”的size[i−1][j]和“选”的size[i−1][π(i)−1]+1之间取大。
i=1时,j能覆盖π(1)就只有一条可选,所以(1)填size[1][j]=1;(2)沿用size[i−1][j];回溯确定选第i条时,(3)把i记入net[m++],再令j=π(i)−1以排除相交候选。平台第(3)项已带分号,代码空后也有分号,整理时只需一个;原答案字样保留。
该算法采用动态规划。maxNum填二维状态,为O(n2);constructSet只沿i逆序走一次,为O(n)。原实现只单独计算第n行的size[n][n],并未漏算回溯需要的整行:第一次从(n,n)决策后即进入第n−1行,后续所需行都已计算。
给定排列的最优值是4;代码回溯依次得到上端9、7、5、3,按升序写即(3,4)、(5,5)、(7,9)、(9,10)。最优子集可能不唯一,例如上端4、5、7、9也可形成四条不交叉连线;题答给出的是其中一组,不宜把其他最优组一概判错。平台第一套π记号的首项少一个右括号,后面的明确数对无歧义。
原代码中的全角符号、分开的比较运算符和头文件空格需整理才能编译,原文仍保留。此外,若将此函数推广到n=1,第一行初始化后又用第0行覆盖size[1][1],而函数从未初始化第0行;题给n=10不受此边界影响。明确边界修正版可在第一行初始化后直接处理n=1并返回,不能宣称原程序对任意规模都已完整处理。
仅整理语法的版本已对n=2..8全部46,232个排列,用独立子集穷举验证最优值及回溯不相交性;增加单元素处理的版本覆盖n=1..8共46,233个排列。另核对n=10给定例、递增和递减排列,地址与未定义行为检查通过。
原站可见页面已核实上述循环边界、单独计算末项、原标点及函数结尾;已有首行初始化保留,结尾没有额外初始化或单元素处理。原解析首个π数对的右括号缺失也已确认。 参考答案(8)的第一套π记号也已核实首项缺右括号;其后明确数对完整,原答案两种写法均保留。
补充说明
平台解析给出的最优连线示意图,红线表示其所选的一组答案:
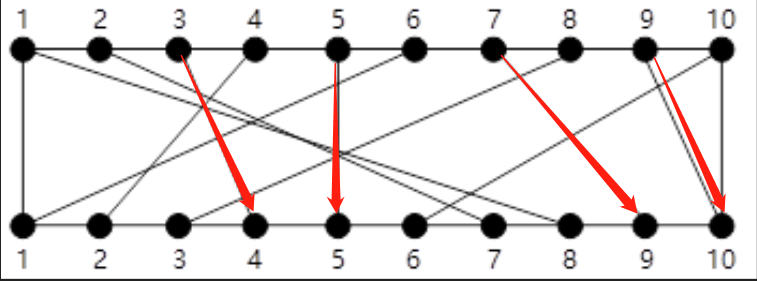
2015年上半年软件设计师案例真题:案例题
本节收录 1 道案例,答案与解析默认收起。
2015-05-case Q004
皇后摆放的C程序
在n行n列的棋盘上放置n个皇后,任意两个皇后不能在同一行、同一列或同一条对角线上。
第i个皇后固定放在第i行。从第一行开始,每个皇后由第一列向后尝试:若不与已放置皇后冲突,则确定位置并考虑下一行;冲突就尝试下一列;超过最后一列则回到上一行重新选择。重复直到找出全部方案。
变量含义:pos是一维数组,pos[i]记录第i行皇后所在的列;count统计方案数;i、j、k为变量;N为皇后数。所给C程序如下:
【问题1】(10分)根据说明和代码填写(1)~(5)。
【问题2】(2分)算法采用的设计策略是(6)。
【问题3】(3分)上述代码的输出为(7)。
答案与解析
平台参考答案(原文保留)
【问题1】
(1)pos[i] ==pos[k]
(2)j=1
(3)isplace(pos,j)==0
(4)j < N
(5)j=j-1
【问题2】
(6)回溯法
【问题3】
(7)
方案1:2 4 1 3
方案2:3 1 4 2
解析与纠错
每行只放一个皇后,因此还需排除同列和同对角线:第(1)空为pos[i]==pos[k],对角线由行差绝对值等于列差绝对值检查。第(2)空j=1,从第一行开始;第(3)空isplace(pos,j)==0表示当前位置冲突,需要继续增加列号;第(4)空j<N表示仍有下一行;第(5)空j=j-1回退上一行。
这是一种回溯搜索。位置合法就深入下一层,无可用列就撤销当前行并退回;列号按升序尝试,因此四皇后两组输出依次为2 4 1 3和3 1 4 2。
找到最后一行的一个解后立即回退,并不会漏掉同一前缀下的第二个解:前N−1行已有互不相同的N−1个列号,最后一行至多只剩一列可选。这一论证依赖每行、每列都只放一个皇后。
补充说明
原代码问题与修正条件:原题确实写作“#define N4”,N和4之间没有空格;两处“══”是相连双长横线,并非标准C的==。全角分号与拆开的“< =”“> =”也按原样保留,直接填入答案仍不能编译。上面的方案须按N=4及标准C标点、比较运算符解释,这些是明确的语法修正,不是原题原文。
第(3)空后的“_”表示填空横线向右延伸,不是变量名中的下划线,也不是需要补入的C符号。题面保留这一文本表示;把答案写入程序执行时应去除该填空标记。main在return 1及闭括号后即结束,没有遗漏后续代码;return 1使程序即使已打印正确方案,仍返回非零进程状态。
下面给出修正上述语法、填入答案并移除填空标记后的完整演示程序;它不是原题逐字原文。N=1~10已与独立求解程序比较,结果数依次为1、0、0、2、10、4、40、92、352、724。
四皇后的示意图如下: