计算机组成与体系结构:课件整理与例题解析
本篇将本章的课程提要、10 个知识主题和章节回顾合并整理。教学图片来自课件,已下载到本地;保留原题及选项并统一编号,折叠区域中的**参考答案与推导由本笔记补充,并非课件提供的官方答案**。原图中的笔误、简化说法和历史考试口径在相邻正文中说明。
本章的学习主线是:先理解数如何编码与校验,再理解 CPU、存储器和外设怎样协作,最后计算指令执行性能与系统可靠性。课件中的星级仅代表讲义的复习建议,不代表固定考试分值。
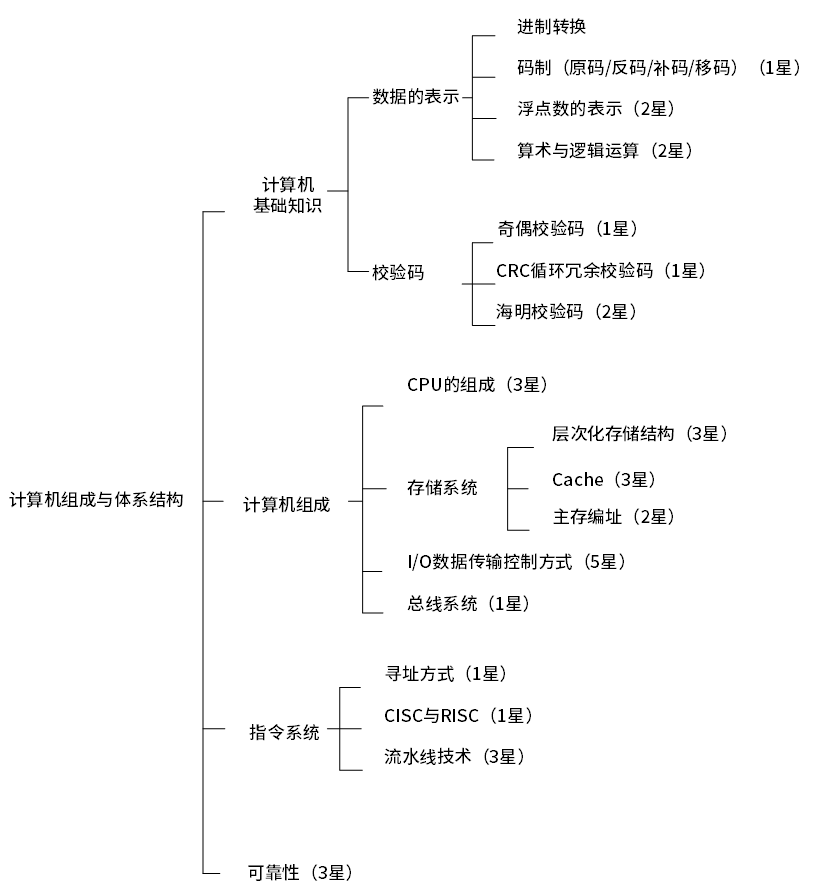
一、数据的表示
进制转换:位权、除基取余与分组
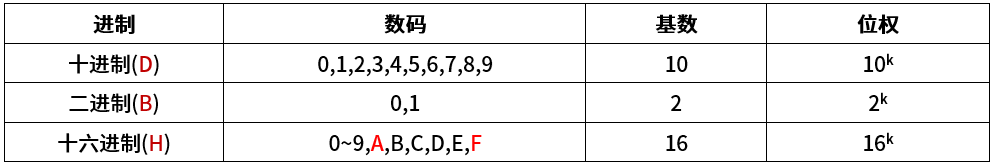
R 进制中每位数字只能取 0~R−1。小数点左侧最低位的位权是 R0,向左依次为 R1、R2;右侧依次为 R−1、R−2。十六进制 A~F 分别代表十进制的 10~15。
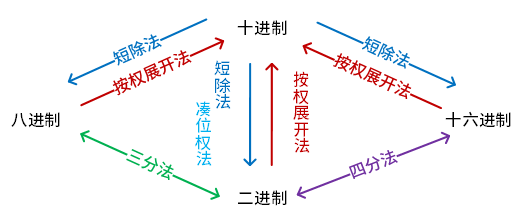
| 转换方向 | 方法 | 注意事项 |
|---|---|---|
| R 进制 → 十进制 | 各位数字乘位权,再相加 | 小数位使用负指数 |
| 十进制整数 → R 进制 | 反复除以 R,直到商为 0 | 余数从后往前读 |
| 十进制小数 → R 进制 | 小数部分反复乘以 R,依次取整数部分 | 顺序读取;可能无限循环,需约定精度 |
| 二进制 ↔ 八进制 | 每 3 个二进制位对应 1 个八进制位 | 从小数点向两侧分组 |
| 二进制 ↔ 十六进制 | 每 4 个二进制位对应 1 个十六进制位 | 整数端向左补 0,小数端向右补 0 |
按权展开的原例:
111B = 1×2² + 1×2¹ + 1×2⁰ = 7D。10100.01B = 2⁴ + 2² + 2⁻² = 20.25D。604O = 6×8² + 4×8⁰ = 388D。
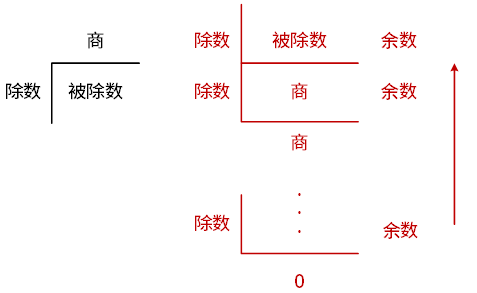
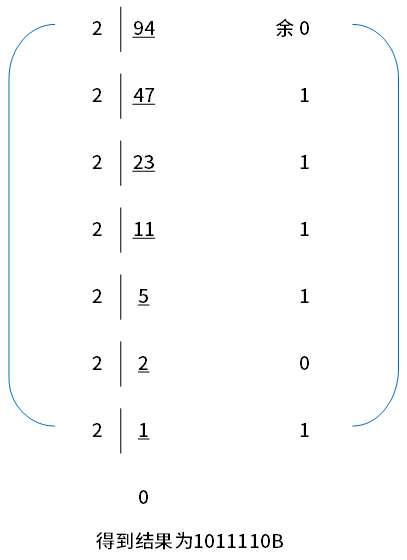
94 = 64+16+8+4+2,因此 94D = 1011110B;按 8 位写为 01011110B。除基取余法适用于整数部分,不能直接拿来处理小数部分。
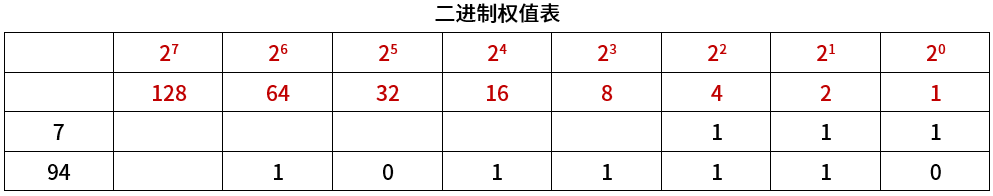
原思考:IP 地址中 192D 转换为二进制是多少?
参考答案与推导
192 = 128+64,因此按 8 位表示为 11000000B。按 IPv4 的一个字节写数时,应保留到 8 位。
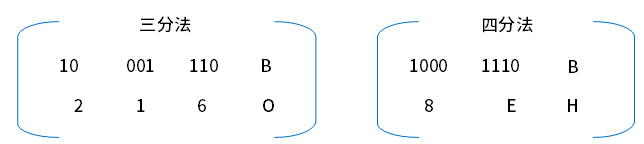
图中的同一个二进制数 10001110B,三位分组为 010 001 110,得到 216O;四位分组为 1000 1110,得到 8EH,十进制值均为 142。
原思考:内存地址中 31B5H 转换为二进制是多少?
参考答案与推导
逐位替换:3 → 0011、1 → 0001、B → 1011、5 → 0101。
因此为 0011 0001 1011 0101B,十进制值是 12725。
原码、反码、补码和移码
先确定**位数、编码方式和小数点位置**,再解释一个比特串。以 n 位有符号整数为例:
| 编码 | 编码规则 | 零的编码 |
|---|---|---|
| 原码 | 最高位表示正负,其余位表示绝对值 | 正零和负零两种 |
| 反码 | 非负数与原码相同;负数保持符号位,数值位取反 | 正零和负零两种 |
| 补码 | 非负数与原码相同;负数在反码基础上加 1,保留 n 位 | 只有一种零 |
| 移码/偏置码 | 编码值=真值+约定偏置 | 在此处的完整整数编码范围内,零只有一种编码 |
“补码翻转最高位得到移码”有前提:两者位数相同,移码偏置为 2n−1。 一般移码并不保证满足此口诀。偏置码的最高位也不宜继续简单解释为“0 正、1 负”的符号位。
例如,8 位整数 −1 的原码、反码、补码分别为 10000001、11111110、11111111;使用偏置 128 的移码为 01111111。
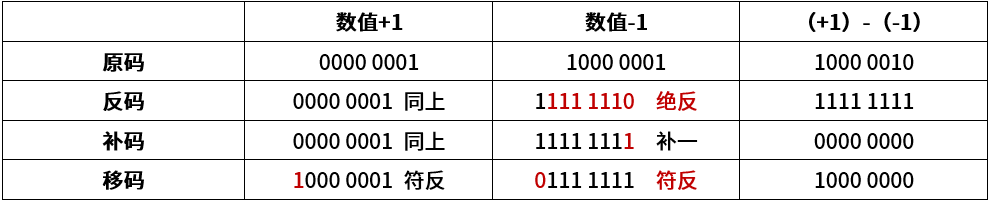
图中最后一列表头写成
(+1)−(−1),却给出补码00000000等结果,表头与内容不一致。真正的1−(−1)=2;1+(−1)=0。也不能把原码、移码当成普通无符号数直接相加而不作编码处理。该列不作为正确运算示例。
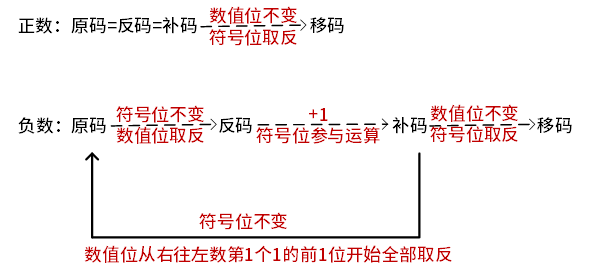
补码的符号位参与加法;最终结果需要保留规定字长并判断有符号溢出。最小负数 −2^(n−1) 没有同字长的原码表示,不能强行套用“先写原码再取反加一”的步骤。对 n 位补码串,若按无符号解释得到 u,则最高位为 1 时真值为 u−2ⁿ。
补码还有一个硬件上的用途:把减法统一为加法。在 n 位结果按模 2ⁿ 保留的前提下,A−B 可由 A+[−B]补 实现,符号位也一起参与运算。例如 8 位的 9−5 可算为 00001001+11111011,舍去最高进位后为 00000100,即 4。这样可复用加法器,不代表增加了有效位数或消除了溢出。
最高位的进位与有符号溢出不是一回事。 补码加法中,两个同号数相加却得到异号结果,表示有符号溢出;异号相加不会有这种溢出。例如 8 位 100+40 得到位串 10001100,解释为 −116,说明真实结果 140 超出了 −128~127,而不能把 −116 当作正确数学结果。
例题 1:由补码求真值
如果“2X”的补码是“90H”,那么X的真值是( )。
A、72
B、-56
C、56
D、111
参考答案与解析
答案:B,−56。
题目用两位十六进制数表达补码,按 8 位有符号整数理解。90H=144,最高位为 1,因此 2X=144−256=−112,得到 X=−56。不要把 90H 直接按无符号 144 代入。
定点整数与定点小数的范围
n 包含一个符号位;纯小数约定有 n−1 位小数。这里移码使用与补码对应的半量程偏置。
| 编码 | 定点整数范围 | 纯小数范围 | 不同数值的个数 |
|---|---|---|---|
| 原码、反码 | −(2n−1−1) ~ 2n−1−1 | −(1−2−(n−1)) ~ 1−2−(n−1) | 2n−1 |
| 补码、上述移码 | −2n−1 ~ 2n−1−1 | −1 ~ 1−2−(n−1) | 2n |
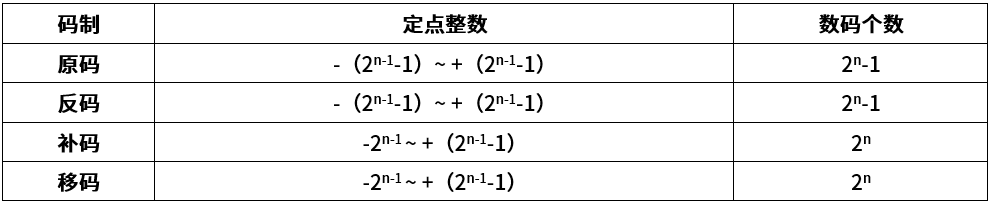
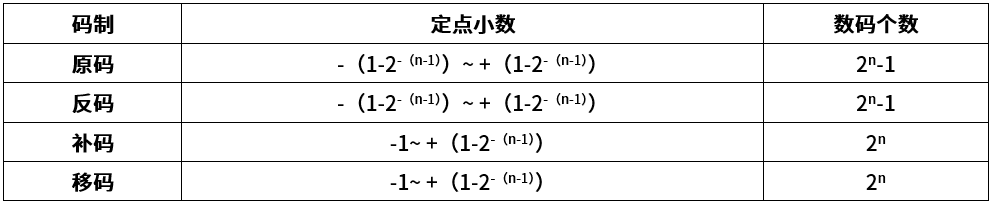
图中“数码个数”宜理解为**不同数值的个数**。n 位始终有 2n 个比特串;原码和反码将两个比特串解释为零,所以少一个不同数值。
例如 n=4,原码整数为 −7~7,补码整数为 −8~7;原码纯小数为 −7/8~7/8,补码纯小数为 −1~7/8,步长为 1/8。
例题 2:补码的最小负数
采用n位补码(包含一个符号位)表示数据,可以直接表示数值( )。
A、2 n
B、-2 n
C、2 n-1
D、-2 n-1
参考答案与解析
答案:D,−2n−1。
按定点整数理解,n 位补码范围是 −2^(n−1)~2^(n−1)−1。最小值的编码为 100…0,最大正数比 2^(n−1) 少 1。
浮点数:阶码管范围,尾数管精度
抽象形式为 N = 尾数 × 基数^阶码。在基数、规格化等其他规定相同时,阶码位数较多通常意味着范围较大,尾数有效位较多意味着精度较高。
加减运算通常经过:对阶 → 尾数加减 → 规格化 → 舍入 → 溢出等异常检查。对阶是“小阶向大阶看齐”,把阶码较小的一方尾数右移;原文“小数向大数看齐”容易误解为比较数值大小。
例如 1.23×10² + 3.2×10⁴ = (0.0123+3.2)×10⁴ = 3.2123×10⁴ = 32123。实际机器尾数位有限,右移和舍入可能损失精度。
不要把教学模型与 IEEE 754 混用。 教学题可以指定“阶码用补码、尾数用原码”;IEEE 754 的常见 binary32/binary64 则使用独立符号位、偏置指数和尾数字段:
- binary32 指数字段为 8 位,偏置是 127,不是 128。
- binary64 指数字段为 11 位,偏置是 1023,不是 1024。
- 对规格化数,指数值为“指数字段值−偏置”;全 0、全 1 指数字段有非规格化数、零、无穷与 NaN 等专门含义。
- 因此不能用“把同位数补码符号位翻转”来计算 IEEE 754 指数字段。例如 binary32 指数 −1 编码为
126 = 01111110B,而 8 位补码 −1 翻最高位得到的是01111111B,两者不同。
拆解自定义浮点格式时,先把阶符与阶码数值位合成完整的阶码,再独立解释数符和尾数,最后相乘。规格化要求尾数满足指定形式,以便充分利用有效位;在常见二进制原码纯小数模型中,非零尾数的绝对值为 0.1…₂,对应 1/2≤|M|<1。允许非规格化时不能擅自补前导 1;补码尾数的规格化规则也要按所给格式判断。
求整体极值要组合两部分的范围,而不只是数阶码位数。例如某教学格式的阶码共 5 位、采用偏置 16 的移码,最大指数为 15;尾数为含符号位的 7 位补码纯小数,范围是 −1~1−2⁻⁶。若格式无保留编码,则最小值为 −2¹⁵,最大值为 (1−2⁻⁶)×2¹⁵。这里的“最小值”是最负的数;最小正数还取决于最小指数、是否要求规格化及是否允许非规格化。
常见的**补码纯小数尾数**要求非零规格化结果的符号位与小数点后首位不同:正数为 0.1…,负数为 1.0…,即 1/2≤M<1 或 −1≤M<−1/2。原因是 0.0… 或 1.1… 仍有可以消去的冗余符号位。例如 4 位尾数 1.100 表示 −½,尚未规格化;变为 1.000(−1)并把阶码减 1,数值保持不变。判断的是尾数自身的两位,不是比较阶符与数符;零另作特殊处理。
左规使尾数左移、阶码减小;右规使尾数右移、阶码增大。 例如正尾数相加后暂得 1.01₂×2³,右规为 0.101₂×2⁴,两者都是 10;若最大允许阶码为 3,这次右规就会造成阶码上溢。相减后暂得 0.001₂×2³,则左移两位为 0.1₂×2¹,两者都是 1,阶码过小时可能下溢。这里展示数学尾数,临时结果需有足够位数,不能先按最终字长截断再规格化。舍入也可能产生进位并再次要求右规;尾数进位与最终阶码上溢应分别判断。
例题 3:浮点范围与精度
对于长度相同但格式不同的两种浮点数,假设前者阶码长、尾数短,后者阶码短、尾数长,
其他规定都相同,则二者可表示数值的范围和精度情况为( )。
A、二者可表示的数的范围和精度相同
B、前者所表示的数的范围更大且精度更高
C、前者所表示的数的范围更大但精度更低
D、前者所表示的数的范围更小但精度更高
参考答案与解析
答案:C,前者范围更大但精度更低。
其他格式规定相同时,阶码长意味着可覆盖更宽的指数范围;尾数短意味着保留的有效数字较少。不要把“能表示很大的数”误认为“能精确表示更多末位”。
例题 4:按字段还原浮点值
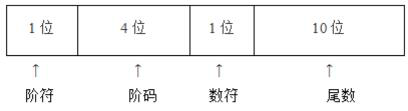
某种机器的浮点数表示格式如下(允许非规格化表示)。若阶码以补码表示,尾数以原码表示,则1 0001 0 0000000001表示的浮点数是( )。
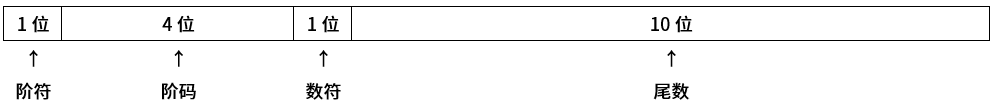
A、2 -16 ×2 -10
B、2 -15 ×2 -10
C、2 -16 ×(1-2 -10 )
D、2 -15 ×(1-2 -10 )
参考答案与解析
答案:B,2−15×2−10,即 2−25。
按题图分组为 10001 | 0 | 0000000001:
- 阶符与 4 位阶码合成 5 位补码
10001,真值为17−32=−15,不能只把后四位当成 +1。 - 数符为 0,尾数是正的纯小数
0.0000000001B=2⁻¹⁰。 - 浮点值为
2⁻¹⁰×2⁻¹⁵=2⁻²⁵。
题目允许非规格化表示,所以不强制尾数最高有效位为 1;该格式也不是 IEEE 754。
位掩码与移位:按位处理整数
逻辑运算判断整个条件的真假;**按位运算**把整数的对应二进制位逐一处理。Java 中整数使用 &、|、^、~,短路条件使用 &&、||;Kotlin 的整数位运算对应 and、or、xor、inv()。
| 目的 | 按位操作 | 原因 |
|---|---|---|
| 保留选中的位 | x & mask |
掩码为 0 的位被清零,为 1 的位保留 |
| 将选中的位置 1 | x | mask |
与 1 做或必为 1 |
| 翻转选中的位 | x ^ mask |
与 1 异或翻转,与 0 异或不变 |
| 清除选中的位 | x & ~mask |
先反转掩码,再保留其余位 |
例如检查低 3 位是否全为 0,应判断 (x & 0x07)==0;若检查是否全为 1,则判断结果是否等于 0x07。用或运算会主动把这些位置 1,不能检查原来的位是否为 0。
固定字长下,左移会丢弃高位、低位补 0;在结果可表示、没有溢出时,左移一位相当于乘 2。逻辑右移高位补 0,算术右移高位补符号位;循环移位则把移出的位送回另一端,不能当成乘除法。Java 的 >> 是算术右移,>>> 是逻辑右移,Kotlin 对应 shr、ushr。负数算术右移通常向负无穷方向取整,例如 Java 的 −7 >> 1 为 −4,而整数除法 −7/2 为 −3。讨论补码位串时的移位规则,不能不加条件地当成 C/C++ 对所有有符号移位的保证。
逻辑运算与短路求值
| 运算 | 结果为真的条件 |
|---|---|
| 与 AND | 两边都真 |
| 或 OR | 至少一边真 |
| 非 NOT | 原值为假 |
| 异或 XOR | 两边不同 |
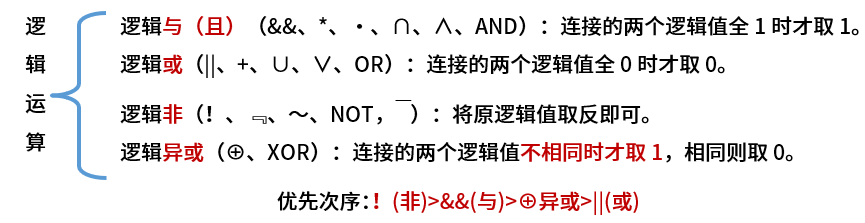
图中混合了数学记号和程序语言记号,运算符优先级应以具体语言为准。例如 Java 的 ^ 高于 &&,不能照搬图中“与高于异或”的顺序。逻辑异或也不是短路运算。
a && b:a 为假时,不再计算 b。a || b:a 为真时,不再计算 b。- 短路会影响右侧带有赋值、函数调用等副作用的表达式是否执行。
原例 (m=a>b)&&(n=c>d) 中,若 a=1,b=2,c=3,d=4 且 m、n 原值均为 1,则按讲义采用的 C 类表达式语义,左侧将 m 赋为 0,右侧不执行,n 仍为 1。Java 不允许直接把布尔结果赋给整型变量,不能原样套用这组整数声明。
例题 5:短路求值
对布尔表达式进行短路求值是指:无须对表达式中所有操作数或运算符进行计算就可确定表达式的值。对于表达式“a or ((c< d) and b)”,( )时可进行短路计算。
A、d为true
B、a为true
C、b为true
D、c为true
参考答案与解析
答案:B,a 为 true。
外层是 a or (...)。一旦 a 为真,整个表达式已确定为真,右边的比较和 b 都无需计算。c<d 为假时也可能使内层 and 短路,但这不是其他选项给出的条件。
专项题库练习(15 题)
本小节对应题库练习共 15 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 002
来源:知识点练习「计算机组成与体系结构」第 2 题(原站解析入口)。
机器字长为n位,最高位用作符号位。其有符号定点整数的最大值是多少?
-
A. 2n − 1
-
B. 2n−1 − 1
-
C. 2n
-
D. 2n−1
同题来源:2026年5月软件设计师综合知识真题(考生回忆版)第 52 题(原站试卷目录)。来源题干、原选项对照与解析保留在下方折叠。
答案与解析
平台答案:B。
整理解析
最大正数的符号位为0,其余n−1位全为1,数值为2n−1−1。
同题来源:2026-05 Q052
原平台答案(2026-05 Q052,原题选项):D;对应本页选项:B。
原题选项顺序保留如下;以下解析中的字母按该来源题目保留,并非改写原平台答案。
来源题干(复习摘要)
用 n 个二进制位表示带符号整数时,可表示的最大值是( )。
| 原题选项 | 原题选项内容 | 本页对应选项 |
|---|---|---|
| A | 2n−1 | D |
| B | 2n | C |
| C | 2n−1 | A |
| D | 2n−1−1 | B |
整理解析(该来源)
选 D。按常见带符号定点整数编码,最大正数的符号位为 0,其余 n−1 位全为 1,值为 2n−1−1。这里解释的是正数最大值;补码负数不能笼统理解为“符号位加其余位的绝对值”。题中断开的幂次已合并排版。
题目 014
来源:知识点练习「计算机组成与体系结构」第 14 题(原站解析入口)。
以n位二进制补码表示有符号定点小数,共能表示多少个不同的值?
-
A. 2n
-
B. 2n-1
-
C. 2n-1
-
D. 2n-1+1
答案与解析
平台答案:A。
整理解析
n位补码有2n种编码,零只有一种表示,因此可表示2n个值。按1位符号、n−1位小数计算,范围为[−1,1−2−(n−1)],步长为2−(n−1)。
题目 021
展开题目 021(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 21 题(原站解析入口)。
浮点数表示范围主要取决于哪一部分的位数?
-
A. 尾数
-
B. 阶码
-
C. 数符
-
D. 阶符
答案与解析
平台答案:B。
整理解析
在基数和编码方式一定时,阶码位数主要决定可覆盖的数量级,尾数位数主要决定精度。精确最大值仍受尾数、偏置和保留编码影响,不能说范围完全与尾数无关。
题目 027
展开题目 027(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 27 题(原站解析入口)。
哪一种移位指令的效果相当于把操作数乘以2?
-
A. 算术左移
-
B. 逻辑右移
-
C. 算术右移
-
D. 带进位循环左移
答案与解析
平台答案:A。
整理解析
在无溢出的前提下,算术左移一位相当于乘2。固定字长下若高位溢出,这一数学等价就不再成立。
题目 028
展开题目 028(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 28 题(原站解析入口)。
已知2X的补码为90H,求X的真值。
-
A. 72
-
B. -56
-
C. 56
-
D. 111
答案与解析
平台答案:B。
整理解析
按8位补码且2X未溢出解释,90H=144−256=−112,故X=−56。若允许8位运算按模256回绕,X=72也会产生90H,因此平台答案依赖通常的无溢出假设。
题目 033
展开题目 033(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 33 题(原站解析入口)。
16位浮点格式包含1位阶符、6位阶码值、1位数符和8位尾数。阶码采用移码,尾数采用补码,求可表示数值的范围。
-
A. -264~(1-2-8)264
-
B. -263~(1-2-8)263
-
C. -(1-2-8)264~(1-2-8)264
-
D. -(1-2-8)263~(1-2-8)263
答案与解析
平台答案:B。
整理解析
阶码合计7位,按本题移码定义偏置为64,最大阶码为63;含符号位的补码尾数范围为[−1,1−2−8]。因此整体下界为−263,上界为(1−2−8)×263。这是自定义格式,不套用IEEE 754的特殊阶码保留规则。
题目 037
展开题目 037(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 37 题(原站解析入口)。
对x && (y || !z)做短路求值。&&、||、!分别表示与、或、非;&&和||左结合,!右结合;优先级从高到低为!、&&、||。下列判断哪项正确?
-
A. x为真即可判整个表达式为真,无需计算y、z
-
B. x为假即可判整个表达式为假,无需计算y、z
-
C. x为真时先依据z决定是否计算y
-
D. x为假时再依据y决定是否计算z
答案与解析
平台答案:B。
整理解析
先求x:为假就立即得到假,不访问y、z;为真再求y,y为真时跳过z,y为假才求!z。平台“与z值无关”不能理解为x为真时最终结果总与z无关。
题目 040
展开题目 040(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 40 题(原站解析入口)。
整数a的字长为16位,要检查最低4位是否全为0,应采用哪项运算和比较?
-
A. a与0x000F做“逻辑与”,再检查结果是否为0
-
B. a与0x000F做“逻辑或”,再检查结果是否为F
-
C. a与0x000F做“逻辑异或”,再检查结果是否为0
-
D. a与0x000F做“逻辑与”,再检查结果是否为F
答案与解析
平台答案:A。
整理解析
掩码0x000F的高12位为0、低4位为1,所以(a & 0x000F)==0恰好检查低4位全零。选项所称“逻辑与”应按逐位与理解,不能替换成C/Java的逻辑与&&。
题目 051
展开题目 051(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 51 题(原站解析入口)。
浮点数由阶码和尾数构成。两数相加需先对阶,若阶差绝对值为n,应怎样调整阶码与尾数?
-
A. 大阶向小阶对齐,尾数左移n位
-
B. 大阶向小阶对齐,尾数右移n位
-
C. 小阶向大阶对齐,尾数左移n位
-
D. 小阶向大阶对齐,尾数右移n位
答案与解析
平台答案:D。
整理解析
把较小阶码提高到较大阶码,同时将对应尾数右移n位:m×2e=(m/2n)×2e+n。这里比较的是阶码而非数值大小,右移丢失低位后还需考虑舍入。
题目 059
展开题目 059(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 59 题(原站解析入口)。
用n位补码表示数据,其中含1个符号位。下列哪个数值可以直接表示?
-
A. 2n
-
B. -2n
-
C. 2n-1
-
D. -2n-1
答案与解析
平台答案:D。
整理解析
按补码整数理解,范围是−2n−1~2n−1−1,只有D在范围内。最高位权重为−2n−1,所以100…0自然表示最小负数,并非平台所称的另行“人为定义”;该整数范围不能直接用于小数。
题目 063
展开题目 063(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 63 题(原站解析入口)。
短路求值可在未计算全部操作数或运算符时确定结果。对于a or ((c < d) and b),所列哪项条件能触发短路?
-
A. d为true
-
B. a为true
-
C. b为true
-
D. c为true
答案与解析
平台答案:B。
整理解析
按从左到右的短路规则,a为true就跳过整个右侧并返回true;若a为false且c<d为false,内层and也会跳过b。平台“最后计算or”不能被当作实际求值顺序。
题目 078
展开题目 078(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 78 题(原站解析入口)。
关于两个浮点数相加的步骤,下列哪项正确?
-
A. 先对阶,大阶向小阶对齐
-
B. 先对阶,小阶向大阶对齐
-
C. 无需对阶,直接相加尾数
-
D. 无需对阶,直接相加阶码
答案与解析
平台答案:B。
整理解析
先把较小阶码对齐到较大阶码,并右移小阶数的尾数,再进行尾数相加,之后还需规格化、舍入和溢出检查。阶码小不代表数值一定小,不能按数值大小决定移位对象。
题目 095
展开题目 095(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 95 题(原站解析入口)。
某机允许非规格化浮点表示,位域依次为阶符1位、阶码4位、数符1位、尾数10位,见图;阶码用补码,尾数用原码。位串1 0001 0 0000000001表示哪个浮点数?
-
A. 2-16×2-10
-
B. 2-15×2-10
-
C. 2-16× (1-2-10)
-
D. 2-15× (1-2-10)
答案与解析
平台答案:B。
整理解析
5位补码阶码100012=−16+1=−15;尾数为正,0.00000000012=2−10,故数值为2−15×2−10=2−25。允许非规格化,不补隐藏前导1,也不使用IEEE 754偏置规则;补码可直接按位权求值,无须先转原码。
题目 106
展开题目 106(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 106 题(原站解析入口)。
两种浮点格式总位数相同,其他规定一致;前者阶码更长、尾数更短,后者阶码更短、尾数更长。它们的数值范围和精度如何比较?
-
A. 两者范围与精度相同
-
B. 前者范围更大、精度更高
-
C. 前者范围更大、精度更低
-
D. 前者范围更小、精度更高
答案与解析
平台答案:C。
整理解析
在基数、编码与规格化约定一致时,阶码更长可覆盖更多数量级,尾数更短则有效位数更少,因此前者范围更大、精度更低。
题目 107
展开题目 107(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 107 题(原站解析入口)。
计算机用补码表示有符号数,主要带来下列哪项效果?
-
A. 使加减法过程与手工运算一致
-
B. 提高运算过程与结果的精确程度
-
C. 提高加减法运算速度
-
D. 把减法转为加法,简化运算器设计
答案与解析
平台答案:D。
整理解析
n位补码可在模2n下用加法器实现减法,并把符号位与数值位统一处理,核心收益是简化运算器。它不消除溢出,也不自动提高精度;实际速度取决于实现,不能绝对断言必然加速或完全无速度收益。
二、校验码
奇偶校验:看出错位的数量,别看位号
在有效信息位之外增加一个校验位,使**整个码字**中 1 的数量为奇数(奇校验)或偶数(偶校验)。每翻转一位都会改变一次奇偶性,因此能检测奇数个位翻转,不能检测偶数个位翻转,也不能指出是哪一位出错。
“奇数个数据位出错”与“第 1、3、5 等奇数位置出错”含义不同。校验位自身出错也属于码字错误;检错能力取决于整个码字被翻转的总位数。
例题 6:奇校验的检错能力
以下关于采用一位奇校验方法的叙述中,正确的是( )。
A、若所有奇数位出错,则可以检测出该错误但无法纠正错误
B、若所有偶数位出错,则可以检测出该错误并加以纠正
C、若有奇数个数据位出错,则可以检测出该错误但无法纠正错误
D、若有偶数个数据位出错,则可以检测出该错误并加以纠正
参考答案与解析
答案:C。
奇数个位翻转会改变总奇偶性,所以能检出,但只有一个校验位无法定位并纠正错误。A 的“所有奇数位”说的是位置,实际出错位数可能为偶数,不能保证检出。
CRC:模二除法与漏检条件
设信息为 M(x),生成多项式 G(x) 的次数为 r。最简教学模型的处理步骤是:
- 信息串后补 r 个 0,相当于乘 xr。
- 对 G(x) 作模二除法;加减都用异或,不借位、不进位。
- 取 r 位余数作为校验字段,替换末尾的 r 个 0,形成发送码字。
- 接收方用同一 G(x) 去除收到的码字;余数非零表示检测到错误,余数为零表示**未检测到错误**。
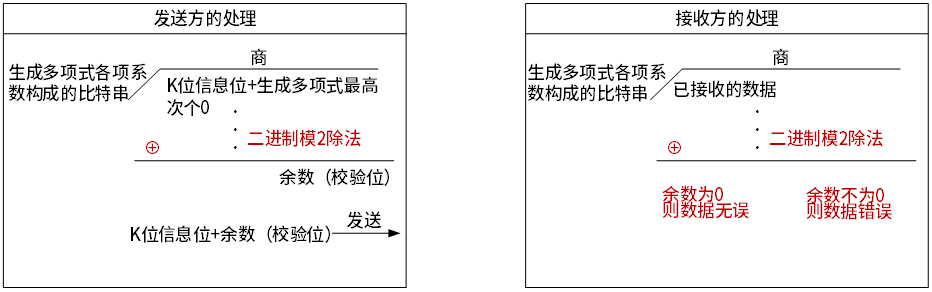
原文和图中“余数为 0 则数据无误”“任意个数据位出错余数都不为 0”均不成立。如果错误多项式 E(x) 恰好是 G(x) 的倍数,错误仍会通过校验。实际 CRC 协议还可能规定初值、输入输出反射和最终异或值,校验结果应按对应协议判断。
常见 r 次 CRC 在生成多项式满足相应条件时能检测所有单比特错误、长度不超过 r 位的突发错误等;更长错误模式的检出能力取决于多项式和消息长度。不能把 CRC 理解为保证检出任意错误的机制,也不能当成抵御恶意篡改的密码学认证。
**原例:**数据 10110011,G(x)=x⁴+x³+1,对应除数 11001,r=4。把 101100110000 模二除以 11001,余数为 0100,发送码字为 101100110100。
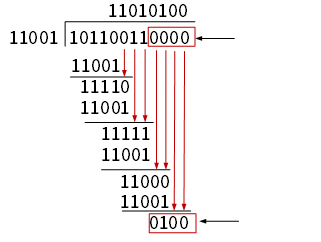
验证:发送码字除以 11001 的余数为 0。若低 5 位恰好按错误模式 11001 翻转,接收到 101100101101,余数仍为 0;这个具体反例说明了漏检的可能性。
例题 7:识别 CRC
在( )校验方法中,采用模2运算来构造校验位。
A、水平奇偶
B、垂直奇偶
C、海明码
D、循环冗余
参考答案与解析
按本题预期答案:D,循环冗余。
课件意在考“CRC 用生成多项式作模二除法构造校验字段”。题干只写“模 2 运算”不够严谨:其他校验也会使用异或即模二加法。应结合本题教学语境作答,不能推导成“只有 CRC 使用模二运算”。
海明码:由校验结果定位单比特错误
若有 m 位信息、r 位校验位,基本海明码要区分“无错”与 m+r 个单比特错误位置,因此至少满足:
2r ≥ m+r+1,取最小整数 r。
校验位放在位号 1、2、4、8……,其余位置放数据。位号写成二进制后,第 j 位为 1 的位置参与对应的第 j 组校验。各组校验结果组成综合征,在**至多一位出错**的假设下可定位错误位。
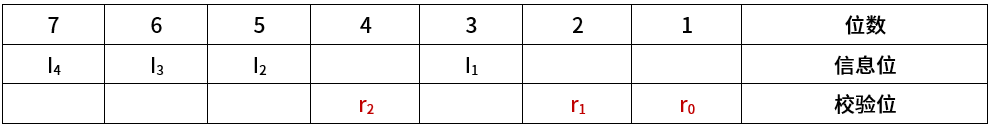
原例:信息 1011 的海明码。 沿用原图从右向左编号、偶校验的约定:I₄I₃I₂I₁=1011,放在 7、6、5、3 位,校验位 r₂、r₁、r₀ 位于 4、2、1 位。
r₂ = I₄ ⊕ I₃ ⊕ I₂ = 1⊕0⊕1 = 0。r₁ = I₄ ⊕ I₃ ⊕ I₁ = 1⊕0⊕1 = 0。r₀ = I₄ ⊕ I₂ ⊕ I₁ = 1⊕1⊕1 = 1。
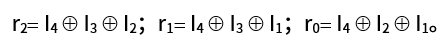
图中最后一个数据位下标有笔误,应为 I₁。原正文位号分解处的加号也应改为等号:
7=4+2+1、6=4+2、5=4+1、3=2+1。
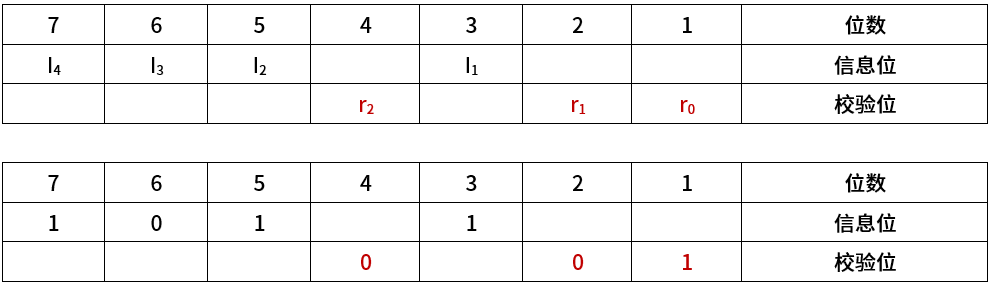
因此码字按 7→1 位书写为 1010101。检查分组 {1,3,5,7}、{2,3,6,7}、{4,5,6,7},每组均有偶数个 1。
基本海明码的最小码距为 3:可用于单错纠正;虽然双比特错误会使综合征非零,但单错纠正译码器可能把它误当成单错,不能保证同时实现单错纠正和双错识别。增加整体奇偶位的扩展海明码可实现 SECDED(单错纠正、双错检测)。
例题 8:海明校验位数与校验分组
海明码是一种纠错码,其方法是为需要校验的数据位增加若干校验位,使得校验位的值决定于某些被校位的数据,当被校数据出错时,可根据校验位的值的变化找到出错位,从而纠正错误。对于32位的数据,至少需要增加( )个校验位才能构成海明码。
以10位数据为例,其海明码表示D 9 D 8 D 7 D 6 D 5 D 4 P 4 D 3 D 2 D 1 P 3 D 0 P 2 P 1 中,其中D i (0≤i≤9)表示数据位,P j (1≤j≤4)表示校验位,数据位D 9 由P 4 、P 3 和P 2 进行校验(从右至左D 9 的位序为14,即等于8+4+2,因此用第8位的P 4 、第4位的P 3 和第2位的P 2 校验),数据位D 5 由( )进行校验。
A、3
B、4
C、5
D、6
A、P 4 P 1
B、P 4 P 2
C、P 4 P 3 P 1
D、P 3 P 2 P 1
参考答案与解析
答案:第一空 D(6);第二空 B(P₄、P₂)。
对于 32 个数据位:r=5 时 2⁵=32 < 32+5+1=38,不够;r=6 时 2⁶=64 ≥ 32+6+1=39,满足,因此至少加 6 位。若额外要求 SECDED,还需另加一个整体奇偶位,本题没有这项要求。
题面另一个例子是 10 位数据的海明码,不要与第一空的 32 位混在一起。由右往左数,D₅ 位于第 10 位,10=8+2=1010B,因此由第 8 位的 P₄ 与第 2 位的 P₂ 校验。D₉ 位于 14=8+4+2,与题面说明一致。
三类校验的关键词
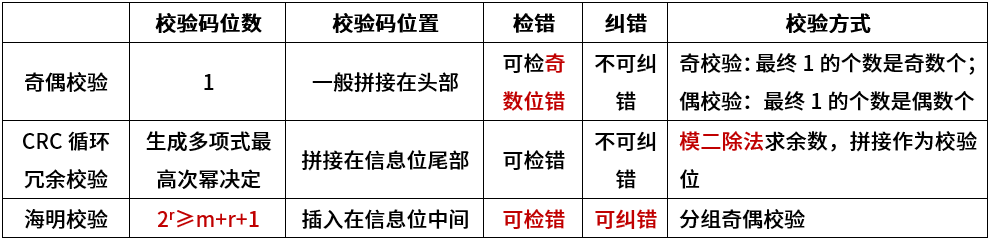
| 题干线索 | 对应概念 | 不能忽略的边界 |
|---|---|---|
| 1 的个数、奇数/偶数、一个校验位 | 奇偶校验 | 只能检测奇数个位翻转,不能纠错 |
| 生成多项式、模二除法、余数 | CRC | 常规用途是检错,有漏检模式 |
| 多个校验组、定位错误位、2ʳ≥m+r+1 | 海明码 | 基本纠错能力是单比特,不能任意多位纠错 |
CRC 的题目常用“模二运算”作关键词,但奇偶校验和海明码也会用到异或(模二加法);严谨的区分特征是**生成多项式与模二除法**。
专项题库练习(7 题)
本小节对应题库练习共 7 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 003
来源:知识点练习「计算机组成与体系结构」第 3 题(原站解析入口)。
海明码在n个数据位之间插入k个校验位,以奇偶校验扩大码距并实现检错、纠错。n=48时,k最少取多少?
-
A. 4
-
B. 5
-
C. 6
-
D. 7
答案与解析
平台答案:C。
整理解析
单比特纠错需区分无错和48+k个错误位置,故2k≥48+k+1。k=5时32<54,k=6时64≥55,最少6位;这里不计扩展海明码的额外整体奇偶校验位。
题目 034
来源:知识点练习「计算机组成与体系结构」第 34、43 题(原站解析入口)。
对16位数据信息进行海明码纠错,最少需附加多少位校验位?
-
A. 3
-
B. 4
-
C. 5
-
D. 6
答案与解析
平台答案(来源第 34 题):C。
整理解析(来源第 34 题)
单错纠正要求2k≥16+k+1。k=4时16<21,k=5时32≥22,故至少5位。若还需可靠地区分双比特错误,通常另加整体奇偶校验位。
平台答案(来源第 43 题):C。
整理解析(来源第 43 题)
与Q34相同,2r≥16+r+1给出最小r=5。平台先定义N为总码长,又写“K+r+1=N”,等式有误;正确为N=K+r、2r≥N+1。普通海明码仅保证单错纠正,不能推及任意多个错误。
题目 049
来源:知识点练习「计算机组成与体系结构」第 49 题(原站解析入口)。
下列关于海明码的说法,哪项正确?
-
A. 海明码以奇偶性实现检错和纠错
-
B. 海明码的码距为1
-
C. 海明码只能检错,不能纠错
-
D. 海明码的数据位与校验位必须等长
答案与解析
平台答案:A。
整理解析
海明码通过多组奇偶校验定位错误。普通海明码最小码距为3,可纠正1位错误;作为纯检错码可发现2位错误,但不能同时保证单错自动纠正和所有双错识别。加整体奇偶校验的扩展码可实现单错纠正、双错检测。
题目 054
来源:知识点练习「计算机组成与体系结构」第 54 题(原站解析入口)。
海明码插入若干校验位,各校验位由对应数据位计算;校验结果的变化可定位出错位并纠错。32位数据至少需增加(54)个校验位。另有10位数据,其海明码从左到右为D9 D8 D7 D6 D5 D4 P4 D3 D2 D1 P3 D0 P2 P1;Di(0≤i≤9)为数据位,Pj(1≤j≤4)为校验位。从右起编号,D9在第14位,14=8+4+2,所以由第8、4、2位的P4、P3、P2校验。D5应由(55)校验。本题回答第54空。
-
A. 3
-
B. 4
-
C. 5
-
D. 6
答案与解析
平台答案:D。
整理解析
校验信息要区分无错和32+k个错误位置,因此2k≥32+k+1。k=5不足,k=6满足,最少6位。平台共用解析的“DB”分别对应第54、55空。
题目 055
来源:知识点练习「计算机组成与体系结构」第 55 题(原站解析入口)。
海明码插入若干校验位,各校验位由对应数据位计算;校验结果的变化可定位出错位并纠错。32位数据至少需增加(54)个校验位。另有10位数据,其海明码从左到右为D9 D8 D7 D6 D5 D4 P4 D3 D2 D1 P3 D0 P2 P1;Di(0≤i≤9)为数据位,Pj(1≤j≤4)为校验位。从右起编号,D9在第14位,14=8+4+2,所以由第8、4、2位的P4、P3、P2校验。D5应由(55)校验。本题回答第55空。
-
A. P4、P1
-
B. P4、P2
-
C. P4、P3、P1
-
D. P3、P2、P1
答案与解析
平台答案:B。
整理解析
从右起D5是第10位,10=8+2=10102,故受第8位P4和第2位P2校验。本题求校验关系,与第54空的校验位数量不是同一问题。
题目 061
来源:知识点练习「计算机组成与体系结构」第 61 题(原站解析入口)。
使用一位奇校验时,下列关于检错、纠错能力的判断哪项正确?
-
A. 所有奇数位出错时,能检出但不能纠正
-
B. 所有偶数位出错时,能检出并纠正
-
C. 有奇数个数据位出错时,能检出但不能纠正
-
D. 有偶数个数据位出错时,能检出并纠正
答案与解析
平台答案:C。
整理解析
应看翻转位数的奇偶,而非位序编号。完整码字中奇数个位翻转会改变奇偶性,能检出;偶数个位翻转会漏检。一个校验位无法定位错误,不能纠错。
题目 068
来源:知识点练习「计算机组成与体系结构」第 68 题(原站解析入口)。
哪种校验方法采用模2运算构造校验位?
-
A. 水平奇偶
-
B. 垂直奇偶
-
C. 海明码
-
D. 循环冗余
答案与解析
平台答案:D。
整理解析
平台意图考CRC的模2多项式除法取余,答案为D。但原题只说“模2运算”过宽:奇偶校验和海明码也使用模2加法(异或),因此不能据这一泛称把A、B、C全部排除。
三、计算机组成与 CPU
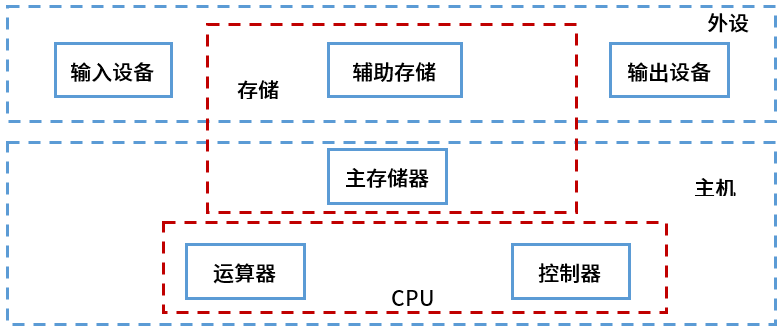
计算机的基本功能部件包括运算器、控制器、存储器、输入设备和输出设备。CPU 主要包括运算器、控制器、寄存器组及内部连接;主存不属于 CPU。
| 部件 | 核心职责 | 题干关键词 |
|---|---|---|
| ALU,算术逻辑单元 | 算术和逻辑运算 | 运算、比较 |
| AC,累加寄存器 | 保存中间结果或操作数 | 暂存运算结果 |
| DR/MDR,数据寄存器 | 暂存从内存读出或即将写入内存的内容 | 数据缓冲,读写均可能 |
| PSW,程序状态字/状态寄存器 | 保存条件码、状态位及控制信息 | 零、进位、溢出、中断控制 |
| PC,程序计数器 | 按教学模型保存下一条待取指令地址 | 下一条、地址 |
| IR,指令寄存器 | 保存当前已取出的指令 | 指令内容、操作码 |
| ID,指令译码器 | 解释操作码,参与生成相应控制 | 译码 |
| AR/MAR,地址寄存器 | 暂存本次内存访问的地址 | 当前访问地址 |
| 时序与控制部件 | 按时序组织指令执行并发出控制信号 | 操作信号、协调执行 |
课件将 ALU、AC、DR、PSW 归于运算器,将 PC、IR、ID、AR、时序部件归于控制器。这是教学职责划分;不同教材可能把 PSW 等归入其他部分。答题优先判断功能,不把该表当作所有处理器的物理布置。现代通用寄存器体系也不一定设置单独的累加器。
PC 保存地址,IR 保存指令;AR 保存访问地址,DR 保存访问内容。 DR 不只服务于写内存,IR 也不应一概叫“下一条指令寄存器”。
存储程序与取指过程
冯·诺依曼模型把指令和数据都以二进制形式保存在存储器中,CPU 根据程序规定的顺序自动取指、执行,转移指令可以改变执行顺序。主存可以同时存放指令和数据,Cache 也可以缓存两者;某些处理器把指令 Cache 和数据 Cache 分开,并不改变二者都是存储内容这一点。
一次简化取指可写为 PC → MAR → 读主存 → MDR → IR,随后解释 IR 的操作码。PC 顺序前移或被分支目标更新,MAR 则还会用于操作数访存。相同位串究竟作为指令还是数据,取决于 CPU 此次访问的用途。ALU 内部包括加法、逻辑、移位等运算电路;寄存器负责保存内容,两者职责不同。
Flynn 分类:数指令流和数据流
指令流是执行中的指令序列,数据流是这些指令处理的数据序列。Flynn 分类从这两个维度描述并行组织,不按指令长短或 CPU 主频分类。
| 类别 | 指令流/数据流 | 如何理解 |
|---|---|---|
| SISD | 单/单 | 一个控制流处理一组数据的传统顺序模型;内部仍可以流水化 |
| SIMD | 单/多 | 同一操作同时施加到多个数据元素,如向量加法 |
| MISD | 多/单 | 多个操作流处理同一数据流;通用实例少,常在容错等特定模型中讨论 |
| MIMD | 多/多 | 多个处理单元独立执行不同指令、处理各自数据,如多核上的不同线程 |
Android 开发中,ARM NEON 向量指令体现 SIMD;多个核心分别执行 UI 线程与计算线程体现 MIMD。整机可以同时具有多种层次的并行能力,不能凭支持一条向量指令就把整个多核系统归为纯 SIMD。传统教材把 MISD 称为“只有理论意义”,应理解为常见通用体系中罕见,而非逻辑上不可能实现。
主频、CPI 与 MIPS:把周期换成时间
主频 f 是每秒时钟周期数,时钟周期为 1/f;CPI 是平均每条指令花费的周期数。若第 i 类指令占执行指令总数的比例 pᵢ,其 CPI 为 cᵢ,则:
例如 2.4 GHz 的 CPU 执行三类指令,比例为 50%、30%、20%,CPI 分别为 1、3、5,则平均 CPI 为 0.5×1+0.3×3+0.2×5=2.4,速度为 1000 MIPS;执行 1200 万条指令的 CPU 时间为 0.012 s。只有各类指令数量相同才能简单平均 CPI,不能按类别数量直接除。
MIPS 统计每秒执行多少百万条指令,指令做多少工作却因指令集和程序而异。因此比较完成同一任务的性能,应看执行时间,不能只比主频或 MIPS。“每分钟完成多少请求”也是吞吐率;单个请求从提交到完成的时间是响应时间,二者不能互换。
浮点计算常用 FLOPS(每秒浮点运算次数),MFLOPS=浮点运算次数/(秒数×10⁶)。一次向量指令可能完成多次浮点运算,因而不能直接把 MIPS 当作 MFLOPS;比较时还要统一精度和运算计数口径。公式也见本章纲要的“MIPS 与 MFLOPS”。
例题 9:谁产生指令操作信号
计算机执行指令的过程中,需要由( )产生每条指令的操作信号并将信号送往相应的部件进行处理,以完成指定的操作。
A、CPU的控制器
B、CPU的运算器
C、DMA控制器
D、Cache控制器
参考答案与解析
答案:A,CPU 的控制器。
控制器解释指令并按时序组织各部件动作。ALU 负责执行算术/逻辑运算;DMA 和 Cache 控制器分别处理其专门范围的事务。
专项题库练习(15 题)
本小节对应题库练习共 15 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 001
来源:知识点练习「计算机组成与体系结构」第 1 题(原站解析入口)。
在CPU中,哪个寄存器通常向ALU提供运算数据,并暂存算术、逻辑运算的结果?
-
A. 程序计数器
-
B. 状态寄存器
-
C. 通用寄存器
-
D. 累加寄存器
答案与解析
平台答案:D。
整理解析
经典累加器结构中,这一职责由累加寄存器承担。现代CPU的通用寄存器也能保存操作数和结果。平台称累加器“不能长时间保存数据”不严谨:只要未改写且状态维持,它就能继续保存数据。
题目 009
来源:知识点练习「计算机组成与体系结构」第 9 题(原站解析入口)。
以下哪个部件属于CPU的算术逻辑单元(ALU)?
-
A. 程序计数器
-
B. 加法器
-
C. 指令寄存器
-
D. 指令译码器
答案与解析
平台答案:B。
整理解析
加法器直接实现算术运算,属于ALU;程序计数器、指令寄存器和指令译码器属于指令控制相关部件。运算器的范围比ALU更大,不能把运算器的所有寄存器都算作ALU内部部件。
题目 012
展开题目 012(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 12 题(原站解析入口)。
Flynn依据信息流把计算机分为4类。按本题口径,哪一类被称为只有理论意义、没有实例?
-
A. SISD
-
B. MISD
-
C. SIMD
-
D. MIMD
答案与解析
平台答案:B。
整理解析
平台按传统题库口径选MISD,但“无实例”过于绝对:处理同一输入的多算法容错系统常被讨论为MISD。SISD也可有流水线;支持SIMD扩展不等于整机是纯SIMD,SIMD指令也未必一周期完成。Flynn分类最早提出于1966年,1972年有进一步阐述。
题目 031
展开题目 031(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 31 题(原站解析入口)。
CPU从内存读取、分析并执行指令时,依据什么区分同样采用二进制存放的指令与数据?
-
A. 指令周期的不同阶段
-
B. 指令和数据的寻址方式
-
C. 指令操作码的译码结果
-
D. 指令和数据所在的存储单元
答案与解析
平台答案:A。
整理解析
同样的位模式可作指令或数据,区别在访问用途:取指阶段取得的内容按指令解释,取操作数时按数据解释。这里的阶段是逻辑用途,流水线可以同时处理多条指令的不同阶段。
题目 032
展开题目 032(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 32 题(原站解析入口)。
在指令周期中,为从内存取得操作码,首先应把哪个部件的内容送上地址总线?
-
A. 指令寄存器(IR)
-
B. 通用寄存器(GR)
-
C. 程序计数器(PC)
-
D. 状态寄存器(PSW)
答案与解析
平台答案:C。
整理解析
PC保存待取指令的地址。实现中通常先把PC送入MAR,再由地址通路发起访问,不要求PC直接驱动外部地址引脚。
题目 039
展开题目 039(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 39 题(原站解析入口)。
CPU进行算术或逻辑运算时,通常把源操作数和结果暂存在哪个寄存器中?
-
A. 程序计数器(PC)
-
B. 累加器(AC)
-
C. 指令寄存器(IR)
-
D. 地址寄存器(AR)
答案与解析
平台答案:B。
整理解析
经典结构中的累加器AC保存操作数、中间值或结果。现代通用寄存器体系也可承担这一职责,不是所有CPU都必须经过专用累加器。
题目 057
展开题目 057(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 57 题(原站解析入口)。
执行指令时,CPU会自动更新哪个部件,使其持续保存下一条待执行指令的地址?
-
A. 指令寄存器
-
B. 程序计数器
-
C. 地址寄存器
-
D. 指令译码器
答案与解析
平台答案:B。
整理解析
程序计数器PC负责保存并更新下一条指令的地址,IR保存指令内容。平台解析漏写“地址”,且称地址寄存器AR不是常见CPU部件也不准确。
题目 064
展开题目 064(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 64 题(原站解析入口)。
CPU执行一条指令所需的操作信号,由哪个部件生成并送往相应执行部件?
-
A. CPU的控制器
-
B. CPU的运算器
-
C. DMA控制器
-
D. Cache控制器
答案与解析
平台答案:A。
整理解析
CPU控制器结合操作码、时序和状态产生控制信号,运算器依信号完成运算。DMA控制器负责数据搬运,不负责CPU全部指令的解释,DMA也不必通过专用总线实现。
题目 077
展开题目 077(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 77 题(原站解析入口)。
提供指令地址的程序计数器PC,在教材的功能组成中归属哪里?
-
A. 控制器
-
B. 运算器
-
C. 存储器
-
D. I/O设备
答案与解析
平台答案:A。
整理解析
PC用于控制后续取指流程,归入控制器;运算器主要处理算术逻辑运算。这是功能划分,不要求现代CPU在物理布局上严格分成教材所画的两个模块。
题目 079
展开题目 079(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 79 题(原站解析入口)。
CPU主频为2.8GHz,应用程序含A、B、C共3类指令,比例依次为35%、45%、20%,CPI(每条指令所需时钟周期数)依次为4、2、6,见表。执行该程序的平均CPI为(79),以MIPS表示的速度约为(80)。
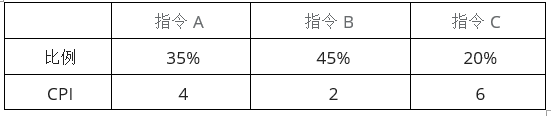
本题回答第79空。
-
A. 25
-
B. 3
-
C. 3.5
-
D. 4
答案与解析
平台答案:C。
整理解析
按指令比例加权:平均CPI=4×35%+2×45%+6×20%=3.5,不能取三个CPI的简单算术平均。原页A确为25,不是2.5,选项按核实结果保留。
题目 080
展开题目 080(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 80 题(原站解析入口)。
CPU主频为2.8GHz,应用程序含A、B、C共3类指令,比例依次为35%、45%、20%,CPI(每条指令所需时钟周期数)依次为4、2、6,见表。执行该程序的平均CPI为(79),以MIPS表示的速度约为(80)。
本题回答第80空。
-
A. 700
-
B. 800
-
C. 930
-
D. 1100
答案与解析
平台答案:B。
整理解析
平均CPI为3.5,因此MIPS=2.8×10⁹/(3.5×106)=800。该速度与本程序的指令构成有关,不能脱离指令集和工作负载比较不同机器的总体性能。
题目 082
展开题目 082(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 82 题(原站解析入口)。
软件质量指标中,“每分钟可以处理多少个请求”对应哪一项?
-
A. 响应时间
-
B. 吞吐量
-
C. 负载
-
D. 容量
答案与解析
平台答案:B。
整理解析
请求数/时间表示吞吐率,题目称吞吐量;单次请求用时才是响应时间。负载通常是施加的工作量,容量也不只表示存储容量,平台的定义过窄。
题目 084
展开题目 084(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 84 题(原站解析入口)。
CPU中哪个寄存器给出下一条待执行指令的内存地址?
-
A. 程序计数器
-
B. 指令寄存器
-
C. 主存地址寄存器
-
D. 状态条件寄存器
答案与解析
平台答案:A。
整理解析
PC保存下一次取指的地址;IR保存指令内容,MAR保存本次访存地址,PSW保存状态和控制标志。
题目 096
展开题目 096(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 96 题(原站解析入口)。
关于冯诺依曼计算机,下列哪项说法不正确?
-
A. 指令与数据均使用二进制
-
B. 指令总在主存中,数据则在Cache中
-
C. 程序功能通过CPU执行指令实现
-
D. 程序执行由指令自动控制
答案与解析
平台答案:B。
整理解析
存储程序模型允许指令和数据同存主存,Cache也可缓存两者。B规定“指令只在主存、数据只在Cache”的固定分工,因而错误。
题目 103
展开题目 103(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 103 题(原站解析入口)。
以下哪项不属于CPU的基本组成部件?
-
A. 算术逻辑运算单元
-
B. 系统总线
-
C. 控制单元
-
D. 寄存器组
答案与解析
平台答案:B。
整理解析
CPU的基本功能部件是算术逻辑运算单元、控制单元和寄存器组;系统总线用于连接CPU、主存和I/O等。CPU内部仍可有总线或其他互连,不应理解为CPU内不存在任何总线。
四、存储系统
存储层次与局部性
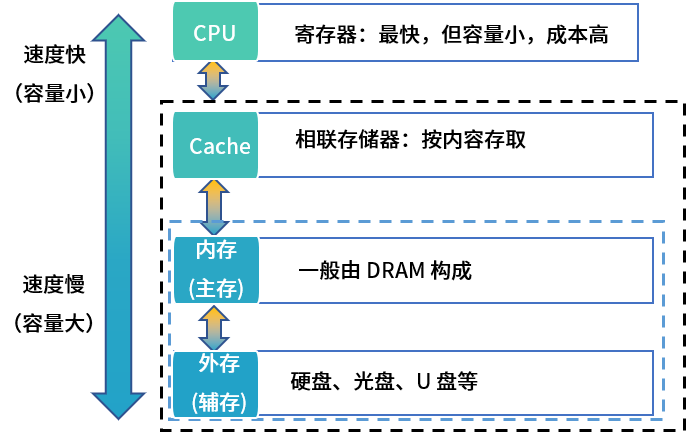
典型层次从快到慢为:寄存器 → Cache → 主存 → 辅存。通常越靠近 CPU,容量越小、单位容量成本越高;分层体系借助局部性,以较低成本取得接近高速存储器的访问性能。
| 局部性 | 含义 | 例子 |
|---|---|---|
| 时间局部性 | 刚访问过的内容,近期可能再次访问 | 循环体指令、反复使用的变量 |
| 空间局部性 | 刚访问地址附近的内容,近期可能被访问 | 顺序执行指令、遍历连续数组 |
“近期可能”是访问倾向,不是每次访问都满足的保证。Cache 利用高速缓存减少平均访问时间;虚拟存储通过地址映射、按需装入等机制组织主存与辅存,提供较大的虚拟地址空间,也支持保护和隔离。虚拟地址空间的上限仍受体系结构和操作系统限制。
按存取方式区分:随机存取(如 RAM)、顺序存取(如磁带)、直接存取(传统磁盘定位后读写)和按内容匹配的相联访问。Cache 不等同于一块纯相联存储器:CPU 仍给出地址,Cache 通过索引和标记比较查找;全相联或组相联结构中的标记匹配体现相联访问。
DRAM、SRAM、ROM、EEPROM 与 Flash
| 类型 | 主要特点 | 常见用途或边界 |
|---|---|---|
| DRAM | 电容电荷会泄漏,需周期刷新;易失,密度较高、成本较低 | 主存 |
| SRAM | 用双稳态电路保持信息,通电时无需刷新;易失、速度快、每位电路较多 | Cache 等高速存储 |
| ROM | 非易失,正常使用以读取为主 | 固化内容;ROM 家族也包括可编程型号 |
| EEPROM | 非易失,可电擦写;常支持字节级擦写或更新 | 少量配置数据;也有页写方式 |
| Flash | 非易失,通常按扇区/块擦除,编程粒度与擦除粒度不同 | 固件、SSD、存储卡等 |
EEPROM 不能笼统说成“以 bit 为单位”,Flash 也不能笼统说成“读写都是按块”。 传统 EEPROM 常按字节更新;NOR Flash 可按字节/字编程或提供缓冲编程,NAND Flash 通常按页编程、按块擦除,具体以器件规格为准。写入前是否需擦除、寿命和延迟也与介质及控制器有关,不能只凭粒度断言谁更快。
“BIOS”是固件,不是存储器材料名称;现代主板固件通常保存在 Flash 中。SRAM 的“静态”只表示不需周期刷新,不表示断电后仍能保存数据。
SRAM 通常每位占用更多晶体管,集成密度低于 DRAM。功耗还取决于容量、工艺、访问频率和待机状态,不能仅由“需要刷新”判定哪一种总是更耗电。Flash 的非易失性适合保存固件,但其擦写延迟与寿命限制使它通常不用于替代频繁更新的工作主存;能随机读取也不等于适合所有 RAM 用途。
例题 10:空间局部性
CPU访问存储器时,被访问数据一般聚集在一个较小的连续存储区域中。若一个存储单元已被访问,则其邻近的存储单元有可能还要被访问,该特性被称为( )。
A、数据局部性
B、指令局部性
C、空间局部性
D、时间局部性
参考答案与解析
答案:C,空间局部性。
决定性的表述是“邻近的存储单元”。如果强调同一内容很快再次被访问,才是时间局部性。
例题 11:主存使用的存储器
计算机系统的主存主要是由( )构成的。
A、DRAM
B、SRAM
C、Cache
D、EEPROM
参考答案与解析
答案:A,DRAM。
一般主存追求容量和成本,采用 DRAM;高速 Cache 通常使用 SRAM。选项中的 Cache 是层次与用途名称,不是与 DRAM 同层次的器件技术分类。
Cache 命中率与平均访问时间
命中率 h 表示所需数据可在 Cache 中找到的比例,未命中率为 1−h。计算前必须区分**未命中的总耗时**与**未命中后的额外代价**。
| 题目对时间的定义 | 平均访问时间 |
|---|---|
| t₁ 为命中总时间,t₂ 为未命中总时间 | h×t₁ + (1−h)×t₂ |
| t₁ 为每次都需付出的 Cache 查询时间,P 为未命中后的额外代价 | t₁ + (1−h)×P |
| 先查 Cache、未命中后再访问主存,主存耗时 tₘ,忽略其他开销 | h×t₁ + (1−h)×(t₁+tₘ) = t₁+(1−h)×tₘ |
原课件写作 h×t₁+(1−h)×t₂,同时把 t₂ 叫“主存周期”。只有把 t₂ 视为未命中路径总耗时,或题目明确允许主存查询重叠等假设时,才能直接这么用。工程上常见的 AMAT 形式是 命中时间+未命中率×未命中代价。存储器的周期时间与访问延迟也不总是同一概念,计算应沿用题目定义。
例如补充算例:h=0.9,Cache 查询 2 ns,未命中后额外访问主存 50 ns,则平均时间为 2+0.1×50=7 ns;若 50 ns 被定义为整个未命中路径的总时间,则为 0.9×2+0.1×50=6.8 ns。两个结果对应不同口径。
Cache 的三种地址映射
Cache 与主存之间以**块/Cache 行**为单位传输。课件图中称“页”,这里不应与虚拟存储中的页面概念混淆。
| 映射方式 | 主存块可以放到哪里 | 选择规则 | 主要特点 |
|---|---|---|---|
| 直接映射 | 唯一指定的 Cache 行 | 行号=主存块号 mod Cache 行数 |
简单,但不同块可能争用同一行 |
| 全相联映射 | 任意 Cache 行 | 比较所有候选行标记 | 灵活,无映射冲突缺失;仍有容量和首次访问缺失 |
| 组相联映射 | 指定组内的任意一路 | 组号=主存块号 mod 组数 |
组间直接映射,组内全相联 |
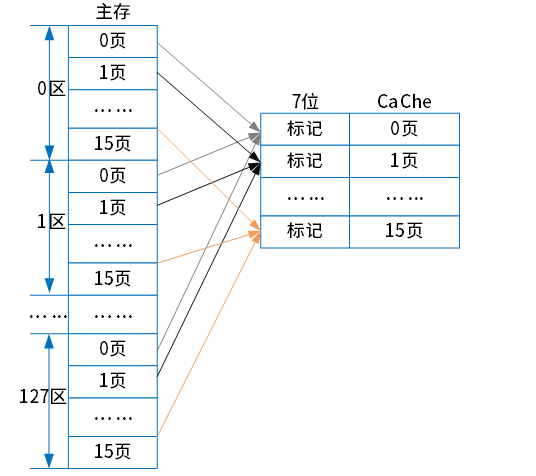
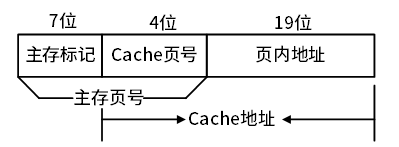
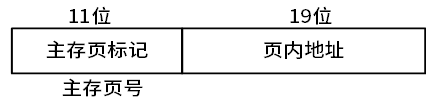
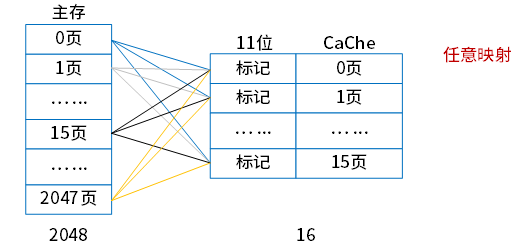
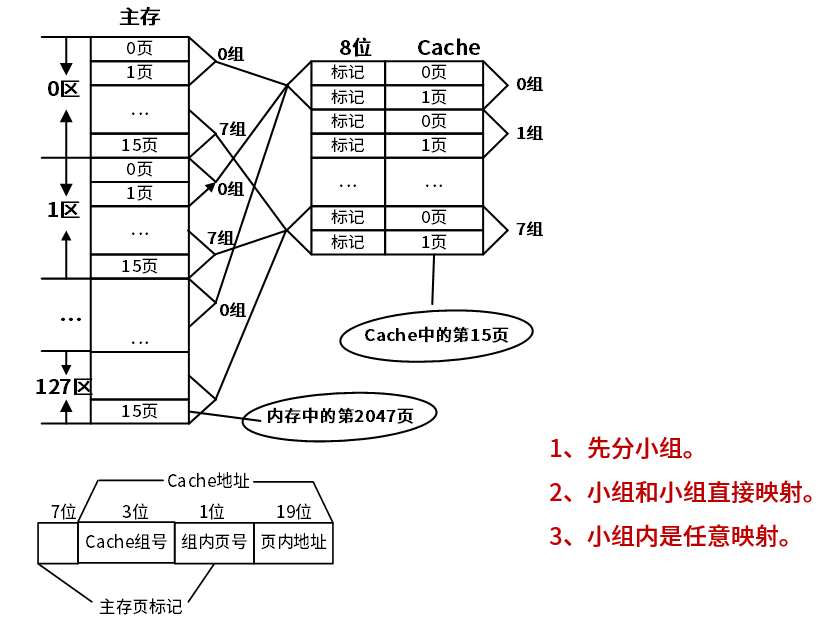
对图中 30 位地址、块内偏移 19 位、Cache 共 16 行的例子,标准字段划分为:
- 直接映射:
标记 7 位 + 行号 4 位 + 偏移 19 位。 - 全相联:
标记 11 位 + 偏移 19 位。 - 两路组相联:16 行组成 8 组,
标记 8 位 + 组号 3 位 + 偏移 19 位。
组相联原图把部分标记拆开显示,并画了“组内页号”。Cache 中最终选中的路号由匹配或替换结果决定,不是主存地址中固定指定 Cache 位置的一位。 学习地址划分应以上面的标准三字段表达为准。
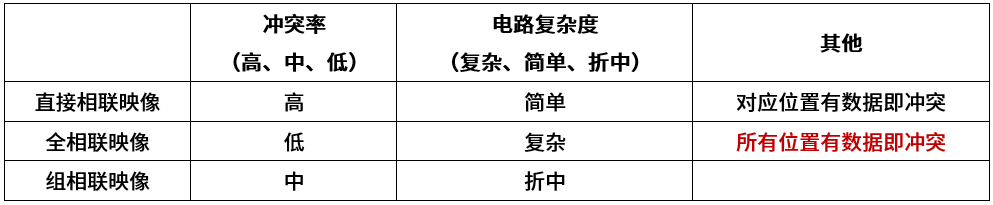
“对应位置有数据即冲突”应补充为:需要装入的块与该处已有的有效块不同,才发生占用冲突;若标记相同就是命中。全相联装满后装入新块也需要替换,但通常称容量造成的替换,不应把它与直接映射的冲突缺失混为一谈。
例题 12:Cache 地址映射的管理者
在程序执行过程中,高速缓存(Cache)与主存间的地址映射由( )。
A、操作系统进行管理
B、存储管理软件进行管理
C、程序员自行安排
D、硬件自动完成
参考答案与解析
答案:D,硬件自动完成。
普通 CPU Cache 的索引、标记比较和替换由硬件完成。不要与虚拟内存中由操作系统管理、硬件参与地址转换的页面机制混淆。
例题 13:全相联映射
主存与Cache的地址映射方式中,( )方式可以实现主存任意一块装入Cache中任意位置,只有装满才需要替换。
A、全相联
B、直接映射
C、组相联
D、串并联
参考答案与解析
答案:A,全相联。
“任意主存块放到任意 Cache 位置”说明没有固定行或固定组限制。直接映射即使其他行空闲,目标行被不同块占用也可能替换;组相联则局限在指定组内。
主存编址与芯片数量
- 存储单元数=最大地址−最小地址+1,首尾地址都包含。
- 容量=存储单元数×每个单元的位数/字节数。
- 按字节编址:一个地址对应 1 Byte;按字编址:一个地址对应一个机器字。
64K×8 bit表示 64K 个单元,每单元 8 bit,即 64 KiB;不要把它误读成 64 Kbit。- 在字数和位宽能整倍扩展且组织匹配时,总片数=目标容量/单片容量。更细致地看,是**字扩展倍数×位扩展倍数**。
存储计算题中的 K 通常按 1024 处理;以下沿用题面 KB,同时用 KiB 标明二进制容量。
例题 14:主存容量与芯片数
内存按字节编址,地址从A0000H到CFFFFH的内存,共有( )字节,若用存储容量为64K×8bit的存储器芯片构成该内存空间,至少需要( )片。
A、80KB
B、96KB
C、160KB
D、192KB
A、2
B、3
C、5
D、8
参考答案与解析
答案:第一空 D(192KB);第二空 B(3 片)。
地址首尾均包含:CFFFFH−A0000H+1=30000H=196608 Byte=192 KiB。
单片 64K×8 bit=65536 Byte=64 KiB,因此 192/64=3 片。常见错误是漏掉末尾的 +1,或者没有把 bit 转换成 Byte。
专项题库练习(24 题)
本小节对应题库练习共 24 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 006
来源:知识点练习「计算机组成与体系结构」第 6 题(原站解析入口)。
用256K×8bit芯片组成按字节编址、地址为40000000H~400FFFFFH的内存,需要几片?
-
A. 4
-
B. 8
-
C. 16
-
D. 32
答案与解析
平台答案:A。
整理解析
含首尾的容量为400FFFFFH−40000000H+1=100000H=220B。每片为256KiB=218B,相除得4片;芯片容量中的K按1024计。
题目 008
来源:知识点练习「计算机组成与体系结构」第 8 题(原站解析入口)。
计算机使用分级存储,主要是为了解决哪一类矛盾?
-
A. 主存容量不足
-
B. 存储器读写可靠性
-
C. 外设访问效率
-
D. 存储容量、成本和速度之间的矛盾
同题来源:2026年5月软件设计师综合知识真题(考生回忆版)第 34 题(原站试卷目录)。来源题干、原选项对照与解析保留在下方折叠。
答案与解析
平台答案:D。
整理解析
快的存储器通常昂贵且容量较小,慢的存储器可提供低成本的大容量;分层利用局部性兼顾容量、成本与平均访问速度。各层并非都由操作系统直接管理,例如Cache通常由硬件管理。
同题来源:2026-05 Q034
原平台答案(2026-05 Q034,原题选项):B;对应本页选项:D。
原题选项顺序保留如下;以下解析中的字母按该来源题目保留,并非改写原平台答案。
来源题干(复习摘要)
计算机采用多级存储层次,主要希望解决哪一项需求或矛盾?
| 原题选项 | 原题选项内容 | 本页对应选项 |
|---|---|---|
| A | 需要扩充主存容量 | A |
| B | 需要兼顾存储成本、容量与速度 | D |
| C | 存储器读写可靠性不够 | B |
| D | 外设访问效率低 | C |
整理解析(该来源)
快存储通常昂贵且容量有限,大存储通常便宜但较慢。分级存储利用局部性让常用数据更靠近CPU,在三项目标之间折中,所以选B。
题目 010
展开题目 010(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 10 题(原站解析入口)。
内存按字节编址,A5000H~DCFFFH(含首尾)的容量是多少?
-
A. 123KB
-
B. 180KB
-
C. 223KB
-
D. 224KB
答案与解析
平台答案:D。
整理解析
容量为DCFFFH−A5000H+1=38000H=229376B,除以1024得224KiB。选项KB沿用教材的1024B口径。
题目 013
展开题目 013(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 13 题(原站解析入口)。
在所列存储部件中,CPU访问哪一种通常最快?
-
A. 内存
-
B. Cache
-
C. 通用寄存器
-
D. 硬盘
答案与解析
平台答案:C。
整理解析
通常的速度次序为通用寄存器、Cache、主存、硬盘,因此选择通用寄存器。
题目 015
展开题目 015(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 15 题(原站解析入口)。
比较Cache地址映像方式,哪一种的块冲突最少?
-
A. 全相联映像
-
B. 组相联映像
-
C. 直接映像
-
D. 无法确定的
答案与解析
平台答案:A。
整理解析
容量和块大小相同时,全相联允许块放入任意行,不产生固定行/组限制导致的冲突失效。它仍会有强制、容量等失效,不能推断任意替换策略下总失效率都最小。
题目 020
展开题目 020(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 20 题(原站解析入口)。
教材中的虚拟存储体系由哪两级存储器组成?
-
A. 主存-辅存
-
B. 寄存器-Cache
-
C. 寄存器-主存
-
D. Cache-主存
答案与解析
平台答案:A。
整理解析
主存与辅存协作,为程序提供逻辑地址空间。它不增加物理RAM容量;m位地址只能说明可编址2m个单元,只有字节编址才对应2mB,也不表示已安装同样多内存。
题目 023
展开题目 023(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 23 题(原站解析入口)。
内存按字节编址,B3000H~DABFFH(含首尾)的容量是多少?
-
A. 123KB
-
B. 159KB
-
C. 163KB
-
D. 194KB
答案与解析
平台答案:B。
整理解析
DABFFH−B3000H+1=27C00H=162816B,除以1024得159KiB。地址区间包含两端,不能漏掉加1。
题目 026
展开题目 026(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 26 题(原站解析入口)。
按字节编址的内存区间A1000H~B13FFH,容量为多少KB?
-
A. 32
-
B. 34
-
C. 65
-
D. 67
答案与解析
平台答案:C。
整理解析
B13FFH−A1000H+1=10400H=66560B,除以1024得65,容量为65KiB。平台除以1024后再把商写成“65K”混淆了单位。
题目 029
展开题目 029(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 29 题(原站解析入口)。
哪种主存—Cache映射允许任意主存块装入任意Cache行,并且只有Cache装满时才需要替换?
-
A. 全相联
-
B. 直接映射
-
C. 组相联
-
D. 串并联
答案与解析
平台答案:A。
整理解析
全相联没有固定行或组的限制,有空行即可装入。它通常需要更复杂、昂贵且耗电的标记比较硬件,但平台称其必然“访问速度慢”不准确,并行比较也能快速查找。
题目 036
展开题目 036(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 36 题(原站解析入口)。
关于Cache与主存之间的地址映射,由谁完成的表述正确?
-
A. 由操作系统管理
-
B. 由程序员编程处理
-
C. 由应用软件调度
-
D. 由硬件自动完成
答案与解析
平台答案:D。
整理解析
正常访问时,Cache控制硬件按映射规则比较标记、判断命中并选择相应位置,程序员和应用程序不必逐次安排。
题目 044
展开题目 044(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 44 题(原站解析入口)。
下列关于高速缓存Cache的说法,哪项不正确?
-
A. 设置Cache可扩充主存容量
-
B. Cache保存主存部分内容的拷贝
-
C. 增大Cache容量不会使命中率线性提高
-
D. Cache位于CPU与主存之间
答案与解析
平台答案:A。
整理解析
Cache缩短平均访问时间,不扩大可编址主存容量,故A错误。“主存拷贝”是简化描述:写回缓存的脏块可能比主存更新;写未命中可用写分配或不写分配,不能像平台解析那样一概说写入主存即可。
题目 045
展开题目 045(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 45 题(原站解析入口)。
程序运行时,Cache与主存的地址映射由谁完成?
-
A. 操作系统
-
B. 程序员调度
-
C. 硬件自动
-
D. 用户软件
答案与解析
平台答案:C。
整理解析
地址映射、标记匹配等由Cache硬件自动执行,对普通应用程序透明。
题目 047
展开题目 047(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 47 题(原站解析入口)。
使用32K×8bit存储芯片,组成按字节编址、地址A0000H~DFFFFH的内存,至少需要几片?
-
A. 4
-
B. 8
-
C. 16
-
D. 32
答案与解析
平台答案:B。
整理解析
总容量为DFFFFH−A0000H+1=40000H=256KiB。每片32K×8bit=32KiB,因此需256/32=8片,且8bit已匹配字节位宽。
题目 048
展开题目 048(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 48 题(原站解析入口)。
计算机主存通常主要使用哪一种存储器件?
-
A. DRAM
-
B. SRAM
-
C. Cache
-
D. EEPROM
答案与解析
平台答案:A。
整理解析
DRAM密度高、单位容量成本低,适合大容量主存;SRAM更快、无需周期刷新但成本高,常用于Cache。Cache表示存储层次角色,不是与DRAM、SRAM并列的器件工艺。
题目 058
展开题目 058(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 58 题(原站解析入口)。
微机的BIOS(基本输入输出系统)通常保存在哪里?
-
A. 主板上的ROM
-
B. CPU的寄存器
-
C. 主板上的RAM
-
D. 虚拟存储器
答案与解析
平台答案:A。
整理解析
传统教材将BIOS归入主板ROM。现代BIOS/UEFI通常存于可更新的非易失性Flash,“固化”不代表永远不能改写;固件程序与保存启动设置的CMOS/NVRAM需要区分。
题目 066
展开题目 066(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 66 题(原站解析入口)。
CPU访问的数据常聚集在较小的连续区域:某地址被访问后,其邻近地址也可能被访问。这种性质叫什么?
-
A. 数据局部性
-
B. 指令局部性
-
C. 空间局部性
-
D. 时间局部性
答案与解析
平台答案:C。
整理解析
邻近地址可能被访问属于空间局部性;同一内容可能很快再次访问属于时间局部性。指令和数据都可能同时具有这两类局部性。
题目 070
展开题目 070(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 70 题(原站解析入口)。
CPU内外设置多级Cache,主要是为了什么?
-
A. 增加主存容量
-
B. 提高CPU访问主存中数据或指令的效率
-
C. 增加存储系统的存量
-
D. 加快CPU对外存的访问
答案与解析
平台答案:B。
整理解析
让经常访问的指令和数据尽量在更近、更快的层次命中,从而降低平均访存代价,缓解CPU与主存的速度差。Cache不扩充程序可用的主存地址空间。
题目 073
展开题目 073(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 73 题(原站解析入口)。
内存按字节编址,范围为A0000H~CFFFFH,容量为(73)字节;用64K×8bit芯片组成该内存,至少需(74)片。本题回答第73空。
-
A. 80KB
-
B. 96KB
-
C. 160KB
-
D. 192KB
答案与解析
平台答案:D。
整理解析
含首尾的容量为CFFFFH−A0000H+1=30000H=196608B=192KiB。题目选项中的KB按1024B使用,应选192KB。
题目 074
展开题目 074(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 74 题(原站解析入口)。
内存按字节编址,范围为A0000H~CFFFFH,容量为(73)字节;用64K×8bit芯片组成该内存,至少需(74)片。本题回答第74空。
-
A. 2
-
B. 3
-
C. 5
-
D. 8
答案与解析
平台答案:B。
整理解析
该区间总容量为192KiB,每片64K×8bit=64KiB,因此至少192/64=3片。本空求芯片数,第73空求容量,应区分所求量。
题目 076
展开题目 076(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 76 题(原站解析入口)。
程序执行时,Cache与主存的地址映射由谁负责?
-
A. 操作系统管理
-
B. 存储管理软件管理
-
C. 程序员自行安排
-
D. 硬件自动完成
答案与解析
平台答案:D。
整理解析
由Cache控制硬件按规则自动映射并比较标记。操作系统可影响缓存属性或执行维护操作,但不逐次负责地址映射;有标记比较逻辑也不等于所有Cache都是全相联。
题目 087
展开题目 087(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 87 题(原站解析入口)。
关于Flash Memory(闪存),下列哪项描述错误?
-
A. 断电仍能保存数据,属于非易失性存储器
-
B. 以块为单位删除
-
C. 采用随机访问,常用于替代主存
-
D. 嵌入式系统可用Flash替代ROM
答案与解析
平台答案:C。
整理解析
C错在把Flash说成通常用于替代工作主存。NOR Flash可随机读取、直接执行代码;NAND常按页读写、按块擦除。不能只用“能否随机访问”判断,平台列出的擦除块大小和速度比较也不是普遍规律。
题目 094
展开题目 094(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 94 题(原站解析入口)。
哪一种存储器件依靠周期性刷新来维持数据?
-
A. SRAM
-
B. DRAM
-
C. FLASH
-
D. EEPROM
答案与解析
平台答案:B。
整理解析
DRAM以电容电荷保存信息,电荷泄漏使其必须刷新;SRAM在通电时由双稳态电路保持数据。DRAM常用于主存,但DRAM是器件类型,主存是用途和层次,不能像平台解析那样等同。
题目 097
展开题目 097(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 97 题(原站解析入口)。
比较SRAM与DRAM的集成率、功率及刷新要求,下列哪项正确?
-
A. SRAM比DRAM集成率低、功率小,无需定期刷新
-
B. SRAM比DRAM集成率高、功率小,需要定期刷新
-
C. DRAM比SRAM集成率高、功率大,无需定期刷新
-
D. DRAM比SRAM集成率低、功率大,需要定期刷新
答案与解析
平台答案:A。
整理解析
SRAM通常每位占用更多晶体管,密度低、无需刷新;DRAM密度较高但需要刷新。平台选A,但其中“SRAM功率小”的说法缺少容量、工艺和访问负载等条件,不能仅凭有无刷新作普遍功耗排序。
题目 105
展开题目 105(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 105 题(原站解析入口)。
哪一种存储器用电容保存信息,并且需要周期性刷新?
-
A. DRAM
-
B. EPROM
-
C. SRAM
-
D. EEPROM
答案与解析
平台答案:A。
整理解析
电容存储与周期刷新对应DRAM。SRAM靠通电维持双稳态;EPROM和EEPROM属于断电仍保留信息的非易失性存储器。
五、I/O 数据传输控制方式
谁等待设备,谁搬运数据
| 控制方式 | CPU 怎样参与 | 主要辨识点 |
|---|---|---|
| 无条件传送 | 在已保证设备就绪的条件下,由 CPU 直接执行传送 | 不查状态、不等中断,仍由 CPU 搬运 |
| 程序查询 | 不断查询设备状态,由 CPU 执行数据传送 | 忙等、轮询 |
| 中断 | 设备就绪后通知 CPU,由中断服务程序处理 | 无需持续轮询,但 CPU 仍参与传送 |
| DMA | CPU 初始化参数,DMA 控制器在设备与内存间传送数据,结束后通常通知 CPU | 数据块传输,不逐字节由 CPU 搬运 |
| 通道 | 执行通道程序,独立组织较复杂的 I/O 操作 | 专用 I/O 控制、通道命令 |
| I/O 处理机 | 用专门处理器承担更完整的 I/O 工作 | 较强的独立处理能力 |
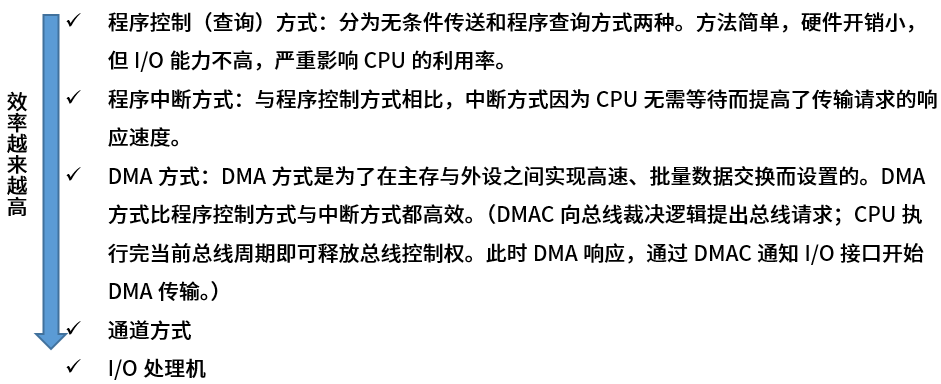
课件按 CPU 卸载程度给出效率递增趋势,但实际性能也受传输长度、配置开销、总线竞争和缓存一致性影响;短小传输未必 DMA 最划算。
中断允许 CPU 在设备准备期间执行其他程序;DMA 进一步让数据搬运不必逐次经过 CPU。DMA 不表示完全不需要 CPU,也不保证 CPU 访问主存永远不受影响。DMA 与 CPU 共享总线时可能采用周期窃取、突发传输等仲裁方式。
总线周期是一次总线访问所需的时间;它与时钟周期、指令周期含义不同。传统同步设备模型下,DMA 取得总线可在总线周期边界进行;可屏蔽外部中断通常在允许的指令边界被响应,具体由体系结构规定。
中断处理与现场保存
典型流程:设备发出中断请求 → CPU 在允许响应时保存必要状态 → 找到中断服务程序入口 → 执行服务 → 恢复现场 → 返回原程序。
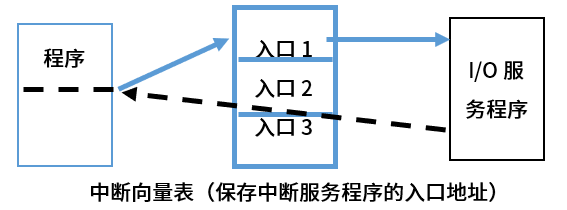
现场包括返回地址、状态寄存器和需要保留的通用寄存器等,具体由硬件与服务程序分工保存。保存现场是为了能够正确恢复被打断的执行,不是把整个内存复制一份。中断向量表用于定位服务入口,不用于保存完整现场。
中断响应时间从**请求发出**计到**开始进入服务程序**,包含等待允许响应、仲裁和必要入口操作;服务程序开始到结束的时间属于处理耗时。二者相加才接近事件的完整处理时间,不能用服务耗时代替响应延迟。
若高优先级中断打断正在执行的低优先级服务程序,就形成中断嵌套。进入顺序若为“原程序 → 中断甲 → 中断乙”,恢复顺序必须是“乙 → 甲 → 原程序”;堆栈的后进先出特性适合保存多层返回地址和状态。栈中保存的是 PC 等寄存器的值,不能用单个 PC 保存任意多层现场。
按来源区分,外部设备的完成通知属于外部中断;执行指令产生的除零、缺页等通常称为异常,是与该条指令相关的同步事件。这里“同步”指事件与指令执行有关,与多线程的同步互斥不是同一分类。DMA 完成可以通过中断通知 CPU,也可由软件查询完成状态。
严格说,“软件中断”常指程序执行 INT 等指令主动陷入处理程序;一些历史题却用它泛指除零等程序执行异常。应先读题目的分类口径,不能据此把除零异常等同于显式的软件中断指令。
例题 15:CPU 与外设并行
计算机运行过程中,CPU需要与外设进行数据交换。采用( )控制技术时,CPU与外设可并行工作。
A、程序查询方式和中断方式
B、中断方式和DMA方式
C、程序查询方式和DMA方式
D、程序查询方式、中断方式和DMA方式
参考答案与解析
答案:B,中断方式和 DMA 方式。
按教材分类,程序查询使 CPU 忙等;中断使 CPU 在设备准备期间可执行其他工作,DMA 还能由控制器执行块传送。这里“并行”强调 CPU 与设备工作的时间重叠,不表示它们同时占用同一条互斥总线。
例题 16:中断及保存现场
计算机运行过程中,遇到突发事件,要求CPU暂时停止正在运行的程序,转去为突发事件服务,服务完毕,再自动返回原程序继续执行,这个过程称为( ),其处理过程中保存现场的目的是( )。
A、阻塞
B、中断
C、动态绑定
D、静态绑定
A、防止丢失数据
B、防止对其他部件造成影响
C、返回去继续执行原程序
D、为中断处理程序提供数据
参考答案与解析
答案:第一空 B(中断);第二空 C(返回去继续执行原程序)。
“暂停当前程序、处理事件、返回继续”是中断。保存现场当然有助于不丢失执行状态,但题目问目的,最完整的表述是保证恢复后能够从正确位置继续原程序。
专项题库练习(14 题)
本小节对应题库练习共 14 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 016
来源:知识点练习「计算机组成与体系结构」第 16 题(原站解析入口)。
CPU的中断响应时间,应从哪个时刻量到哪个时刻?
-
A. 从发出中断请求到中断处理结束
-
B. 从中断处理开始到中断处理结束
-
C. CPU分析判断中断请求
-
D. 从发出中断请求到开始进入中断处理程序
答案与解析
平台答案:D。
整理解析
从中断请求发出到开始进入中断服务程序的间隔,才是响应时间;整个处理过程的耗时不包括在这一指标内。
题目 019
来源:知识点练习「计算机组成与体系结构」第 19 题(原站解析入口)。
CPU一般在下列哪一过程结束时响应DMA请求并交出总线?
-
A. 一条指令执行
-
B. 一段程序
-
C. 一个时钟周期
-
D. 一个总线周期
答案与解析
平台答案:D。
整理解析
传统共享总线模型要求先完成当前总线传输,所以在总线周期结束时响应,不必等待整条指令结束。平台关于总线周期、机器周期的包含关系不是通则,也不能把指令执行的全部耗时等同于总线传输。
题目 041
展开题目 041(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 41 题(原站解析入口)。
常见I/O控制包括无条件传送、中断、程序查询和DMA。哪一种无需CPU执行逐项传送数据的指令?
-
A. 中断
-
B. 程序查询
-
C. 无条件传送
-
D. DMA
答案与解析
平台答案:D。
整理解析
DMA硬件负责实际数据搬运。CPU通常仍要设置地址、长度和方向,并处理完成、异常及必要的缓存一致性,不能说整个I/O过程完全不需要CPU;DMA也有启动开销,并非任何数据量下都最快。
题目 050
展开题目 050(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 50 题(原站解析入口)。
CPU需要与外设交换数据时,哪些I/O控制方式允许CPU与外设并行工作?
-
A. 程序查询方式和中断方式
-
B. 中断方式和DMA方式
-
C. 程序查询方式和DMA方式
-
D. 程序查询方式、中断方式和DMA方式
答案与解析
平台答案:B。
整理解析
按程序查询忙等的模型,中断和DMA可让CPU在设备工作期间处理其他任务。中断不保证响应延迟一定小于轮询;DMA仍需CPU初始化和完成处理,总线争用也可能让CPU等待。
题目 052
展开题目 052(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 52 题(原站解析入口)。
CPU遇到突发事件后暂停当前程序,转去服务该事件,完成后自动回到原程序继续执行。这一过程称为(52),其中保存现场是为了(53)。本题回答第52空。
-
A. 阻塞
-
B. 中断
-
C. 动态绑定
-
D. 静态绑定
答案与解析
平台答案:B。
整理解析
该过程称为中断。平台共用解析中的“BC”是第52、53空依次为B、C,并非本题多选。静态绑定还可在链接阶段完成,不能仅限编译时。
题目 053
展开题目 053(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 53 题(原站解析入口)。
CPU遇到突发事件后暂停当前程序,转去服务该事件,完成后自动回到原程序继续执行。这一过程称为(52),其中保存现场是为了(53)。本题回答第53空。
-
A. 防止丢失数据
-
B. 防止对其他部件造成影响
-
C. 返回去继续执行原程序
-
D. 为中断处理程序提供数据
答案与解析
平台答案:C。
整理解析
保存返回地址、状态字和必要寄存器,是为了恢复被打断程序并继续执行,所以对应C。平台“BC”分别回答第52、53空;两小问独立保留。
题目 065
展开题目 065(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 65 题(原站解析入口)。
DMA控制方式在哪两个部分之间直接建立数据通路并交换数据?
-
A. CPU与主存
-
B. CPU与外设
-
C. 主存与外设
-
D. 外设与外设
答案与解析
平台答案:C。
整理解析
传统DMA在主存与外设之间搬运数据,CPU负责初始化和完成处理,不逐项执行搬运指令。平台称外设不能直接相互交换数据,并不是所有硬件的普遍限制。
题目 072
展开题目 072(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 72 题(原站解析入口)。
计算机处理中断时保存现场,主要是为了什么?
-
A. 避免中断处理程序的数据丢失
-
B. 避免破坏其他程序的数据
-
C. 确保正确返回被中断程序并继续执行
-
D. 给中断处理程序提供所需数据
答案与解析
平台答案:C。
整理解析
保存返回地址、必要寄存器和状态字,以便服务结束后恢复被中断程序的执行状态。无需复制全部内存,中断服务程序也不等同于“提出申请的另一个程序”。
题目 081
展开题目 081(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 81 题(原站解析入口)。
中断向量用于提供哪一种地址?
-
A. 函数调用结束后的返回地址
-
B. I/O设备的接口地址
-
C. 主程序的入口地址
-
D. 中断服务程序入口地址
答案与解析
平台答案:D。
整理解析
它用于定位中断服务程序的入口,与原程序的返回地址不同。不同体系结构可能由向量号索引表项,向量中也可能带状态信息。
题目 086
展开题目 086(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 86 题(原站解析入口)。
DMA每传送一个数据,按题目的模型需要占用哪一种周期?
-
A. 指令周期
-
B. 总线周期
-
C. 存储周期
-
D. 机器周期
答案与解析
平台答案:B。
整理解析
DMA传输需要使用总线,教材对应总线周期。实际设备可能有等待状态、多个总线拍或突发传输,不能把它理解为所有数据都恰好占一个时钟周期。
题目 088
展开题目 088(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 88 题(原站解析入口)。
按题干定义,异常来自处理器内部的指令执行事件,中断来自处理器外部请求。DMA传送结束和除法运算的除数为0,应分别归为哪类?
-
A. DMA结束与除数为0都属于中断
-
B. DMA结束属于中断,除数为0属于异常
-
C. DMA结束属于异常,除数为0属于中断
-
D. DMA结束与除数为0都属于异常
答案与解析
平台答案:B。
整理解析
按此分类,DMA完成通知来自处理器外部,归为中断;执行整数除零指令触发的是异常。DMA完成也可由软件轮询获知,不是每次完成都必然发送中断。
题目 091
展开题目 091(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 91 题(原站解析入口)。
关于程序中断和DMA两种I/O控制方式,哪项说法正确?
-
A. 两种方式都能让CPU与外设并行工作
-
B. 两种方式在传输数据期间都无需CPU干预
-
C. DMA传输速度低于程序中断方式
-
D. 两种方式都不需要CPU保护现场
答案与解析
平台答案:A。
整理解析
两者都允许CPU与外设并行工作,但中断方式的数据搬运仍需CPU执行服务程序;DMA由硬件搬运,CPU负责设置和完成处理。DMA应译为直接存储器访问,平台“直接寄存器存取”有误;无条件传送也不要求轮询就绪状态。
题目 092
展开题目 092(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 92 题(原站解析入口)。
中断向量提供下列哪一种地址?
-
A. 被选中设备的地址
-
B. 待传送数据的起始地址
-
C. 中断服务程序入口地址
-
D. 主程序的断点地址
答案与解析
平台答案:C。
整理解析
中断向量用于定位服务程序入口,不是设备地址、数据地址或原程序断点。具体由谁索引向量表取决于体系结构,平台所述“中断控制器负责查表”并非通则。
题目 098
展开题目 098(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 98 题(原站解析入口)。
实现多级中断时,用什么组织并保存程序现场最有效?
-
A. 通用寄存器
-
B. 累加器
-
C. 堆栈
-
D. 程序计数器
答案与解析
平台答案:C。
整理解析
嵌套中断应按进入顺序的逆序恢复,堆栈的后进先出特性正好匹配。PC和通用寄存器并非平台所称的“与本题无关”,它们的内容恰是需要保存的现场,只是不适合单独组织多层记录。
六、总线系统
总线是部件间传递信息的公共连接与协议机制;传统模型把它画成多根信号线,现代互连也可以采用串行链路及点对点结构。
| 分类角度 | 类别 | 含义 |
|---|---|---|
| 连接范围 | 芯片内总线、元件级总线、系统总线、外部/通信总线 | 分别连接芯片内部、电路板元件、主机组成部件及外部设备或系统 |
| 传输方式 | 串行、并行 | 按位依次传输;多条数据线同时传多位 |
| 信息用途 | 数据、地址、控制 | 传什么;到哪里;做何操作与何时响应 |
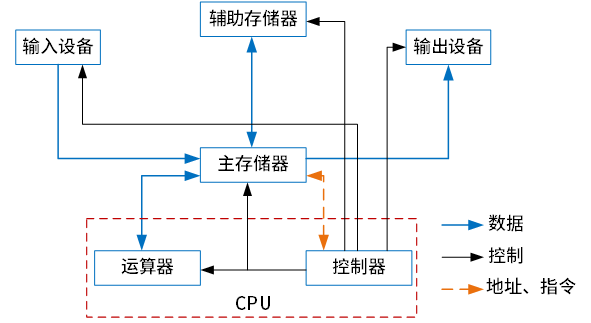
- 数据总线传送数据,也可传送取指时读出的指令字,并不限于 CPU 与 RAM 两者之间。
- 地址总线给出存储器或 I/O 地址;地址线数与可寻址单元数相关。
- 控制线承载读写控制、应答、中断、仲裁等信息,不应认为所有控制信息都只从 CPU 单向发出。
传统 PCI 是并行系统总线;PCI Express(PCIe) 使用串行点对点链路。传统并行 SCSI 是外设接口;SAS 是串行连接 SCSI。原文“PCI 目前广泛采用”“SCSI 一定并行”需要结合历史版本理解。串行/并行只描述传输组织,不能直接推断现代串行接口比并行接口慢。
位宽、带宽与同步方式
数据总线位宽是一次可并行传送的比特数;带宽是单位时间传送的数据量。若宽度为 W bit,时钟 f Hz,每 k 个周期才完成一次整字传输,则理想带宽为 (W/8)×f/k B/s。例如 64 bit、150 MHz、每 3 周期传一次,带宽为 8×150×10⁶/3=400 MB/s。这里 MB/s 按十进制计;换成 MiB/s 再除以 2²⁰。协议、等待和仲裁会使有效带宽低于理想值。
同步总线按共同的时钟约定传输时刻;异步总线通过请求/应答等握手信号协调设备何时完成传输,不依赖统一节拍。串行/并行描述位如何传输,同步/异步描述时序如何协调,是两个不同维度;有缓冲区本身不是异步的定义。
多个设备共用一条总线时,需要仲裁谁能发起当前传输。单总线结构连接简单,但同一传输资源上的争用可能成为瓶颈;专用总线可以按设备速度和协议匹配设计,也不能因此推断任何专用总线都无限快。
例题 17:三总线结构
三总线结构的计算机总线系统由( )组成。
A、CPU总线、内存总线和IO总线
B、数据总线、地址总线和控制总线
C、系统总线、内部总线和外部总线
D、串行总线、并行总线和PCI总线
参考答案与解析
答案:B,数据总线、地址总线和控制总线。
本题按传输信息的用途分类:传内容、指位置、发控制。其他选项混用了连接范围、传输方式或具体标准等不同分类维度。
专项题库练习(5 题)
本小节对应题库练习共 5 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 007
来源:知识点练习「计算机组成与体系结构」第 7 题(原站解析入口)。
按传输的信息类型划分,计算机的三总线结构包含哪三类总线?
-
A. CPU总线、内存总线和IO总线
-
B. 数据总线、地址总线和控制总线
-
C. 系统总线、内部总线和外部总线
-
D. 串行总线、并行总线和PCI总线
答案与解析
平台答案:B。
整理解析
数据、地址、控制总线分别传送数据、访问地址和控制/时序信号。平台把位宽称为带宽并不准确:位宽以bit计,带宽以bit/s或B/s计,还受频率和协议开销影响。
题目 017
来源:知识点练习「计算机组成与体系结构」第 17 题(原站解析入口)。
总线宽32bit,时钟频率200MHz,每5个时钟周期传送一个32bit字。带宽为多少MB/s?
-
A. 40
-
B. 80
-
C. 160
-
D. 200
答案与解析
平台答案:C。
整理解析
每次传4B,每秒传200×106/5次,带宽为160×106B/s=160MB/s。这里MB按106B计,不需要像平台解析那样把220与106近似相等;换为MiB/s约152.59。
题目 025
来源:知识点练习「计算机组成与体系结构」第 25 题(原站解析入口)。
关于计算机总线,下列哪项表述不正确?
-
A. 并行总线适用于近距离高速传输
-
B. 串行总线适用于长距离传输
-
C. 单总线能连接不同类型设备,设计简单且性能很高
-
D. 专用总线可按所连接设备进行最佳匹配设计
答案与解析
平台答案:C。
整理解析
单总线结构便于控制和扩充,但设备争用同一传输资源会限制总体性能,故C的“性能很高”不成立。并行近距、串行远距是传统经验,现代串行互连也广泛用于近距离高速传输。
题目 090
来源:知识点练习「计算机组成与体系结构」第 90 题(原站解析入口)。
关于PCI总线与SCSI总线的传输方式和内、外总线分类,哪项正确?
-
A. PCI:串行外总线;SCSI:并行内总线
-
B. PCI:串行内总线;SCSI:串行外总线
-
C. PCI:并行内总线;SCSI:串行内总线
-
D. PCI:并行内总线;SCSI:并行外总线
答案与解析
平台答案:D。
整理解析
本题按传统PCI和并行SCSI理解,对应并行内总线、并行外总线。PCI不能与串行PCI Express混淆;SCSI家族也包含SAS等串行技术。
题目 101
来源:知识点练习「计算机组成与体系结构」第 101 题(原站解析入口)。
所列信息交换场景中,哪一种采用异步传输?
-
A. CPU与内存交换信息
-
B. CPU与PCI总线交换信息
-
C. CPU与I/O接口交换信息
-
D. I/O接口与打印设备交换信息
答案与解析
平台答案:D。
整理解析
传统接口模型把打印设备与I/O接口之间按就绪、应答配合的传输归为异步,故平台选D。同步或异步取决于具体协议和时序,有缓存池不是异步的定义,也不能只凭设备名称判定所有实现。
七、指令与寻址方式
指令的组成与执行阶段
指令通常含操作码,以及操作数、寄存器编号或地址等字段。课件把后者概括为“地址码”,不意味着每条指令都必须包含主存地址。
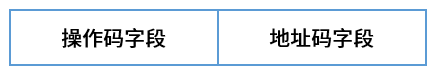
基础执行过程可分为**取指 → 分析/译码 → 执行**,更细的实现还能包含访存、写回等阶段。在存储程序模型中,CPU 是按当前取指或数据访问的用途解释内存内容;不能仅凭某串二进制位的外观区分它是指令还是数据。
看清保存的是数值还是地址
用 A 表示指令中的地址/立即数字段,Rᵢ 表示寄存器内容,M[A] 表示地址 A 处的内容。以下次数只计算**取操作数额外访问主存的次数,不计取指,也忽略 Cache**。
| 寻址方式 | 操作数 | 额外访存 | 关键词 |
|---|---|---|---|
| 立即寻址 | A | 0 | 数直接在指令里 |
| 主存直接寻址 | M[A] | 1 | 指令给出操作数地址 |
| 主存间接寻址 | M[M[A]] | 2 | 先到内存取地址,再取数 |
| 寄存器直接寻址 | Rᵢ | 0 | 寄存器里就是数 |
| 寄存器间接寻址 | M[Rᵢ] | 1 | 寄存器里存地址 |
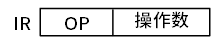
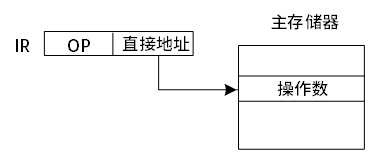
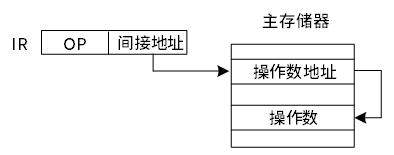
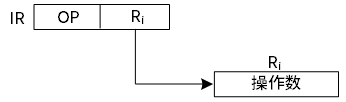
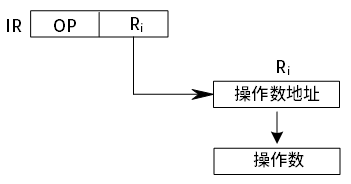
立即数通常受指令字段宽度限制,灵活性较低。“寄存器直接”和“主存直接”要看完整名称;“间接”意味着多了一层地址引用,并非意味着总共只访问一次内存。
例题 18:寻址速度的考试比较
计算机指令系统采用多种寻址方式。立即寻址是指操作数包含在指令中,寄存器寻址是指操作数在寄存器中,直接寻址是指操作数的地址在指令中。这三种寻址方式操作数的速度( )。
A、立即寻址最快,寄存器寻址次之,直接寻址最慢
B、寄存器寻址最快,立即寻址次之,直接寻址最慢
C、直接寻址最快,寄存器寻址次之,立即寻址最慢
D、寄存器寻址最快,直接寻址次之,立即寻址最慢
参考答案与解析
按教材的简化比较,答案:A。
假定指令已经取到,立即数就在指令中;寄存器寻址需要读取指定寄存器;主存直接寻址还要访问存储器,所以考试排序为“立即 → 寄存器 → 主存直接”。
工程上立即数和寄存器操作的实际延迟取决于译码、数据通路、依赖关系及处理器实现,不能把该排序当成所有 CPU 上严格的性能定律。
专项题库练习(2 题)
本小节对应题库练习共 2 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 022
来源:知识点练习「计算机组成与体系结构」第 22 题(原站解析入口)。
指令的地址字段直接给出操作数本身,这属于哪种寻址方式?
-
A. 隐含寻址
-
B. 寄存器寻址
-
C. 立即寻址
-
D. 直接寻址
答案与解析
平台答案:C。
整理解析
立即寻址把操作数编码在指令中。直接寻址给出的是操作数地址,寄存器寻址给出的是寄存器编号,注意“值”与“地址”的区别。
题目 093
来源:知识点练习「计算机组成与体系结构」第 93 题(原站解析入口)。
立即寻址把操作数放在指令中,寄存器寻址把操作数放在寄存器中,直接寻址把操作数地址放在指令中。取得操作数的速度应怎样排序?
-
A. 立即寻址最快,寄存器寻址其次,直接寻址最慢
-
B. 寄存器寻址最快,立即寻址其次,直接寻址最慢
-
C. 直接寻址最快,寄存器寻址其次,立即寻址最慢
-
D. 寄存器寻址最快,直接寻址其次,立即寻址最慢
答案与解析
平台答案:A。
整理解析
按指令已取到后的额外取数开销比较:立即数无需再读,寄存器寻址需读寄存器,直接寻址需访存,因此依次为立即、寄存器、直接。这是教学模型,不是所有实际程序在所有微架构上的严格耗时排序。
八、CISC 与 RISC
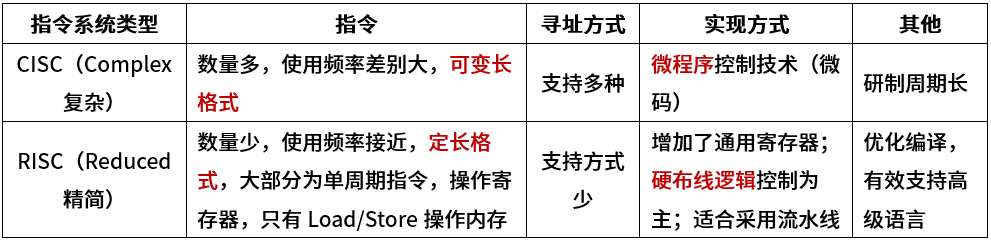
| 维度 | CISC 经典特征 | RISC 经典特征 |
|---|---|---|
| 指令 | 种类较多,允许复杂操作 | 操作规整,常用指令简单 |
| 编码 | 常见变长格式 | 常见定长或规整格式 |
| 寻址 | 较复杂、多样 | 较少、规整 |
| 访存 | 指令可有较复杂的存储器操作数形式 | 典型 Load/Store 结构,算术主要操作寄存器 |
| 控制实现 | 常与微程序控制联系 | 常与硬布线、流水线联系 |
| 寄存器与编译 | 依实现而异 | 通常强调较多通用寄存器和编译优化 |
以上是**考试中的经典设计倾向,不是现代 CPU 的绝对边界**。RISC 也可能提供压缩指令和多种长度,一条指令也可能需多个周期;CISC 处理器同样广泛使用流水线,并可能把复杂指令译成内部微操作。“单周期”还要区分一条指令的延迟和流水线稳定后每周期完成一条的吞吐能力。
CISC 全称为 Complex Instruction Set Computer(复杂指令系统计算机),RISC 为 Reduced Instruction Set Computer(精简指令系统计算机)。典型 Load/Store 设计由加载、存储指令访问主存,普通算术指令在寄存器间运算;复杂操作可能分解为更多简单指令,所以指令种类少不代表一个程序执行的指令总数也少。
硬布线控制器用组合逻辑及时序电路产生控制信号,适合规则的指令译码;微程序控制器从控制存储器读取微指令序列,组织实现一条机器指令所需的微操作,便于表达复杂控制。二者都是控制器的实现方法,可以混合使用;微指令不等同于程序员编写的机器指令。
**VLIW(Very Long Instruction Word,超长指令字)**由编译器把可并行的操作安排到一个长指令字的不同槽位,交给多个功能单元执行。关键是编译期分析依赖和资源冲突,不是把任意相邻指令拼起来就能并行。它与 Flynn 的“指令流/数据流”分类角度不同;VLSI 则是超大规模集成电路的工艺规模名称。
例题 19:识别 RISC 特点
以下关于RISC(精简指令系统计算机)技术的叙述中,错误的是( )。
A、指令长度固定、指令种类尽量少
B、指令功能强大、寻址方式复杂多样
C、增加寄存器数目以减少访存次数
D、用硬布线电路实现指令解码,快速完成指令译码
参考答案与解析
答案:B。
“功能强大、寻址方式复杂多样”是本题用来描述 CISC 的经典特征。A、C、D 对应教材中的 RISC 倾向。现代 RISC 的指令长度和实现方式可有例外,不改变这道经典分类题的预期答案。
专项题库练习(7 题)
本小节对应题库练习共 7 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 011
来源:知识点练习「计算机组成与体系结构」第 11 题(原站解析入口)。
比较RISC与CISC,下列哪项说法不正确?
-
A. RISC的指令系统通常更复杂
-
B. RISC通常配置更多寄存器
-
C. RISC编译器的子程序库通常比CISC的大得多
-
D. RISC更符合VLSI工艺对规整性的要求
答案与解析
平台答案:A。
整理解析
经典定义中RISC采用较精简、规则的指令,A把复杂程度说反了。其余表述是教材的典型倾向,不能视为现代处理器的硬性规则;尤其“子程序库大得多”不能仅凭指令集类别推出。
题目 024
来源:知识点练习「计算机组成与体系结构」第 24 题(原站解析入口)。
缩写CISC对应哪个术语?
-
A. 复杂指令系统计算机
-
B. 超大规模集成电路
-
C. 精简指令系统计算机
-
D. 超长指令字
答案与解析
平台答案:A。
整理解析
CISC是Complex Instruction Set Computer,即复杂指令系统计算机;RISC则表示精简指令系统计算机。
题目 030
来源:知识点练习「计算机组成与体系结构」第 30 题(原站解析入口)。
缩写VLIW指什么?
-
A. 复杂指令系统计算机
-
B. 超大规模集成电路
-
C. 单指令流多数据流
-
D. 超长指令字
答案与解析
平台答案:D。
整理解析
VLIW即Very Long Instruction Word,超长指令字。编译器把可并行操作安排在一个长指令字中,交给不同功能单元执行;不能把任意有依赖的指令拼接就视为加速。
题目 069
来源:知识点练习「计算机组成与体系结构」第 69 题(原站解析入口)。
下列关于RISC(精简指令系统计算机)的描述,哪项错误?
-
A. 指令长度固定,指令种类尽量少
-
B. 指令功能强大,寻址方式复杂多样
-
C. 增加寄存器,减少访存
-
D. 采用硬布线解码,快速完成译码
答案与解析
平台答案:B。
整理解析
经典RISC强调指令简单规则、寻址方式较少、寄存器较多,B的强复杂指令及多样寻址不符合。定长指令和硬布线是传统设计倾向,并非所有现代RISC的强制定义。
题目 085
来源:知识点练习「计算机组成与体系结构」第 85 题(原站解析入口)。
比较RISC和CISC计算机,下列哪项说法正确?
-
A. RISC不使用流水线,CISC使用流水线
-
B. RISC使用复杂指令,CISC使用简单指令
-
C. RISC通用寄存器很少,CISC通用寄存器很多
-
D. RISC采用组合逻辑控制器,CISC普遍采用微程序控制器
答案与解析
平台答案:D。
整理解析
D符合经典教材对典型实现的概括:RISC常用硬布线,CISC常用微程序。两类都能流水化,平台“CISC不适合流水线”过于绝对;现代CISC常译成内部微操作,硬布线与微程序也可以混用。
题目 099
来源:知识点练习「计算机组成与体系结构」第 99 题(原站解析入口)。
下列RISC与CISC比较中,哪项说法不正确?
-
A. RISC大多数指令在一个时钟周期内完成
-
B. RISC普遍用微程序控制器,CISC普遍用硬布线控制器
-
C. RISC的指令种类和寻址方式比CISC少
-
D. RISC和CISC都采用流水线
答案与解析
平台答案:B。
整理解析
B把传统控制实现说反了:RISC常用硬布线,CISC常用微程序,两者都可流水化。“大多一周期”只是理想化概括,不能将每周期完成一条的吞吐率与单条指令延迟混同。
题目 102
来源:知识点练习「计算机组成与体系结构」第 102 题(原站解析入口)。
关于RISC(精简指令集计算机)的特点,哪项说法错误?
-
A. 限制存储器操作,以简化控制
-
B. 指令种类丰富,功能强大
-
C. 配置大量通用寄存器
-
D. 选用使用频率较高的指令,提高执行速度
答案与解析
平台答案:B。
整理解析
RISC通常采用较简单、规则的指令与寻址方式,并用较多寄存器减少访存,故“种类多、功能强”不符合。精简本身不保证任意程序更快,实际时间还取决于指令数、CPI、主频和编译效果。
九、流水线技术
重叠的是多条指令的不同阶段
流水线把执行过程分段,使各段在同一时刻服务于不同指令。例如第一条指令在执行,第二条在分析,第三条在取指。
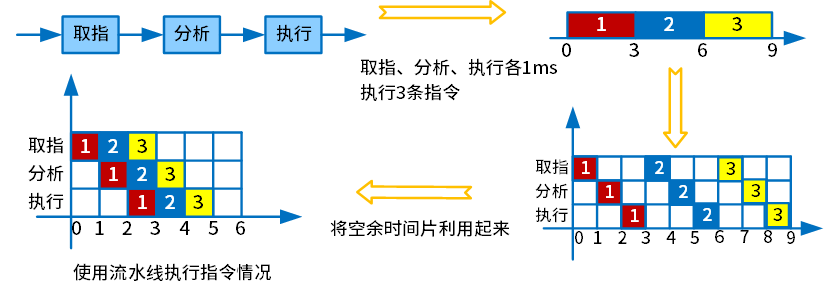
流水线主要提高**整体吞吐率和部件利用率**,不保证缩短单条指令的延迟;段间寄存器等开销还可能增加单条延迟。图中每段 1 ms、共 3 段,串行执行 3 条需要 9 ms,理想流水执行需要 5 ms。
流水线会因三类相关而停顿:结构相关是不同指令争用同一硬件,数据相关是后面的指令等待前面的结果,控制相关是分支使后续取指方向尚未确定。暂停推进称为停顿,清除错误路径中的指令会产生空泡,吞吐率和加速比随之下降。
在总工作量和级间开销可比的条件下,各级耗时越均衡,最慢级造成的空等通常越少。异步控制通过握手推进阶段,仍受数据依赖和慢阶段限制,不能保证明显提速。流水线题的理想公式只在忽略这些额外代价时成立。
时间公式先分清模型
设有 n 条指令、k 个阶段,各段时间为 t₁…tₖ,最长段时间 τ=max(tᵢ)。下表先忽略阶段间寄存器开销、冲突、相关与分支停顿。
| 模型 | 总时间 | 适用条件 |
|---|---|---|
| 串行 | n×Σtᵢ |
一条全部完成再开始下一条 |
| 课件常称“理论公式” | Σtᵢ+(n−1)×τ |
首条按各段实际耗时通过,随后按瓶颈间隔完成 |
| 统一时钟的同步流水线,常称“实践公式” | (k+n−1)×τ |
每级均占一个完整时钟周期,首条经过 k 个周期 |
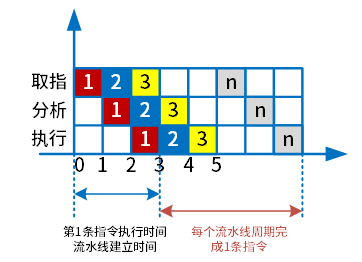
各段不等长时,Σtᵢ 不等于 kτ。 两个公式描述不同的计时假设,不能把一个当作另一个的恒等变形。实际同步流水线的时钟周期还需要计入寄存器与时钟等开销;若有 s 个停顿周期,则在简单单发射模型下可写为 (k+n−1+s)×τ。
计算顺序:列阶段时间 → 找最慢段 → 确认首条延迟口径 → 加后续 n−1 条的间隔。若题目给出时空图或时钟规定,优先按它计算。
**原思考:**一条指令的执行过程可以分解为取指、分析和执行三步,在取指时间 t取指=3△t、分析时间 t分析=2△t、执行时间 t执行=4△t 的情况下,若按串行方式执行,则 10 条指令全部执行完需要( )△t;若按流水线的方式执行,流水线周期为( )△t,则 10 条指令全部执行完需要( )△t。
参考答案与两种计时口径
按原课件理论口径:90、4、45。
串行时间 10×(3+2+4)=90△t;最长段为 4△t;流水时间 (3+2+4)+9×4=45△t。
若题目指定各级按统一 4△t 时钟推进,则为 (3+10−1)×4=48△t。45 和 48 的区别来自首条延迟分别为 9 和 12,不能混算。
吞吐率、加速比与效率
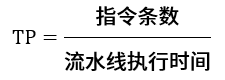
有限任务的平均吞吐率 TP=n/T;理想稳定状态最大吞吐率为 TPmax=1/τ。吞吐率单位是“条/时间”,不能写成单纯时间。
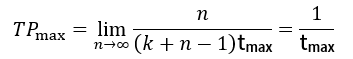
**原思考:**一条指令的执行过程可以分解为取指、分析和执行三步,取指时间 t取指=3△t、分析时间 t分析=2△t、执行时间 t执行=4△t。10 条指令的吞吐率?最大吞吐率?
参考答案与推导
沿用理论总时间 45△t,平均吞吐率为 10/(45△t)=2/(9△t),最大吞吐率为 1/(4△t)。
若采用同步时钟总时间 48△t,这 10 条的平均吞吐率为 10/(48△t)=5/(24△t),稳定阶段的最大吞吐率仍为 1/(4△t)。
加速比 S=串行时间/流水时间,必须比较相同工作量并说明计时模型。对于 k 级等长、无停顿的理想流水线,效率可用 E=S/k=n/(n+k−1);若各段不等长、所占硬件资源不同,不应无条件沿用这一定义。课件关于“暂未考查某参数”的判断具有时间性,复习仍应理解参数含义。
例题 20:流水线与单条指令延迟
下列关于流水线方式执行指令的叙述中,不正确的是( )。
A、流水线方式可提高单条指令的执行速度
B、流水线方式下可同时执行多条指令
C、流水线方式提高了各部件的利用率
D、流水线方式提高了系统的吞吐率
参考答案与解析
答案:A。
流水线让多条指令的不同阶段重叠,提高单位时间完成的指令数,并不保证单条指令更快。B 的“同时执行多条”指多条在流水线中同时处于不同阶段,不等于每条都占用同一个执行部件。
例题 21:100 条指令的流水时间
将一条指令的执行过程分解为取指、分析和执行三步,按照流水方式执行,若取指时间t 取指 =4△t、分析时间t 分析 =2△t、执行时间t 执行 =3△t,则执行完100条指令,需要的时间为( )△t。
A、200
B、300
C、400
D、405
参考答案与解析
按课件采用的理论公式,答案:D,405△t。
首条耗时 4+2+3=9△t,最慢段为 4△t,后 99 条各增加 4△t,总时间 9+99×4=405△t。
若明确要求三级都按统一 4△t 时钟对齐,应为 (3+100−1)×4=408△t。该结果不在给定选项中,说明这道历史题采用前一种口径;不能因此宣称真实同步流水线也一定为 405。
专项题库练习(8 题)
本小节对应题库练习共 8 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 004
来源:知识点练习「计算机组成与体系结构」第 4 题(原站解析入口)。
一条指令分取指、分析、执行三步,耗时分别为4△t、2△t、3△t。600条指令顺序执行共需(4)△t;按执行第i条、分析第i+1条、取第i+2条重叠的流水线执行,共需(5)△t。本题回答第4空。
-
A. 2400
-
B. 3000
-
C. 3600
-
D. 5400
答案与解析
平台答案:D。
整理解析
顺序执行时每条耗时(4+2+3)△t=9△t,600条总耗时600×9=5400△t。第5空属于另一小问。
题目 005
来源:知识点练习「计算机组成与体系结构」第 5 题(原站解析入口)。
一条指令分取指、分析、执行三步,耗时分别为4△t、2△t、3△t。600条指令顺序执行共需(4)△t;按执行第i条、分析第i+1条、取第i+2条重叠的流水线执行,共需(5)△t。本题回答第5空。
-
A. 2400
-
B. 2405
-
C. 3000
-
D. 3009
答案与解析
平台答案:B。
整理解析
按平台采用的理想时序,首条延迟为9△t,此后每4△t完成一条,总时间为9+599×4=2405△t。若各级统一占一个4△t时钟周期,则会得到2408△t,不能混用这两种模型。
题目 018
来源:知识点练习「计算机组成与体系结构」第 18 题(原站解析入口)。
关于指令流水线的性能度量,哪项表述错误?
-
A. 最大吞吐率由最慢流水段的耗时决定
-
B. 断流会使加速比明显下降
-
C. 要使加速比和效率最大化,应让各级运行时间相同
-
D. 采用异步控制会使流水线性能明显提升
答案与解析
平台答案:D。
整理解析
异步控制没有必然明显提速的保证,D不成立;平台称异步必然增加阻塞概率也缺乏普遍依据。忽略开销和停顿时,k级等时流水线执行n条的总时间为(n+k−1)τ,吞吐率n/[(n+k−1)τ],加速比nk/(n+k−1);有限批次仍不能因各级等时就达到稳态上限。
题目 035
来源:知识点练习「计算机组成与体系结构」第 35 题(原站解析入口)。
指令按取指、分析、执行三级流水处理,t取指=4△t、t分析=2△t、t执行=3△t。完成100条指令共需多少△t?
-
A. 200
-
B. 300
-
C. 400
-
D. 405
答案与解析
平台答案:D。
整理解析
按平台的实际首条延迟模型,T=(4+2+3)+99×4=405△t。4△t是后续完成间隔,并非每条指令的完整延迟;若每级统一占4△t时钟周期,则总时间为408△t。
题目 046
来源:知识点练习「计算机组成与体系结构」第 46 题(原站解析入口)。
四级指令流水线依次完成取指、取数、运算和保存结果,各需8ns、9ns、4ns、8ns。操作周期至少为多少ns?
-
A. 4
-
B. 8
-
C. 9
-
D. 33
答案与解析
平台答案:C。
整理解析
忽略级间开销时,周期至少等于最慢级耗时max(8,9,4,8)=9ns。实际同步电路还需计入流水寄存器、建立时间和时钟偏差。
题目 056
来源:知识点练习「计算机组成与体系结构」第 56 题(原站解析入口)。
吞吐率表示流水线单位时间处理的任务数。各流水段耗时不同时,题目所指的吞吐率是哪项时间量的倒数?
-
A. 最短流水段操作时间
-
B. 各段流水的操作时间总和
-
C. 最长流水段操作时间
-
D. 流水段数乘以最长流水段操作时间
答案与解析
平台答案:C。
整理解析
最慢级决定稳态输出间隔,理想最大吞吐率为1/最长段耗时。该结论忽略级间开销、冲突和停顿;有限批次应按任务数/总耗时计算,计入填充与排空,不能直接用此倒数代替实际吞吐率。
题目 062
来源:知识点练习「计算机组成与体系结构」第 62 题(原站解析入口)。
关于用流水线执行指令,下列哪项说法不正确?
-
A. 能加快单条指令的执行
-
B. 能同时执行多条指令
-
C. 能提高各部件利用率
-
D. 能提高系统吞吐率
答案与解析
平台答案:A。
整理解析
流水线让不同指令的阶段重叠,主要提高多指令吞吐率和部件利用率,不保证缩短单条指令延迟。平台称单条指令耗时与顺序执行相同,只适用于忽略流水寄存器等开销的简化模型。
题目 075
来源:知识点练习「计算机组成与体系结构」第 75 题(原站解析入口)。
每条指令分取指、分析、执行三步,t取指=5△t、t分析=2△t、t执行=3△t。题面规定以[取指]k、[分析]k+1、[执行]k+2重叠的流水线执行,完成500条指令共需多少△t?
-
A. 2500
-
B. 2505
-
C. 2510
-
D. 2515
答案与解析
平台答案:B。
整理解析
平台按首条实际延迟加后续完成间隔计算:T=(5+2+3)+499×5=2505△t。若三级统一占5△t时钟周期,则应为2510△t。另有原题笔误:按递增指令序号,同一时刻应为[取指]k+2、[分析]k+1、[执行]k;原页的下标方向已核实确实写反,此处保留题面和平台答案口径。
十、可靠性、可维护性与可用性
先区分“持续不坏”与“此刻可用”
| 指标 | 回答的问题 | 常见表达 |
|---|---|---|
| 可靠性 R(t) | 在指定条件和时间 t 内,持续完成规定功能而不失效的概率 | 恒定失效率 λ 的指数模型下 R(t)=e^(−λt) |
| MTTF | 到首次失效或一个工作期结束的平均运行时间 | 指数寿命模型下 MTTF=1/λ |
| MTTR | 修复所需的平均时间 | 指数修复时间模型下 MTTR=1/μ |
| 可维护性 M(t) | 在规定条件下于时间 t 内修复完成的概率 | 指数修复模型下 M(t)=1−e^(−μt) |
| 可用性 A | 在需要时能够工作的概率或长期运行时间比例 | 简单交替工作/修复模型下 A=MTTF/(MTTF+MTTR) |
1/λ 和 1/μ 要求相应的恒定率/指数分布假设;一般分布不能凭某个瞬时失效率直接取倒数当均值。

MTBF 的统计口径必须读清:
- 课件图把相邻两次故障时刻之间的整个周期叫 MTBF,包含修复和工作,所以写成
MTBF=MTTR+MTTF。按这个定义,可用性为MTTF/MTBF。 - 很多工程资料把 MTBF 定义为“总运行时间/故障次数”,不含维修停机时间。按此口径,常见公式为
A=MTBF/(MTBF+MTTR)。 - 不能把两种 MTBF 定义混在同一推导里。维修时间很小时它们数值可能接近,但定义仍不相同。
原课件的 MTTF/(1+MTTF)、1/(1+MTTR)、MTBF/(1+MTBF) 是历史教材中用来描述指标随平均时间单调变化的归一化表达,不是通用可靠性、可维护性和可用性公式。分母中的 1 若没有时间单位或归一化基准,就不能直接与一个时间量相加;它们也没有说明任务时间、修复模型等条件。
例如同一个 1 小时时间换成 60 分钟,直接套用 x/(1+x) 会从 1/2 变为 60/61,说明缺少基准时并不是单位无关的概率。历史选择题可以识别其指定对应关系,但工程计算应回到上表的模型。
补充理解:某设备平均工作 1000 小时、平均修复 10 小时,简单模型的长期可用性为 1000/1010≈99.01%;若工作寿命服从指数分布,它持续工作 1000 小时不坏的可靠度为 e⁻¹≈36.79%。可用性高不表示长时间完全不发生故障,快速修复也能提高可用性。
还有一类题直接给出观察样本。在同一批 N 个初始正常部件都观察到时刻 t、期间未修复也未退出统计时,若有 f 个失效,可靠度的样本估计为 (N−f)/N。例如 500 个部件运行到规定时长有 3 个失效,估计可靠度为 0.994。f/N 是该时段的失效比例,不是单位为“每小时”的失效率 λ;不能把二者直接互换。
例题 22:历史试题中的可用性指标
计算机系统的( )可以用MTBF/(1+MTBF)来度量,其中MTBF为平均失效间隔时间。
A、可靠性
B、可用性
C、可维护性
D、健壮性
参考答案与解析
按该历史教材的对应关系,答案:B,可用性。
这是辨认课件所使用指标名称的题。MTBF/(1+MTBF) 不能作为工程上的通用可用性公式;必须说明时间基准及 MTBF 是否包含维修时间。常见运行时间口径下,可用性为 MTBF/(MTBF+MTTR),修复时间不会自动等于 1。
串联、并联与混联系统
以下 Rᵢ 必须指**同一任务时间**内的可靠度,且假定各部件失效独立、连接/切换等附加部件理想。若存在共同电源故障、环境共因失效或切换失败,要另建模型。
| 结构 | 工作条件 | 系统可靠度 |
|---|---|---|
| 串联 | 所有部件都工作 | R=R₁×R₂×…×Rₙ |
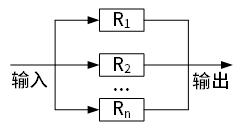
| 并联冗余 | 至少一个支路工作 | R=1−(1−R₁)(1−R₂)…(1−Rₙ) |
| 串并混联 | 先求各局部子系统,再组合 | 按可靠性逻辑逐层化简 |
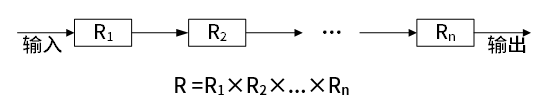
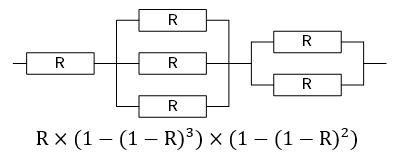
图中的结构为“单个部件 → 三个部件并联 → 两个部件并联”,所以在上述独立性假设下,可靠度为 R×[1−(1−R)³]×[1−(1−R)²]。
原文把这张图称作“N 模混合系统”,容易与**多数表决的 N 模冗余**混淆。图上没有表决器,公式按普通串并联解释。以理想表决器的三模冗余为例,要求三个部件至少两个成功,可靠度为 3R²(1−R)+R³,并不是 1−(1−R)³。
例题 23:串并联系统可靠度
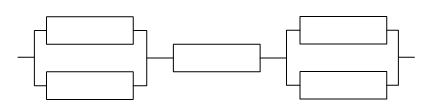
某计算机系统由下图所示的部件构成,假定每个部件的千小时可靠度都为R,则该系统的千小时可靠度为( )。
A、R+2R/4
B、R+R 2 /4
C、R(1-(1-R) 2)
D、R(1-(1-R) 2) 2
参考答案与解析
答案:D,R[1−(1−R)²]²。
图中从左到右是“两部件并联 → 单部件 → 两部件并联”。每个并联组的可靠度为 1−(1−R)²,三个子系统串联,因此:
R系统 = [1−(1−R)²]×R×[1−(1−R)²] = R[1−(1−R)²]²。
这是同一千小时任务时长下、各部件失效独立且连接理想的结果。检验边界:R=0 时系统可靠度为 0,R=1 时为 1。
专项题库练习(9 题)
本小节对应题库练习共 9 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 038
来源:知识点练习「计算机组成与体系结构」第 38 题(原站解析入口)。
MTBF表示平均失效间隔时间。按题目给出的MTBF/(1+MTBF),所度量的系统属性是哪一种?
-
A. 可靠性
-
B. 可用性
-
C. 可维护性
-
D. 健壮性
答案与解析
平台答案:B。
整理解析
平台把它归为可用性,但该式不是通式。若MTBF约定为平均正常运行时长,稳态可用率为MTBF/(MTBF+MTTR),只有MTTR按相同单位等于1或已归一化时才化为题式;若MTBF包含修复时间,则不能再重复加MTTR。稳态可用率也不等于任意时刻的瞬时可用度。平台另称可靠性等于MTTF/(1+MTTF)是错误的,可靠度应为R(t)=P(T>t),指数寿命模型下才有R(t)=e−t/MTTF。
题目 042
来源:知识点练习「计算机组成与体系结构」第 42 题(原站解析入口)。
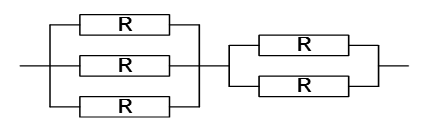
系统由一组三部件并联与一组两部件并联串接而成,见图。每个部件的千小时可靠度均为R,求系统的千小时可靠度。
-
A. (1-R3)(1-R2)
-
B. (1-(1-R)3)(1-(1-R)2)
-
C. (1-R3)+(1-R2)
-
D. (1-(1-R)3)+(1-(1-R)2)
答案与解析
平台答案:B。
整理解析
独立失效、连接理想时,两组可靠度分别为1−(1−R)3和1−(1−R)2,串联后相乘。1−R是同一千小时区间的失效概率,平台将其称作失效率不准确;共同原因故障存在时不能直接套独立乘积。
题目 060
展开题目 060(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 60 题(原站解析入口)。
图中左侧三个部件并联,右侧两个部件并联,两组再串联。每个部件的千小时可靠度都是R,系统的千小时可靠度是多少?
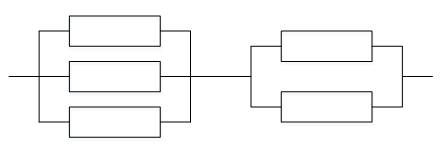
-
A. (3R+2R)/2
-
B. R/3+R/2
-
C. (1-(1-R)3)(1-(1-R)2)
-
D. (1-(1-R)3-(1-R)2)
答案与解析
平台答案:C。
整理解析
假设部件独立失效,每组至少一个正常即可工作,则两组可靠度为1−(1−R)3、1−(1−R)2,串联取乘积。存在共同原因故障时,此独立概率公式不再直接适用。
题目 067
展开题目 067(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 67 题(原站解析入口)。
系统由3个部件组成,各部件的千小时可靠度均为R;系统千小时可靠度为[1−(1−R)2]R。哪种连接方式符合?
-
A. 3个部件全部串联
-
B. 3个部件全部并联
-
C. 前两个部件并联,再与第三个串联
-
D. 第一个部件与后两个并联形成的子系统串联
答案与解析
平台答案:C。
整理解析
平台答案为C,但C、D实际上都成立。独立失效条件下,C得到[1−(1−R)2]R,D得到R[1−(1−R)2],两式相等。部件可靠度相同,串联子系统的前后顺序不影响结果,平台把D判错没有依据。
题目 071
展开题目 071(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 71 题(原站解析入口)。
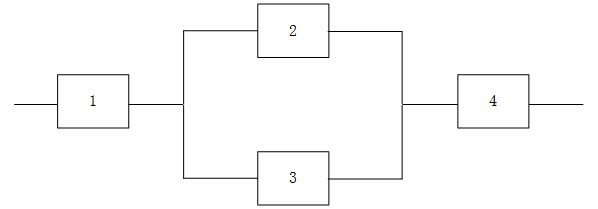
系统按部件1—并联冗余部件2和3—部件4串接,见图。部件1、2、3的可靠度依次为0.90、0.80、0.80,要求系统可靠度不低于0.85。部件4的可靠度至少应为多少?
- A. 0.85 / {0.9×[1−(1−0.8)2]}
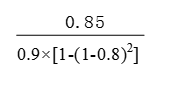
- B. 0.85 / [0.9×(1−0.8)2]
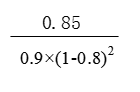
- C. 0.85 / [0.9×(0.8+0.8)]
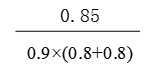
- D. 0.85 / [0.9×2×(1−0.8)]
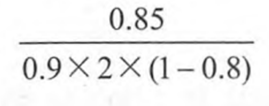
答案与解析
平台答案:A。
整理解析
按独立失效模型,R系统=0.9×[1−(1−0.8)2]×R4=0.864R4。因此R4≥0.85/0.864=425/432≈0.983796,即至少约98.38%,对应A。
题目 083
展开题目 083(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 83 题(原站解析入口)。
可靠性定义为系统在给定条件和时间区间内无失效运行的概率。MTTF为平均无故障时间,MTTR为平均修复时间;题目要求选择计算软件可靠性的公式。
-
A. MTTF/(1+MTTF)
-
B. 1/(1+MTTF)
-
C. MTTR/(1+MTTR)
-
D. 1/(1+MTTR)
答案与解析
平台答案:A。
整理解析
平台答案为A,但MTTF/(1+MTTF)不是通用可靠度公式。可靠度是R(t)=P(T失效>t);指数寿命模型下才有R(t)=e−t/MTTF。平均运行时长/(平均运行时长+MTTR)是交替运行/修复模型的稳态可用度,两者不能混淆。未规定时间归一化基准时,“1+时间”还存在量纲问题。
题目 089
展开题目 089(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 89 题(原站解析入口)。
题目将软件可维护性描述为系统在特定时间区间内正常进行维护活动的概率。MTTF表示平均无故障时间,MTTR表示平均故障修复时间;应选哪个可维护性公式?
-
A. MTTF/(1+MTTF)
-
B. 1/(1+MTTF)
-
C. MTTR/(1+MTTR)
-
D. 1/(1+MTTR)
答案与解析
平台答案:D。
整理解析
平台答案为D,但1/(1+MTTR)至多是规定时间基准后的归一化指标,不是通用维护概率或修复率。维护度为M(t)=P(T修复≤t);若修复时间服从指数分布,则修复率μ=1/MTTR,M(t)=1−e−t/MTTR。μ的单位是1/时间,不能与概率混用;平台把MTTF/(1+MTTF)当作通用可靠性公式也不成立。
题目 100
展开题目 100(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 100 题(原站解析入口)。
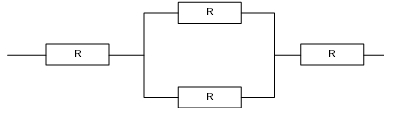
计算机系统的连接结构如图:首尾各一个部件串联,中间是两个部件并联。题目给定每个软件的千小时可靠度R=0.95,求系统千小时可靠度的表达式。
-
A. 0.95×(1-(1-0.95)2)×0.95
-
B. 0.95×(1-0.95)2×0.95
-
C. 0.95×2×(1-0.95)×0.95
-
D. 0.954×(1-0.95)
答案与解析
平台答案:A。
整理解析
独立失效、并联任一支路成功即可工作时,系统可靠度=0.952×[1−(1−0.95)2]=0.90024375,约90.02%,对应A。题目称软件,实际软件副本可能因共同缺陷相关失效,不能无条件假定独立。
题目 104
展开题目 104(先作答,再查看解析)
来源:知识点练习「计算机组成与体系结构」第 104 题(原站解析入口)。
某种部件用于2000台计算机,运行1000小时后有4台的该部件失效。其千小时可靠度R是多少?
-
A. 0.990
-
B. 0.992
-
C. 0.996
-
D. 0.998
答案与解析
平台答案:D。
整理解析
到1000小时仍正常的比例为(2000−4)/2000=0.998。平台用1−λt计算只是一阶近似,并非通用可靠度公式;若假设恒定失效率,应为R(t)=e−λt,失效率估计还需考虑实际暴露时间。
补充:媒体表示与数据量计算
本节对应已入库早期真题中的媒体基础。先分清“信息是什么”“怎样编码”和“由什么设备呈现”:
| 类别 | 含义与例子 |
|---|---|
| 感觉媒体 | 直接作用于感官的信息形式,如文字、声音、图像 |
| 表示媒体 | 信息的编码形式,如字符编码、音频编码 |
| 表现媒体 | 输入或呈现信息的设备,如扫描仪、显示器、音箱 |
| 存储媒体 | 保存信息的物理介质,如磁盘、光盘 |
| 传输媒体 | 传递信息的物理通路,如电缆、光纤 |
BMP 常用于位图,WAV、MP3 常用于音频,MOV、AVI 常用于视频及音频等轨道的封装。容器格式不等于压缩编码,不能仅凭 MOV 后缀确定视频采用何种编码,也不能认定所有 WAV、BMP 都使用同一种未压缩表示。按工具主要用途区分:Photoshop 编辑图像,Premiere 编辑视频,PowerPoint 制作演示文稿,Acrobat 处理 PDF。
扫描题先把物理尺寸换成像素:宽、高分别乘每英寸采样点数。题面常写 DPI,图像像素密度也常写 PPI;这里按题给的扫描采样密度计算。**原始、未压缩、紧密存放**的位图数据量为 宽像素数×高像素数×每像素位数/8,不含文件头、行对齐等开销。例如 2×3 英寸图片按 200 点/英寸扫描,得到 400×600 像素;24 位 RGB 每像素 3 B,数据量为 400×600×3=720000 B。横向为 400 像素、纵向为 600 像素;24 位表示颜色深度,不能当作分辨率。压缩文件大小还取决于图像内容和编码设置。
采样率表示每秒采多少次,量化位数表示每次样本用多少位,声道数表示同时记录几路。在信号已带限的理想模型中,采样率须高于最高频率的两倍以避免混叠,实际还需抗混叠滤波及余量。传统窄带电话语音常限在约 3.4 kHz,采用 8 kHz 采样;这不是所有人声或音频的固定采样率。若题目给未压缩 PCM,则 字节数=采样率×量化位数×声道数×秒数/8,不直接用于压缩音频。
在其他条件可比时,基频主要对应音高(音调),振幅影响声强和主观响度,波形与谐波结构影响音色。FM 合成还涉及载波、调制频率和调制指数,参数变化可能同时影响多个听觉属性。不能把历史题里“幅度改变音高”的平台答案当作一般声学规律。
章节回顾与关键词辨析
| 知识主题 | 应能独立完成的任务 | 容易混淆的地方 |
|---|---|---|
| 数据的表示 | 进制互转;解释补码;计算表示范围;拆解浮点字段 | 位数含不含符号位;不同数值数目不等于比特串数目;IEEE 偏置不是半量程偏置 |
| 校验码 | 判断检错与纠错能力;CRC 模二除;海明校验位数和分组 | 奇数个位而非奇数位置;余数 0 不保证无错;SEC 与 SECDED |
| CPU | 由职责辨认 PC、IR、AR、DR、ALU、控制器 | 地址与内容;当前指令与下一条地址 |
| 存储系统 | 判断局部性和介质;Cache 映射、平均时间;地址空间与芯片数 | 命中时间与未命中代价;字节和位;编程粒度与擦除粒度 |
| I/O 控制 | 区分查询、中断、DMA;说明中断现场的作用 | 无需忙等不等于 CPU 不参与;DMA 不等于零 CPU 开销 |
| 总线 | 按连接范围、传输方式、用途分别分类 | 三总线是数据/地址/控制;PCI 与 PCIe 不同 |
| 寻址 | 顺着引用找到操作数,数清额外访存次数 | 寄存器存的是值还是地址;不把取指混入取数次数 |
| CISC/RISC | 识别经典设计倾向 | 考试特点并非现代实现的绝对限制 |
| 流水线 | 找瓶颈,算建立时间、总时间、平均和最大吞吐率 | Σtᵢ 与 kτ;单条延迟与整体吞吐率 |
| 可靠性 | 区分指标,化简串并联图 | 任务时间与长期比例;独立性;MTBF 的统计口径 |
做题时先圈出决定模型的条件:字长/符号、编码方式、编址单位、额外耗时/总耗时、时钟对齐、串联/并联、独立失效,再选择公式。关键词能帮助定位知识点,真正决定答案的是这些条件。
课件来源
来自用户指定的《2026 版本软件设计师考试精讲班视频教程讲义电子版》,通过 Obsidian Web Clipper 正文输入框提取。以下 12 个目录项已合并进本篇,含 46 张本地教学图;提要与回顾不重复拆成文章。
| 原课件 | chapterId | 本篇归属 |
|---|---|---|
| 课程内容提要 | 161672 | 开篇提要 |
| 数据的表示 | 161675 | 主题一 |
| 校验码 | 161676 | 主题二 |
| 计算机组成 | 161677 | 主题三 |
| 存储系统 | 161678 | 主题四 |
| I/O 数据传输控制方式 | 161679 | 主题五 |
| 总线系统 | 161680 | 主题六 |
| 寻址方式 | 161681 | 主题七 |
| CISC 与 RISC | 161682 | 主题八 |
| 流水线技术 | 161683 | 主题九 |
| 可靠性 | 161684 | 主题十 |
| 章节回顾 | 161685 | 回顾与关键词辨析 |