程序设计语言基础:课件整理与例题解析
本篇合并本章的课程内容提要、程序设计语言、语言处理程序基础和章节回顾四篇课件。教学图片已下载到本地;原题与选项保留,例题统一编号。折叠区域的**参考答案、推导与纠错由本笔记补充,并非课件提供的官方答案**。原图中的笔误和简化说法在相邻正文中说明。
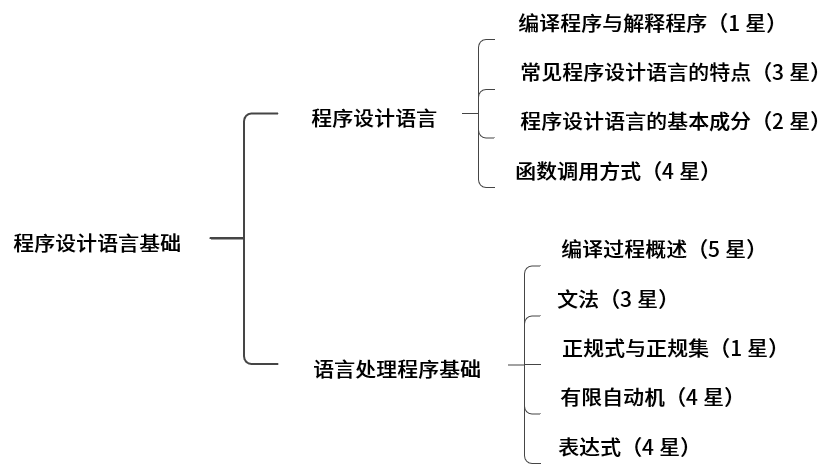
本章先理解语言如何描述数据与操作,再理解函数调用如何传递数据,最后沿“字符 → 记号 → 语法结构 → 代码”学习编译过程、文法、正规式和有限自动机。已有的第 03 章知识导图适合配合复习;课件提要中的星级只表示讲义的复习建议。
一、编译、解释与常见语言
编译与解释的比较
**编译**把一种表示的程序翻译成另一种表示;目标可以是本机机器码、字节码或其他中间表示。**解释**由解释器在运行时执行源程序或中间表示。二者可以出现在同一套语言实现中。
| 观察点 | 传统提前编译为本机代码 | 典型解释执行 |
|---|---|---|
| 翻译与执行 | 先产生目标程序,再运行 | 解释器在运行时参与执行 |
| 目标程序 | 还可能需要链接、装入及运行库 | 不一定产生可独立运行的本机程序 |
| 运行开销 | 通常省去运行时逐步解释的开销 | 通常有解释调度开销 |
| 可移植性 | 同一份机器码受架构、操作系统及 ABI 限制 | 同一份程序仍需兼容的解释器、库及平台环境 |
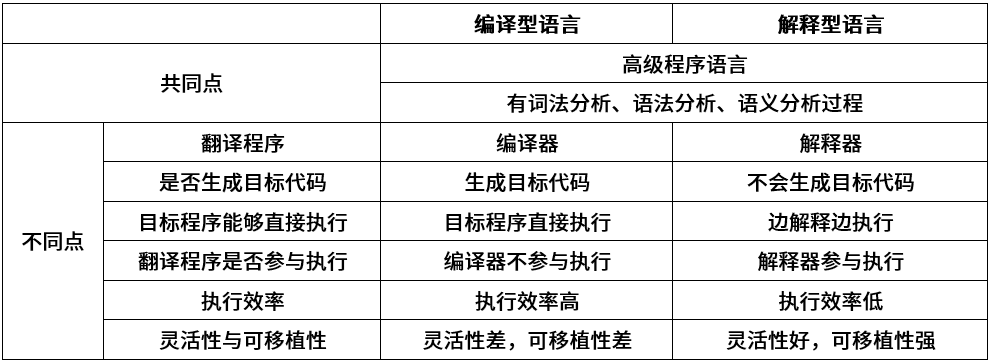
原表用于传统考试对比,不能把“编译一定快、解释一定慢”“编译型语言不可移植”当成普遍结论。性能受实现、优化和任务影响;源代码可移植性与编译产物可移植性也不是一回事。
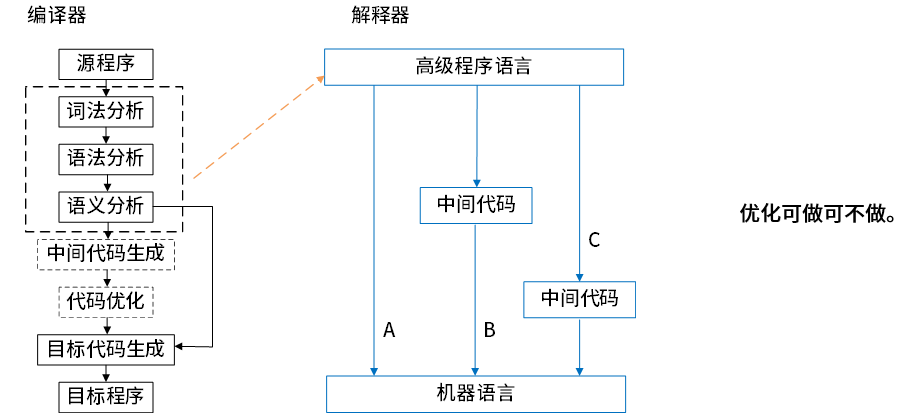
原课件“编译得到目标代码,解释得到中间代码”的概括不够准确:编译也常生成中间代码,解释器也不一定先生成独立中间代码。例如 Java 通常先由 javac 编译为字节码,JVM 再解释执行或通过 JIT 编译热点代码;CPython 通常先把 Python 源码编译为字节码,再由虚拟机执行。不要将一种语言永久划为互斥的“编译型”或“解释型”。
例题 1:编译器的传统特点
编译器与解释器是程序语言翻译的两种基本形态,以下关于编译器工作方式及特点的叙述中,正确的是( )。
A、边翻译边执行,用户程序运行效率低且可移植性差
B、先翻译后执行,用户程序运行效率高且可移植性好
C、边翻译边执行,用户程序运行效率低但可移植性好
D、先翻译后执行,用户程序运行效率高但可移植性差
参考答案与解析
按本题的传统本机编译模型,选 D。 先翻译后执行是主要判断点;“效率高、可移植性差”比较的是传统本机目标程序与解释执行环境。
B 的“可移植性好”若指源程序,未必错误,因此不能脱离题目模型机械记忆。实际语言实现可能混合字节码、解释和 JIT。
常见语言的识别关键词
| 语言 | 课件关键词与适用理解 |
|---|---|
| Fortran | 科学计算、数值计算;重视数组计算和执行效率 |
| Pascal | 教学、结构化程序设计;Delphi 使用 Object Pascal |
| C | 过程式、指针、系统开发;可以细致控制内存 |
| Lisp | 符号处理、列表、函数式编程;人工智能研究中的经典语言 |
| C++ | 面向对象、泛型、底层控制;支持多种范式 |
| Java | 面向对象、字节码、JVM;跨平台依赖兼容运行时与库 |
| C# | 面向对象、.NET、中间语言;可采用 JIT 或 AOT 等实现 |
| Prolog | 事实、规则、逻辑推理;知识表示和专家系统 |
| Python | 动态类型、多范式、脚本与自动化;常见实现含字节码编译阶段 |
| PHP | 常用于 Web 服务端脚本,可嵌入 HTML;实现也可包含字节码与 JIT |
关键词用于辨认主要特点,并不限定语言只能完成某一种任务。
函数式编程以函数求值和组合来组织计算,常强调把函数作为数据传递、减少可变共享状态;Lisp 是经典代表。逻辑编程则描述事实和规则,由推理机制回答查询,Prolog 是典型代表。面向对象以类和对象组织状态与行为,Python 也支持这种方式。一种语言可同时支持多种范式,“函数式代表”不等于其他语言不能使用函数或高阶函数。
开发操作系统底层时,需要精确控制内存、硬件接口和运行时开销,因此 C/C++ 常被选用;这是一种适用性比较,不是宣称操作系统只能用这两种语言实现。Python 等高级运行环境更适合上层自动化与应用逻辑;XML 和 HTML 则主要描述结构化文档,不靠它们自身执行通用程序逻辑。
脚本、标记语言与包管理
脚本通常用来自动化操作、连接已有组件或在宿主环境中执行,也能使用变量、函数和控制结构;“用于脚本”与“通用语言”并不冲突。HTML 这类标记语言主要描述页面结构、链接等文档信息;PHP 可在服务端执行逻辑,根据请求或数据库内容生成 HTML。动态网页需要可执行的处理逻辑,但并非只有 PHP 才能实现。
Python 的**安装包**与**导入模块**属于不同步骤:在终端执行 python -m pip install 包名,把包安装到所选解释器的环境;在程序内执行 import 模块名,加载已能找到的模块供代码调用。例如安装 requests 后,程序中才能使用 import requests(前提是该运行环境确实能找到它)。指定 python -m pip 可以减少把包误装到另一套 Python 环境的情况;安装名与导入名也不保证总是相同。这与在 Android 项目中先声明依赖、再在源码中引用相应类属于不同层次的操作相似。
例题 2:脚本语言
以下关于脚本语言的叙述中,正确的是( )。
A、脚本语言是通用的程序设计语言
B、脚本语言更适合应用在系统级程序开发中
C、脚本语言主要采用解释方式实现
D、脚本语言中不能定义函数和调用函数
参考答案与解析
按课件的分类口径,选 C。 脚本语言通常通过解释环境运行,D 显然错误;Python、JavaScript 等均能定义和调用函数。B 不是脚本语言的一般优势。
A 的措辞有歧义:不少脚本语言本身确实是通用语言。因此 C 是本题预期答案,但不能由此推出“所有脚本语言都不是通用程序设计语言”。“脚本语言”更多描述常见使用方式和运行环境。
例题 3:Python 的特点
Python语言的特点不包括( )。
A、跨平台、开源
B、编译型
C、支持面向对象程序设计
D、动态编程
参考答案与解析
按传统分类选 B。 Python 通常归入解释型语言;支持跨平台、开源生态、面向对象及动态类型等特征。
本题不能推出“Python 完全不编译”。CPython 的字节码编译、其他实现的 JIT 等,属于实现层面的具体机制。
专项题库练习(11 题)
本小节对应题库练习共 11 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 001
来源:知识点练习「程序设计语言基础」第 1 题(原站入口)。
从以下语言或技术中选择更适合处理动态网页的一项。
- A. HTML
- B. LISP
- C. PHP
- D. JAVA/C++
答案与解析
平台答案:C。
整理解析
PHP 面向 Web 服务端开发,可根据请求生成页面,按题目侧重点选 C。HTML 主要描述页面结构;Java 等也能开发动态网站。纠错:平台用“比 CGI 或 Perl 更快”作一般结论并不严谨,CGI 是接口机制,性能还取决于实现、运行方式和具体任务。
题目 004
来源:知识点练习「程序设计语言基础」第 4 题(原站入口)。
按传统的编译执行与解释执行模型,以下关于是否生成源程序对应目标程序的说法,哪项正确?
- A. 编译方式生成目标程序,解释方式不生成
- B. 解释方式生成目标程序,编译方式不生成
- C. 两种方式都生成目标程序,仅优化效率不同
- D. 两种方式都不生成目标程序,仅是否优化不同
答案与解析
平台答案:A。
整理解析
编译先产出目标程序,再执行该结果;纯解释由解释器在运行中处理源程序或内部表示,按这一教材口径选 A。限定:解释器也可能先生成字节码,现代实现还能结合即时编译;“不生成”不是说解释器不能有任何中间表示。
题目 008
展开题目 008(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 8 题(原站入口)。
以下哪项通常被归为支持面向对象的解释型程序设计语言?
- A. XML
- B. Python
- C. Prolog
- D. C
答案与解析
平台答案:B。
整理解析
Python 支持类和对象,常见实现通过解释执行字节码运行,选 B。XML 是标记语言,Prolog 以逻辑编程为主要范式,C 通常采用编译实现。这里是常见使用方式的分类,并不限制 Python 只能解释执行。
题目 030
展开题目 030(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 30 题(原站入口)。
以下关于脚本语言的说法,哪项符合其通常的实现特点?
- A. 脚本语言是通用程序设计语言
- B. 脚本语言更适合开发系统级程序
- C. 脚本语言主要采用解释方式实现
- D. 脚本语言不能定义或调用函数
答案与解析
平台答案:C。
整理解析
按传统分类,脚本常交由解释器执行,C 的“主要”表述最合适;脚本当然可以定义和调用函数。口径说明:是否通用与是否用于脚本并不互斥,例如 Python 是通用语言;也有只服务特定环境的脚本语言。因此不能把 A 当作所有脚本语言的共同定义,或反过来断言脚本语言都不通用。
题目 041
展开题目 041(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 41 题(原站入口)。
在以下选项中,哪种语言通常更适合开发操作系统?
- A. C/C++
- B. Java
- C. Python
- D. JavaScript
答案与解析
平台答案:A。
整理解析
操作系统底层需要控制内存布局、硬件接口和运行时开销,C/C++ 在这些方面较适合,故选 A。纠错:平台所说现行操作系统“均由 C/C++ 开发”过于绝对;系统也常含汇编,并可采用 Rust 等其他语言。
题目 042
展开题目 042(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 42 题(原站入口)。
下列关于脚本语言、标记语言及编译执行的说法,哪项不正确?
- A. 脚本语言不使用变量和函数
- B. 标记语言常用于描述格式化和链接
- C. 脚本语言采用解释方式实现
- D. 编译型语言执行效率更高
答案与解析
平台答案:A。
整理解析
脚本程序可以使用变量并定义、调用函数,A 明显错误,保留平台答案 A。表述限定:C、D 是教材对常见实现的概括;脚本实现也可含字节码或即时编译,而执行效率必须比较具体实现和任务,不能视为无条件规律。
题目 047
展开题目 047(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 47 题(原站入口)。
按常见编程语言范式分类,下列哪项是函数式语言的代表?
- A. Lisp
- B. Prolog
- C. Python
- D. Java/C++
答案与解析
平台答案:A。
整理解析
Lisp 是函数式编程的重要早期代表,按本题分类选 A;Prolog 以逻辑编程为代表。限定:语言往往支持多种范式,Lisp 也能包含可变状态,Python、Java/C++ 也提供函数式特性,不能由此断言其他语言完全不支持函数式编程。
题目 048
展开题目 048(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 48 题(原站入口)。
把高级语言程序转化为计算机可执行的形式时,按传统编译与纯解释模型,以下关于目标程序的说法哪项正确?
- A. 编译和解释都会生成逻辑上等价的目标程序
- B. 编译和解释都不会生成逻辑上等价的目标程序
- C. 编译生成逻辑上等价的目标程序,解释不生成
- D. 解释生成逻辑上等价的目标程序,编译不生成
答案与解析
平台答案:C。
整理解析
编译的结果是目标语言程序;纯解释则在解释器控制下执行源程序或内部表示,按此口径选 C。纠错与限定:编译目标不一定是机器码,也可以是其他目标语言;解释器也可使用字节码。“是否生成独立目标程序”是本题采用的传统区分。
题目 083
展开题目 083(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 83 题(原站入口)。
按通常的 Python 语言特点分类,以下哪项不属于其典型特征?
- A. 跨平台、开源
- B. 编译型
- C. 支持面向对象程序设计
- D. 动态编程
答案与解析
平台答案:B。
整理解析
教材通常把 Python 归为动态的解释型语言,因此本题选 B。纠错与限定:常见实现也会先编译为字节码,还可采用即时编译等技术,不能理解成 Python 完全没有编译过程;这里的分类说的是常见执行方式。
题目 086
展开题目 086(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 86 题(原站入口)。
使用 pip 安装 numpy,以下哪个命令正确?
- A.
pip numpy - B.
pip install numpy - C.
install numpy - D.
import num
答案与解析
平台答案:B。
整理解析
pip 的 install 子命令用于安装包,所以选 B。import 是程序运行时导入模块的语句,不是安装命令。需要明确使用哪个 Python 环境时,也可运行 python -m pip install numpy。
题目 090
展开题目 090(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 90 题(原站入口)。
编译器与解释器是程序语言处理的两种基本形态。按传统教材对本机代码编译执行的比较,以下哪项描述编译器的工作方式及特点?
- A. 边翻译边执行,程序运行效率低且可移植性差
- B. 先翻译后执行,程序运行效率高且可移植性好
- C. 边翻译边执行,程序运行效率低但可移植性好
- D. 先翻译后执行,程序运行效率高但可移植性差
答案与解析
平台答案:D。
整理解析
先把源程序翻译为目标程序,再运行目标程序,符合编译执行,按本机二进制的教材比较选 D。限定:可移植性较差指特定指令集和运行环境的目标二进制,不等于源代码不能换平台重新编译;编译也可面向可移植字节码,效率比较同样依赖具体实现。
二、基本成分与 Python 数据类型
程序设计语言通常提供描述**数据、运算、控制、数据传输**的成分。数据类型规定可取的值及可执行的操作;表达式通过运算组合值;控制结构决定执行顺序;赋值、输入输出和参数传递等完成数据传输。
标识符是给变量、函数、用户定义类型等程序实体使用的名字。它必须满足语言的拼写和命名规则,并在使用位置有相应声明或绑定。关键字/保留字由语言规定用途,通常不能当作普通自定义名字;注释则用于说明源码,通常不会产生可被程序引用的变量或类型。合法的标识符拼写不代表它在当前作用域已经定义。
变量、常量、作用域与存储期
变量把名字与可使用的值或对象关联起来,常量按语言规则限制重新赋值。局部/全局说的是可见范围,变量/常量说的是可否改变,存储期说的是对象存在多久,这三组概念不能互相代替。普通局部变量当然可以更新;C 的静态局部变量名字只在局部可见,存储却持续整个程序运行期。Kotlin 的 val 限制重新赋值,若它引用可变列表,列表内容仍可变化。Python 的动态类型表示类型主要关联对象,许多类型检查发生在执行时,名字也可重新绑定到不同类型的对象;并不是对象没有类型或任何运算都合法。
高级语言抽象了具体机器指令,但程序仍可能依赖平台 API、数据尺寸或运行库;“高级”不是无条件跨平台的保证。整型与浮点型混合运算是否自动提升,也依语言而定:Java 常先按数值提升规则转换;Kotlin 的混合数值算术可由运算符重载支持,但把 Int 变量赋给 Double 变量时需要显式转换,例如 count.toDouble()。浮点转整数与整数转浮点的方向不同,后者也可能因有效位数有限而丢失精度。
容器、可变性与常见运算
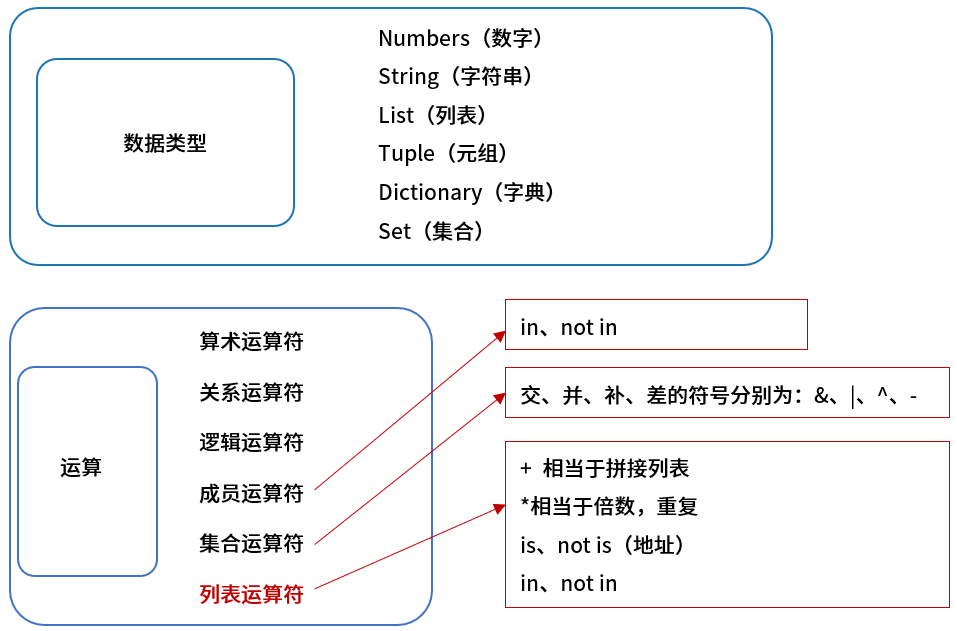
| 类型 | 顺序与访问 | 是否可变 | 重复内容 | 空对象 |
|---|---|---|---|---|
list |
有序序列,用整数下标或切片访问 | 可变 | 元素可重复 | [] |
tuple |
有序序列,用整数下标或切片访问 | 不可变 | 元素可重复 | () |
dict |
按键访问;Python 3.7 起语言规范保证保持插入顺序 | 可变 | 键唯一,值可以重复 | {} 或 dict() |
set |
不保证插入顺序,没有位置下标或键值索引 | 可变 | 元素不重复,且必须可哈希 | set() |
原文称字典“无序、无重复数据”,不适用于现代 Python:字典保持插入顺序,但不属于按位置索引的序列;重复写入同一个键会更新该键的值,不同键可以对应相同的值。集合没有“索引为键值”这一机制。{} 是空字典,空集合必须写 set()。
数值、字符串和元组对象不可变;列表、字典和集合对象可变。元组的不可变性指其中各位置的引用不能替换,引用的可变对象内部仍可变化。
运算时要分清三个维度:
==比较值,is/is not比较对象身份;原图的not is应改为is not。身份比较不是通用的“值相等”判断。in/not in检查成员;用于字典时默认检查键。- 集合的
&、|、^、-分别是交集、并集、对称差集、差集。原图把^写成“补”不准确;相对于全集 U 的补集应写成U - A。 - 列表的
+连接序列,*重复序列。重复会复制元素引用,不会递归复制内部对象,如[[]] * 2的两个位置指向同一个列表。
非空元组由**逗号**形成:(7) 是整数,(7,) 才是单元素元组;7,8 也可构成元组。type(obj) 查询对象类型,id(obj) 查询对象标识,str(obj) 取得字符串表示,三者用途不同。字典 d={"score":90} 中,del d["score"] 删除键值项;del d[0] 因没有键 0 而抛出 KeyError,不是删除第一个位置;del d 则删除名字的绑定,不保证对象没有其他引用。
Python 的切片、输入与异常
range(start,stop,step) 产生等差整数序列,range(stop) 默认从 0 开始、步长为 1,不含 stop。seq[start:stop:step] 是切片,也从 start 开始且不含 stop;step 为负时向较小索引移动。比如 list(range(9))[7:1:-2] 访问索引 7、5、3,结果为 [7,5,3],不会取终止索引 1。seq[::-1] 省略起止边界,用于反转整个序列;切片中的步长不能为 0。
Python 3 的 input() 读取一行,去掉末尾换行符后返回**字符串**。输入看起来像数字也不会自动变成数值:text=input() 后需要 int(text) 才尝试转换为整数,无法转换时会抛出 ValueError。类似地,列表乘整数是按顺序重复整个列表,不是逐元素乘法;例如 [3,5]*3 得到 [3,5,3,5,3,5]。
列表推导式 [表达式 for 变量 in 可迭代对象 if 条件] 按迭代次序取值,先筛选,满足条件才计算表达式并加入**新列表**。例如 [v*v for v in [2,3,4] if v%2==0] 依次保留 2、4,得到 [4,16]。切片赋值则修改原列表:默认步长为 1 时,可用不同长度的序列替换选中区间,用 [] 替换就是删除;扩展切片的步长不为 1 时,赋值长度须与选中位置数相同。
Python 用 try/except 捕获异常,raise 主动抛出异常,语法名称与 Java/Kotlin 的 try/catch 不同。else 在 try 主体未抛异常时执行;finally 在正常离开或异常传播时进行收尾。示例用一个函数处理输入文本:
这里非法整数文本会在 except 中得到处理;数值小于等于 0 则在 else 中抛出新的异常,它不会被同一 try 的 except 再次捕获。raise 是抛出语句,不是捕获结构;finally 也不保证进程被强制终止时仍能执行。
Python 常见库的职责
| 库 | 主要职责 |
|---|---|
| NumPy | 多维数组与数值计算;数组乘数可进行逐元素运算,语义不同于普通 list 的重复 |
| Matplotlib | 绘制图表,例如训练损失曲线与结果可视化 |
| TensorFlow、PyTorch | 构建模型、自动求导、训练与推理等深度学习能力 |
| Keras | 提供搭建和训练神经网络的高层接口 |
绘图库可以参与深度学习工作流,但“展示训练结果”与“负责构建、训练模型”是不同职责。不能因为两个库都常出现在同一份 Notebook 中就把它们归为同类。
三种基本控制结构
顺序结构按先后执行;选择结构根据条件选分支;循环结构按条件重复执行。
Python 的分支写作 if/elif/else,没有名为 switch...case 的语句;Python 3.10 起的 match...case 是结构模式匹配。for 遍历可迭代对象,while 按条件重复,两者均可带 else:循环正常结束且没有通过 break 退出时执行,包括一轮也没进入的情况;它不是每轮迭代后执行的分支。continue 只跳过本轮余下语句,不像 break 那样阻止循环正常结束后的 else。
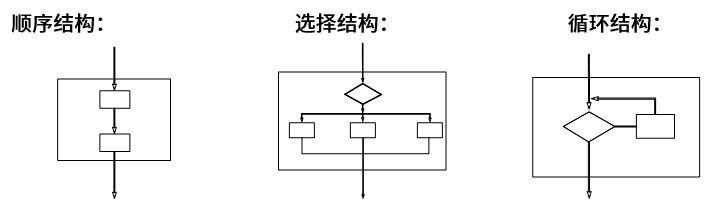
例题 4:基本控制结构
通用的高级程序设计语言一般都会提供描述数据、运算、控制和数据传输的语言成分,其中,控制包括顺序、( )和循环结构。
A、选择
B、递归
C、递推
D、函数
参考答案与解析
答案:A,选择。 三种基本结构是顺序、选择、循环。递归是通过函数调用自身解决问题的机制,不是此处要填的基本控制结构。
例题 5:Python 的有序可变序列
在Python语言中,( )是一种可变的、有序的序列结构,其中元素可以重复。
A、元组(tuple)
B、字符串(str)
C、列表(list)
D、集合(set)
参考答案与解析
答案:C,列表。 按条件依次排除:元组和字符串不可变;集合不是有序序列,也没有位置索引;列表同时满足可变、有序、可重复。
专项题库练习(11 题)
本小节对应题库练习共 11 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 014
来源:知识点练习「程序设计语言基础」第 14 题(原站入口)。
以下有关程序设计语言、变量和常量的说法中,哪项错误?
- A. 语言的基本成分包括数据、运算、控制、传输等
- B. 高级语言不依赖具体机器硬件
- C. 局部变量的值在程序运行期间不能改变
- D. 常量的值在程序运行期间不能改变
答案与解析
平台答案:C。
整理解析
“局部”限定名字可见的范围,不表示值不可修改。普通可赋值的局部变量能在其生存期内多次更新,因此 C 错误。常量的不可变性与变量是否局部是不同概念。
题目 035
来源:知识点练习「程序设计语言基础」第 35 题(原站入口)。
高级语言中,哪些对象通常可以由程序员用自定义标识符命名?候选对象为:①关键字或保留字,②变量,③函数,④数据类型,⑤注释。
- A. ①②③
- B. ②③④
- C. ①③⑤
- D. ②④⑤
答案与解析
平台答案:B。
整理解析
变量名、函数名以及用户定义的类型名或类型别名都可由程序员声明,对应②③④,选 B。关键字由语言预先规定,注释内容通常不参与程序的名称绑定。
题目 054
展开题目 054(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 54 题(原站入口)。
按常见的数值运算和赋值规则,下列哪种操作会涉及把整型数据转换成浮点型数据?
- A. 把浮点变量的值赋给整型变量
- B. 把整型常量赋给整型变量
- C. 将整型变量与浮点型变量相加
- D. 将浮点常量与浮点型变量相加
答案与解析
平台答案:C。
整理解析
混合相加时,通常先把整数转换到参与运算的浮点类型,再进行计算,选 C。A 的转换方向相反;B、D 不涉及整型到浮点型这一方向的转换。
题目 058
展开题目 058(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 58 题(原站入口)。
通用高级语言通常提供描述数据、运算、控制和数据传输的成分。其中基本控制结构包括顺序、哪一项以及循环?
- A. 选择
- B. 递归
- C. 递推
- D. 函数
答案与解析
平台答案:A。
整理解析
结构化程序设计的三种基本控制结构是顺序、选择和循环。选择根据条件决定执行哪条分支,因此选 A。递归是一种调用与问题求解方式,不是这里缺少的控制结构名称。
题目 084
展开题目 084(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 84 题(原站入口)。
Python 中哪种结构可修改、保持序列顺序,并且允许元素重复?
- A. 元组(tuple)
- B. 字符串(str)
- C. 列表(list)
- D. 集合(set)
答案与解析
平台答案:C。
整理解析
列表支持按位置访问和修改,也允许重复元素,因此选 C;元组和字符串不可变,集合不保留重复元素,也不是序列。纠错:平台解析误把 B 的 str 讲成 dict;此外,Python 3.7 起字典保留插入顺序,不能再笼统称其无序,但它仍是映射而非列表式序列。
题目 085
展开题目 085(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 85 题(原站入口)。
在下列 Python 模块或库中,哪一项不提供深度学习模型的构建、训练功能?
- A. TensorFlow
- B. Matplotlib
- C. PyTorch
- D. Keras
答案与解析
平台答案:B。
整理解析
Matplotlib 的主要职责是数据绘图,不是模型构建和训练框架,选 B。其余三项提供深度学习模型相关能力。“不支持”按本题应理解为不直接承担建模训练;Matplotlib 仍可用于显示训练曲线和结果。
题目 087
展开题目 087(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 87 题(原站入口)。
Python 程序已定义 X=[1,2],表达式 X*2 得到什么?
- A.
[1,2,1,2] - B.
[1,1,2,2] - C.
[2,4] - D. 出错
答案与解析
平台答案:A。
整理解析
列表乘整数表示按原顺序重复序列两次,得到 [1,2,1,2],选 A,不是逐元素乘 2。该操作重复的是元素引用,并非对元素执行深复制;本题元素为整数,不影响上述结果。
来源补充(2022年上半年第21题)
原题代码 X=[1,2] 及A、B、C选项确实都使用全角逗号“,”,D为“出错”。Python按这段字面代码解析会产生SyntaxError,因此按原代码应选D;平台A对应把逗号当作排版问题、按通常列表语法理解的读法。原题标点与平台答案分别保留。列表重复仅重复元素引用,不是深复制。
题目 088
展开题目 088(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 88 题(原站入口)。
Python 中哪种结构不可变、有序且允许重复元素?
- A. tuple(元组)
- B. dict(字典)
- C. list(列表)
- D. set(集合)
答案与解析
平台答案:A。
整理解析
元组是不可变序列,保存顺序且允许重复,选 A。纠错:不可变指元组中的元素引用不能增删或替换,不代表变量名不能重新赋值,也不保证其中可变对象的内部内容不能变化。平台所称字典无序也已过时,Python 3.7 起保证其插入顺序。
题目 092
展开题目 092(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 92 题(原站入口)。
以下哪项不是 Python 3 中合法的异常处理写法?
- A.
try…except… - B.
try…except…finally - C.
try…catch… - D.
raise
答案与解析
平台答案:C。
整理解析
Python 使用 except 子句捕获异常,没有 try…catch 语法,因此选 C。raise 是合法的抛出或重新抛出异常的语句。题目把“异常处理结构”作了宽泛使用:raise 本身不是捕获异常的结构,但不是非法关键字或非法语法。
题目 093
展开题目 093(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 93 题(原站入口)。
在 Python 3 中,计算 list(range(11))[10:0:-2] 会得到哪项结果?
- A.
[10,8,6,4,2,0] - B.
[10,8,6,4,2] - C.
[0,2,4,6,8,10] - D.
[0,2,4,6,8)
答案与解析
平台答案:B。
整理解析
range(11) 给出 0~10;切片从索引 10 开始,每次减 2,并且不包含终止索引 0,所以结果为 [10,8,6,4,2],选 B。原题笔误(已核实):D 项原站确写 [0,2,4,6,8),方括号与全角圆括号不匹配;题面保留原写法,不默改成合法列表。这不影响按切片规则判断平台答案 B。
题目 094
展开题目 094(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 94 题(原站入口)。
Python 3 执行 x=input() 时,用户输入 123 并按回车。此后 x 的值是哪一项?
- A.
123 - B.
1,2,3 - C.
1 2 3 - D.
'123'
答案与解析
平台答案:D。
整理解析
input() 读取一行并返回去掉末尾换行符的字符串,不会自动把数字文本转换为整数。因此 x 是字符串 '123',选 D;若需要整数,还须显式调用 int。
三、函数调用:值、地址与引用
Python 函数定义头以冒号结束,函数体靠缩进表示;return a,b 返回一个元组,调用者可用两个变量解包,并不是返回两次。例如:
普通调用可以混用位置实参与关键字实参:前者依次匹配,后者按名字匹配,同一形参不能重复赋值,所以 summarize(3,a=6) 会报错。普通位置形参列表中,必需参数在前、带默认值的参数在后;默认值不表示该参数只能按关键字传入。关键字专用参数有不同规则,如 def f(*, a=1, b): ... 合法。讨论参数“按哪个名字匹配”与后面“复制值还是建立别名”属于两个问题。
运行时内存与栈帧
在常见 C/C++ 运行时模型中,按用途可把进程空间理解为以下几部分:
| 区域 | 主要内容 | 生命周期与管理方式 |
|---|---|---|
| 代码区 | 编译生成的指令 | 通常随程序映像装入 |
| 静态数据区 | 全局变量、静态局部变量等 | 存储期通常覆盖整个程序运行过程,初值可放初始化区或零初始化区 |
| 栈区 | 函数调用的活动记录,即栈帧 | 通常随调用建立、返回撤销,由编译生成的代码和运行时管理 |
| 堆区 | 在运行中按需创建的对象或数据 | C 可用 malloc/free,C++ 可用相应分配及释放机制;生命周期不必随某次调用结束 |
栈帧通常包含返回地址、保存的寄存器、形参和自动局部变量等调用状态,具体值也可能保存在寄存器或被优化掉。全局变量不属于每次调用各自建立的栈帧。递归调用的每一层通常有独立栈帧,所以同名局部变量不会自动变成同一个变量;返回时应恢复上一层现场。若甲调用乙、乙再调用丙,应先从丙返回乙,再从乙返回甲,这正是栈的后进先出顺序。
Java/Kotlin 中对象通常由运行时在堆上管理并由垃圾回收器回收,栈帧中的局部变量可能保存对象引用。引用变量所在的位置与它引用的对象所在的位置不同。 堆对象可能在创建它的函数返回后继续存活;反过来,不能在 C 函数返回后继续使用已结束生命周期的自动局部对象地址。此处描述逻辑模型,不要求所有实现的栈都向低地址增长,也不意味着操作系统为每一次调用直接分配栈帧。
先看形参究竟接收了什么
| 机制 | 形参的含义 | 给形参重新赋值 | 修改调用者数据的方式 |
|---|---|---|---|
| 按值传递 | 实参值的一份副本 | 只修改形参 | 若副本是指针或对象引用,可通过它访问同一个对象 |
| C 的指针参数 | 地址值的副本,仍是按值传递 | 不会改变调用者的指针变量 | 用 *p 修改有效地址指向的对象 |
| C++ 的非 const 左值引用参数 | 绑定到实参对象的别名 | 赋值作用于被引用对象 | 直接通过引用修改对象 |
| Java 的对象引用参数 | 引用值的副本,仍是按值传递 | 不会替换调用者变量中保存的引用 | 调用方法或修改字段可能改变共享对象 |
C 和 Java 都是按值传递。 “传地址”描述传入的值是地址,不等于语言具有真正的按引用参数机制。Java 的参数不能让被调用函数重新绑定调用者的局部变量。
普通 C 数组形参 void update(int a[], int n) 中,a[] 会调整为指针类型;传入数组名时,通常传的是首元素地址,仍按值复制这个指针。于是 a[0]=9 可修改调用方元素,但不会自动复制整个数组,也不能在函数内用 sizeof(a) 求实参数组长度,长度应另传。C++ 显式的数组引用接口另论。若函数既无返回值又无参数,可写声明 void work(void);,前一个 void 说明返回类型,括号里的 void 说明无参数,分号表示这里只作声明。
课件将“传址、引用、指针调用”放在一起,是为了比较修改是否能传回;做程序题仍须看具体语言及表达式。p = other 与 *p = value 不是同一个操作。
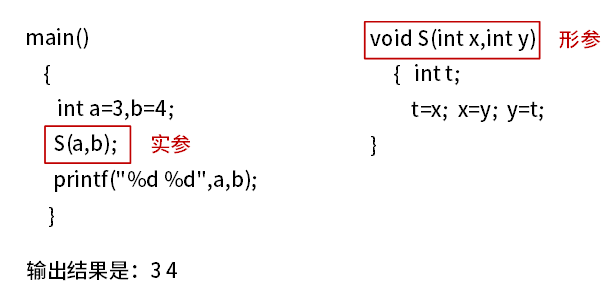
按值版本只交换局部副本,调用前 a=3,b=4,调用后仍输出 3 4。
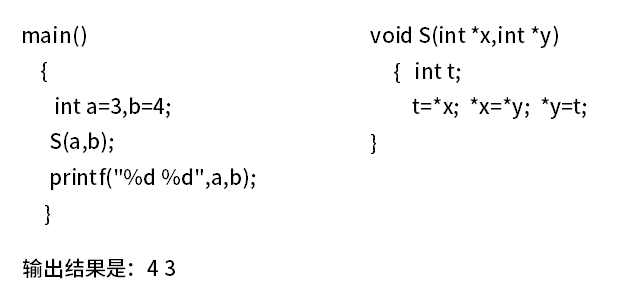
上图定义
S(int *x, int *y),调用却写成S(a,b)。按图中的int a=3,b=4,正确调用必须是S(&a,&b)。原图代码不能直接作为正确的 C 程序运行。
下面补全为可运行的 C 程序:
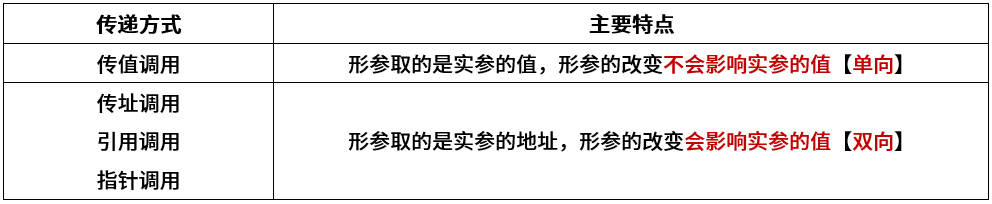
“传址实参不能是常量”也不能无限推广:C 的指针参数可以接收地址表达式;C++ 的 const T& 可以绑定临时对象,而非 const 左值引用一般不能。考试明确约定某参数为“传引用”时,按该约定追踪别名关系。
跟踪调用时,可以先给同名变量加上所属函数作为标签,再画出哪些是副本、哪些是别名。例如采用可写引用模型的 adjust(value, ref target) 先令 value=value+2,再令 target=target×value;若调用者执行 adjust(3,total) 且 total 原为 4,局部 value 变为 5,total 变为 20。若第二个参数也改为传值,乘法只改变副本,total 仍为 4。不要因为两个形参都来自同一个调用语句,就假定它们采用相同的传递方式。
例题 6:混合传值与传引用
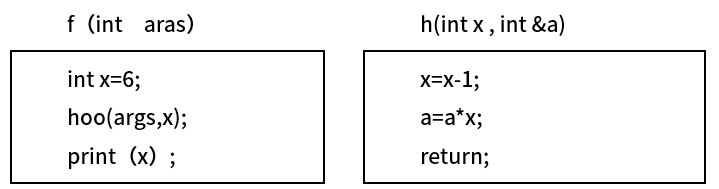
函数f()、h()定义如下,调用函数h()时,第一个参数采用传值(call by value)方式,第二个参数采用传引用(call by reference)方式。设有函数调用f(5),那么"print(x) "执行后输出的值为( )。
A、24
B、25
C、30
D、36
参考答案与解析
按题干指定的 f、h 调用关系,答案:A,24。 图中 f(int aras)、调用 hoo(args,x)、右侧函数 h(...) 命名不一致。依据题干,将其统一理解为 f(int args) 调用 h(args,x);若逐字当作源码,原图不能直接编译。
为避免两个 x 混淆,把 f 的局部变量记为 x_f,h 的值参数记为 x_h:
| 执行位置 | x_h(值副本) |
a(引用 x_f) |
x_f |
|---|---|---|---|
f(5) 初始化 |
尚未创建 | 尚未绑定 | 6 |
h(args, x_f) |
5 | 绑定到 x_f |
6 |
x_h = x_h - 1 |
4 | 仍绑定到 x_f |
6 |
a = a * x_h |
4 | 写入 6×4 |
24 |
| 返回 f 后输出 | 已结束 | 已结束 | 24 |
修正命名后的 C++ 等价程序如下,引用语法只用于第二个参数:
做题顺序:圈出每个实参 → 标出“副本/别名” → 分清同名局部变量 → 按语句更新。 不要看到“引用”就认为所有形参都与实参同步变化。
专项题库练习(15 题)
本小节对应题库练习共 15 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 002
来源:知识点练习「程序设计语言基础」第 2 题(原站入口)。
函数采用引用调用时,按题目的参数传递模型,向形参提供的是哪项内容?
- A. 把实参的值传给形参
- B. 把实参的地址传给形参
- C. 把形参的值传给实参
- D. 把形参的地址传给实参
答案与解析
平台答案:B。
整理解析
引用调用使形参关联到实参对象,修改该对象可反映到调用方;本题用“传递地址”描述这一机制,选 B。纠错:C 的参数一律按值传递,指针参数复制的是指针值;数组形参会调整为指针类型。这不等同于 C++ 的引用参数,不能把 C 的指针参数直接说成语言层面的引用传递。
题目 016
来源:知识点练习「程序设计语言基础」第 16 题(原站入口)。
在 C 程序通常的内存布局模型中,全局变量的存储空间位于哪一区域?
- A. 代码区
- B. 静态数据区
- C. 栈区
- D. 堆区
答案与解析
平台答案:B。
整理解析
全局变量具有静态存储期,通常存放在静态数据区,选 B;实现上可再分为保存初始化数据的区域和零初始化区域等。不是每次调用函数时在栈上创建,也不是通过堆分配。
题目 025
展开题目 025(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 25 题(原站入口)。
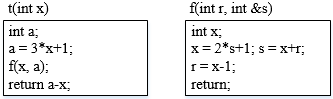
函数 t()、f() 的定义见图。调用 t 时 x = 5;t 内调用 f 时,第一个参数按值传递,第二个参数按引用传递。t() 最后返回什么值?
- A. 33
- B. 22
- C. 11
- D. 负数
答案与解析
平台答案:A。
整理解析
t 中先算得 a = 3×5+1 = 16。进入 f 时 r 为 5 的副本,s 引用 t 的 a;f 的局部 x = 2×16+1 = 33,随后 s = 33+5 = 38,使 a 变为 38。再把 r 改为 32 不影响 t 的 x,故返回 38−5 = 33,选 A。两个函数内的 x 是不同变量。
题目 028
展开题目 028(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 28 题(原站入口)。
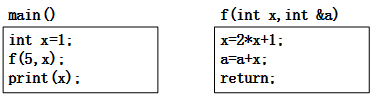
main() 与 f() 的定义见图。调用 f 时,第一个参数按值传递,第二个参数按引用传递。main() 执行 print(x) 后输出多少?
- A. 1
- B. 6
- C. 11
- D. 12
答案与解析
平台答案:D。
整理解析
main 的 x 初值为 1,调用 f(5,x) 后,f 的局部形参 x = 5,a 引用 main 的 x。先算局部 x = 2×5+1 = 11,再令 a = 1+11 = 12,于是 main 的 x 变成 12,选 D。
题目 031
展开题目 031(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 31 题(原站入口)。
函数参数常按值或按引用传递。以下关于这两种方式的说法,哪项正确?
- A. 按值传递时,形参与实参相互传值
- B. 按值传递时,实参不能是变量
- C. 按引用传递时,修改形参实际会修改所引用实参的值
- D. 按引用传递时,实参可以是任意变量和表达式
答案与解析
平台答案:C。
整理解析
在题目的可写引用模型中,形参是实参对象的别名,对该对象赋值也会改变调用方看到的值,选 C。按值传递允许变量实参,只复制其值。引用能绑定什么对象取决于语言和引用类型,不能笼统说任意表达式都行;若只是按值复制指针,改指针本身也不等同于改被指对象。
题目 039
展开题目 039(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 39 题(原站入口)。
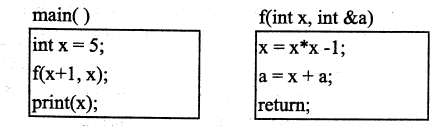
main()、f() 的定义见图。调用 f 时,第一个参数按值传递,第二个参数按引用传递。执行 main() 中的 print(x) 会得到哪个值?
- A. 11
- B. 40
- C. 45
- D. 70
答案与解析
平台答案:B。
整理解析
main 的 x 为 5,调用 f(x+1,x) 时,f 的局部 x 取得副本 6,a 则引用 main 的 x。函数内先算 x = 6×6−1 = 35,再算 a = 35+5 = 40,所以返回后打印 40,选 B。两个同名 x 不能当成同一变量。
题目 046
展开题目 046(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 46 题(原站入口)。
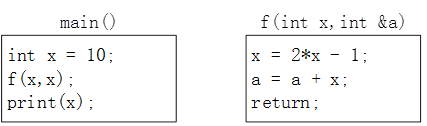
main() 与 f() 的定义见图。调用 f 时,第一个参数按值传递,第二个参数按引用传递。main() 执行完毕时输出多少?
- A. 10
- B. 19
- C. 20
- D. 29
答案与解析
平台答案:D。
整理解析
main 的 x 初值为 10,f(x,x) 的第一个形参取得副本 10,第二个形参 a 引用 main 的 x。函数内把局部 x 算成 2×10−1 = 19,再令 a = 10+19 = 29,于是 main 打印 29,选 D。
题目 057
展开题目 057(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 57 题(原站入口)。
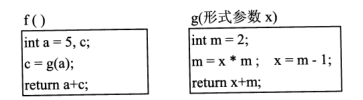
函数 f、g 的定义见图。f 执行到 g(a) 时采用引用调用,f 最终返回哪个值?
- A. 14
- B. 18
- C. 24
- D. 28
答案与解析
平台答案:D。
整理解析
f 的 a 初值为 5;g 的形参 x 引用它。g 中先算 m = 5×2 = 10,再令 x = 10−1 = 9,使 a 同时变为 9,g 返回 x+m = 19。于是 f 的 c = 19,返回 a+c = 9+19 = 28,选 D。
题目 063
展开题目 063(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 63 题(原站入口)。
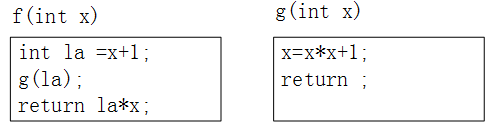
函数 f、g 见图,执行 y=f(2)。其中调用 g(la) 分别使用引用调用和值调用时,表达式完成后 y 的值依次是多少?
- A. 9、6
- B. 20、6
- C. 20、9
- D. 30、9
答案与解析
平台答案:B。
整理解析
f 的参数 x = 2,局部 la = x+1 = 3。按引用调用 g 时,g 将所引用对象更新为 3×3+1 = 10,f 返回 10×2 = 20;按值调用时只更新副本,la 仍为 3,f 返回 3×2 = 6,选 B。两种方式按题设分别代入,g 与 f 的同名 x 不能混为一体。
题目 069
展开题目 069(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 69 题(原站入口)。
程序发生嵌套函数调用或递归调用时,通常用哪种结构保存状态,以便按正确次序返回?
- A. 队列
- B. 优先队列
- C. 栈
- D. 散列表
答案与解析
平台答案:C。
整理解析
最后进入的调用要先返回,正好对应栈的后进先出特性,选 C。每层调用的返回位置和需要恢复的状态可随栈帧保存;优化可以省去部分帧,但不改变本题所考查的返回次序。
题目 070
展开题目 070(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 70 题(原站入口)。
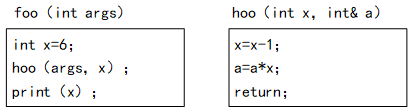
foo()、hoo() 的定义见图。hoo 的第一个参数按值传递,第二个参数按引用传递。调用 foo(5) 后,print(x) 输出多少?
- A. 24
- B. 25
- C. 30
- D. 36
答案与解析
平台答案:A。
整理解析
foo 的 args = 5、局部 x = 6;hoo(args,x) 的第一个形参取得副本 5,第二个形参 a 引用 foo 的 x。hoo 先将自己的 x 改为 4,再执行 a = 6×4 = 24,所以打印 24,选 A。纠错:平台把 foo 中的 x 称为全局变量,原图明确显示它是 foo 的局部变量。
题目 073
展开题目 073(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 73 题(原站入口)。
按常见程序运行时布局,内存分为静态数据区、代码区、栈区和堆区。第(73)空问哪个区域通常随函数调用与返回自动管理;第(74)空问哪个区域由程序按需要申请和释放。本题回答第(73)空。
- A. 静态数据区
- B. 代码区
- C. 栈区
- D. 堆区
答案与解析
平台答案:C。
整理解析
调用时建立、返回时撤销的活动记录通常放在栈区,选 C。纠错:具体栈帧的调整一般由编译生成的调用代码及运行时按约定完成,不是操作系统逐次分配每个函数帧;栈向低地址增长也只是常见实现,不是所有体系结构的必然规定。
题目 074
展开题目 074(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 74 题(原站入口)。
按常见程序运行时布局,内存分为静态数据区、代码区、栈区和堆区。第(73)空问哪个区域通常随函数调用与返回自动管理;第(74)空问哪个区域由程序按需要申请和释放。本题回答第(74)空。
- A. 静态数据区
- B. 代码区
- C. 栈区
- D. 堆区
答案与解析
平台答案:D。
整理解析
程序需要在运行中选择容量和生命周期的对象,通常从堆区申请空间,例如 C 的 malloc/free,选 D。题目采用显式分配释放的模型;垃圾回收语言可由运行时回收对象,堆的布局和增长方向也依实现而定。
题目 079
展开题目 079(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 79 题(原站入口)。
foo、hoo 的定义见图。调用 hoo(a,x) 时,第一个参数按引用传递,第二个参数按值传递。执行 foo(5) 后,按输出顺序会得到哪一组数?
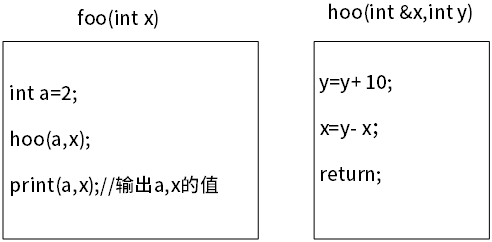
- A. 2,5
- B. 2,15
- C. 13,5
- D. 13,15
答案与解析
平台答案:C。
整理解析
foo 中 a = 2、x = 5;hoo 的形参 x 引用 a,形参 y 取得 5 的副本。先算 y = 15,再令所引用对象 x = 15−2 = 13,所以 foo 的 a 变为 13,而它自己的 x 仍为 5。输出 13,5,选 C。
题目 089
展开题目 089(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 89 题(原站入口)。
一次函数调用通常会在栈顶建立活动记录,即栈帧,用来保存执行该次调用所需的信息。以下哪项不属于该调用的栈帧内容?
- A. 形参变量
- B. 全局变量
- C. 返回地址
- D. 局部变量
答案与解析
平台答案:B。
整理解析
全局变量的生命周期不依附于某一次函数调用,通常放在独立的全局或静态存储区域,选 B。栈帧用于保存调用相关参数、局部状态和返回信息。表述修正:栈帧不专属于虚拟机,本机程序也使用;具体参数和局部量还可能分配在寄存器中。
四、编译过程与错误分类
从源文件到可执行程序:完整工具链
传统 C/C++ 工具链可分成 预处理 → 编译 → 汇编 → 链接。这是程序构建的外层流程;词法、语法、语义等则是其中编译器内部的阶段,不应把这两套层次混成一个顺序表。
| 环节 | 主要工作 | 产物或常见问题 |
|---|---|---|
| 预处理 | 展开宏、处理头文件包含与条件编译 | 预处理后的源代码;宏展开不等于函数调用 |
| 编译 | 分析高级语言、检查约束并翻译 | 传统模型生成汇编代码,也可能直接生成目标文件 |
| 汇编 | 把助记符等汇编表示转成机器代码 | 可重定位目标文件,外部符号可能尚未解析 |
| 链接 | 合并目标文件与库,解析跨模块符号,完成必要重定位 | 可执行程序或库;未定义引用、重复定义可能在此暴露 |
| 装入 | 把可执行映像及所需运行环境映射到内存 | 为开始执行做准备,不是把源代码再次编译 |
因此“某源文件编译成功”不保证最终链接成功,例如调用了仅有声明、链接时找不到定义的函数。实际工具可合并步骤而不输出中间文件;动态链接还可能把部分符号绑定留到装载或运行阶段。Android 的 NDK 构建会涉及本机工具链,Java/Kotlin 到 DEX、再由 ART 运行的路径则不同,不能套用所有文件后缀。
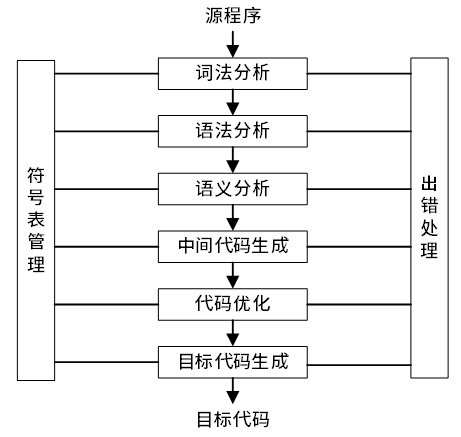
六个阶段与两个贯穿工作
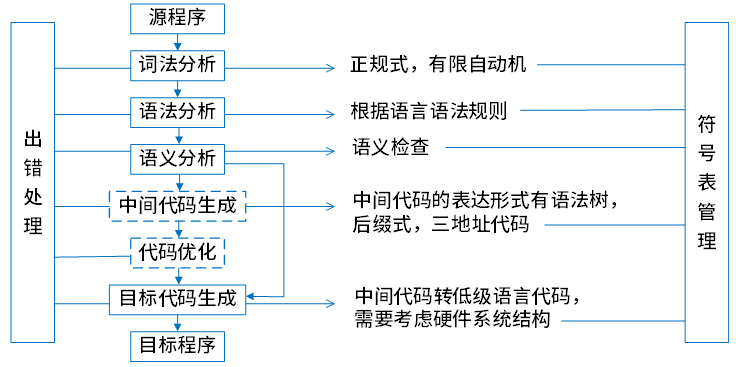
| 阶段 | 输入与工作 | 常见输出或检查 |
|---|---|---|
| 词法分析 | 扫描字符,识别单词符号 | 关键字、标识符、常量、运算符、分隔符组成的 Token 流 |
| 语法分析 | 按文法组织 Token | 语法结构或语法树,检查括号配对、缺操作数等 |
| 语义分析 | 检查名字、作用域、类型、参数等语言约束 | 注明类型等信息的结构,报告静态语义错误 |
| 中间代码生成 | 把程序转成便于分析的表示 | 三地址码、四元式、语法树、字节码等 |
| 代码优化 | 在保持规定语义的前提下变换程序 | 减少冗余或改善性能的代码 |
| 目标代码生成 | 按目标平台选指令、分配寄存器等 | 目标代码 |
符号表管理和错误处理会支持多个阶段。教材可以把阶段画成独立方框,但实现可以合并;中间代码生成和优化也不要求在每个编译器中都作为独立步骤存在。
词法分析:字符流变成记号流
以课件的 Pascal 风格片段为例,统一成半角标点:
记号序列可以写为:
共 17 个记号;:= 是一个赋值号,60 是一个整常数字面量。原文第 6 个记号误写成 Y,应为 Z。real 在具体语言中可能是预定义类型标识符,其分类以该语言词法规则为准,不能单凭名字认定为保留字。
语法与语义分析
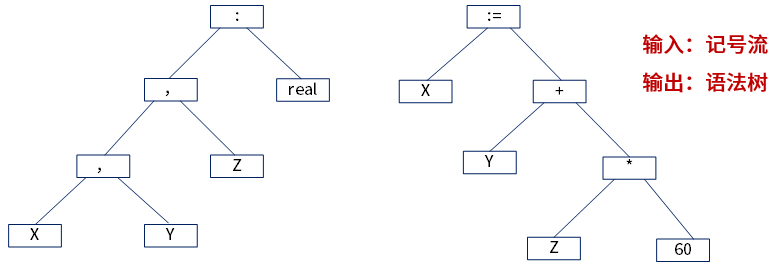
赋值右侧按乘法优先于加法组织为 Y + (Z * 60)。自顶向下方法从开始符号出发构造结构,包括递归下降、预测分析;自底向上方法从输入逐步归约,包括移进—归约方法。遇到“递归下降/预测”联想到自顶向下,遇到“移进/归约”联想到自底向上。
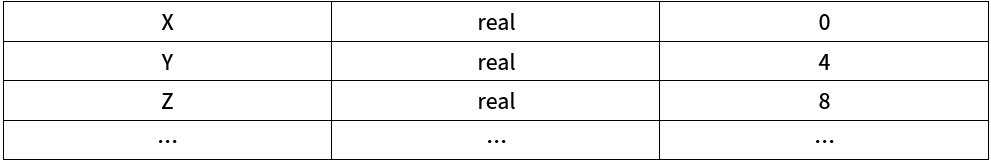
符号表可保存名字、类型、作用域、存储位置等。图中的 X、Y、Z 被示意为 real,偏移为 0、4、8;这是教学布局假设,不代表所有语言的实数都占 4 字节。
“运算符不支持操作数类型”属于静态语义检查的典型内容。例如 C 的 % 要求整数操作数,而 Python 的 % 可以用于浮点数等类型,不能把“浮点取余一定非法”作为跨语言规则。
自顶向下分析可理解为“按规则预测接下来该看到什么”:对 E→T+T,先建立 E,再调用识别 T 的过程、匹配 +、识别另一个 T。递归下降通常为非终结符写分析函数;递归的是分析器自身,而不是被分析程序的业务调用。
自底向上则从已读记号开始,把符合产生式右部的结构归约成左部。例如对 E→T+T、T→id,读入 id 后可归约成 T,读完两个 T 和中间的加号后再归约成 E。“移进”把输入符号加入分析栈,“归约”用较大的语法成分替代已识别部分。两类分析都可能从左向右读取文本,构树方向与读字符方向不是一回事。
语法制导翻译与符号表
语法制导翻译是在产生式上附加**属性和语义动作**,随语法结构的建立计算信息。例如产生式 E→E₁+T 可附加“检查两侧类型、确定 E 的类型、必要时插入整数到实数转换、发出加法代码”的动作。它把语法结构与类型检查或代码生成联系起来,不只是画语法树,也不只是某一种优化。
符号表记录名字对应的类型、作用域等属性,帮助动作判断这里的 x 指哪一个声明;哈希表或分层映射只是符号表的实现方式。若外层与函数内各声明一个 x,按词法作用域查找时应优先匹配当前可见的内层声明,不能把同名标识符都映射到同一个变量。
错误在何时发现
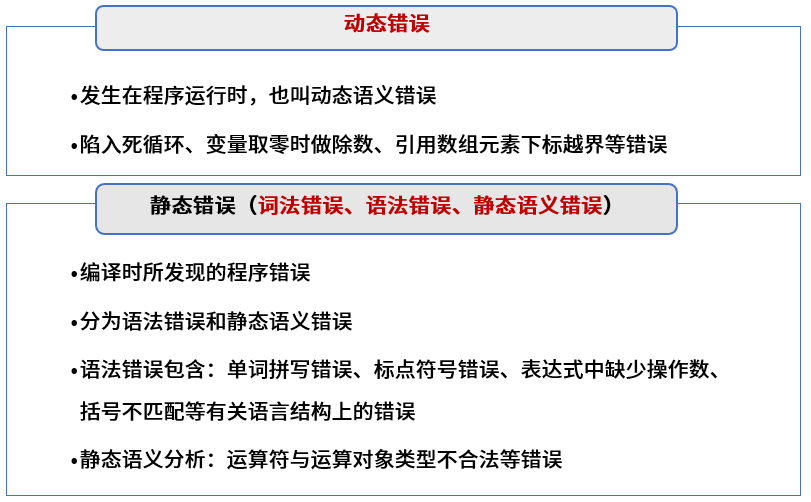
| 类别 | 示例与边界 |
|---|---|
| 词法错误 | 该语言不允许的字符、不完整字面量等;拼错名字若仍是合法标识符,不一定属于词法错误 |
| 语法错误 | 括号不配对、表达式缺操作数、必要分隔符缺失等 |
| 静态语义错误 | 名字未声明、类型不匹配、参数不符合声明等,具体以语言规则为准 |
| 运行时问题 | 某些除零、越界、非法访问;可能抛异常、终止或产生未定义行为 |
| 逻辑错误 | 程序运行但结果不符合需求;不一定自动报错 |
死循环不必然是错误,服务器事件循环可能有意长期运行。编译器也可能提前发现某些越界或除零,因此不能只凭问题名称断言它一定在运行时才被发现。
中间代码、四元式与类型转换
课件常见中间表示包括后缀式、语法树、三地址码、四元式。高层中间表示通常避免绑定具体机器,实际编译器也可能使用包含目标信息的低层中间表示。
四元式形式为 (运算符, 操作数1, 操作数2, 结果)。对于 X := Y + Z * 60,若 Y、Z 为实数,可用如下三地址表示:
对应的乘法四元式例如 (*, Z, t1, t2);赋值、一元转换的空操作数如何表示属于具体约定。
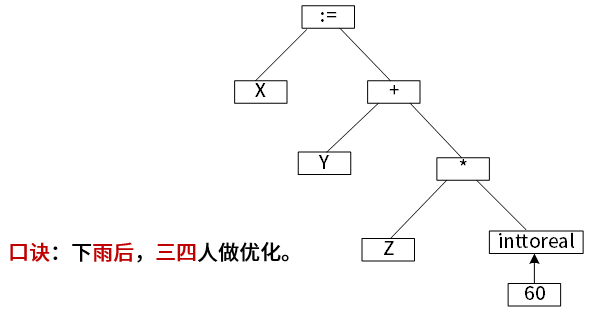
图中的 inttoreal 使整数常量参与实数运算;编译器还可能把常量转换提前完成。原图口诀“下雨后,三四人做优化”中的“三四”用于联想到三地址码、四元式,但理解输入输出比记口诀更可靠。
中间表示把程序计算关系与具体机器指令分开:同一套前端分析结果可以交给不同后端,多个源语言也可共享优化步骤和后端,因而有利于编译器移植。树、图、三地址码描述计算结构;栈、队列只是存放或处理数据的通用结构,不能把它们与符号表、程序中间表示的功能名称混为一谈。
目标代码生成除了选择机器指令,还要决定哪些活跃值放入有限的寄存器。寄存器不够时,有些值需暂存内存,称为溢出保存(spill),会增加访存;这就是寄存器分配与目标机器相关、属于编译器后端工作的原因。代码优化必须保持语言规定的行为,不能把所有除法、浮点运算或有副作用的调用任意重排。
例题 7:可选阶段与解释器执行
编译器和解释器是两种基本的高级语言处理程序。编译器对高级语言源程序的处理过程可以划分为词法分析、语法分析、语义分析、中间代码生成、代码优化、目标代码生成等阶段,其中( )并不是每个编译器都必需的,与编译器相比,解释器( )。
A、词法分析和语法分析
B、语义分析和中间代码生成
C、中间代码生成和代码优化
D、代码优化和目标代码生成
A、不参与运行控制,程序执行的速度慢
B、参与运行控制,程序执行的速度慢
C、参与运行控制,程序执行的速度快
D、不参与运行控制,程序执行的速度快
参考答案与解析
答案:第一空 C,第二空 B。 传统流程中,中间代码生成与代码优化可省略,语义分析后也可以直接生成目标代码。解释器参与程序的运行控制,在本题传统对比下执行开销较大。
这是教学模型下的阶段比较,不表示解释执行对所有任务都一定慢于所有编译实现。
例题 8:语法分析的输入与错误
将编译器的工作过程划分为词法分析、语义分析、中间代码生成、代码优化和目标代码生成时,语法分析阶段的输入是( )。若程序中的括号不配对,则会在( )阶段检查出该错误。
A、记号流
B、字符流
C、源程序
D、分析树
A、词法分析
B、语法分析
C、语义分析
D、目标代码生成
参考答案与解析
答案:第一空 A,第二空 B。 词法分析把字符流变成记号流,语法分析再接收记号流;括号不配对违反语法结构。
原题列举阶段时漏列“语法分析”,但后续问题明确询问该阶段。按标准编译流程判断,不将该漏项作为另一种编译过程。
例题 9:中间代码的形式
将高级语言源程序先转化为一种中间代码是现代编译器的常见处理方式。常用的中间代码有后缀式、( )、树等。
A、前缀码
B、三地址码
C、符号表
D、补码和移码
参考答案与解析
答案:B,三地址码。 符号表是保存符号信息的数据结构;补码、移码是数值编码,不是这里讨论的程序中间表示。
专项题库练习(25 题)
本小节对应题库练习共 25 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 003
来源:知识点练习「程序设计语言基础」第 3 题(原站入口)。
编译高级语言程序时,需要持续记录和查询源程序中符号的类型、属性等信息。这些信息应归入哪种表或结构?
- A. 符号表
- B. 哈希表
- C. 动态查找表
- D. 栈和队列
答案与解析
平台答案:A。
整理解析
符号表按标识符保存类型、作用域等属性,供名称解析、类型检查和代码生成使用,选 A。哈希表可以是符号表的实现方式,但本题问的是这份信息在编译器中的功能名称。
题目 006
来源:知识点练习「程序设计语言基础」第 6 题(原站入口)。
在 C/C++ 程序中,整型变量 a 的值为 0,程序使用表达式 c=b/a。下列哪种情况最可能发生?
- A. 编译时报告语法错误
- B. 编译时报告逻辑错误
- C. 运行时报告语法错误
- D. 运行时产生异常
答案与解析
平台答案:D。
整理解析
按本题将 b/a 视为整数除法的出题意图,除零通常在运行时表现为故障,平台选 D。纠错:C/C++ 的整数除零是未定义行为,不保证抛出可捕获异常;编译器若能推断除数为零,也可能提前诊断。题面只说明 a 为整型,未给出 b 的类型;若 b 为浮点数,就不能直接套用整数除零的结论。
题目 010
展开题目 010(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 10 题(原站入口)。
把高级语言源程序转换成机器语言时,编译器常使用中间代码。以下有关中间代码的说法,哪项不正确?
- A. 中间代码不依赖具体机器
- B. 使用中间代码有利于编译器移植
- C. 中间代码可用树或图表示
- D. 中间代码可用栈和队列表示
答案与解析
平台答案:D。
整理解析
按教材对中间表示形式的分类,树或图、三地址代码、后缀式等能明确表达计算关系;栈和队列是一般数据结构,不是本题列举的中间表示类别,故选 D。口径说明:这不等于中间代码不能存入栈或队列,也不排除基于栈的中间指令;机器无关性主要指这里讨论的高层中间表示。
题目 011
展开题目 011(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 11 题(原站入口)。
编译高级语言源程序时,把变量或临时结果分配到寄存器的工作通常归入哪个阶段?
- A. 词法分析
- B. 语法分析
- C. 语义分析
- D. 目标代码生成
答案与解析
平台答案:D。
整理解析
寄存器分配要考虑目标处理器可用的寄存器、活跃值及必要的内存溢出保存,属于编译器后端工作。在本题阶段划分中归入目标代码生成,选 D;实际编译器可将其实现为独立的后端处理步骤。
题目 017
展开题目 017(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 17 题(原站入口)。
高级语言的处理过程可划分为多个阶段。按传统纯解释执行模型,以下哪个阶段不包含在内?
- A. 词法分析
- B. 语法分析
- C. 语义分析
- D. 目标代码生成
答案与解析
平台答案:D。
整理解析
解释器仍需识别单词、语法结构并检查相应语义,然后直接执行或执行内部表示;它不必生成供之后独立执行的目标程序,因此选 D。这不排除先形成抽象语法树或字节码,也不适用于把解释与即时编译混合起来的所有实现。
题目 019
展开题目 019(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 19 题(原站入口)。
递归下降分析属于哪一类分析方法?
- A. 自底向上的语法分析
- B. 自上而下的语法分析
- C. 自底向上的词法分析
- D. 自上而下的词法分析
答案与解析
平台答案:B。
整理解析
递归下降从开始符号对应的过程出发,按产生式调用下级语法成分的分析过程,逐步匹配输入。它沿语法树从根向叶展开,属于自上而下的语法分析,选 B。
题目 020
展开题目 020(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 20 题(原站入口)。
编译器与解释器是高级语言的两类基本处理程序。图示编译流程包含词法分析、语法分析、语义分析、中间代码生成、代码优化和目标代码生成。第(20)空要选出并非所有编译器都必须具备的阶段;第(21)空比较解释器是否参与运行控制及通常的执行速度。本题回答第(20)空。
- A. 词法分析和语法分析
- B. 语义分析和中间代码生成
- C. 中间代码生成和代码优化
- D. 代码优化和目标代码生成
答案与解析
平台答案:C。
整理解析
简单编译器可以在分析源程序的过程中直接发出目标代码,不必先建立单独的中间代码层;为了得到正确程序,也不一定要进行优化。因此可省去的是中间代码生成和代码优化,选 C。图中的阶段是概念划分,实际实现还可融合多个阶段。
题目 021
展开题目 021(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 21 题(原站入口)。
编译器与解释器是高级语言的两类基本处理程序。图示编译流程包含词法分析、语法分析、语义分析、中间代码生成、代码优化和目标代码生成。第(20)空要选出并非所有编译器都必须具备的阶段;第(21)空比较解释器是否参与运行控制及通常的执行速度。本题回答第(21)空。
- A. 不参与运行控制,执行速度较慢
- B. 参与运行控制,执行速度较慢
- C. 参与运行控制,执行速度较快
- D. 不参与运行控制,执行速度较快
答案与解析
平台答案:B。
整理解析
纯解释执行时,由解释器读取程序表示并分派相应操作,因此它参与运行控制;与可比的直接执行目标代码相比,这通常增加运行开销,按教材模型选 B。纠错:解释执行并不在所有任务上都必然更慢,实际速度还受优化、运行库和即时编译等因素影响。
题目 023
展开题目 023(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 23 题(原站入口)。
程序执行后陷入死循环,可能属于以下哪一类错误?
- A. 词法错误
- B. 语法错误
- C. 动态语义错误
- D. 静态语义错误
答案与解析
平台答案:C。
整理解析
若程序本应结束,却因循环条件或变量更新逻辑而持续运行,这属于运行行为不符合预期,按本题分类选 C。纠错:不能仅以“编译器未发现”来定义动态语义错误;简单死循环可以静态识别,而任意程序是否终止一般不可判定。有意持续运行的事件循环也未必是错误。
题目 026
展开题目 026(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 26 题(原站入口)。
编译器或解释器用移进—归约法分析高级语言程序的语法。按语法结构的构建方向,这属于哪种分析方法?
- A. 自顶向下(自上而下)
- B. 自底向上(自下而上)
- C. 自左向右
- D. 自右向左
答案与解析
平台答案:B。
整理解析
先移进输入符号,再把已识别的产生式右部归约为左部非终结符,逐步构建较大的语法结构,属于自底向上,选 B。输入从左到右扫描与语法树从底向上构建是两种不同的方向描述。
题目 029
展开题目 029(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 29 题(原站入口)。
现代编译器常先把高级语言源程序转成中间代码。除后缀式和树之外,下列哪项也是常用的中间代码形式?
- A. 前缀码
- B. 三地址码
- C. 符号表
- D. 补码和移码
答案与解析
平台答案:B。
整理解析
三地址码把计算拆成如 t = x + y 的简单操作,便于分析、优化和生成目标代码,选 B。符号表保存名字属性;补码、移码用于数值编码。
题目 034
展开题目 034(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 34 题(原站入口)。
执行下面这段 C 代码,按题目的错误分类应归入哪一项?
- A. 变量未定义
- B. 静态语义错误
- C. 语法错误
- D. 动态语义错误
答案与解析
平台答案:D。
整理解析
for 后的分号构成空循环体,后面的 {k++;} 是循环外的语句。按逐语句执行模型,k 一直为 0,条件 k < 100 始终成立,不能到达自增语句,故属于运行逻辑问题,选 D;代码本身并无缺失分号等语法错误。标准限定:现代 C 对这类无可观察行为、条件非常量的循环允许终止假设,不能保证优化后一定持续空转。
题目 037
展开题目 037(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 37 题(原站入口)。
将编译过程分为若干阶段时,检查程序语句的形式是否符合规则,主要属于哪一阶段?
- A. 词法分析
- B. 语法分析
- C. 语义分析
- D. 代码生成
同题来源:知识点第 37、55 题。各来源的题干、原选项顺序和解析保留在下方折叠及来源记录中。
答案与解析
平台答案:B。
整理解析
语法分析把词法单元组合成表达式、语句等结构,并检查这种组合是否符合产生式,选 B。词法关注单词构成,语义关注这些结构的含义与约束。
同题来源:知识点第 55 题
平台答案(知识点第 55 题,原题选项):B。 本来源答案对应本页选项 B。
原题选项顺序保留如下;以下解析中的字母按该来源题目保留,并非改写原平台答案。
来源题干(复习摘要)
把编译器按阶段划分时,哪个阶段主要检查程序中句子的结构是否正确?
| 原题选项 | 原题选项内容 | 本页对应选项 |
|---|---|---|
| A | 词法分析 | A |
| B | 语法分析 | B |
| C | 语义分析 | C |
| D | 代码生成 | D |
整理解析(该来源)
语法分析按照产生式检查记号如何组合成表达式、语句等结构,选 B。词法分析识别单词,语义分析检查类型、声明等含义方面的约束。
题目 043
展开题目 043(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 43 题(原站入口)。
编译或解释高级语言程序时,可以先生成等价的中间代码。下列有关中间代码的描述,哪项正确?
- A. 中间代码通常用符号表表示
- B. 后缀式与三地址码是常用中间代码形式
- C. 中间代码优化必须依据执行机器的特性
- D. 中间代码不能跨平台
答案与解析
平台答案:B。
整理解析
后缀式和三地址码都可表达源程序的计算关系,因此选 B。符号表主要记录标识符属性;许多中间代码优化和表示可以独立于目标机器。限定:不是所有优化都完全不考虑机器,也不是每一种中间表示都天然可移植,不能把平台的概括推广到所有编译器层次。
题目 044
展开题目 044(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 44 题(原站入口)。
编译器进行语法分析时,主要判断哪一方面是否合法?
- A. 源程序中的标识符是否合法
- B. 语句的含义是否合法
- C. 语句的结构是否合法
- D. 表达式的类型是否合法
答案与解析
平台答案:C。
整理解析
语法分析检查词法单元是否按文法组成正确结构,例如括号、表达式和语句的组合,选 C。标识符的拼写规则通常由词法检查;名称是否声明、表达式类型是否匹配则属于语义检查。
题目 052
展开题目 052(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 52 题(原站入口)。
题面所称的“语法指导翻译”属于下列哪一类方法?
- A. 动态语义分析
- B. 中间代码优化
- C. 静态语义分析
- D. 目标代码优化
答案与解析
平台答案:C。
整理解析
通常称为语法制导翻译:把属性和语义动作附在产生式上,随语法分析计算类型等信息,进行静态检查或生成代码。在本题分类中选 C。它也能承担代码生成任务,并非只限于静态语义分析。
题目 059
展开题目 059(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 59 题(原站入口)。
编译 C/C++ 源程序时,哪个阶段主要负责检查各条语句的结构是否合法?
- A. 词法分析
- B. 语义分析
- C. 语法分析
- D. 目标代码生成
答案与解析
平台答案:C。
整理解析
语句由记号按文法规则组合,检查这种结构属于语法分析,选 C。语义分析进一步检查类型与名称使用等约束,不能与结构检查混淆。
题目 060
展开题目 060(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 60 题(原站入口)。
编译或解释高级语言程序时,要保存并查询源程序中符号的类型、特征等属性。这些信息应放在哪种结构中?
- A. 哈希表
- B. 符号表
- C. 堆栈
- D. 队列
答案与解析
平台答案:B。
整理解析
按用途,这份名称及属性信息称为符号表,选 B。哈希表可用来加速符号表查找,但只是实现方式;栈和队列也不对应本题所问的编译器信息表名称。
题目 061
展开题目 061(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 61 题(原站入口)。
在分阶段的编译器中,检查源程序字符及其按构造规则组成的符号是否符合语言规定,主要由哪个阶段负责?
- A. 词法分析
- B. 语法分析
- C. 语义分析
- D. 代码生成
答案与解析
平台答案:A。
整理解析
词法分析把字符序列识别为标识符、关键字、常量、运算符等记号,并检查其构成,选 A。后续语法分析才检查这些记号的组合结构。
题目 064
展开题目 064(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 64 题(原站入口)。
把编译过程分为词法分析、语法分析、语义分析、中间代码生成、代码优化、目标代码生成。第(64)空问语法分析的输入是什么;第(65)空问程序括号不配对通常在哪一阶段被发现。本题回答第(64)空。
- A. 记号流
- B. 字符流
- C. 源程序
- D. 分析树
答案与解析
平台答案:A。
整理解析
词法分析把源程序的字符流切分为记号流,语法分析再据此构建结构,所以输入是记号流,选 A。纠错:这里的“字符流”就是词法分析所接收的字符序列,无须转而用 Java 的字符 I/O 类解释,也不能说它与编译过程无关。
题目 065
展开题目 065(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 65 题(原站入口)。
把编译过程分为词法分析、语法分析、语义分析、中间代码生成、代码优化、目标代码生成。第(64)空问语法分析的输入是什么;第(65)空问程序括号不配对通常在哪一阶段被发现。本题回答第(65)空。
- A. 词法分析
- B. 语法分析
- C. 语义分析
- D. 目标代码生成
答案与解析
平台答案:B。
整理解析
单个左、右括号都可能是合法记号,但它们是否配对属于结构约束,通常由语法分析检查,选 B。这个判断与第(64)空的“语法分析输入是记号流”是同一材料的不同问题。
题目 068
展开题目 068(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 68 题(原站入口)。
用 C/C++ 编写的应用程序,按常见工具链应依次经过哪些处理才形成可执行程序?
- A. 预处理→编译→汇编→链接
- B. 编译→预处理→汇编→链接
- C. 汇编→预处理→链接→编译
- D. 链接→预处理→编译→汇编
答案与解析
平台答案:A。
整理解析
先处理宏和头文件等预处理内容,再编译为汇编表示,汇编成目标文件,最后链接目标文件与库,选 A。实际工具链可把多个步骤合并执行,不一定把所有中间文件保存到磁盘。
题目 077
展开题目 077(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 77 题(原站入口)。
对 C/C++ 源程序进行编译时,类型检查属于以下哪个阶段?
- A. 词法分析
- B. 语义分析
- C. 语法分析
- D. 目标代码生成
答案与解析
平台答案:B。
整理解析
类型检查要判断操作数、运算符、赋值和函数参数是否符合类型约束,属于静态语义分析,选 B。纠错:平台把目标代码生成标成“执行阶段”是错误的;生成目标代码仍在编译过程中,运行时行为不能一概归入该阶段检查。
题目 081
展开题目 081(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 81 题(原站入口)。
编译高级语言源程序时,哪种表负责保存各符号的必要属性,以支持语义检查和代码生成?
- A. 决策表
- B. 符号表
- C. 广义表
- D. 索引表
答案与解析
平台答案:B。
整理解析
符号表把名字与类型、作用域、存储位置等信息关联起来,语义检查和后端生成代码都可以查询它,选 B。这里按表在编译器中的用途命名。
题目 091
展开题目 091(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 91 题(原站入口)。
在编译或解释高级语言程序所需的语法分析中,递归子程序分析法属于哪种方向的分析?
- A. 自上而下
- B. 自下而上
- C. 从左至右
- D. 从右至左
答案与解析
平台答案:A。
整理解析
递归子程序法为非终结符编写分析过程,从文法开始符号逐层展开产生式,属于自上而下,选 A。纠错:这里的子程序是语法分析器自身的函数,不是沿待编译程序的 main 和业务函数调用链执行;也不能只凭“递归”二字推断任意算法的分析方向。
五、文法、推导与句子
文法四元组先看符号约定
本笔记采用 G = (V_N, V_T, P, S):
V_N:非终结符的有限集合,例如{S,A}。V_T:终结符的有限集合,例如{a,b},且V_N ∩ V_T = ∅。P:产生式的有限集合。S ∈ V_N:开始符号。
四元组的分量顺序在不同教材中可能不同,关键是声明与使用一致。原文先定义 G=(V,T,S,P),又举 G=({a,b},{S,A},S,P),在自己的约定下把终结符与非终结符集合写反了。按其前文约定应为 G=({S,A},{a,b},S,P);按本笔记约定则为 G=({S,A},{a,b},P,S)。
产生式 α → β 表示把可匹配的左部替换为右部;右部可以含非终结符,不是每次都立即“用终结符替换非终结符”。从开始符号推导出的符号串称为句型;只含终结符的句型才是句子。
| 文法 | 关键限制或用途 | 对应自动机 |
|---|---|---|
| 0 型,无限制文法 | 表达能力最一般;识别过程对不属于语言的输入未必停机 | 图灵机 |
| 1 型,上下文有关文法 | 通常按非收缩产生式定义,空串有约定性例外 | 线性有界自动机 |
| 2 型,上下文无关文法 | 左部为单个非终结符,常用于程序语法 | 非确定性下推自动机 |
| 3 型,正规文法 | 一致使用右线性或左线性形式,常用于词法 | 有限自动机 |
此表对应章节回顾中的“文法分类与自动机”,不要求由几个例子推断任意文法的类型。
幂、正闭包与克林闭包
把 A 看作字符串集合:A⁰={ε};A¹=A;A² 为从 A 选两串进行连接得到的集合,依此类推。
- 正闭包
A⁺ = A¹ ∪ A² ∪ A³ ∪ …:选择 A 中的串连接一次或多次。 - 克林闭包
A* = A⁰ ∪ A⁺:允许连接零次,因此一定包含空串ε。
例如 {a}*={ε,a,aa,aaa,…};{ab}*={ε,ab,abab,…}。口诀“加 1,星 0”记的是最少重复次数,没有有限的最大次数。还需注意:若 A 本身含 ε,那么 A⁺ 也含 ε,不能笼统说“正闭包一定没有空串”。
从产生式判断能生成什么
判断某串是否属于文法的语言,先检查终结符和可用运算,再构造推导;平常数学合法的表达式,未必被题给文法允许。一元负号规则 F→-F 只允许给 F 加前缀,不会凭空提供二元减法;没有括号、除号或数字常量的产生式,就不能在推导中自行加入。
对于递归规则,可先看每轮增加了什么。例如 S→abS|baS|ab|ba 每递归一次都增加一个 ab 或 ba 块,终止时也得到其中一块,因此语言恰为 (ab|ba)⁺。所有生成串的 a、b 数量相同,但 aabb 不能分成这些二字符块,说明“数量相同”只是必要条件,不等于完整语言描述。题目中的“所有”和“某些”需要这样验证。
最左推导每次展开当前最左非终结符,最右推导每次展开最右非终结符;推导树记录产生式的父子关系,叶子从左到右组成句型。是否已成为句子取决于叶子有没有剩余非终结符,不取决于做了多少步。
语法树的结合方向由题给产生式决定。 例如令 N 生成单个数字:E→E-N|N 把 9-4-1 组织成 (9-4)-1=4;改成 E→N-E|N,则依次展开为 N-E⇒N-N-E⇒N-N-N,右边的 E 嵌在上一层右子树中,结构是 9-(4-1)=6。这里括号用于说明树形,不是额外加入的产生式。乘法即使在数学上可结合,两棵不同形状的语法树也不能互换;不能用日常默认的左结合替代题给的右递归文法。
原例:推导句型 aabAa
产生式:
原题要求构造句型 aabAa 的推导树。
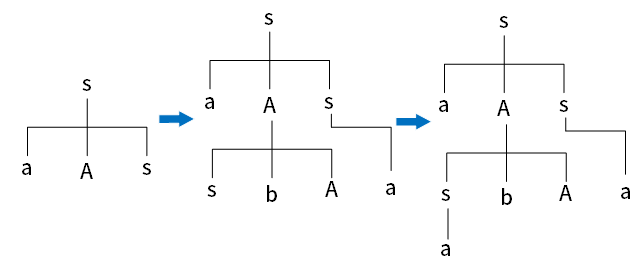
参考推导与说明
一条推导是(最后一步展开右侧的 S,因此不是最左推导):
依次使用 S→aAS、A→SbA、内部 S→a、末尾 S→a。图中标成小写 s 的节点按产生式中的大写 S 理解。
从最终树的叶子由左到右读到 a a b A a。其中还有非终结符 A,所以它是**句型,不是句子**;题目并不要求继续把 A 展开。
例题 10:哪些表达式能由文法生成
简单算术表达式的结构可以用下面的上下文无关文法进行描述(E为开始符号),( )是符合该文法的句子。
E→T|E+T
T→F|T*F
F→-F|N
N→0|1|2|3l4|5|6|7|8|9
A、2--3*4
B、2+-3*4
C、(2+3)*4
D、2*4-3
参考答案与解析
答案:B,2+-3*4。 原题 N 的规则中 3l4 是排版笔误,按数字备选理解为 3|4。题目文法没有括号规则,也没有二元减法,但允许 F→-F 表示一元负号。
B 的一条推导为:
A、D 都需要文法没有定义的二元减法;C 需要 F→(E) 一类括号规则,但本题没有。判断的是**本题文法能否生成**,不能用日常数学中“看起来合法”代替推导。
专项题库练习(7 题)
本小节对应题库练习共 7 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 005
来源:知识点练习「程序设计语言基础」第 5 题(原站入口)。
描述大多数程序设计语言的语法结构,通常使用下列哪类文法就足够?
- A. 正规文法
- B. 上下文无关文法
- C. 上下文有关文法
- D. 短语结构文法
同题来源:知识点第 5、13、33 题。各来源的题干、原选项顺序和解析保留在下方折叠及来源记录中。
答案与解析
平台答案:B。
整理解析
表达式嵌套、语句组合等递归结构适合用上下文无关产生式表达,因此选 B。正规文法通常用于词法模式;声明是否存在、类型是否相容等约束还需语义检查,不能把全部语言规则都归为上下文无关语法。
同题来源:知识点第 13 题
平台答案(知识点第 13 题,原题选项):B。 本来源答案对应本页选项 B。
原题选项顺序保留如下;以下解析中的字母按该来源题目保留,并非改写原平台答案。
来源题干(复习摘要)
为大多数通用程序设计语言描述语法时,通常选用哪类文法?
| 原题选项 | 原题选项内容 | 本页对应选项 |
|---|---|---|
| A | 正规文法 | A |
| B | 上下文无关文法 | B |
| C | 上下文有关文法 | C |
| D | 短语结构文法 | D |
整理解析(该来源)
语法分析需要刻画表达式、语句和括号等递归嵌套关系,上下文无关文法能够描述这些主要结构,选 B。这里说的是语法骨架;名称绑定和类型等规则仍需另行检查。
同题来源:知识点第 33 题
平台答案(知识点第 33 题,原题选项):B。 本来源答案对应本页选项 B。
原题选项顺序保留如下;以下解析中的字母按该来源题目保留,并非改写原平台答案。
来源题干(复习摘要)
乔姆斯基把文法分为 4 种类型,其中哪一种能够描述程序设计语言的大多数语法现象?
| 原题选项 | 原题选项内容 | 本页对应选项 |
|---|---|---|
| A | 上下文有关文法 | C |
| B | 上下文无关文法 | B |
| C | 正规文法 | A |
| D | 短语结构文法 | D |
整理解析(该来源)
上下文无关文法通过递归产生式刻画表达式、语句、嵌套块等结构,对应乔姆斯基层次中的 2 型,选 B。词法模式通常较简单,可用正规文法;类型相容等要求则不只靠语法产生式处理。
题目 007
来源:知识点练习「程序设计语言基础」第 7 题(原站入口)。
文法 G 的开始符号为 S,产生式为 S → A0 | B1、A → S1 | 1、B → S0 | 0。从 S 出发,能够生成的字符串符合下列哪项描述?
- A. 所有仅由 0 组成的字符串
- B. 所有仅由 1 组成的字符串
- C. 某些 0 和 1 数量相同的字符串
- D. 所有 0 和 1 数量不相同的字符串
答案与解析
平台答案:C。
整理解析
消去 A、B 后可写为 S → S10 | 10 | S01 | 01,因此生成的串恰为一个或多个 10、01 块的连接,即 (10|01)+。每块各含一个 0 和一个 1,所以总数相等;但 0011 等等量字符串不能生成,故是“某些”,选 C。
题目 040
来源:知识点练习「程序设计语言基础」第 40 题(原站入口)。
下图是一棵表达式语法树。按后缀形式写出该表达式,应选择哪项?
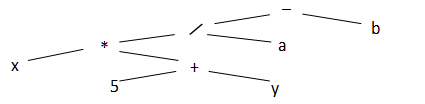
- A.
x 5 y + * a / b - - B.
x 5 y a b * + / - - C.
- / * + x 5 y a b - D.
x 5 + * y + a / b -
答案与解析
平台答案:A。
整理解析
对树按左子树、右子树、根的顺序遍历:先把 5+y 写成 5 y +,与 x 相乘得到 x 5 y + *,再依次除以 a、减去 b,形成 x 5 y + * a / b -,选 A。对应的中缀式为 x*(5+y)/a-b。
题目 049
来源:知识点练习「程序设计语言基础」第 49 题(原站入口)。
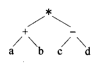
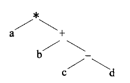
后缀表达式为 a b c - + d *,其中 -、+、* 都是二元运算,分别表示减、加、乘。下列哪棵语法树与它等价?
- A.
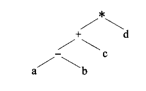
- B.
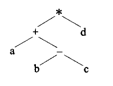
- C.
- D.
答案与解析
平台答案:B。
整理解析
读到减号先合并 b、c 为 b−c,再由加号把 a 与该结果相加,最后乘以 d。因此根为乘号,左子树是 a+(b−c),右子树是 d,对应 B。按原图,其余选项的后序序列分别为 A:a b - c + d *,C:a b + c d - *,D:a b c d - + *。
题目 051
来源:知识点练习「程序设计语言基础」第 51 题(原站入口)。
用下列上下文无关文法描述简单算术表达式,E 为开始符号。哪个选项可以成为该文法的句子?
- A.
2--3*4 - B.
2+-3*4 - C.
(2+3)*4 - D.
2*4-3
答案与解析
平台答案:B。
整理解析
平台答案保留为 B。原题笔误(已核实):原站确写 N→0|1|2|3l4|5|6|7|8|9,其中是小写字母 l,不是分隔符 |;题干保留原写法。严格按这份文法,N 不能单独产生 3、4,四个选项均不成立。只有按命题意图将 3l4 修正为 3|4,B 的 2+-3*4 才可由加法、一元负号和乘法规则推出;A、D 需要文法没有的二元减法,C 需要没有的括号。这是对原题笔误的解释,不能把平台答案 B 当成原文法无误的结论。平台原解析的推导还混入了多余负号。
题目 067
来源:知识点练习「程序设计语言基础」第 67 题(原站入口)。
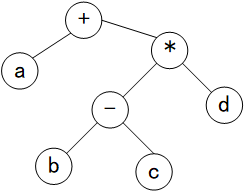
根据下图的表达式语法树,选择其后缀式(逆波兰式)。
- A.
abcd-+* - B.
ab-c+d* - C.
abc-d*+ - D.
ab-cd+*
答案与解析
平台答案:C。
整理解析
根是加号,左子树只有 a;右子树先做 b−c,再乘 d。后序遍历依次得到 a b c - d * +,对应 C,表达式为 a+(b-c)*d。
题目 071
来源:知识点练习「程序设计语言基础」第 71 题(原站入口)。
下面的上下文无关文法描述算术表达式,其中 +、-、* 分别是加、减、乘,id 仅表示由单个字母命名的变量。哪个表达式可由文法产生?
- A.
a+-b-c - B.
a*(b+c) - C.
a*-b+2 - D.
-a/b+c
答案与解析
平台答案:A。
整理解析
一元负号允许 -b,E 的加减规则允许把 a、-b、c 依次组成 a+-b-c,因此选 A。文法不含括号、除号或数字常量,分别排除 B、D、C。纠错:平台称乘法推导必先经过 E+T 或 E−T 并不成立,也可直接 E→T→T*F;C 的关键问题是常量 2 无法由 id 产生。
六、正规式与正规集
正规式是表达方式,正规集是它表示的语言
设 Σ 为有限字母表,用 L(r) 表示正规式 r 对应的字符串集合。基本定义如下:
| 正规式 | 表示的集合 |
|---|---|
∅ |
空集:L(∅)=∅,没有任何串 |
ε |
L(ε)={ε},恰好包含一个串,即空串 |
a,其中 a∈Σ |
L(a)={a} |
r\|s |
L(r)∪L(s),选择其一 |
rs 或 r·s |
L(r)L(s),先取左边的串再连接右边的串 |
r* |
(L(r))*,重复零次或多次 |
(r) |
与 r 相同,括号指定结合范围 |
原文“若 r 和 s 分别表示正规集 L(r)=L(s)”误加了等号,应理解为“分别表示 L(r) 和 L(s)”,不要求两集合相等。另外原定义漏列了空集正规式 ∅;∅ 与 ε 必须区分。
例如 L(∅*)={ε},因为重复零次得到空串;但 ∅{a}=∅,因为无法从空集中取出左边的串。优先级是 闭包 * > 连接 > 选择 |。
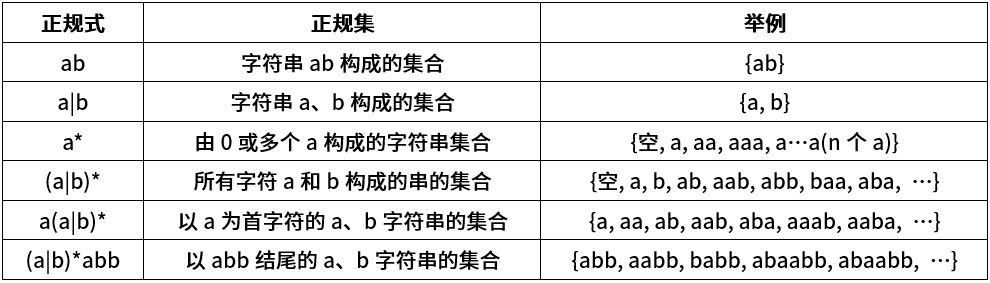
| 表达式 | 可接受的串 |
|---|---|
ab |
只有 ab |
a\|b |
a 或 b |
a* |
ε、a、aa、aaa、… |
(a\|b)* |
a、b 构成的任意有限串,包括空串 |
a(a\|b)* |
以 a 开头的串 |
(a\|b)*abb |
以 abb 结尾的串 |
这里是形式语言中的正规式;实际编程语言的正则引擎若含反向引用等扩展,能力和语法可能不同。
分析正规式可按“选择的分支、连接的顺序、重复的范围”拆开。比如 (01)* 只能重复整个 01 块,而 0*1* 先取若干个 0 再取若干个 1;两者都接受空串,但 0011 只属于后者,0101 只属于前者。检验候选时还要尝试空串、单字符、多个片段连接和不满足约束的最短反例。
从状态图概括语言时,先找必须经过的路径,再识别可重复回路;回路可以读一个字符,也可以读整段字符。证明等价要同时说明“表达式产生的串都能走通”和“所有接受路径都能由表达式描述”,几组样例相同不足以证明。
例题 11:每个 a 后至少跟一个 b
由字符a、b构成的字符串中,若每个a后至少跟一个b,则该字符串集合可用正规式表示为( )。
A、(b|ab)*
B、(ab*)*
C、(a*b*)*
D、(a|b)*
参考答案与解析
答案:A,(b|ab)*。 按通常题意,“每个 a 后至少跟一个 b”指 a 后面必须紧接 b。可以把合法串从左到右分解为 b 或 ab 两类片段;多余的 b 由单独的 b 片段补上。
B 中 b* 允许零个 b,因此它接受非法串 a;C、D 也接受 a,可立即排除。A 允许空串,因为空串没有 a,自然不违反条件。
技巧:先找最短反例。 一个候选正规式接受了不符合条件的串,就不可能是答案;筛选后再检查它能覆盖全部合法串。
专项题库练习(4 题)
本小节对应题库练习共 4 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 032
来源:知识点练习「程序设计语言基础」第 32 题(原站入口)。
字符串只含 a、b,并要求每个 a 后面紧接至少一个 b。下列哪个正规式恰好描述这个集合?
- A.
(b|ab)* - B.
(ab*)* - C.
(a*b*)* - D.
(a|b)*
答案与解析
平台答案:A。
整理解析
把每个 a 与其后紧接的一个 b 配成 ab,其余 b 单独成块,合法串正好由 b 或 ab 反复连接,故选 A。B、C 中的 b* 可以取零次,D 也允许单独的 a,均会接受不合要求的串。题目未要求非空,空串也满足约束。
题目 036
来源:知识点练习「程序设计语言基础」第 36 题(原站入口)。
在仅由 a、b 构成的字符串中,要表示全部以 b 结尾的字符串,应使用哪个正规式?
- A.
(b|ab)*b - B.
(ab*)*b - C.
a*b*b - D.
(a|b)*b
答案与解析
平台答案:D。
整理解析
前缀可以是任意 a、b 串,包括空串;末尾再接一个 b,所以是 (a|b)*b,选 D。A 漏掉 aab,B 漏掉 bab,C 漏掉 abab,都不能覆盖全部以 b 结尾的串。整个表达式不接受空串,但接受单独的 b。
题目 050
来源:知识点练习「程序设计语言基础」第 50 题(原站入口)。
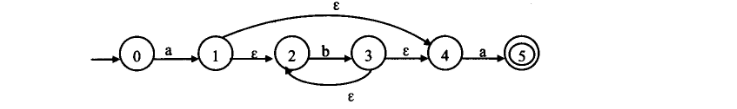
下图给出了带空串转移的不确定有限自动机 NFA。它接受的字符串集合对应哪个正规式?
- A.
ab*a - B.
(ab)*a - C.
a*ba - D.
a(ba)*
答案与解析
平台答案:A。
整理解析
从初态 0 到 1 必须读 a。随后可经 ε 直接到 4,或先进入 2,经读 b 到 3、再由 ε 回 2 的回路重复任意次,最后通过 ε 到 4。到终态 5 还必须读一个 a,因此恰为 a 后接零个或多个 b 再接 a,即 ab*a,选 A;最短接受串为 aa。
题目 075
来源:知识点练习「程序设计语言基础」第 75 题(原站入口)。
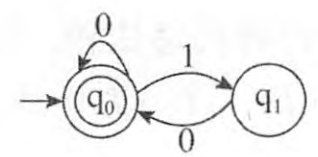
根据下图的状态转换,哪个正规式与该有限自动机等价?
- A.
(0|1)* - B.
(0|10)* - C.
0*(10)* - D.
0*(1|0)*
答案与解析
平台答案:B。
整理解析
q0 是初态和接受态,读一个 0 可原地返回,读 10 可经 q1 返回。接受串就是 0、10 这两种块按任意顺序连接,选 B。星号表示零次或任意有限次重复,包含空串,并不是无限长串。A、D 还接受单独的 1;C 不能表示 100。
七、有限自动机:按实际边逐个读字符
DFA 与 NFA
DFA 可写为 M=(Q,Σ,δ,q₀,F):Q 是有限状态集合,Σ 是有限字母表,q₀∈Q 是唯一初态,F⊆Q 是接受状态集合,δ:Q×Σ→Q 是转换函数。课件使用的 (S,Σ,δ,S0,Z) 只是另一组符号。
完整 DFA 对每个“状态+输入符号”都有且只有一个后继。教材图若省略不接受的转换,可视为隐含一个非接受的死状态:缺失边进入死状态,死状态在所有字符上回到自身。
NFA 对同一输入可以有多个候选后继,也可以没有后继;允许 ε 转换的定义还能不消耗输入换状态。DFA 与 NFA 的识别能力相同,都对应正规语言。
接受条件是读完整个输入后处于接受状态。 NFA 只要存在一条读完整串且结束于接受状态的路径即可。中途到过接受状态不够;接受状态也不是必须“永远停留”的吸收状态。
ε 闭包与子集构造:怎样把 NFA 变成 DFA
NFA 读完同一段输入后可能位于多个状态,DFA 可以把这个**状态集合当作一个新状态**。ε 闭包 E(X) 是从集合 X 出发,经零条或多条 ε 边可到达的全部状态,包含 X 本身;ε 不消耗输入字符。
- 新 DFA 的初态为
E({原初态})。 - 对当前集合 X 和一个输入字符 a,从 X 中每个状态沿 a 边取后继,并集记为
move(X,a),再取E(move(X,a))。 - 每个新集合各建一个状态,反复计算,直到没有新集合;空集合可作为拒绝死状态。
- 新状态只要包含至少一个原接受状态,就标为接受状态,无须集合中每个状态都接受。
补充例:原 NFA 初态 p、接受态 r,只有 p —ε→ q、q —a→ q、q —b→ r 三种边。字母表为 {a,b},子集构造得到:
| DFA 状态(NFA 状态集合) | 读 a 后 | 读 b 后 | 接受? |
|---|---|---|---|
| A={p,q},初态 | B | C | 否 |
| B={q} | B | C | 否 |
| C={r} | D | D | 是 |
| D=∅ | D | D | 否 |
例如 aab 依次经过 A、B、B、C,被接受;ba 经过 A、C、D,虽中途到 C,读完后仍拒绝。这份表识别 a*b;A 与 B 之后的接受行为相同,还可以在 DFA 最小化时合并,但子集构造本身不要求直接得到最少状态数。
原例与思考:S 到 f 的自动机
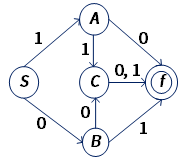
依照原图和正文,转换为:
| 状态 | 输入 0 | 输入 1 |
|---|---|---|
| S | B | A |
| A | f | C |
| B | C | f |
| C | f | f |
| f | 死状态 | 死状态 |
| 死状态 | 死状态 | 死状态 |
唯一初态为 S,唯一接受状态为 f。C→f 上的 0,1 表示两个不同输入都去 f,不是同一输入有两个后继。
原思考:以该图为例,哪些是能够被有限自动机识别的串?该有限自动机是确定的还是不确定的?
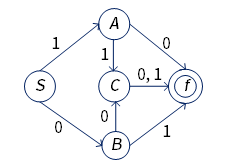
参考答案与路径
按缺失边隐含死状态的约定,它是 DFA。 被接受的串恰为 {01,10,000,001,110,111}。
| 串 | 从 S 开始的路径 |
|---|---|
01 |
S → B → f |
10 |
S → A → f |
000 |
S → B → C → f |
001 |
S → B → C → f |
110 |
S → A → C → f |
111 |
S → A → C → f |
例如 010 在前两位后到达 f,但还有一位 0,随后进入死状态,因此不接受。等价正规式为 01|10|(00|11)(0|1)。
例题 12:逐条检验候选串
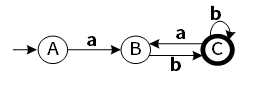
某确定的有限自动机(DFA)的状态转换图如下图所示(A是初态,C是终态),则该DFA能识别( )。
A、aabb
B、abab
C、baba
D、abba
参考答案与解析
答案:B,abab。 依据图中的箭头:A --a→ B、B --b→ C、C --a→ B、C --b→ C。A 在 b 上、B 在 a 上的缺失转换视为进入死状态。
| 选项 | 状态路径 | 结果 |
|---|---|---|
A aabb |
A → B → 死状态 → 死状态 → 死状态 | 拒绝 |
B abab |
A → B → C → B → C | 接受 |
C baba |
第一位 b 就进入死状态 | 拒绝 |
D abba |
A → B → C → C → B | 拒绝,结束于 B |
D 中途两次到 C,却没有在**读完整串后**停在 C,这正是此题容易误判的地方。
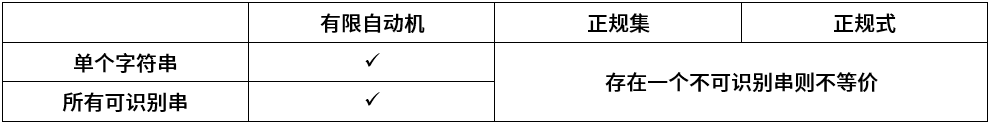
单个串可以通过模拟路径判断;判断两个语言是否相同则需要覆盖全部串。找到一个反例即可否定等价,但几个相同的样例不能证明等价。
例题 13:由自动机判断正规式
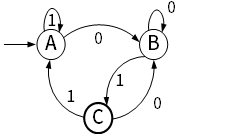
下图所示为一个有限自动机(其中,A是初态、C是终态),该自动机识别的语言可用正规式( )表示。
A、(0|1)*01
B、1*0*10*1
C、1*(0)*01
D、1*(0|10)*1*
参考答案与解析
答案:A,(0|1)*01。 按原图转换逐项读出:
| 状态 | 输入 0 | 输入 1 |
|---|---|---|
| A(初态) | B | A |
| B | B | C |
| C(接受) | B | A |
可以用“已读前缀的结尾”理解三个状态:A 表示空串或以 1 结尾但最后两位不是 01;B 表示以 0 结尾;C 表示以 01 结尾。因此恰好接受所有以 01 结尾的串。
例如 0101 的路径是 A→B→C→B→C,能接受,排除无法表示它的 C;11 能由 B 选项生成,却不能被图接受;D 甚至接受空串,也不符合初态非接受的图。
课件“先看结尾、再找反例”的提示可以用来筛选,但不能把“以 1 结尾”直接当成“以 01 结尾”:11、1011 都以 1 结尾,却不被接受。
例题 14:图示是否真是 DFA
下图所示有限自动机(DFA)是( )。
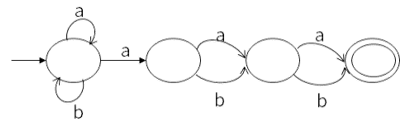
A、确定的有限自动机,它能识别以bab结尾的
B、确定的有限自动机,他不能识别以bab结尾的
C、非确定的有限自动机,他能识别以bab结尾的
D、非确定的有限自动机,他不能识别以bab结尾的
参考答案与解析
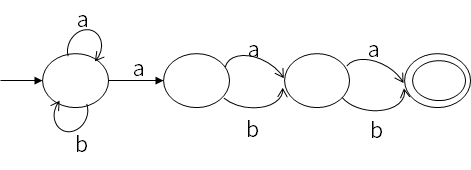
依据实际题图选 D。 题干括号先写了“DFA”,但初态在输入 a 时既可自环,又可走到第二个状态,所以图实际上是 NFA,不能被题干标签带偏。
将从左到右四个状态记为 q₀、q₁、q₂、q₃,q₃ 为唯一接受状态。图上第一条向右的边标的是 a;之后两步都允许 a 或 b。其语言为:
即“倒数第三个字符是 a,长度至少为 3”的串。以 bab 结尾的串,倒数第三个字符必为 b,因此都不被接受。以 bab 为例,状态集合依次为:
读完后没有 q₃,因此拒绝;aba 则有路径 q₀→q₁→q₂→q₃,可以接受。
原选项 A、B 虽称“确定”,与图不符;C 把结尾条件误判了。选项末尾省略的宾语按“字符串”理解,正文保留原选项措辞。
自动机题的固定检查顺序
- 标出初态、接受状态、输入字母表,确认箭头方向及标签。
- 对每个状态和同一输入检查是否存在多个去向,判断 DFA/NFA;缺失边按题目约定处理。
- DFA 每步跟踪一个状态;NFA 每步跟踪一组状态,若有 ε 边还要计算 ε 闭包。
- 读完全部字符再看是否接受。检验正规式时用最短反例筛选,再说明状态对应的语言性质。
关键词用于提醒检查项;最终结论必须来自题图实际转换。
专项题库练习(11 题)
本小节对应题库练习共 11 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 012
来源:知识点练习「程序设计语言基础」第 12 题(原站入口)。
观察下图的有限自动机。对它所能接受的字符串,以下哪项描述不正确?
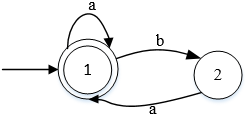
- A. a 不能连续出现
- B. b 不能连续出现
- C. 非空字符串必须以 a 结尾
- D. 可以接受空串
答案与解析
平台答案:A。
整理解析
图中状态 1 既是初态又是终态,且有标记为 a 的自环,所以 aa 等连续 a 可以被接受,A 错误。读 b 会转到非终态 2,必须再读 a 返回 1;因此不能连续出现 b,非空接受串以 a 结尾。初态本身可接受,故空串也被接受。
题目 018
来源:知识点练习「程序设计语言基础」第 18 题(原站入口)。
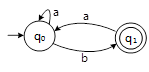
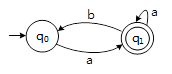
给定图示非确定有限自动机 NFA,q0 同时是初始状态和接受状态。下列哪个确定有限自动机 DFA 与它接受相同的语言?
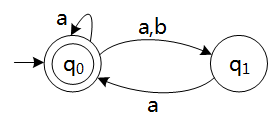
- A.
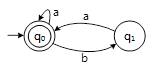
- B.
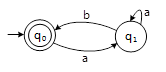
- C.
- D.
答案与解析
平台答案:A。
整理解析
原 NFA 从 q0 返回 q0 的基本回路可读入 a、aa 或 ba;其中 aa 可由两个 a 回路替代,故语言为 (a|ba)*,含空串。A 在接受初态上读 a 可循环,读 b 后必须读 a 才能返回接受态,识别的正是这一语言。图中省略的转移可统一补到拒绝死状态;只验证少数示例不足以证明自动机等价。
题目 024
展开题目 024(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 24 题(原站入口)。
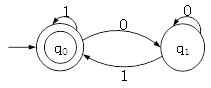
图示 NFA 的 q0 既是初始状态,也是接受状态。对于它接受的 0、1 字符串,以下哪项描述正确?
- A. 接受的 0、1 字符串长度均为偶数
- B. 接受的 0、1 字符串中,0 与 1 的数量相同
- C. 接受的非空 0、1 字符串,其开头和结尾都是 0
- D. 接受的非空 0、1 字符串都以 1 结尾
答案与解析
平台答案:D。
整理解析
图中读到 0 会进入或保持在非终态 q1,读到 1 则进入或保持在接受态 q0。因此读完非空串后能接受,当且仅当最后一位是 1,选 D。串 1 就足以反驳 A、B、C;此外,初态可接受,所以空串也在该语言中。
题目 027
展开题目 027(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 27 题(原站入口)。
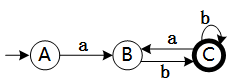
下图给出 DFA 的状态转换,A 是初态,C 是接受态。它能接受下列哪个字符串?
- A. aabb
- B. abab
- C. baba
- D. abba
答案与解析
平台答案:B。
整理解析
逐字符跟踪 abab:A ─a→ B ─b→ C ─a→ B ─b→ C,结束于接受态,选 B。aabb 在 B 读第二个 a 时无可用转移;baba 无法从 A 读入 b;abba 最后落在非终态 B。
题目 038
展开题目 038(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 38 题(原站入口)。
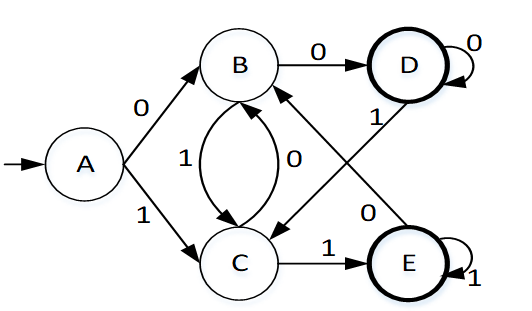
图示 DFA 的初态为 A,接受态为 D、E。以下哪个二进制字符串可被它接受?
- A. 00110
- B. 10101
- C. 11100
- D. 11001
答案与解析
平台答案:C。
整理解析
输入 11100 的路径为 A ─1→ C ─1→ E ─1→ E ─0→ B ─0→ D,最终在接受态,选 C。其余三个选项依次终止于 B、C、C,均非接受态。纠错:平台解析把路径写为 ACEEBDD,多写了最后一个 D;5 个输入符号应产生 5 次转移,即这里的 6 个状态。
题目 045
展开题目 045(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 45 题(原站入口)。
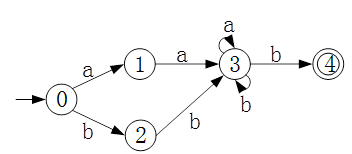
题目给出下图自动机并称其为 DFA,指定 0 为初态、4 为接受态。它能接受下列哪个字符串?
- A. aaab
- B. abab
- C. bbba
- D. abba
答案与解析
平台答案:A。
整理解析
aaab 有接受路径 0 ─a→ 1 ─a→ 3 ─a→ 3 ─b→ 4,选 A。abab、abba 在状态 1 读 b 时无法继续;bbba 不存在读完后停在 4 的路径。纠错:原图状态 3 对输入 b 同时有自环和到 4 的边,实际是非确定自动机,与题干称 DFA 不符;应按存在一条完整接受路径来判定。
题目 056
展开题目 056(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 56 题(原站入口)。
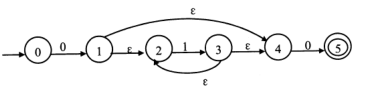
观察下图的非确定有限自动机 NFA,它能接受下列哪个字符串?
- A. 0110
- B. 0101
- C. 1100
- D. 1010
答案与解析
平台答案:A。
整理解析
原图先读 0,从中间的 ε 转移进入可重复读 1 的回路,最后再读 0 到终态,语言为 01*0。因此 0110 有完整接受路径,选 A;B 的末字符不是 0,C、D 的首字符不是 0。仅检查首尾是必要条件,本图的中间回路同时保证 A 的内部两个 1 可被读入。
题目 062
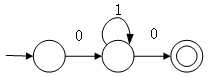
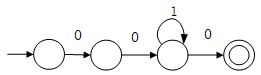
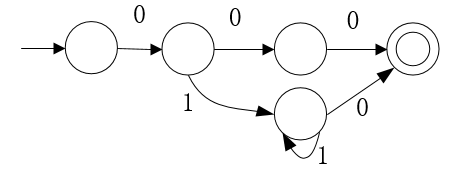
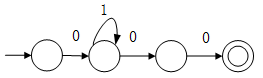
展开题目 062(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 62 题(原站入口)。
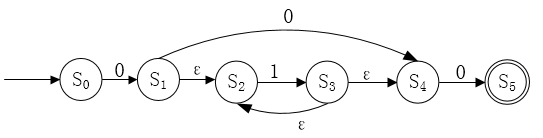
下图给出一个带 ε 转移的非确定有限自动机 NFA。以下哪个 DFA 与它接受完全相同的字符串集合?
- A.
- B.
- C.
- D.
答案与解析
平台答案:C。
整理解析
原图从 S0 先读 0 到 S1;中段可直接读一个 0 到 S4,或经 ε 进入至少读一次 1 的回路后到 S4;最后必须读 0 到 S5。因此语言为 000 或 01ⁿ0(n≥1)。C 正好具有这两条分支,选 C。A 会接受原图不接受的 00;B、D 均不能接受 010,不能与原 NFA 等价。
题目 072
展开题目 072(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 72 题(原站入口)。
下图为有限自动机的状态转换关系。它能接受哪个二进制字符串?
- A. 1001
- B. 1100
- C. 1010
- D. 0101
答案与解析
平台答案:B。
整理解析
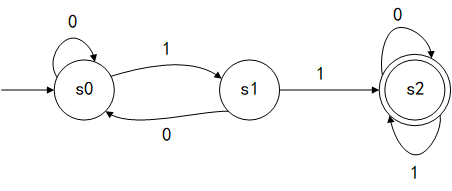
输入 1100 的状态路径为 s0→s1→s2→s2→s2,结束在接受态 s2,选 B。图中连续读到两个 1 即可进入 s2,此后 0、1 都自循环;其余选项均不含连续的 11,不能到达接受态。
题目 078
展开题目 078(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 78 题(原站入口)。
观察图示有限自动机(题面标注为 DFA),选择其确定性分类,以及它能否接受以 bab 结尾的字符串。
- A. 确定有限自动机,能接受以 bab 结尾的字符串
- B. 确定有限自动机,不能接受以 bab 结尾的字符串
- C. 非确定有限自动机,能接受以 bab 结尾的字符串
- D. 非确定有限自动机,不能接受以 bab 结尾的字符串
答案与解析
平台答案:D。
整理解析
初态读 a 时可自环或转入下一状态,所以它是 NFA。从初态通向终态的非循环路径依次读入 a、任意字符、任意字符,因此接受串的倒数第三个字符必须是 a,不能以 bab 结尾,选 D。纠错:题干括注 DFA 与原图的非确定转移不符。
题目 082
展开题目 082(先作答,再查看解析)
来源:知识点练习「程序设计语言基础」第 82 题(原站入口)。
下图给出 NFA,S0 为初态、S3 为接受态。它接受的字符串具有哪项性质?
- A. 不能包含连续的 0
- B. 不能包含连续的 1
- C. 必须以 101 开头
- D. 必须以 101 结尾
答案与解析
平台答案:D。
整理解析
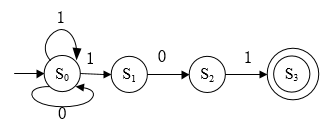
在 S0 可循环读任意 0、1;一旦选择离开,就必须读完 1→0→1 才能到达 S3,后面没有继续读入的边。因此语言为 (0|1)*101,选 D。00101、11101 都能被接受,说明连续 0 或 1 均允许,也不要求以 101 开头。
八、前缀、中缀与后缀表达式
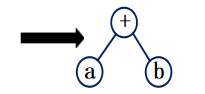
对同一棵表达式树,前序遍历得到前缀式,按运算顺序加括号的中序表示得到中缀式,后序遍历得到后缀式。前缀式又称波兰式,后缀式又称逆波兰式。
| 表达式 | 前缀式 | 中缀式 | 后缀式 |
|---|---|---|---|
| 两数相加 | + a b |
a+b |
a b + |
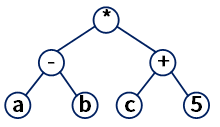
| 先减、先加,再乘 | * - a b + c 5 |
(a-b)*(c+5) |
a b - c 5 + * |
空格用来区分记号,尤其是多位数和多字符变量;题目若全是单字符操作数,可以省略空格。
从表达式树到后缀式,再用栈求值
表达式树的叶子是操作数,内部节点是运算符,根对应整个表达式最后执行的运算。对二元运算,左、右子树的顺序必须保留;减法、除法交换子树会改变结果。前序为“根、左、右”,后序为“左、右、根”;中序转文本时要恢复必要括号,不能只把字符串起来。
例如 (p+q)/(r-s) 的根是 /,左子树根为 +,右子树根为 -;前缀为 / + p q - r s,后缀为 p q + r s - /。其中 / 放在最后,表示两棵子树的结果都已准备好才做除法。
后缀式从左向右求值时:操作数入栈;遇到二元运算符先弹出右操作数 b,再弹出左操作数 a,将 a 运算符 b 的结果压回栈。以 9 3 - 2 / 为例:
| 读到的记号 | 栈内容(左底右顶) | 动作 |
|---|---|---|
| 9、3 | [9,3] |
两个操作数依次入栈 |
| - | [6] |
先弹 3,再弹 9,计算 9−3 |
| 2 | [6,2] |
新操作数入栈 |
| / | [3] |
先弹 2,再弹 6,计算 6/2 |
二元运算时不足两个元素说明式子不合法;整个合法单表达式结束后应只剩一个结果。若栈中存放子树而不是数值,同样的弹栈过程也能从后缀式重建表达式树。
中缀转后缀使用的是**运算符栈**,要与上述操作数栈分开。操作数直接输出;遇运算符,先弹出优先级更高的栈顶运算符。优先级相同时,当前运算符左结合则弹出,右结合则保留。左括号入栈,右括号触发弹出直到匹配的左括号,两括号本身不输出;结束后弹出余下运算符。
以通常均为左结合的 +、-、* 处理 8+6*3-4:
| 已扫描到 | 运算符栈(左底右顶) | 已输出后缀 |
|---|---|---|
| 8 | 空 | 8 |
| + | + |
8 |
| 6*3 | + * |
8 6 3 |
| - | - |
8 6 3 * + |
| 4 | - |
8 6 3 * + 4 |
| 结束 | 空 | 8 6 3 * + 4 - |
读到 - 时,先因优先级弹出 *,再因同级左结合弹出 +。转换的运算符栈峰值为 2;对所得后缀求值,读到第三个数时操作数栈为 [8,6,3],峰值为 3,最终结果为 22。问“扫描到某个数时栈里有什么”,必须先确认问哪一种栈;运算符栈在读到操作数时通常不变。
例题 15:中缀转后缀
表达式(a-b)*(c+5)的后缀式是( )。
A、abc5+*-
B、ab-c+5*
C、abc-*5+
D、ab-c5+*
参考答案与解析
答案:D,ab-c5+*。 对原图从左到右做后序遍历:先得到左子树 ab-,再得到右子树 c5+,最后输出根节点 *。
不要只把括号去掉或只按文本顺序移动符号;必须保留原来的运算依赖。
例题 16:逆波兰式求值
表达式采用逆波兰式表示时,利用( )进行求值。
A、栈
B、队列
C、符号表
D、散列表
参考答案与解析
答案:A,栈。 从左到右扫描:操作数入栈;遇到二元运算符,先弹出右操作数,再弹出左操作数,计算后把结果压回栈。结束时应只剩一个结果。
例如令 a=8,b=3,c=2,a b - c 5 + * 依次得到 8−3=5、2+5=7、5×7=35。减法、除法要格外注意弹栈顺序。
专项题库练习(7 题)
本小节对应题库练习共 7 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 009
来源:知识点练习「程序设计语言基础」第 9 题(原站入口)。
把中缀算术表达式 (a-b)*(c+d) 改写为后缀表达式,应选哪一个?
- A.
ab-cd+* - B.
abcd-*+ - C.
ab-+*cd - D.
ab-c+d*
答案与解析
平台答案:A。
整理解析
后缀式把运算符放在两个操作数之后。左子表达式得到 ab-,右子表达式得到 cd+,将两部分连接后再附上外层乘号,得到 ab-cd+*,选 A。
题目 015
来源:知识点练习「程序设计语言基础」第 15 题(原站入口)。
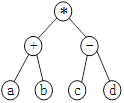
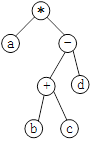
以下哪棵表达式树对应算术表达式 (a+(b-c))*d?
- A.
- B.
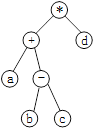
- C.
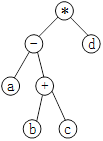
- D.
答案与解析
平台答案:B。
整理解析
最后执行的是乘法,所以根为 *,右子树是 d;左子树的根为 +,其左孩子是 a、右孩子是以 b 和 c 为左右孩子的 -。只有 B 与此结构相符。核图后其余三项分别表示 A:(a+b)*(c-d),C:(a-(b+c))*d,D:a*((b+c)-d)。
题目 022
来源:知识点练习「程序设计语言基础」第 22 题(原站入口)。
计算采用逆波兰式(后缀式)表示的表达式时,通常使用哪种结构?
- A. 栈
- B. 队列
- C. 符号表
- D. 散列表
答案与解析
平台答案:A。
整理解析
从左到右扫描,遇操作数入栈,遇运算符就弹出所需操作数、计算后把结果压回栈,故选 A。对于减法或除法,先弹出的是右操作数,不能颠倒顺序。
题目 053
来源:知识点练习「程序设计语言基础」第 53 题(原站入口)。
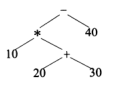
下图的二叉表达式树对应哪个简单算术表达式?
- A.
10*20+30-40 - B.
10*(20+30-40) - C.
10*(20+30)-40 - D.
10*20+(30-40)
答案与解析
平台答案:C。
整理解析
根是减号,右孩子为 40;左子树为乘法,其左孩子是 10,右子树计算 20+30。按树的分组关系得到 10*(20+30)-40,选 C。
题目 066
来源:知识点练习「程序设计语言基础」第 66 题(原站入口)。
将表达式 (a-b)*(c+d) 改写为后缀式(逆波兰式),应选哪项?
- A.
abcd-+* - B.
ab-c+d* - C.
abc-d* - D.
ab-cd+*
答案与解析
平台答案:D。
整理解析
左子表达式写成 ab-,右子表达式写成 cd+,外层乘法放在二者之后,得到 ab-cd+*,选 D。虽然题干与第 9 题计算相同,但选项及正确答案字母不同,应独立保留。
题目 076
来源:知识点练习「程序设计语言基础」第 76 题(原站入口)。
算术表达式 a*(b+c/d)-e 对应哪个后缀式?
- A.
a b c d / + * e - - B.
a b c d e * + / - - C.
a*b+c/d-e - D.
a b * c d / + e -
答案与解析
平台答案:A。
整理解析
先将 c/d 写为 c d /,再与 b 相加,与 a 相乘,最后减 e,所得序列是 a b c d / + * e -,选 A。后缀式的运算符顺序体现原式的分组和优先级。
题目 080
来源:知识点练习「程序设计语言基础」第 80 题(原站入口)。
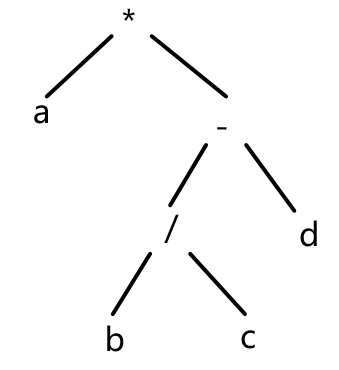
下图二叉树中的 *、/、- 分别表示乘、除、减。该树对应哪个算术表达式?
- A.
a*b/c-d - B.
a*b/(c-d) - C.
a*(b/c-d) - D.
a*(b-c/d)
答案与解析
平台答案:C。
整理解析
根为乘号,左子树是 a,右子树以减号为根,其左侧为 b/c、右侧为 d。所以分组是 a*(b/c-d),选 C。转回中缀式时必须保留右子树的括号,不能只按中序字符直接拼接。
九、章节回顾与关键词辨析
| 复习任务 | 看到题目时先确认什么 |
|---|---|
| 编译与解释 | 是比较传统本机程序,还是讨论具体实现中的字节码、解释、JIT? |
| 语言特点 | 科学计算、符号处理、逻辑推理、JVM/.NET 等识别词,但不把特点当唯一用途 |
| 数据与控制 | 顺序/选择/循环;Python 的有序性、可变性、重复值和访问方式分别判断 |
| 参数传递 | 实参是值、地址还是引用;形参是副本还是别名;赋值改的是谁? |
| 编译过程 | 字符流→词法→记号流→语法结构;类型、声明问题再看静态语义 |
| 文法与推导 | 分清终结符和非终结符;句型可含非终结符,句子不能含 |
| 正规式 | ε≠∅;星号允许零次;先区分连接与选择,再用反例排除 |
| 有限自动机 | 看真实边标签、同一输入的后继数、缺失边、完整输入后的状态 |
| 后缀表达式 | 表达式树后序;栈求值时先出右操作数,再出左操作数 |
课件回顾还要求了解文法分类及其自动机对应关系;复习时将正规文法—有限自动机、上下文无关文法—下推自动机配对。做题需要规则与推导支撑,关键词只是入口。
课件来源
整理自《2026 版本软件设计师考试精讲班视频教程讲义电子版》,使用 Obsidian Web Clipper 正文输入框提取的 Markdown 与其中的教学图片:
原图保留以便对照,存在笔误时以相邻纠错说明为准;图片来源清单记录原始 URL、本地文件名与 SHA-256。