算法基础:复杂度、查找、排序与算法策略
本篇整合“算法基础”的 6 篇课件,保留教学图、原题与选项,并补充参考解析。题号统一编排;选择题答案和推导由本笔记补充,并非课件公布的标准答案。有歧义的题目明确给出算法约定,原图中的简化说法和笔误在相邻正文中说明。
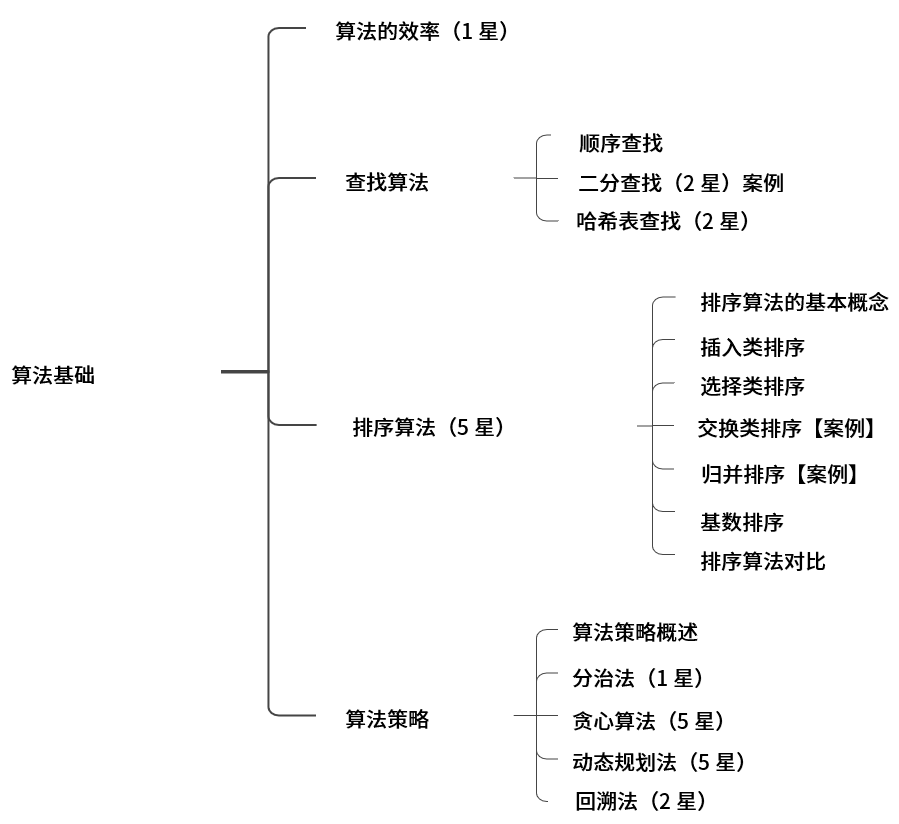
一、怎样分析算法的效率
时间复杂度与空间复杂度
时间复杂度描述基本操作次数随输入规模的增长规律,不等于程序实际运行的秒数。 运行时间还受硬件、语言实现、常数开销和输入分布影响。分析前应说明输入规模 n、计数的基本操作,以及最好、平均或最坏情况。
空间复杂度也要先明确口径:**辅助空间**通常不计输入本身,**总空间**包含输入;递归调用栈、动态申请的数组和临时数据结构都需要计入,不能只数局部变量的个数。比较的是同时占用的最大空间,不是把先后释放的空间全部相加。
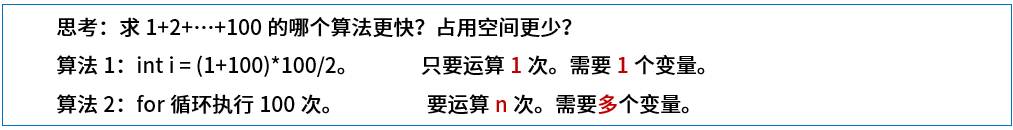
图中 1+2+…+100 的 100 固定时,两种方法都属于常数量级。推广到 1+2+…+n,在固定字长运算模型且不溢出的前提下,公式 n*(n+1)/2 是 Θ(1),逐项累加是 Θ(n);二者都只需常数个变量,辅助空间均为 O(1)。“用了多个变量”不等于 O(n) 空间。 若使用任意精度大整数,还需计算大整数运算的成本。
大 O 表示渐近上界:存在常数 c>0 和 n₀,使所有 n≥n₀ 都有 0≤f(n)≤c·g(n),就记为 f(n)=O(g(n))。Θ 表示同阶紧确界,Ω 表示下界。例如 3n³+2n²+n=Θ(n³),当然也属于 O(n³)。不要把“大 O”与“最坏情况”直接等同:最好、平均、最坏函数各自都可以用 O 或 Θ 描述。
常见增长顺序(n 足够大,指数为固定常数):
1 < log n < n^(2/3) < n < n log n < n² < n³ < n⁴ < 2ⁿ < n!
对数换底只相差常数,因此在渐近复杂度中通常写 log n 即可;精确比较次数仍需说明底数、取整及计数方式。
**摊还分析**考察一串操作的总成本,不需要假设输入的概率分布。例如动态数组从容量 1 开始,满时扩为原来的两倍:某次追加可能要复制已有 n 项,单次最坏 Θ(n);但连续追加 N 项,历次扩容复制量为 1+2+4+…,总和小于 2N,再加 N 次写入,总成本为 Θ(N),所以每次追加的摊还成本为 Θ(1)。这不意味着每次都只做常数次操作,也不同于对随机输入求平均。
从代码结构数操作次数
| 代码结构 | 计数方法 | 常见量级 |
|---|---|---|
| 固定次数的常数成本操作 | 次数不随 n 增长 | Θ(1) |
| 每次加 1,遍历 n 个元素 | n 次 | Θ(n) |
| 两层独立循环,每层 n 次 | n×n 次 | Θ(n²) |
| 内层遍历 1~i | 1+2+…+n | Θ(n²) |
| 每次将区间减半或变量倍增 | 约 log₂n 次 | Θ(log n) |
| 每个元素执行一次对数成本操作 | n×log n | Θ(n log n) |
| 枚举 n 个元素的所有子集 | 2ⁿ 个子集,再乘处理一个子集的成本 | 至少有指数数量的候选 |
顺序执行的部分相加,保留主导项;嵌套循环应写出实际求和,不能只看“有几层循环”。三层各执行 n 次的独立循环才是 Θ(n³)。
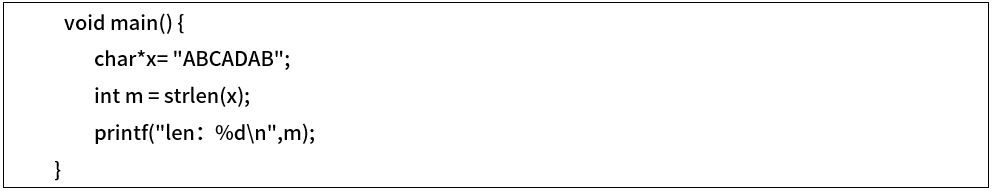
图中字符串固定为 ABCADAB,长度固定,因此该具体片段可视为 O(1)。如果字符串长度是输入 n,常规 strlen 要扫描到终止符,成本是 Θ(n)。没有循环语句也可能调用一个线性或更复杂的函数。 图中 void main() 不是标准的宿主 C 程序入口写法。

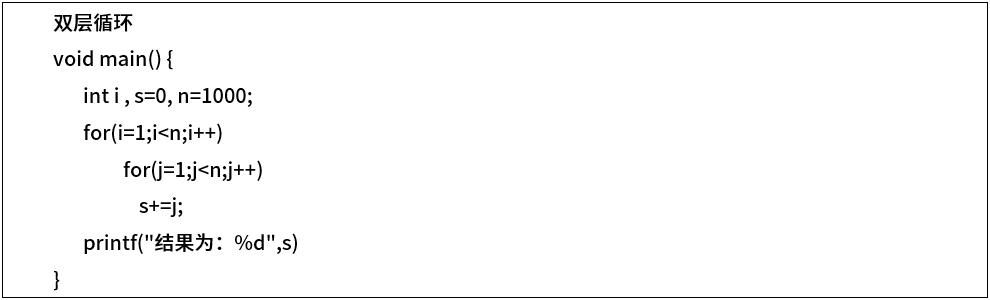
这两张图作为操作次数示意阅读:第一张循环执行 n 次,第二张内层语句执行 (n−1)² 次。图中省略了部分变量声明、数组定义或分号,不应直接当作完整可编译程序;第二张把 n 写成常量 1000,分析 Θ(n²) 时是将 n 推广为输入规模。
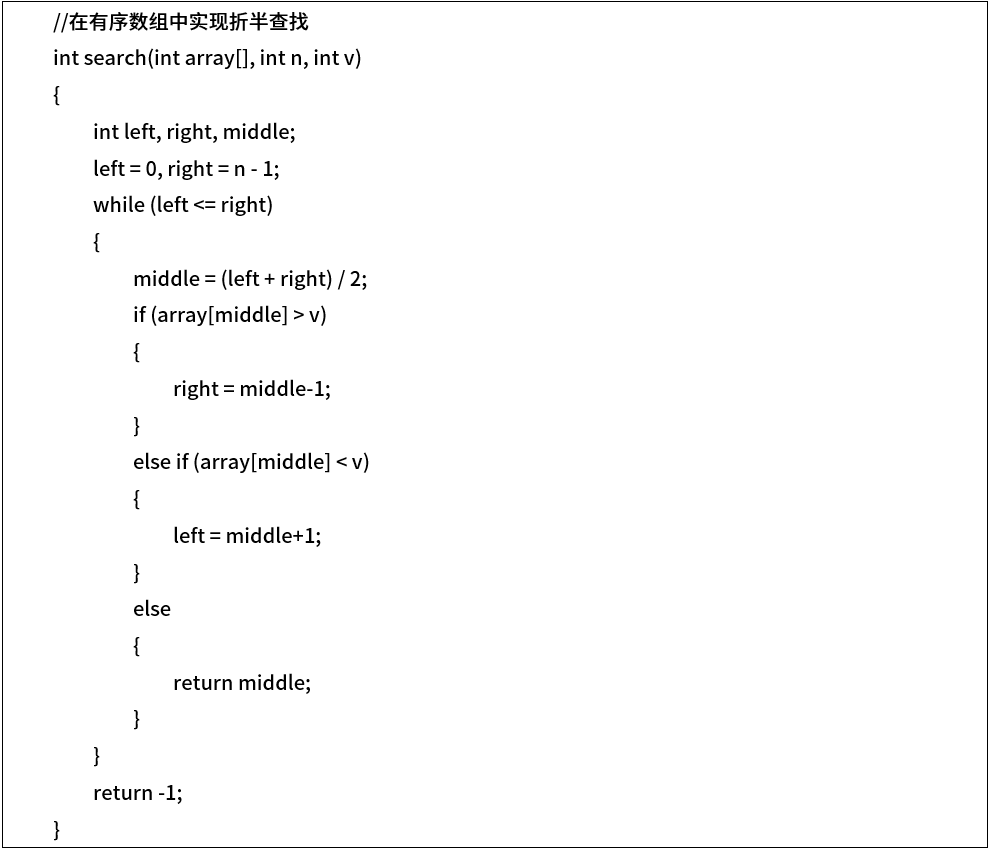
二分查找每轮只保留一半区间,最坏时间为 Θ(log n)。上图是迭代版本,只使用常数个下标,辅助空间 O(1);递归版本还需 O(log n) 调用栈。
两处常见误区:
- 堆排序先自底向上建堆,成本 O(n);随后反复移出堆顶,每次向下调整 O(log n),整体 O(n log n)。不要把一次根节点调整和重新从零建堆混为一谈。
- 自顶向下并不必然是指数时间。**带记忆化的自顶向下动态规划**与自底向上的填表通常计算同一批状态;指数爆炸常出现在没有缓存、重复求解子问题的朴素递归中。
递推式:展开、递归树与主定理
递归算法的时间不仅是递归层数,还包括**每层有多少子问题、每个子问题做多少额外工作**。边界 T(1)=Θ(1) 时,先尝试展开:
T(n)=T(n−1)+n展开成T(1)+2+…+n,为 Θ(n²)。T(n)=T(n/2)+n的总工作是n+n/2+n/4+…,为 Θ(n),不是 Θ(n log n)。T(n)=2T(n/2)+n每层总工作均为 Θ(n),共 Θ(log n) 层,故为 Θ(n log n)。
对 T(n)=aT(n/b)+f(n),a≥1、b>1 为固定常数且基础规模成本为常数,可用**主定理**比较 f(n) 与 nᶜ,其中 c=log_b a:
| 条件 | 紧确时间界 | 直观含义 |
|---|---|---|
f(n)=O(n^(c−ε)),某个 ε>0 |
Θ(nᶜ) |
越向叶层,总工作越大 |
f(n)=Θ(nᶜ) |
Θ(nᶜ log n) |
各层同阶,相加多一个对数因子 |
f(n)=Ω(n^(c+ε)),且 a·f(n/b)≤q·f(n) 对某个 q<1、充分大的 n 成立 |
Θ(f(n)) |
根部的非递归工作主导 |
这是基本三种情形,不能把所有递推式硬套进去;n−1 型不属于该形式,差一个对数因子的边界情况也需进一步展开或使用扩展定理。例如 T(n)=9T(n/3)+n 中 c=2、f(n)=n,属于第一种,时间 Θ(n²)。若比较 T(n)=aT(n/2)+n 与三次增长,a>2 时主要看 log₂a<3,即 a<8;a=2 时是 n log n,也低于三次增长。
遇到 T(n)=2T(n/2)+n log₂n,令 n=2ʰ。第 i 层有 2ⁱ 个子问题,每层额外工作是 2ⁱ×(n/2ⁱ)×log₂(n/2ⁱ)=n(h−i)。非叶层相加为 n[h+(h−1)+…+1]=nh(h+1)/2,加上 Θ(n) 的叶子成本,得到 Θ(n log²n)。例如 n=16,各层额外工作为 64、48、32、16。它既不是每层都做 n log n,也不满足主定理第三种情形所需的多项式阶差距。若改成 4T(n/2)+n log₂n,基准项变成 n²,而 n log n=O(n^1.5),可用第一种情形得到 Θ(n²);相同的合并成本,递归分支数不同,结果也会不同。
规模倍增题应比较主项:若 T(n)≈cnᵖ,规模**变为** k 倍,耗时约变为 kᵖ 倍;n log n 则要计算 kn·log(kn)/(n·log n)。这只是相同模型下的大规模估计,不能由大 O 单独推出精确秒数;“变为 k 倍”与“增加 k 倍”含义也不同。
例题 1:渐近增长顺序
根据渐进分析,表达式序列:n4, lgn, 2n, 1000n, n⅔, n!从低到高排序为( )。
A、lgn,1000n, n ⅔, n 4, n!, 2 n
B、n ⅔,1000n, lgn, n 4, n!, 2 n
C、lgn,1000n, n ⅔, 2 n, n 4, n!
D、lgn, n ⅔, 1000n, n 4, 2 n, n!
参考答案与解析
选 D。 正确顺序为 lg n、n^(2/3)、1000n、n⁴、2ⁿ、n!。常数 1000 不改变线性增长的阶。原题正文的 n4、2n、n2/3 丢失了上标,按选项分别理解为 n⁴、2ⁿ、n^(⅔)。比较渐近增长时,不以某个较小 n 的数值大小代替结论。
例题 2:最长公共子序列的复杂度
求解两个长度为n的序列X和Y的一个最长公共子序列(如序列ABCBDAB和BDCABA的一个最长公共子序列为BCBA)可以采用多种计算方法。如可以采用蛮力法,对X的每一个子序列,判断其是否也是Y的子序列,最后求出最长的即可,该方法的时间复杂度为( )。经分析发现该问题具有最优子结构,可以定义序列长度分别为i和j的两个序列X和Y的最长公共子序列的长度为C[i,j],如下式所示。
采用自底向上的方法实现该算法,则时间复杂度为( )。
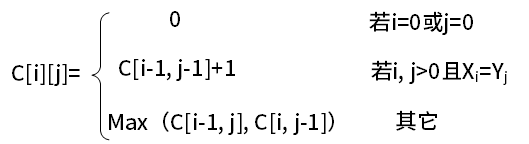
A、O(n²)
B、O(n²lgn)
C、O(n³)
D、O(n2n)
A、O(n²)
B、O(n²lgn)
C、O(n³)
D、O(n2n)
参考答案与解析
两空依次选 D、A,即 O(n·2ⁿ)、O(n²)。 第一组 D 原文的 O(n2n) 应读作 O(n·2ⁿ)。X 有 2ⁿ 个按位置选取的子序列,对每个候选用 O(n) 扫描判断是否也是 Y 的子序列,得到 O(n·2ⁿ)。
动态规划令 C[i][j] 表示 X 前 i 个字符与 Y 前 j 个字符的最长公共子序列长度。边界行为 0;末字符相同,取左上角加 1;否则取上方与左方的较大值。状态数 (n+1)²,每个状态 O(1),因此时间 O(n²)。
完整表辅助空间 O(n²)。只求长度可滚动到 O(n),恢复一个实际子序列则需另行处理路径信息。若改用自顶向下递归并缓存 (i,j) 的结果,时间仍可为 O(n²),并不是课件概述中所说的“一律 O(2ⁿ)”。示例 ABCBDAB 与 BDCABA 的 LCS 长度为 4,BCBA 是一个可行解。
专项题库练习(5 题)
本小节对应题库练习共 5 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 002
来源:知识点练习「算法基础」第 2 题(原站入口)。
某算法的运行时间满足递推式 T(n)=T(n-1)+n,n 为问题规模。其渐进时间复杂度为(2);若问题规模“增加了16倍”,运行时间“增加”(3)倍。
请作答:第 2 题。
-
A. Θ(n)
-
B. Θ(nlgn)
-
C. Θ(n2)
-
D. Θ(n2lgn)
答案与解析
平台答案:C。
整理解析
本问选 C。设基础规模的 T(1) 为常数,展开得 T(n)=T(1)+2+3+…+n=T(1)+n(n+1)/2−1,主项是 n2/2,故为 Θ(n2)。无需像平台解析那样直接假设 T(1)=1;常数初值不影响渐进阶。
题目 003
来源:知识点练习「算法基础」第 3 题(原站入口)。
某算法的运行时间满足递推式 T(n)=T(n-1)+n,n 为问题规模。其渐进时间复杂度为(2);若问题规模“增加了16倍”,运行时间“增加”(3)倍。
请作答:第 3 题。
-
A. 16
-
B. 64
-
C. 256
-
D. 1024
答案与解析
平台答案:C。
整理解析
平台选 C,按其意图把规模变为原来的 16 倍,并用平方主项估算,运行时间变为约 162=256 倍。由递推式得到的有限规模精确比值 T(16n)/T(n) 还含低阶项,不能用 n=1 代入渐进阶就当作精确测量。“增加了16倍”若按新增16倍理解,应是 17n,主项比为 289;“变为256倍”也不等于“增加256倍”,题目措辞不严谨。
同材料可参照第 2 题。
题目 014
来源:知识点练习「算法基础」第 14 题(原站入口)。
算法 A 的运行时间满足 T(n)=8T(n/2)+n2,n 为问题规模,其时间复杂度为(14)。算法 B 满足 T(n)=XT(n/4)+n2。当 n 充分大时,若要求 B 比 A 更快,则 X 的最大值为(15)。
请作答:第 14 题。
-
A. O(n)
-
B. O(nlgn)
-
C. O(n2)
-
D. O(n3)
答案与解析
平台答案:D。
整理解析
本问选 D,紧界为 Θ(n3)。主定理中 a=8、b=2,因此 nlog<sub>2</sub>8=n3,而每层单个子问题的额外工作 n2 低一阶,由递归分支的总成本主导。基础规模耗时视为常数。
题目 015
来源:知识点练习「算法基础」第 15 题(原站入口)。
算法 A 的运行时间满足 T(n)=8T(n/2)+n2,n 为问题规模,其时间复杂度为(14)。算法 B 满足 T(n)=XT(n/4)+n2。当 n 充分大时,若要求 B 比 A 更快,则 X 的最大值为(15)。
请作答:第 15 题。
-
A. 15
-
B. 17
-
C. 63
-
D. 65
答案与解析
平台答案:C。
整理解析
按 X 为固定整数个子问题、且“更快”指渐进阶严格更小的口径,选 C。算法 A 为 Θ(n3);B 在 X>16 时为 Θ(nlog<sub>4</sub>X),要 log4X<3,即 X<64,最大整数为 63。X≤16 时分别为 Θ(n2) 或 Θ(n2 log n),也比 n3 低阶。同阶不等于实际耗时相同,X=64 时仍可能因常数更快,平台结论不能解释成所有实现的精确性能界限。
同材料可参照第 14 题。
题目 056
来源:知识点练习「算法基础」第 56 题(原站入口)。
比较以下六个表达式在 n 增大时的渐进增长速度:n4、lg n、2n、1000n、n⅔、n!。由低到高的正确排列是哪一项( )?
-
A. lg n,1000n,n⅔,n4,n!,2n
-
B. n⅔,1000n,lg n,n4,n!,2n
-
C. lg n,1000n,n⅔,2n,n4,n!
-
D. lg n,n⅔,1000n,n4,2n,n!
答案与解析
平台答案:D。
整理解析
选 D,顺序为 lg n、n⅔、1000n、n4、2n、n!。任意正幂最终都快于对数;⅔ 次幂慢于一次幂,常数 1000 不改变一次幂的增长阶;固定次数的多项式慢于指数,而阶乘最终又快于固定底数的指数。这里比较充分大的 n,不要求每个小 n 都满足相同的数值大小次序。
二、查找算法
顺序查找
依次比较元素,找到目标即返回,否则扫描到表尾后失败。不要求元素有序,数组和链表都能使用。
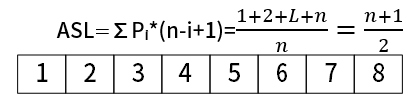
若每个位置被成功查找的概率相同,平均关键字比较次数为 (1+2+…+n)/n=(n+1)/2。失败通常比较 n 个关键字;若把哨兵比较也计算在内,应另说明口径。最好 O(1),平均和最坏 O(n)。
二分查找
教材中的高效二分查找要求**有序且支持按下标随机访问的顺序表**。维护闭区间 [low, high],令 mid=low+(high-low)/2 向下取整;等于目标就成功,大于目标令 high=mid−1,小于目标令 low=mid+1,直到 low>high。
有序链表也可以反复找中点,但访问中点本身不再是 O(1),不具有数组二分查找的相同成本。下标差形式的中点写法可以避免 low+high 的整数溢出。
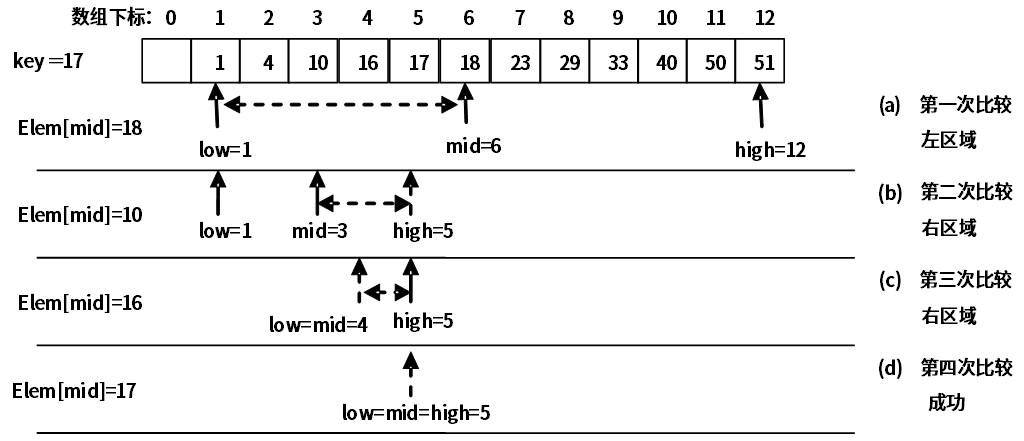
原例有序表 {1,4,10,16,17,18,23,29,33,40,50,51},图采用从 1 开始的下标。寻找 17 依次比较 18 → 10 → 16 → 17,共 4 次。迭代二分在 n≥1 时,最坏关键字比较轮数为 ⌊log₂n⌋+1=⌈log₂(n+1)⌉;此处把一轮三路判断看作一次关键字比较。
二分判定树与平均查找长度
把首次比较的中点作为根,再把左右子区间的中点接为孩子,便得到二分查找判定树。区间被近似均分,所以树高为 O(log n),具有平衡二叉树的形态;它不一定完全,例如两个元素且中点向下取整时,根只有右孩子。
平均查找长度 ASL 是关键字比较次数的概率加权和 Σpᵢcᵢ,不是树高。根计第 1 层:成功找到某结点的比较次数等于其层数;查找失败则沿判定树走到一个空链接,比较次数等于此前经过的实际结点数,不再多算一次空链接。
例如有序表 5,12,19,26,33,40,中点向下取整,根为 19,下一层为 5、33,第三层为 12、26、40。若六个元素等概率,成功 ASL 为 (1×1+2×2+3×3)/6=14/6。失败查询落在七个间隔之一:最小值前、五个相邻值间、最大值后;小于 5 的间隔比较 19、5 共两次,其余六个间隔各三次。**另假设这七个失败间隔等概率**时,失败 ASL 为 (2+6×3)/7=20/7。成功元素等概率不能自动推出失败间隔等概率。
只给比较值、不提供完整表的题,可以累计允许的值域:一次向右排除不大于本次比较值的部分,一次向左排除不小于它的部分;后续比较必须同时满足所有已有上下界。若给了完整数组,还须按每次更新后的下标区间算中点,不能仅凭值域未冲突就认定路径可行。
例题 3:二分查找的前提
在线性表L中进行二分查找,要求L( )。
A、顺序存储,元素随机排列
B、双向链表存储,元素随机排列
C、顺序存储,元素有序排列
D、双向链表存储,元素有序排列
参考答案与解析
选 C。 “顺序存储”保证能直接取中点,“有序排列”保证能排除一半候选。只有其中一个条件不够。
例题 4:不可能出现的比较序列
对某有序表进行折半查找(二分查找)时,进行比较的关键字序列不可能是( )。
A、42,61,90,85,77
B、42,90,85,61,77
C、90,85,61,77,42
D、90,85,77,61,42
参考答案与解析
选 C。 在 90→85→61 之后,下一次比较到 77,说明目标已经进入 (61,85)。此后不可能再比较已经被排除的 42。
做这类题时维护“当前允许的值域”,不要要求相邻比较值始终递增或始终递减。A 可继续落入 (61,85) 的较小部分,B 可落入 (61,85),D 可一路向左,均不违反区间约束。
哈希表与冲突处理
哈希函数把关键字映射到有限的地址空间。冲突是不同关键字得到相同哈希地址;不是“关键字具有相同业务特征”的同义词。常用处理方法包括开放定址法和链地址法。
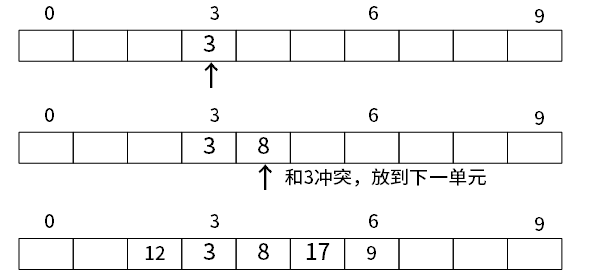
原例表长 10,h(key)=key%5,插入 3、8、12、17、9。3 放到 3;8 的初始地址也是 3,向后探查到 4;12 放到 2;17 从 2 一路探查到 5;9 从 4 探查到 6。哈希函数的模数 5 与线性探查循环回绕的表长 10 是两个参数。
“相同元素只放第一个”是课件的简化口径,不是通用哈希规则。集合可能去重,映射可能覆盖旧值,多重集合或多重映射可能保留多个记录;必须看具体容器语义。开放定址删除通常还需要墓碑等标记,不能随意清空一个槽而截断查找链。
在哈希分布合理且装载因子受控时,查找平均可近似 O(1);最坏可能退化为 O(n),不能无条件写成“一定 O(1)”。
装填因子 α=n/m 表示元素数与桶/槽位数之比。开放定址通常保持 α<1,以便保留空槽;链地址法一个桶能放多个元素,α 可以大于 1。α 较低有助于减少冲突成本,却不能保证无冲突。链地址法将同一哈希地址的关键字存入同一桶的链表等结构,桶内还需继续比较。
哈希地址相同的不同关键字称为**同义词**。线性探查按 (h(key)+i)%m 找空槽,连续占用段容易越来越长,称为聚集;其中可能混有不同初始地址的关键字。例如表长 7、h(k)=k%7,插入 8、15、9 后占据槽位 1、2、3。查 9 时先遇到槽位 2 的 15,但它们的初始地址分别是 2、1,并非同义词。查找必须沿与插入相同的探查序列前进,遇到从未使用的空槽才可判失败;墓碑槽仍需继续探查。
例题 5:什么是哈希冲突
用哈希表存储元素时,需要进行冲突(碰撞)处理,冲突是指( )。
A、关键字被依次映射到地址编号连续的存储位置
B、关键字不同的元素被映射到相同的存储位置
C、关键字相同的元素被映射到不同的存储位置
D、关键字被映射到哈希表之外的位置
参考答案与解析
选 B。 不同关键字被映射到同一个地址。映射到表外说明哈希地址不合法,不是正常意义的冲突处理问题。
例题 6:用线性探查构造哈希表
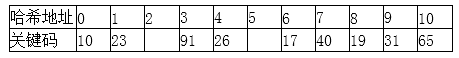
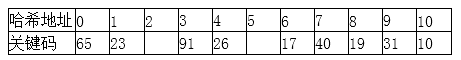
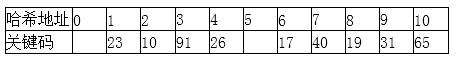
设散列函数为H(key)=key%11,对于关键码序列(23, 40, 91, 17, 19, 10, 31, 65, 26),用线性探查法解决冲突构造的哈希表为( )。
A、

B、

C、

D、

参考答案与推导
选 B。 按题图表长 11,在发生冲突后依次探查 (H(key)+1)%11、(H(key)+2)%11 等位置。
| 关键码 | 初始地址 | 最终地址 |
|---|---|---|
| 23 | 1 | 1 |
| 40 | 7 | 7 |
| 91 | 3 | 3 |
| 17 | 6 | 6 |
| 19 | 8 | 8 |
| 10 | 10 | 10 |
| 31 | 9 | 9 |
| 65 | 10 | 0 |
| 26 | 4 | 4 |
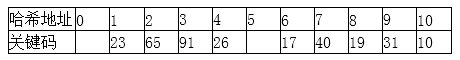
65 的初始地址 10 已放 10,于是回绕到 0;不覆盖先到的元素。最终地址 0~10 为 [65,23,空,91,26,空,17,40,19,31,10]。
专项题库练习(14 题)
本小节对应题库练习共 14 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 001
来源:知识点练习「算法基础」第 1 题(原站入口)。
实现二分查找(折半查找)时,查找表应满足哪项要求( )?
-
A. 顺序存储,关键码无序排列
-
B. 顺序存储,关键码有序排列
-
C. 双向链表存储,关键码无序排列
-
D. 双向链表存储,关键码有序排列
答案与解析
平台答案:B。
整理解析
按教材中有序顺序表的实现选 B。有序性用于排除一半候选,随机访问中点则使每次定位为 O(1),总时间为 O(log n)。有序链表也能按折半思路缩小范围,但定位中点需沿链接访问,不能直接获得同样的 O(log n) 时间保证;“必须顺序存储”是此类标准实现的要求,不是所有折半搜索思想的绝对限制。
题目 009
来源:知识点练习「算法基础」第 9 题(原站入口)。
对一个有序顺序表做折半查找,以下哪组关键字不可能依次出现在查找的比较过程中( )?
-
A. 45,10,30,18,25
-
B. 45,30,18,25,10
-
C. 10,45,18,30,25
-
D. 10,18,25,30,45
答案与解析
平台答案:B。
整理解析
选 B。比较过 30 后又比较 18,说明候选区间已经小于 30;由 18 转向 25 又说明目标大于 18,此后的候选必须处于 (18,30) 内,因而不可能再比较 10。折半查找路径必须始终满足此前累积的上下界,而不能只检查相邻两次比较。
题目 013
展开题目 013(先作答,再查看解析)
来源:知识点练习「算法基础」第 13 题(原站入口)。
在含 55 个互异元素的有序表 A[1..55] 中进行折半查找,中点下标向下取整。若目标值为 A[19],查找过程中依次比较( ),最后比较 A[19]。
-
A. A[28]、A[30]、A[15]、A[20]
-
B. A[28]、A[14]、A[21]、A[17]
-
C. A[28]、A[15]、A[22]、A[18]
-
D. A[28]、A[18]、A[22]、A[20]
答案与解析
平台答案:B。
整理解析
选 B。维护闭区间 [low,high],每次取 mid=⌊(low+high)/2⌋。目标在下标 19,区间依次为 [1,55]、[1,27]、[15,27]、[15,20]、[18,20],中点依次为 28、14、21、17、19。更新边界时排除刚比较过的中点,不能继续保留它。
题目 018
展开题目 018(先作答,再查看解析)
来源:知识点练习「算法基础」第 18 题(原站入口)。
在有序表 A[1..13] 的 13 个元素中进行折半查找,中点下标向下取整。以下说法错误的是( )。
-
A. 无论要查找哪个元素,都是先与A[7]进行比较
-
B. 若要查找的元素等于A[9],则分别需与A[7]、A[11]、A[9]进行比较
-
C. 无论要查找的元素是否在A[]中,最多与表中的4个元素比较即可
-
D. 若待查找的元素不在A[]中,最少需要与表中的3个元素进行比较
答案与解析
平台答案:B。
整理解析
选 B。首个中点是 ⌊(1+13)/2⌋=7,进入右半后中点为 ⌊(8+13)/2⌋=10,不是 11。按目标一路查到下标 9 的标准情形,比较下标为 7、10、8、9;若重复值使查找提前命中,也不能保证 B 所述路径。该判定树的成功/失败查找最多比较 4 次,失败查找最少比较 3 次。
题目 026
展开题目 026(先作答,再查看解析)
来源:知识点练习「算法基础」第 26 题(原站入口)。
有序数组 a[1..12] 包含 12 个互不相同的元素。用中点下标向下取整的二分查找寻找 a[9],依次比较( )后即可查找成功。
-
A. a[6]、a[7]、a[8]、a[9]
-
B. a[6]、a[9]
-
C. a[6]、a[7]、a[9]
-
D. a[6]、a[8]、a[9]
答案与解析
平台答案:B。
整理解析
选 B。初始区间 [1,12] 的中点为 6,因目标下标为 9,下一轮进入 [7,12],中点为 ⌊(7+12)/2⌋=9,立即命中。共比较 a[6]、a[9] 两次。
题目 036
展开题目 036(先作答,再查看解析)
来源:知识点练习「算法基础」第 36 题(原站入口)。
用哈希表保存元素时需要处理碰撞。这里的冲突是指( )。
-
A. 关键字被依次映射到地址编号连续的存储位置
-
B. 关键字不同的元素被映射到相同的存储位置
-
C. 关键字相同的元素被映射到不同的存储位置
-
D. 关键字被映射到哈希表之外的位置
答案与解析
平台答案:B。
整理解析
选 B。哈希冲突指不同关键字 k1≠k2 经哈希函数后得到同一地址 h(k1)=h(k2)。碰撞后可用拉链或开放定址等方式区分记录。键的可能取值多于地址数时不可能保证整个键空间无碰撞,但固定有限键集可采用完美散列;平台“冲突不可避免”不能扩展成任何具体数据集都必定发生碰撞。
题目 045
展开题目 045(先作答,再查看解析)
来源:知识点练习「算法基础」第 45 题(原站入口)。
用散列函数 H(key)=key%11,将关键码(23,40,91,17,19,10,31,65,26)按此顺序插入哈希表,发生冲突时采用线性探查。以下哪张图表示最后的哈希表( )?
-
A.
-
B.
-
C.
-
D.
答案与解析
平台答案:B。
整理解析
选 B。按给定次序计算模 11 的余数,依次为 1、7、3、6、8、10、9、10、4。前七个关键码都可直接放入对应位置;插入 65 时,10 号位置已被 10 占用,线性探查回绕到空的 0 号位置;26 放入 4 号位置。最终地址 0~10 的内容是 [65,23,空,91,26,空,17,40,19,31,10],与 B 图一致。
题目 050
展开题目 050(先作答,再查看解析)
来源:知识点练习「算法基础」第 50 题(原站入口)。
在递增有序表(8,15,19,23,26,31,40,65,91)中进行二分查找,以下哪一组可能是依次比较到的关键字( )?
-
A. 26,23,19
-
B. 26,8,19
-
C. 26,40,65
-
D. 26,31,40
答案与解析
平台答案:C。
整理解析
选 C。按通常的闭区间实现并向下取整中点,首轮比较下标 4 的 26;若目标较大,范围变为下标 5~8,中点是 6,对应 40;再取右半区 7~8,中点是 7,对应 65。因此查找 65 时会得到 26→40→65。若首轮向左,下一项应是 15,故 A、B 不成立;向右时下一项应是 40,也排除了 D。
题目 053
展开题目 053(先作答,再查看解析)
来源:知识点练习「算法基础」第 53 题(原站入口)。
在线性表 L 上实现二分查找,L 应采用哪种存储与排列方式( )?
-
A. 顺序存储,元素随机排列
-
B. 双向链表存储,元素随机排列
-
C. 顺序存储,元素有序排列
-
D. 双向链表存储,元素有序排列
答案与解析
平台答案:C。
整理解析
按有序顺序表的标准实现选 C。元素有序才能根据大小排除一半候选,顺序存储则支持 O(1) 访问中点,使查找达到 O(lg n)。补充:有序链表也可模仿折半缩小范围,但访问中点要沿链接移动,不能据此获得相同的对数时间保证。
题目 057
展开题目 057(先作答,再查看解析)
来源:知识点练习「算法基础」第 57 题(原站入口)。
哈希表使用 H(key)=key%m,并用线性探查处理冲突。查找关键字 e 最终成功,但过程中比较了多个关键字。关于这些被比较的关键字,哪项说法正确( )?
-
A. 这些关键字按有序序列排列
-
B. 这些关键字都不是 e 的同义词
-
C. 这些关键字都是 e 的同义词
-
D. 第一个被比较的关键字可能不是 e 的同义词
答案与解析
平台答案:D。
整理解析
选 D。同义词指散列值相同的不同关键字,但线性探查会把冲突元素移入后续位置,形成包含不同散列值的聚集段。例如 m=5,依次插入 0、5、1 后,它们占据地址 0、1、2;查找 e=1 会先比较地址 1 的 5,而 H(5)=0≠H(1)=1。于是首个比较对象可以不是 e 的同义词。
题目 066
展开题目 066(先作答,再查看解析)
来源:知识点练习「算法基础」第 66 题(原站入口)。
关于散列表及其查找过程,以下哪项叙述正确( )?
-
A. 查找时,只需比较待查关键字及其同义词
-
B. 只要装填因子不大于 ½,就能避免冲突
-
C. 用线性探测处理冲突,容易发生聚集
-
D. 采用链地址法处理冲突,可保证平均查找长度为 1
答案与解析
平台答案:C。
整理解析
选 C。线性探测使碰撞元素依次占据相邻空位,新的碰撞又容易延长连续占用区,形成一次聚集。查找时可能遇到原散列地址不同的关键字,故 A 不成立;低装填因子只能降低冲突概率,不能保证无冲突;链地址法的同一桶也可有多个元素,不能保证平均只比较一次。
题目 067
展开题目 067(先作答,再查看解析)
来源:知识点练习「算法基础」第 67 题(原站入口)。
对长度为 n 的有序顺序表执行二分查找,把比较过程画成判定树,其形态具有以下哪类树的特点( )?
-
A. 最优二叉树(即哈夫曼树)
-
B. 平衡二叉树
-
C. 完全二叉树
-
D. 最小生成树
答案与解析
平台答案:B。
整理解析
选 B。每次选择区间中点,使左右剩余区间的大小至多相差 1;递归形成的各子树高度差也至多为 1,满足平衡二叉树的形态。它不保证末层结点从左向右连续填满,因此一般不是完全二叉树。例如两个元素且中点向下取整时,根仅有右孩子,就是反例。
题目 072
展开题目 072(先作答,再查看解析)
来源:知识点练习「算法基础」第 72 题(原站入口)。
在有序数组 A 中查找记录 K:先比较 K 与中间元素 A[mid],相等就结束;K 较小时继续查左半区,较大时继续查右半区。该算法的设计策略填入(72)。
对于数组(3,14,27,39,42,55,70,85,93,98),假设查找每个元素的概率相同,成功与失败查找的平均比较次数分别填入(73)。
请作答:第 72 题。
-
A. 分治
-
B. 动态规划
-
C. 贪心
-
D. 回溯
答案与解析
平台答案:A。
整理解析
选 A。每次借助中间元素把候选区间分成两半,依据比较结果排除一半,再对保留的一半执行同样操作,按本题的教材分类属于分治策略。它只继续求解其中一个子问题,不需要像归并排序那样递归处理两侧再合并。
题目 073
展开题目 073(先作答,再查看解析)
来源:知识点练习「算法基础」第 73 题(原站入口)。
在有序数组 A 中查找记录 K:先比较 K 与中间元素 A[mid],相等就结束;K 较小时继续查左半区,较大时继续查右半区。该算法的设计策略填入(72)。
对于数组(3,14,27,39,42,55,70,85,93,98),假设查找每个元素的概率相同,成功与失败查找的平均比较次数分别填入(73)。
请作答:第 73 题。
-
A. 29/10和29/11
-
B. 30/10和30/11
-
C. 29/10和39/11
-
D. 30/10和40/11
答案与解析
平台答案:C。
整理解析
按题目预期的等概率口径选 C。向下取整中点时,判定树各层分别有 1、2、4、3 个元素,成功查找平均比较次数为 (1×1+2×2+3×4+4×3)/10=29/10。失败位置共有 11 个:最小元素之前、相邻元素之间的 9 个间隔,以及最大元素之后;其中 5 个间隔需比较 3 次,6 个需比较 4 次,所以在这 11 个间隔等概率的补充假设下,平均值为 (5×3+6×4)/11=39/11。条件缺失:原题只说各元素的查找概率相同,不能据此推出失败间隔也等概率;若失败查询分布不同,应按其概率加权,结果未必是 39/11。另有平台解析笔误:第 7、8 个失败间隔中的“77”应为题干里的 70,原数组并没有 77。
三、排序算法
排序、稳定性与选择条件
排序按关键字建立非递减或非递增顺序。稳定性指**相等关键字的记录在排序前后的相对次序不变**,不是数值本身是否改变。

把原序列的两个 21 标为 21₁、21₂,稳定算法应始终让 21₁ 位于 21₂ 前面。课件的“是否跨区域交换”只能作某些实现的记忆提示,不能代替稳定性的定义或证明。例如稳定归并跨越了两个子区间,但相等时先取左表仍能保持稳定;插入排序若故意把相等元素插到旧元素之前,也会破坏稳定性。
插入排序与希尔排序
**直接插入排序**维护一个已经有序的前缀,把下一个元素插入适当位置。标准稳定版本仅移动严格大于待插入关键字的元素。
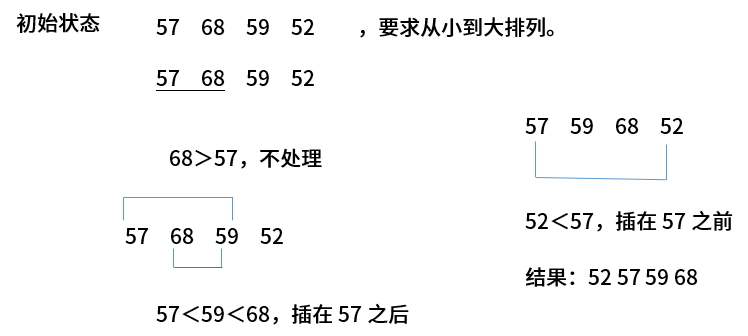
例子依次得到 [57,68,59,52] → [57,59,68,52] → [52,57,59,68]。标准实现的时间与逆序对数量 I 有关,可写为 Θ(n+I):完全有序时 Θ(n),平均和最坏 Θ(n²),辅助空间 O(1)。因此“基本有序”是重要线索,但“无条件最快、一定选它”过于绝对;还需比较规模、稳定性和实际实现。
**希尔排序**按增量 gap 分组,对每组做插入排序,逐步缩小 gap,最后必须有 gap=1。它通常原地进行,但不稳定。
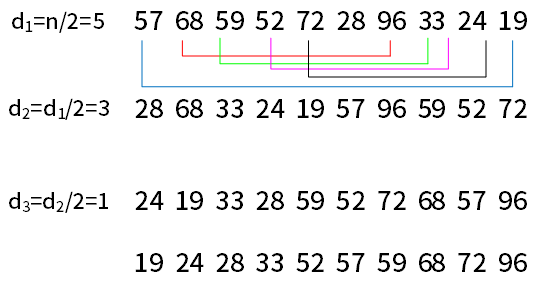
图中实际演示增量 5、3、1,第二行却写成 d₂=d₁/2=3。若采用 C 整数除法逐次减半,5/2 应为 2,因此这张图不能用来说明严格的折半增量;可将它理解为另行选定的 5、3、1 序列。
希尔排序的复杂度取决于增量序列,课件的 O(n^1.3) 不是所有实现的统一界。原始折半增量的最坏时间可为 Θ(n²)。部分考试题将“小于 O(n²)”作为经验性答案,遇到这类表述应区分考试口径与严格的最坏复杂度分析。
例题 7:基本有序时选择哪种排序
现需要对一个基本有序的数组进行排序。此时最适宜采用的算法为( )排序算法,时间复杂度为( )。
A、插入
B、快速
C、归并
D、堆
A、O(n)
B、O(nlgn)
C、O(n²)
D、O(n²lgn)
参考答案与解析
两空依次选 A、A。 题目按“基本有序、插入时仅少量移动”的常规考试口径,选直接插入排序、O(n)。严格说,仅有“看起来基本有序”不足以证明 Θ(n):例如还需要逆序对数为 O(n) 等条件。其他三种标准排序通常需要 Θ(n log n) 量级的工作。
选择排序与堆排序
**简单选择排序**每趟在剩余元素中找最小值,与剩余区间首元素交换。
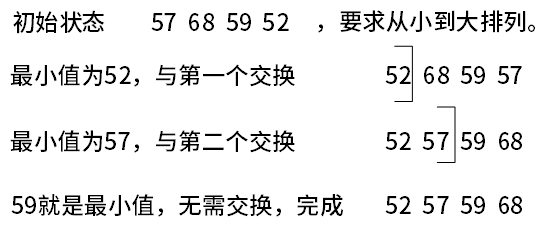
无论输入顺序如何,都需 Θ(n²) 次关键字比较;辅助空间 O(1)。标准交换版本不稳定,例如 [2₁,2₂,1] 首趟变成 [1,2₂,2₁]。
堆是满足父子大小关系的完全二叉树。 使用从 1 开始的数组下标时,i 的孩子在 2i、2i+1;关系只检查存在的孩子。小顶堆父节点≤孩子,大顶堆父节点≥孩子,可以相等。兄弟节点之间不要求有序,整个堆数组也不要求完全排序。
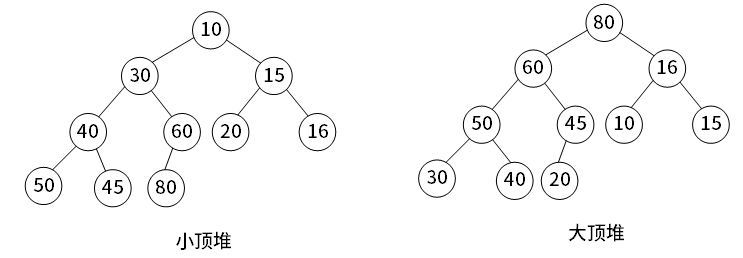
使用从 0 开始的下标时,孩子为 2i+1、2i+2,最后一个非叶节点为 n//2−1。这两套下标公式不能混用。
大顶堆实现数组升序排序:
- 从最后一个非叶节点向根逐个向下调整,初建堆为 O(n)。
- 交换堆顶与当前堆尾,把最大值固定到数组尾部;缩小堆的有效范围。
- 只对新堆顶执行向下调整,成本 O(log n),重复到堆只剩一个元素。
原例数组为 {30,60,10,50,45,16,15,80,40,20}。
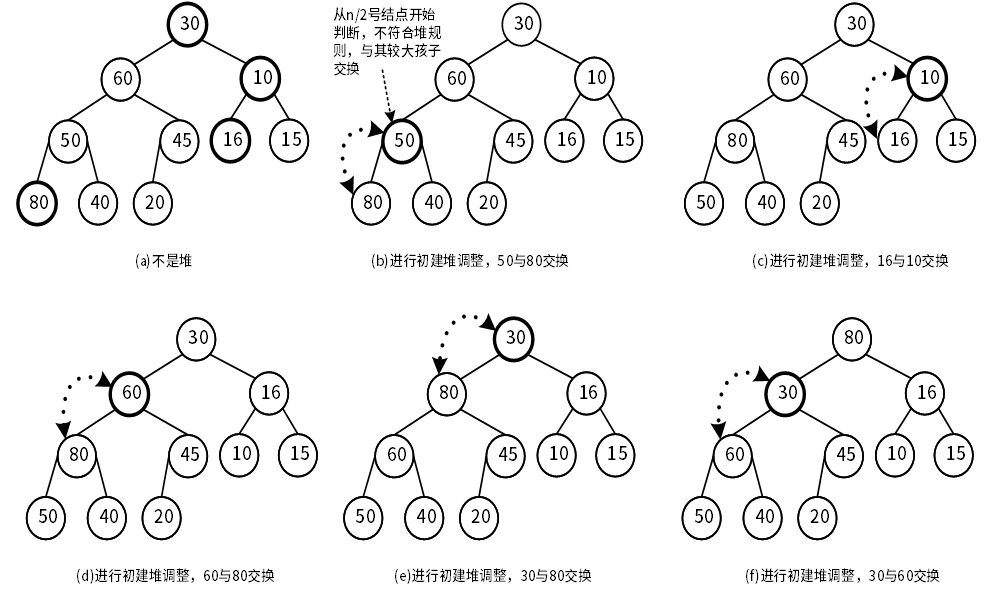
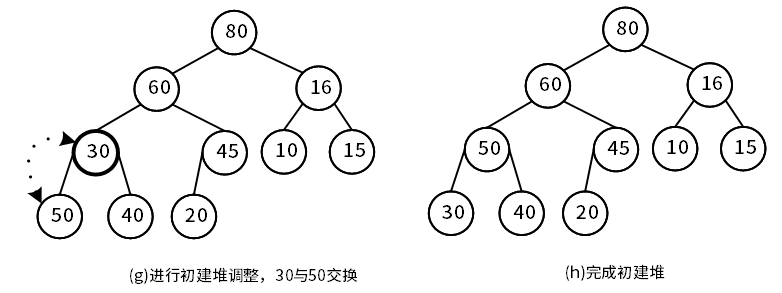
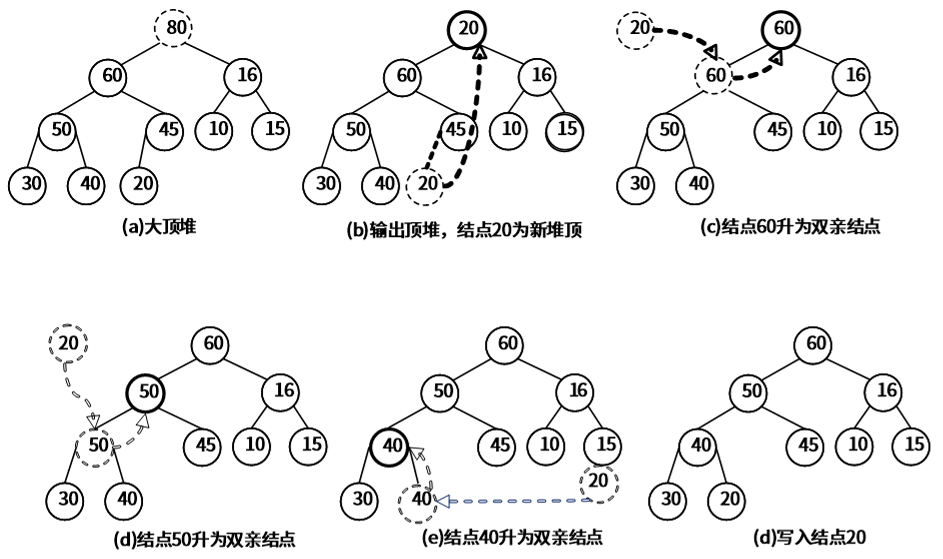
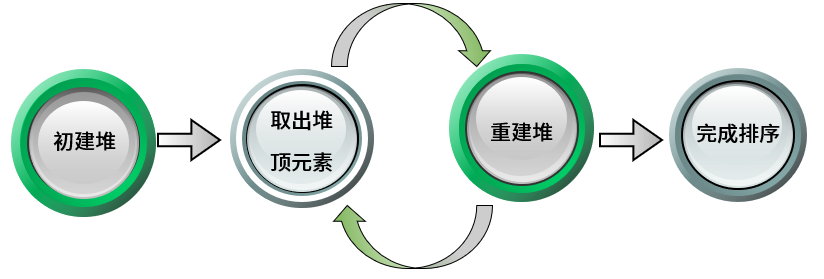
初建堆后数组是 [80,60,16,50,45,10,15,30,40,20];移出 80 后,有效堆为 [60,50,16,40,45,10,15,30,20],数组末端固定为 80。接着移出 60,有效堆变成 [50,45,16,40,20,10,15,30],末尾为 [60,80]。
原图所说的“重建堆”在这一阶段是**已有堆删除堆顶后的局部修复**,不是每次重新执行完整的 O(n) 建堆。整体时间 O(n log n),迭代原地实现辅助空间 O(1),不稳定。
只取最大的前 k 项,不必把全部 n 项排序(1≤k≤n)。可以对全部数据建大顶堆,再取出堆顶 k 次,时间 O(n+k log n);也可以只维护容量 k 的**小顶堆**,让堆顶表示当前入选者中最小的一项。新值不大于堆顶就舍弃,更大则替换堆顶并向下调整。例如 k=3,依次读入 8,3,11,5,10,2:前三项入选;5 替换 3,10 替换 5,2 被舍弃,最终入选 8,10,11。处理每项后都保留已读数据的最大 k 项,因此最后结果正确。k≥2 时总时间 O(n log k)、辅助空间 O(k);k=1 就是线性求最大值。堆中元素尚未全部有序,若还要求输出顺序,再对这 k 项排序。重复值按记录计数,若要求不同数值还须另行去重。
例题 8:由原数组构建大顶堆
对数组A=(2,8,7,1,3,5,6,4)构建大顶堆为( )。(用数组表示)
A、(1,2,3,4,5,6,7,8)
B、(1,2,5,4,3,7,6,8)
C、(8,4,7,2,3,5,6,1)
D、(8,7,6,5,4,3,2,1)
参考答案与条件说明
按标准自底向上、逐个向下调整的过程,选 C。 从原数组 (2,8,7,1,3,5,6,4) 开始:
- 调整下标 4(按 1 起始):1 与孩子 4 交换,得到
(2,8,7,4,3,5,6,1)。 - 下标 3 的 7、下标 2 的 8 已满足条件。
- 下标 1 的 2 先与 8 换,再与 4 换,得到
(8,4,7,2,3,5,6,1)。
D 同样满足大顶堆定义。 如果题目只问“哪一个数组是大顶堆”,C、D 都成立;只有补足常规建堆过程的约定,C 才是该过程对应的结果。不能用“D 不是堆”来排除它。
冒泡排序与快速排序
**冒泡排序**通过相邻元素比较和交换,使本轮极值逐渐移动到一端。
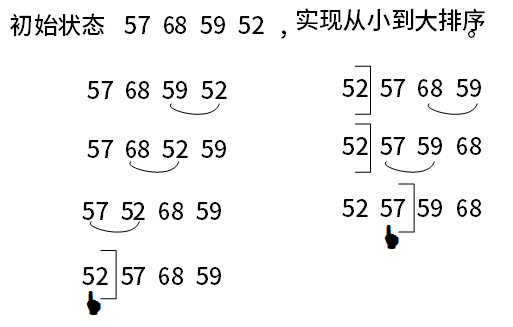
标准稳定实现仅在顺序严格颠倒时交换。平均和最坏时间 O(n²),辅助空间 O(1)。只有带“本趟无交换则提前停止”等优化,完全有序输入才达到 O(n);“基本有序”并不自动保证冒泡排序线性。
**快速排序**选择基准,将序列划分,再分别处理子区间,属于分治。基准可取首元素、末元素、随机元素或抽样中值;具体划分过程由实现决定。
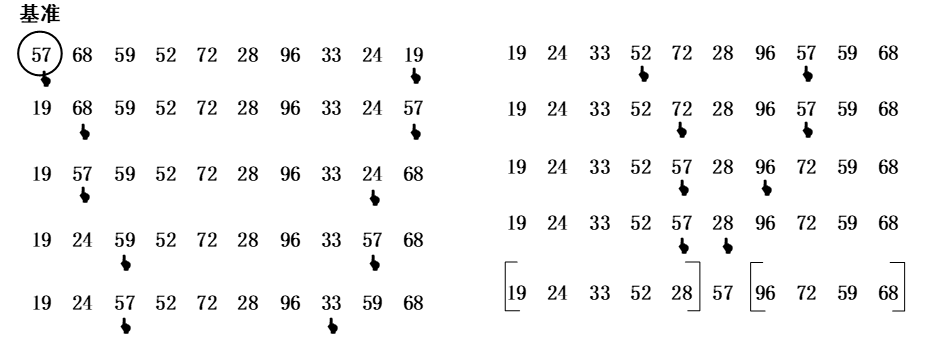
一次划分并不要求左右子区间内部有序。相等关键字放在哪边、基准是否归位,也要看采用的是 Lomuto、Hoare 还是三路划分等具体方法。
标准原地递归快排的平均和最好时间为 O(n log n),最坏 O(n²);辅助空间需计递归栈:平衡时 O(log n),最坏 O(n)。只数交换用的临时变量得到 O(1),会漏掉调用栈。先递归较短子区间、用循环处理较长子区间可将栈深度控制在 O(log n),但不因此消除最坏 O(n²) 的比较成本。
首或末元素作为基准时,已排序输入容易产生极不平衡划分。随机选基准可得到期望 O(n log n),不等于绝无最坏输入;“三数取中”也不是每次都能找到真正中位数。所有关键字相等时,还需注意二路划分的退化,不能只看数组是否有序。
例题 9:以末元素为基准进行一趟划分
对数组A=(2,8,7,1,3,5,6,4)用快速排序算法的划分方法进行一趟划分后得到的数组A为( )(非递减排序,以最后一个元素为基准元素)。进行一趟划分的计算时间为( )。
A、(1,2,8,7,3,5,6,4)
B、(1,2,3,4,8,7,5,6)
C、(2,3,1,4,7,5,6,8)
D、(2,1,3,4,8,7,5,6)
A、O(1)
B、O(lgn)
C、O(n)
D、O(nlgn)
参考答案与实现约定
第二空选 C;第一空缺少唯一确定结果的条件。 以常见的 Lomuto 划分为例,用最后的 4 作基准,从左到右扫描,维护已发现的“小于等于 4”区间:
- 2 已在左边;8、7 跳过。
- 遇到 1,与左区间后的 8 交换,得到
(2,1,7,8,3,5,6,4)。 - 遇到 3,与 7 交换,得到
(2,1,3,8,7,5,6,4)。 - 扫描结束,将基准 4 与 8 交换,得到
(2,1,3,4,7,5,6,8)。
注意:上述标准 Lomuto 结果并不在原题选项中。 D 为 (2,1,3,4,8,7,5,6),可由另一种保持两侧相对顺序的稳定划分得到;B、C 也满足所有左侧值小于 4、右侧值大于 4 的分区性质。因此仅凭题干“以最后一个元素为基准”不能唯一确定某个排列,不能把 D 宣称为标准 Lomuto 的精确输出。
本题能明确判断的是第二空 C,O(n)。第一空需要题目指定的划分伪代码才能唯一作答;若试题预期 D,应理解为其特定划分过程的口径,而不是各种快速排序的共同结论。
快速选择:只寻找第 k 小
快速选择借用快排的划分,但只递归包含目标排名的一侧。把当前区间分成小于、等于、大于基准三组,数量分别为 L、E、G,排名 k 从 1 开始:k≤L 时进左组;L<k≤L+E 时答案就是基准;否则进右组,排名改为 k−L−E。这样也能正确处理重复值。
与快排的“两侧都排序”相比,它无须整理不含目标的那侧。若每次在线性时间选到能保证均衡的基准并划分,满足 T(n)=T(n/2)+Θ(n),总时间 Θ(n);随机基准通常给期望 Θ(n),最坏仍可能 Θ(n²)。真正的中位数是数组中居于中间排名的元素,偶数规模可取两个中间元素之一;用完整排序求中位数会额外付出排序成本。
归并排序
归并排序把两个有序子表合并为一个有序表。比较两表首个未取元素,相等时优先取左表,才能保持稳定;一侧取尽后,将另一侧剩余元素整体接上。
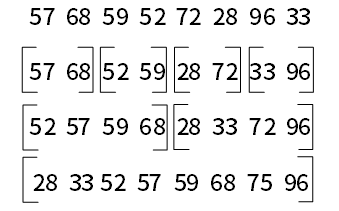
图中原数据为 57,68,59,52,72,28,96,33,最终一行把 72 误写成 75。正确结果是 28,33,52,57,59,68,72,96,排序不会凭空改变关键字。
标准数组归并排序最好、平均和最坏时间均为 O(n log n),辅助数组 O(n);递归栈 O(log n) 被 O(n) 主导。链表归并可以通过重连节点减少数组式辅助存储,但仍需按具体实现计算调用栈。
两个非空有序表长度为 m、n 时,普通双指针合并的关键字比较次数最少为 min(m,n),最多为 m+n−1。最少情形是较短表的全部元素先被取完;最坏情形是在最后一次比较后才有一表耗尽。即使比较提前结束,完整生成数组结果仍要复制剩余记录,移动成本为 Θ(m+n)。
例题 10:最坏情况下的排序复杂度
对n个数排序,最坏情况下时间复杂度最低的算法是( )排序算法。
A、插入
B、冒泡
C、归并
D、快速
参考答案与解析
选 C。 标准插入、冒泡与快速排序的最坏时间都是 O(n²),归并排序的最坏时间是 O(n log n)。题目问的是最坏界,不是平均执行速度。
计数排序:用值域换比较
当关键字为整数且落在较小的连续范围 [low,high] 内,可开 K=high−low+1 个计数槽,用 count[key−low] 统计频数,再按关键字递增输出。例如 3,1,3,2 的频数为 1 出现一次、2 一次、3 两次,直接得到 1,2,3,3。时间 Θ(n+K),仅排序数值可用 O(K) 辅助空间;K 很大而记录很少时不划算。
若记录还附有姓名等数据,不能只输出重复的关键字。标准稳定计数排序对计数求前缀和,得到每种键的输出结束位置,再从输入末尾向前放置**完整记录**并递减位置,额外输出数组使空间为 O(n+K)。它利用键的取值范围,不受一般比较排序 Ω(n log n) 下界的限制;后者针对只靠关键字比较区分任意排列的模型。
基数排序
基数排序按关键字的各位分配和收集,不基于两两比较。LSD 版本从最低位处理到最高位;每一轮必须稳定,才能保留前面较低位的排序成果。对于十进制非负整数,不足的高位按 0 补齐。
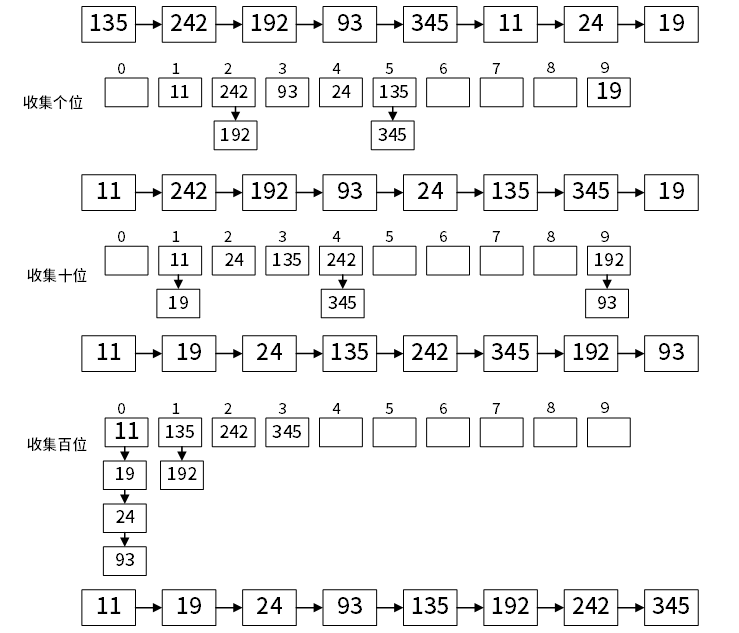
图中初始序列 135,242,192,93,345,11,24,19,最终为 11,19,24,93,135,192,242,345。
统一记号:n 为记录数、d 为位数、r 为每位可能的取值数,例如十进制 r=10。每轮分配 n 个元素、收集 r 个桶,共 d 轮,因此常见实现为 O(d(n+r)) 时间、O(n+r) 辅助空间。链式实现若节点已属于输入,桶头尾指针等额外存储可按 O® 计;要说明口径。
课件正文和汇总图使用 O(d(n+rd))、O(rd),混用了参数和存储口径,不采用它们作为通用公式。也不能只凭“关键字较少”选基数排序,关键要看能否拆成合适的位、位数和基数大小、桶存储开销。
排序方法对照与选型
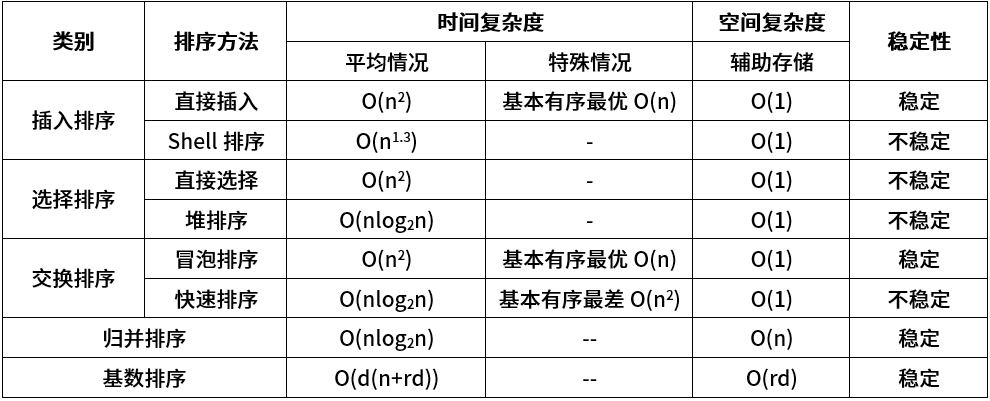
下面按常见实现整理;“稳定”均以正确处理相等关键字为前提。
| 方法 | 最好时间 | 平均时间 | 最坏时间 | 辅助空间 | 稳定 |
|---|---|---|---|---|---|
| 直接插入 | O(n) | O(n²) | O(n²) | O(1) | 是 |
| 希尔 | 依增量与实现 | 依增量与输入模型 | 原始折半增量可 O(n²) | 原地版本 O(1) | 否 |
| 简单选择 | O(n²) | O(n²) | O(n²) | O(1) | 否 |
| 堆排序 | O(n log n) | O(n log n) | O(n log n) | 迭代原地 O(1) | 否 |
| 冒泡,带提前停止 | O(n) | O(n²) | O(n²) | O(1) | 是 |
| 快速,普通递归 | O(n log n) | O(n log n) | O(n²) | 平均 O(log n),最坏 O(n) | 否 |
| 数组归并 | O(n log n) | O(n log n) | O(n log n) | O(n) | 是 |
| LSD 基数 | O(d(n+r)) | O(d(n+r)) | O(d(n+r)) | 常见实现 O(n+r) | 是 |
记录数量小或逆序对少时,可考虑直接插入;要求稳定且需要 O(n log n) 最坏界时,可考虑归并;额外空间很紧且需要 O(n log n) 最坏界时,可考虑迭代堆排序。快排通常有良好平均性能,但“内部排序永远最快”不是可保证的结论;还需看分布、缓存、实现与输入规模。
判断“一趟后是否归位”,看本趟能否证明某元素左边都不大于它、右边都不小于它。冒泡与选择把极值移到端点;堆排序完成一次取出堆顶后固定极值;基准归位式快排固定枢轴。插入的一趟只让已处理前缀有序,归并的一趟只让局部段有序,后续仍可能移动其中每个元素。初建堆尚未取出堆顶、或不保证枢轴归位的分区实现,应单独分析。
例题 11:第一趟就能确定某个元素的最终位置
对于一个初始无序的关键字序列,在下面的排序方法中,( )第一趟排序结束后,一定能将序列中的某个元素在最终有序序列中的位置确定下来。
①直接插入排序②冒泡排序③简单选择排序④堆排序⑤快速排序⑥归并排序
A、①②③⑥
B、①②③⑤⑥
C、②③④⑤
D、③④⑤⑥
参考答案与口径说明
按教材常用定义,选 C:②③④⑤。 冒泡把一个极值移到末端,简单选择把一个极值交换到首端,堆排序交换堆顶与堆尾后固定一个极值,采用基准归位的快排划分固定基准的位置。
插入和归并的一趟通常只保证局部有序。这里“堆排序第一趟”指完成一次取出堆顶,不能只做初建堆;“快排第一趟”指基准归位的划分,而 Hoare 原始分区返回边界并不必然使基准落到最终位置。遇到给定代码的题,应以实际实现为准。
专项题库练习(22 题)
本小节对应题库练习共 22 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 006
来源:知识点练习「算法基础」第 6 题(原站入口)。
快速排序先在待排序数组中确定一个基准元素,以此划分为前、后两部分:前一部分的元素值小于等于基准,后一部分大于基准,再分别对两部分继续划分。这体现了(6)算法设计策略。已知确定基准元素这一步的时间复杂度为 Θ(n),则最好、最坏情况下的排序时间复杂度分别为(7)。
请作答:第 6 题。
-
A. 分治
-
B. 动态规划
-
C. 贪心
-
D. 回溯
答案与解析
平台答案:A。
整理解析
本问选 A。确定基准并划分后,将两个更小的子区间分别排序,是分治策略;各子问题之间无需像动态规划那样复用重叠状态。通常把基准放到最终位置后再递归处理其余元素,以确保问题规模缩小。
题目 007
来源:知识点练习「算法基础」第 7 题(原站入口)。
快速排序先在待排序数组中确定一个基准元素,以此划分为前、后两部分:前一部分的元素值小于等于基准,后一部分大于基准,再分别对两部分继续划分。这体现了(6)算法设计策略。已知确定基准元素这一步的时间复杂度为 Θ(n),则最好、最坏情况下的排序时间复杂度分别为(7)。
请作答:第 7 题。
-
A. Θ(n)和Θ(nlgn)
-
B. Θ(n)和Θ(n2)
-
C. Θ(nlgn)和Θ(nlgn)
-
D. Θ(nlgn)和Θ(n2)
答案与解析
平台答案:D。
整理解析
平台选 D。按允许持续失衡的通常快速排序模型,每轮基准选择加划分耗时 Θ(n):均匀划分时 T(n)=2T(n/2)+Θ(n),为 Θ(n log n);极端划分时 T(n)=T(n−1)+Θ(n),为 Θ(n2)。但“选基准耗时 Θ(n)”本身不代表会选到坏基准;若另有保证划分均衡的线性选枢轴方法,并妥善处理相等元素,最坏可为 Θ(n log n)。平台答案依赖题中未明确保证划分平衡的普通实现口径。
同材料可参照第 6 题。
题目 008
展开题目 008(先作答,再查看解析)
来源:知识点练习「算法基础」第 8 题(原站入口)。
对同一个待排序序列分别使用直接插入排序和简单选择排序。如果其中两个元素的值相同,哪一种方法能保证这两个元素在排序前后的相对次序不变( )?
-
A. 直接插入排序和简单选择排序都可以
-
B. 直接插入排序和简单选择排序都不能
-
C. 只有直接插入排序可以
-
D. 只有简单选择排序可以
答案与解析
平台答案:C。
整理解析
按标准实现选 C。直接插入排序只把严格大于待插入值的元素右移,使新来的相等元素留在已有相等元素之后,因此稳定。通常用远距离交换实现的简单选择排序可能让相等元素越过彼此,因此不稳定。若把比较规则或元素搬移方式改掉,稳定性也可能变化,这里针对教材中的常规实现。
题目 010
展开题目 010(先作答,再查看解析)
来源:知识点练习「算法基础」第 10 题(原站入口)。
按非递减顺序排序时,若能保证排序码相同元素的相对次序保持不变,就称该排序方法稳定。下列哪组输入可以说明简单选择排序不稳定( )?
-
A. 21 48 21* 63 17
-
B. 17 21 21* 48 63
-
C. 63 21 48 21* 17
-
D. 21* 17 48 63 21
答案与解析
平台答案:A。
整理解析
选 A。以每趟选最小值并与未排序区首项交换的常规实现为例,第一趟把 17 与最前面的 21 交换,得到 17、48、21*、63、21。最终为 17、21*、21、48、63,带星号的 21 越到了原先在它前面的 21 之前,构成不稳定的反例。星号只标记元素身份,不参与关键字比较。
题目 011
展开题目 011(先作答,再查看解析)
来源:知识点练习「算法基础」第 11 题(原站入口)。
要在含 n 个数的数组中找出第 i 小的数(1≤i≤n),可借用快速排序的划分思想:对 n 个元素划分,先确定第 k 小的数,再比较 i、k,只进一步处理所需的一侧,直至找到第 i 小的数。划分时,最佳基准应选待处理数组的(11)元素;此时算法在最坏情况下的时间复杂度为(12),不考虑所有元素均相等的情况。
请作答:第 11 题。
-
A. 第一个
-
B. 最后一个
-
C. 中位数
-
D. 随机一个
答案与解析
平台答案:C。
整理解析
本问选 C。选中位数可控制继续搜索的一侧规模;偶数个元素时应取较小或较大的中间顺序统计量作为数组中的基准,不必取两个中间值的算术平均。平台把后续复杂度直接写成 O(n log n),混淆了选择与两侧都递归的排序:若每轮用 O(n) 时间选中位数并划分,且相等元素另行分组或按秩妥善处理,T(n)=T(n/2)+O(n),最坏为 Θ(n)。若靠完整排序找中位数,或重复值被不当分到一侧,结论会变化;仅排除“全部相等”仍不足以保证普通二路划分平衡。
题目 012
展开题目 012(先作答,再查看解析)
来源:知识点练习「算法基础」第 12 题(原站入口)。
要在含 n 个数的数组中找出第 i 小的数(1≤i≤n),可借用快速排序的划分思想:对 n 个元素划分,先确定第 k 小的数,再比较 i、k,只进一步处理所需的一侧,直至找到第 i 小的数。划分时,最佳基准应选待处理数组的(11)元素;此时算法在最坏情况下的时间复杂度为(12),不考虑所有元素均相等的情况。
请作答:第 12 题。
-
A. O(n)
-
B. O(lgn)
-
C. O(nlgn)
-
D. O(n2)
答案与解析
平台答案:C。
整理解析
平台答案保留 C。若按“中位数可在线性时间求出、划分也为线性、重复值妥善分组”的选择算法分析,每次只递归一侧,T(n)=T(⌈n/2⌉)+Θ(n),总成本为 n+n/2+n/4+…=Θ(n),按考试通常要求的紧界应选 A。O(n log n) 虽可作为松上界,却不是由均匀划分直接推出的紧界;若先完整排序求中位数,才可能付出 Θ(n log n) 成本。题干未说明选中位数的方法,仅排除全部相等也不足以保证二路划分均衡。
同材料可参照第 11 题。
题目 016
展开题目 016(先作答,再查看解析)
来源:知识点练习「算法基础」第 16 题(原站入口)。
某应用要对大规模记录排序,记录的关键字为整数。若关键字已基本有序,适合使用(16)排序;若关键字均落在 0 到 9 的范围内,包含两端,则适合使用(17)排序。
请作答:第 16 题。
-
A. 插入
-
B. 归并
-
C. 快速
-
D. 计数
答案与解析
平台答案:A。
整理解析
本问选 A。标准直接插入排序的工作量可写作 Θ(n+I),I 是逆序对数量;基本有序且逆序对很少时,需要搬移的元素少,能接近线性。无需借希尔排序来证明这个结论,“基本有序”也不能在未量化时保证任何实现一定最快。
题目 017
展开题目 017(先作答,再查看解析)
来源:知识点练习「算法基础」第 17 题(原站入口)。
某应用要对大规模记录排序,记录的关键字为整数。若关键字已基本有序,适合使用(16)排序;若关键字均落在 0 到 9 的范围内,包含两端,则适合使用(17)排序。
请作答:第 17 题。
-
A. 插入
-
B. 归并
-
C. 快速
-
D. 计数
答案与解析
平台答案:D。
整理解析
本问选 D。只可能出现 0~9 共 10 种关键字,可先统计频次,再按关键字顺序输出,计数排序耗时 Θ(n+10),即 Θ(n)。这里利用了很小的整数值域;范围很大时计数存储和扫描成本可能不划算,不能泛称它总比所有比较排序快。若记录还有附加数据,应按计数位置搬移完整记录。
同材料可参照第 16 题。
题目 025
展开题目 025(先作答,再查看解析)
来源:知识点练习「算法基础」第 25 题(原站入口)。
n 个关键字按序列 {k1,k2,…,kn} 表示,满足 ki≤k2i 且 ki≤k2i+1(i=1、2、…、[n/2])时称为小根堆(小顶堆)。下列哪个序列不是小根堆( )?
-
A. 16,25,40,55,30,50,45
-
B. 16,40,25,50,45,30,55
-
C. 16,25,39,41,45,43,50
-
D. 16,40,25,53,39,55,45
答案与解析
平台答案:D。
整理解析
选 D。按从 1 开始的数组下标检查每个父结点与实际存在的孩子:D 中 k2=40,而它的右孩子 k5=39,违反父结点不大于孩子的条件。平台解析把大小关系写反了,应是第二个关键字大于第五个。末个非叶结点可能只有左孩子,越界的右孩子不参与比较。
题目 031
展开题目 031(先作答,再查看解析)
来源:知识点练习「算法基础」第 31 题(原站入口)。
两个递增序列 A、B 的长度分别为 m、n,其中 m<n,且 m 与 n 接近。把它们归并为一个长度 m+n 的递增序列,以下哪一种大小关系使归并时的元素比较次数最少( )?
-
A. a1 < a2 < … < am-1 < am < b1 < b2 <… < bn- 1 < bn
-
B. b1 < b2 < … < bn-1 < bn < a1 < a2 < … < am-1 < am
-
C. a1 < b1 < a2 < b2 < …< am-1 < bm-1 < am < bm < bm+1 < … < bn-1 < bn
-
D. b1 < b2 < … < bm-1 < bm < a1 < a2 < … < am-1 < am < bm+1 < … < bn-1 < bn
答案与解析
平台答案:A。
整理解析
选 A。标准双指针归并每次比较两个序列当前首项,较小者进入结果,某一序列耗尽后直接复制另一序列。若 A 的所有元素小于 B 的所有元素,比较 m 次就耗尽较短的 A;反过来需 n 次,而 m<n。该结论针对逐项比较的普通归并;另加整体边界检测可改变特定输入的比较次数。
题目 034
展开题目 034(先作答,再查看解析)
来源:知识点练习「算法基础」第 34 题(原站入口)。
需要排序的数组已经基本有序,最适合采用(34)排序,其时间复杂度为(35)。
请作答:第 34 题。
-
A. 插入
-
B. 快速
-
C. 归并
-
D. 堆
答案与解析
平台答案:A。
整理解析
本问选 A。直接插入排序把下一个元素插到已排序前缀中,只需把比它大的元素后移;已有次序越接近正确,通常需要的搬移越少。更精确的成本为 Θ(n+I),I 是逆序对数;题意按 I 很少的“基本有序”情形选择插入排序。
题目 035
展开题目 035(先作答,再查看解析)
来源:知识点练习「算法基础」第 35 题(原站入口)。
需要排序的数组已经基本有序,最适合采用(34)排序,其时间复杂度为(35)。
请作答:第 35 题。
-
A. O(n)
-
B. O(nlgn)
-
C. O(n2)
-
D. O(n2lgn)
答案与解析
平台答案:A。
整理解析
平台选 A,按基本有序到只剩 O(n) 个逆序对的常见口径,直接插入排序 Θ(n+I)=Θ(n)。仅凭未量化的“基本有序”不能严格保证线性;若逆序对仍很多,成本也随之增大,最坏为 Θ(n2)。
同材料可参照第 34 题。
题目 051
展开题目 051(先作答,再查看解析)
来源:知识点练习「算法基础」第 51 题(原站入口)。
以下四种排序算法用于 n 个数时,哪一种的最坏情况时间复杂度最低( )?
-
A. 插入
-
B. 冒泡
-
C. 归并
-
D. 快速
答案与解析
平台答案:C。
整理解析
选 C。标准归并排序即使在最坏情况下,每层合并总工作量仍为 Θ(n),共有 Θ(lg n) 层,所以是 Θ(n lg n)。通常的直接插入、冒泡以及普通快速排序都可能退化到 Θ(n2)。这里比较的是这些算法的常规实现。
题目 054
展开题目 054(先作答,再查看解析)
来源:知识点练习「算法基础」第 54 题(原站入口)。
将数组 A=(2,8,7,1,3,5,6,4) 按非递减次序进行快速排序,以最后一个元素作为基准。执行一趟划分后的数组填入(54),这一趟划分的计算时间填入(55)。
请作答:第 54 题。
-
A. (1,2,8,7,3,5,6,4)
-
B. (1,2,3,4,8,7,5,6)
-
C. (2,3,1,4,7,5,6,8)
-
D. (2,1,3,4,8,7,5,6)
答案与解析
平台答案:C。
整理解析
平台答案为 C,对应基准随交换移动、两端交替扫描的划分方法:从原数组出发,依次交换 4 与 8、3、7、1,得到 (2,3,1,4,7,5,6,8)。题意限定说明:只说“以末元素为基准”并不能唯一确定划分后的内部次序。B、C、D 都满足 4 左侧小于 4、右侧大于 4;例如保持两侧原相对顺序的稳定划分会得到 D。应保留平台的 C,同时注明它依赖具体划分实现,不能仅由基准位置唯一推出。
题目 055
展开题目 055(先作答,再查看解析)
来源:知识点练习「算法基础」第 55 题(原站入口)。
将数组 A=(2,8,7,1,3,5,6,4) 按非递减次序进行快速排序,以最后一个元素作为基准。执行一趟划分后的数组填入(54),这一趟划分的计算时间填入(55)。
请作答:第 55 题。
-
A. O(1)
-
B. O(lg n)
-
C. O(n)
-
D. O(n lg n)
答案与解析
平台答案:C。
整理解析
选 C。一趟标准划分中,扫描指针只朝前推进,每个元素只接受常数次检查或移动,总时间为 Θ(n),对应 O(n)。这是一趟划分的代价,不是完整快速排序的时间。
题目 058
展开题目 058(先作答,再查看解析)
来源:知识点练习「算法基础」第 58 题(原站入口)。
给定一个起初无序的关键字序列,哪些排序方法在第一趟结束后一定能确定至少一个元素在最终有序序列中的位置( )?
①直接插入排序;②冒泡排序;③简单选择排序;④堆排序;⑤快速排序;⑥归并排序。
-
A. ①②③⑥
-
B. ①②③⑤⑥
-
C. ②③④⑤
-
D. ③④⑤⑥
答案与解析
平台答案:C。
整理解析
按教材中的标准趟次与实现选 C。冒泡的一趟把一个极值送至端点;简单选择的一趟选出极值并安放;堆排序在建堆后的第一轮取出堆顶极值;基准归位式快速排序的一趟确定基准的位置。直接插入只保证已处理前缀有序,归并首趟只保证局部段有序。这里堆排序的“一趟”包括取出极值,不能把仅完成建堆视为已经安放最终元素;快速排序也指基准归位的常见版本。
题目 059
展开题目 059(先作答,再查看解析)
来源:知识点练习「算法基础」第 59 题(原站入口)。
把数组 A=(2,8,7,1,3,5,6,4) 构造成大顶堆,用数组形式表示,其结果是哪一项( )?
-
A. (1,2,3,4,5,6,7,8)
-
B. (1,2,5,4,3,7,6,8)
-
C. (8,4,7,2,3,5,6,1)
-
D. (8,7,6,5,4,3,2,1)
答案与解析
平台答案:C。
整理解析
平台选 C,符合从最后一个非叶结点开始向下调整的常规建堆过程。先交换下标 4、8 的 1 和 4,得到 (2,8,7,4,3,5,6,1);再调整根,让 2 依次与 8、4 交换,得到 (8,4,7,2,3,5,6,1)。纠错与歧义:D=(8,7,6,5,4,3,2,1) 也满足每个父结点不小于孩子的大顶堆定义。题干没有指定建堆算法,故不能将 D 说成“不是大顶堆”;C 是平台采用的标准调整过程的结果,题面条件本身不足以唯一排除 D。
题目 063
展开题目 063(先作答,再查看解析)
来源:知识点练习「算法基础」第 63 题(原站入口)。
序列 {k1,k2,…,kₙ} 由 n 个关键码组成。满足图中两组关系之一时,称为堆。以下哪个序列不是堆( )?
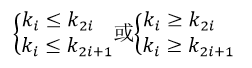
-
A. 15,25,21,53,73,65,33
-
B. 15,25,21,33,73,65,53
-
C. 73,65,25,21,15,53,33
-
D. 73,65,25,33,53,15,21
答案与解析
平台答案:C。
整理解析
选 C。按从 1 开始的数组下标检查父子关系,A、B 都是小顶堆,D 是大顶堆。C 的根 73 大于孩子,已不可能是小顶堆;而下标 3 的 25 小于孩子 53、33,又违反大顶堆条件。图中的两类不等式必须对所有存在的父子边一致成立,不能让不同结点各自选择大顶堆或小顶堆方向;允许父子键值相等。
题目 064
展开题目 064(先作答,再查看解析)
来源:知识点练习「算法基础」第 64 题(原站入口)。
归并排序先把待排数组分为两个大小相同的子数组,分别递归排序,再用 O(n) 时间把两个有序子数组合并。该过程采用的设计策略填入(64),最好与最坏情况下的时间复杂度依次填入(65)。
请作答:第 64 题。
-
A. 分治
-
B. 动态规划
-
C. 贪心
-
D. 回溯
答案与解析
平台答案:A。
整理解析
选 A。它把原数组拆成两个同类的小问题,分别递归解决,再合并两侧结果,这是分治法的“拆分—求解—合并”过程。奇数长度时两侧只需相差 1,不影响设计策略。
题目 065
展开题目 065(先作答,再查看解析)
来源:知识点练习「算法基础」第 65 题(原站入口)。
归并排序先把待排数组分为两个大小相同的子数组,分别递归排序,再用 O(n) 时间把两个有序子数组合并。该过程采用的设计策略填入(64),最好与最坏情况下的时间复杂度依次填入(65)。
请作答:第 65 题。
-
A. Θ(n)和Θ(n lg n)
-
B. Θ(n)和Θ(n2)
-
C. Θ(n lg n)和Θ(n lg n)
-
D. Θ(n lg n)和Θ(n2)
答案与解析
平台答案:C。
整理解析
选 C。对于每层都执行常规合并的归并排序,共有 Θ(lg n) 层,每层处理的元素总数为 Θ(n),无论原序列次序如何,最好和最坏情况都为 Θ(n lg n)。纠错:并非“没有最好和最坏情况”,而是它们具有相同的渐进时间阶;平台把复杂度解释为“外层 n、内层归并 lg n”也不准确,正确依据是递归层数及每层合并代价。
题目 068
展开题目 068(先作答,再查看解析)
来源:知识点练习「算法基础」第 68 题(原站入口)。
原题用“排序后能确保排序码中的相对位置保持不变”描述排序稳定性。以下哪一种排序算法是稳定的( )?
-
A. 冒泡排序
-
B. 快速排序
-
C. 堆排序
-
D. 简单选择排序
答案与解析
平台答案:A。
整理解析
选 A,采用只在前项严格大于后项时交换的标准冒泡实现。纠错:稳定性保留的是“关键字相同的记录”之间的原相对次序,原题和平台解释都遗漏了这一限定;并非所有记录的位置都不能变化。常规快速排序、堆排序及交换式简单选择排序会跨越移动元素,可能颠倒相等键记录的顺序。
题目 069
展开题目 069(先作答,再查看解析)
来源:知识点练习「算法基础」第 69 题(原站入口)。
在下列排序算法中,哪一种占用的辅助存储空间最多( )?
-
A. 归并排序
-
B. 快速排序
-
C. 堆排序
-
D. 冒泡排序
答案与解析
平台答案:A。
整理解析
按教材常见实现和平均空间比较,选 A:数组归并通常需要 Θ(n) 的合并缓冲区;普通快速排序平均递归栈为 Θ(lg n),迭代堆排序与冒泡只需 O(1) 辅助空间。限定说明:题面没交代实现与统计口径,平台将快速排序空间一概写成 lg n 不严谨,未经优化的递归快排最坏栈深可达 Θ(n),此时与常规归并同阶,因此不能声称归并在所有情况下都严格最多。
四、算法设计策略
分治、贪心、动态规划与回溯
| 策略 | 核心思路 | 典型问题与识别线索 | 需要避免的误解 |
|---|---|---|---|
| 分治 | 分解成同类小问题,求解后合并;有时只保留一个子问题 | 归并、快排、大整数乘法、汉诺塔;“拆分—求解—合并” | 递归是一种实现形式,不等于分治;二分查找也常称减治 |
| 贪心 | 当前按一个标准选择,再继续处理剩余问题 | 最小生成树、分数背包、活动安排;“当前最优选择” | 需要证明贪心选择性质,不能保证任意问题全局最优 |
| 动态规划 | 定义状态,利用重叠子问题和状态转移复用结果 | 矩阵链乘、0-1 背包、LCS;“最优子结构、递推、缓存” | 自顶向下记忆化与自底向上填表都可使用;复杂度由状态数和每状态成本决定 |
| 回溯 | 构造部分解,检查约束,不可行就撤销选择 | N 皇后、迷宫、组合枚举;“尝试、冲突、回退” | 不一定只求最优解,也可以找一个解或枚举所有解 |
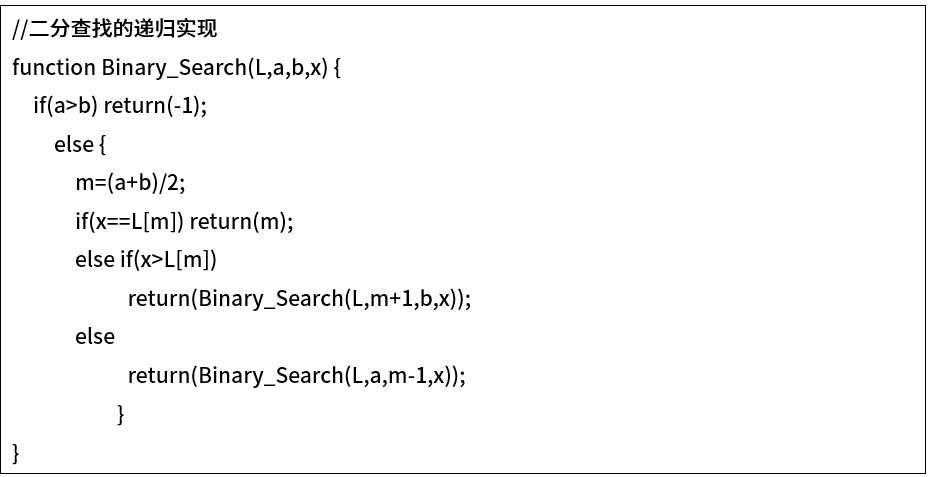
递归二分满足 T(n)=T(n/2)+O(1),因此为 O(log n)。斐波那契朴素双递归会重复计算子问题,不能因为它使用递归就把它当作高效分治的典范;记忆化或迭代才可避免这种重复。
**二维最近点对**也用分治,但合并阶段必须检查跨界点对。先按 x 坐标排序,按下标分成大小接近的两半;分别求最近距离 δ左、δ右,令 δ=min(δ左,δ右)。任何比 δ 更近的跨界点对,其两点都应位于距分割线小于 δ 的条带内。将条带中的点按 y 排序,仅比较纵坐标差小于 δ 的后继点;利用两半内部点距均不小于 δ 的条件,可证明标准平面欧氏距离算法每点只需检查后续至多 7 个候选。
例如 (0,0)、(3,0) 与 (4,1)、(8,1) 分在两侧,子问题最近距离分别为 3、4,而跨界的 (3,0)、(4,1) 距离为 √2,合并时不能漏掉。条带宽度由当前 δ 决定,不是固定的 8 等常数。 预先排序并在递归中线性维护 y 顺序,合并为 O(n),总时间 O(n log n);若每层重新排序,则这一实现可能变为 O(n log²n)。相同 x 坐标的点仍按所属下标分组;若发现重合点,最近距离已为 0,可直接返回。
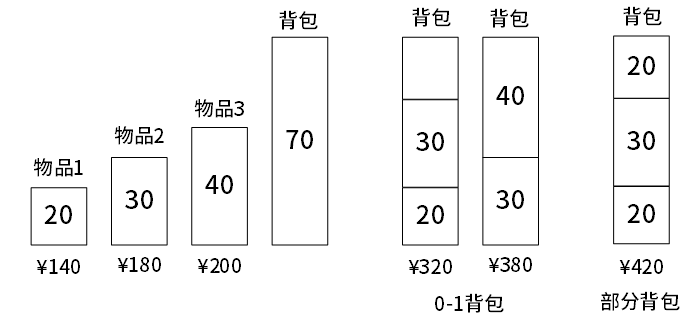
图中容量 70,三个物品重量为 20、30、40,价值为 140、180、200,单位价值分别为 7、6、5。0-1 背包按单位价值贪心会选 20+30,价值 320;但选 30+40 可以得到 380。分数背包允许取一部分,于是选前两个物品并取第三个的 20 单位,价值 140+180+100=420,此时按单位价值贪心能得到最优解。
最小生成树的 Prim、Kruskal 具有相应的正确性依据。找零、多机调度、装箱等要看问题条件,不能把所有贪心策略都当作最优算法。动态规划既能求最优值,也能处理计数与可达性;复杂度不固定是 O(n) 或 O(n²)。
动态规划:先定义状态,再写转移
**最优子结构**指整体最优方案中用到的子方案也必须对相应子问题最优;**重叠子问题**指不同推导路径会反复求同一状态。动态规划把每个状态的结果保存下来,后续复用。解题依次写清:状态含义、初始边界、转移来源、计算次序、答案位置;时间通常是“状态数×每状态候选数”,空间按同时保存的状态计算。求最优数值和恢复实际方案是两件事,后者常需记录前驱或切分点。
0-1 背包与分数背包
0-1 背包每件只能选一次或不选,不能拆分。对正整数重量 wᵢ、非负价值 vᵢ、容量 W,令 dp[i][j] 为前 i 件、总重量**不超过** j 的最大价值:
第一项是不选,第二项是选当前物品后的“剩余容量最优值+本件价值”。按物品数递增、逐行填表,答案为 dp[n][W]。例如容量 6,物品 (重量,价值) 为 (2,3)、(4,7)、(5,8),最优选前两件,价值 10;处理第三件时比较“不选的 10”和“选后剩余容量 1 的价值 0+8”。
二维表时间 Θ(nW)、空间 O(nW)。只求价值可压成 O(W) 的数组,每处理一件,容量须**从 W 向下遍历到 wᵢ**,才能读取上一轮结果;正向更新可能把同一件反复加入,变成可重复取用的语义。Θ(nW) 依赖容量的数值,W 用二进制编码只需 O(log W) 位,所以称为伪多项式时间。若要求恰好装满,不能把所有容量都初始化为 0,应把尚不可达容量标为负无穷。
分数背包允许任意拆分,且价值与取用重量成正比,可按 vᵢ/wᵢ 递减装入,最后一件只取能装下的部分。若仍有高密度物品未取尽,却用了低密度部分,交换等重份额能提高价值,这就是贪心正确性的依据。排序 O(n log n),扫描 O(n);它不适用于不能拆分的 0-1 背包。
LCS:用两个前缀表示状态
最长公共子序列保持两串中的相对顺序,但不要求连续。设 X 长 m、Y 长 n,c[i][j] 为 X 前 i 个字符和 Y 前 j 个字符的 LCS 长度,空前缀对应的行、列均为 0:
- 若
X[i−1]=Y[j−1],则c[i][j]=c[i−1][j−1]+1。 - 否则末字符不能同时采用,取
max(c[i−1][j],c[i][j−1])。
例如 X=ABC、Y=AC,非空行依次为 [1,1]、[1,1]、[1,2],最后得到长度 2,对应 AC。按行或列填表均须保证左、上、左上状态已计算。时间 Θ(mn),完整表空间 O(mn);只求长度可保留两行。恢复序列时从右下角逆推:匹配则记录字符并走左上,否则走向提供较大值的上方或左方,最后反转记录;存在并列最优时可能恢复出不同答案。
蛮力法按位置枚举 X 的子序列,有 2ᵐ 个候选,再对每个候选扫描 Y;m=n 时最坏 O(n·2ⁿ)。有重复字符只会使部分候选内容相同,不会自动减少这个朴素枚举过程的次数。
矩阵链乘:区间状态与切分点
矩阵 (a×b)·(b×c) 的结果为 a×c,普通乘法要做 abc 次标量乘法。矩阵乘法有结合律,能改括号,通常不能任意交换矩阵次序。例如 A 为 5×10、B 为 10×2、C 为 2×8:(AB)C 需 5×10×2+5×2×8=180 次,A(BC) 需 10×2×8+5×10×8=560 次,结果维度均为 5×8。
令第 i 个矩阵维度为 p[i−1]×p[i],状态 m[i][j] 为第 i~j 个矩阵相乘的最少标量乘法次数。单矩阵无需相乘,m[i][i]=0;枚举最后一次乘法的切分点 k:
m[i][j] = min(m[i][k] + m[k+1][j] + p[i−1]·p[k]·p[j]),i≤k<j。
必须按区间长度从短到长填表,最终读 m[1][n];再保存最佳 k 就能递归恢复括号。Θ(n²) 个区间各尝试至多 O(n) 个 k,总时间 Θ(n³)、辅助空间 O(n²)。这里 n 是**矩阵个数**,算法求的是相乘顺序,不是在计算矩阵内的数值。
装配线:累计代价与路线恢复
两条线、每条 n 个工位时,令 fᵢ(j) 为完成第 i 条线第 j 个工位的最短累计时间。入线费用 eᵢ、加工时间 aᵢⱼ 给出边界 fᵢ(1)=eᵢ+aᵢ₁。令 t₁₂(j) 表示从线 1 的 j−1 工位转到线 2 的 j 工位的费用,t₂₁(j) 反之;同线移动费用为 0 时:
例如上一列最优值为 8、6,跨线费用 t₂₁=1、t₁₂=4,本列加工时间为 3、5,则新状态为 min(8,6+1)+3=10、min(6,8+4)+5=11。必须先用两个**旧值**算完两个新值,不能原地覆盖后误用本列结果。每列两个状态、每状态两个来源,时间 Θ(n);只求代价可 O(1) 额外空间,恢复路线需保存最优前驱,常用 O(n) 空间。不能单看当前工位最快而忽略入线、跨线、出线费用。
贪心的应用条件与最优性依据
最小生成树中,Prim 选择跨越已选集合边界的最轻边,Kruskal 按权重挑连接不同分量的边;两者都能由割性质保证最优。邻接矩阵版 Prim 为 O(V²),排序加并查集版 Kruskal 通常为 O(E log E),所以稠密图常考虑前者,稀疏图常考虑后者,具体还取决于实现。边权互异是生成树唯一的充分条件;有并列边权时,两种算法可能得到不同边集,但最小总权相同。
Dijkstra 每轮选**从起点出发暂定距离最小**的未确定顶点,再松弛邻边;标准算法要求非负边权。它既不是每步只找当前顶点的最轻出边,也不因维护距离表就变成动态规划。图上的完整过程见数据结构章的最小生成树与最短路径。
活动题先区分目标:**单场地最多安排多少项**通常按结束时间递增选兼容活动;**安排全部活动需要最少几个场地**则按开始时间递增处理,能复用就复用,否则新增。新增第 r 个场地时,新活动与其他 r−1 个场地的未结束活动同时存在,任何方案都至少需要 r 个场地,因此该数量最优,等于最大同时进行数。对 [开始,结束) 区间,相等时刻先结束再开始;逐场地扫描最坏 O(n²),最小堆维护各场地结束时刻可将分配过程降至 O(n log n)。
另一类是**直线上等半径覆盖**:最左未覆盖点为 x,允许在任意位置设置半径 r 的中心时,选 x+r,可覆盖到 x+2r。任何覆盖 x 的中心都不可能在 x+r 右边;把它移到 x+r 不会漏掉剩余点中的已覆盖点,因此至少有一个最优方案包含这一选择。跳过已覆盖前缀,重复即可。已排序点集只需 O(n) 扫描;无序输入还需排序。若中心只能设在指定地点、半径不同或费用不同,该证明不能直接沿用。
分治求最大子段和与搜索策略
最大**连续**子段和的分治法,把最优段分成三种情况:完全在左边、完全在右边、跨中点。前两种递归处理;第三种取“左半最大后缀和+右半最大前缀和”,线性扫描得到。递推 T(n)=2T(n/2)+Θ(n),时间 Θ(n log n)。若要求非空,单元素基例必须返回该元素本身;全负数组不能返回 0。另可用动态规划 ending[i]=max(a[i],ending[i−1]+a[i]) 在线性时间求解,但不能将它的成本套给题目指定的分治实现。
回溯按深度优先尝试决策,违反约束就撤销,保存的状态也须还原;例如 N 皇后逐行放置,并检查列与两条对角线,可见算法应用的 N 皇后案例。**分支限界**面向优化问题,除扩展候选外,还计算当前分支能达到的乐观界:最小化问题若该分支的下界已不小于当前可行解的成本,就可剪枝。FIFO 型用队列广度优先,优先队列型按最有希望的界扩展;单纯 BFS 没有界与剪枝,还不能称为完整的分支限界。第一个可行解也未必最优。
例题 12:贪心能保证最优的背包问题
采用贪心算法保证能求得最优解的问题是( )。
A、0-1背包
B、矩阵链乘
C、最长公共子序列
D、部分(分数)背包
参考答案与解析
选 D。 分数背包允许拆分物品,按单位重量价值递减选择可以保证最优。0-1 背包不允许拆分;矩阵链乘与最长公共子序列通常使用动态规划。
例题 13:安排活动所需的最少场地
现需要申请一些场地举办一批活动,每个活动有开始时间和结束时间。在同一个场地,如果一个活动结束之前,另一个活动开始,即两个活动冲突。若活动A从1时间开始,5时间结束,活动B从5时间开始,8时间结束,则活动A和B不冲突。现要计算n个活动需要的最少场地数。
求解该问题的基本思路如下(假设需要场地数为m,活动数为n,场地集合为P1,P2,…,Pm),初始条件Pi均无活动安排:
(1)采用快速排序算法对n个活动的开始时间从小到大排序,得到活动a1,a2,…,an。对每个活动ai,i从1到n,重复步骤(2)、(3)和(4);
(2)从P1开始,判断ai与P1的最后一个活动是否冲突,若冲突,考虑下一个场地P2,…;
(3)一旦发现ai与某个Pj的最后一个活动不冲突,则将ai安排到Pj,考虑下一个活动;
(4)若ai与所有已安排活动的Pj的最后一个活动均冲突,则将ai安排到一个新的场地,考虑下一个活动;
(5)将n减去没有安排活动的场地数即可得到所用的最少场地数。
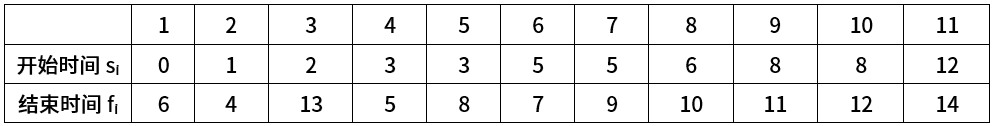
算法首先采用了快速排序算法进行排序,其算法设计策略是( );后面步骤采用的算法设计策略是( )。整个算法的时间复杂度是( )。下表给出了n=11的活动集合,根据上述算法,得到最少的场地数为( )。
A、分治
B、动态规划
C、贪心
D、回溯
A、分治
B、动态规划
C、贪心
D、回溯
A、Θ(lgn)
B、Θ(n)
C、Θ(nlgn)
D、Θ(n 2)
A、4
B、5
C、6
D、7
参考答案与推导
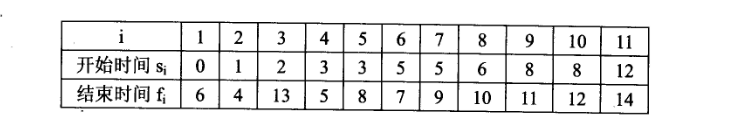
四空依次为 A、C、D、B:分治、贪心、最坏 Θ(n²)、5 个场地。
快排属于分治。活动按开始时间递增处理,选择任一已经空闲的场地;若所有场地都忙,新活动必然需要再增加一个场地,所以这个问题中的贪心选择能达到最少场地数。
原题逐个遍历已有场地,最坏每次扫描 O(n) 个,总计 Θ(n²)。即使排序平均 O(n log n),也会被线性遍历场地的二次成本主导;普通快排本身最坏也可能 O(n²)。原题没有明确“最坏”字样,这里以最坏复杂度解释其二次选项,不能说每种输入都耗时 Θ(n²)。
按原顺序扫描,可得到以下安排:
| 场地 | 活动编号(起止时间) |
|---|---|
| P1 | 1(0,6) → 8(6,10) → 11(12,14) |
| P2 | 2(1,4) → 6(5,7) → 9(8,11) |
| P3 | 3(2,13) |
| P4 | 4(3,5) → 7(5,9) |
| P5 | 5(3,8) → 10(8,12) |
在时间 3,活动 1、2、3、4、5 同时进行,因此至少需要 5 个场地;上表确实只用 5 个,证明最优。活动结束时刻与下一个开始时刻相同不冲突,相当于区间 [开始,结束)。
最小堆优化是另一种实现。 堆保存各场地最后活动的结束时间,只检查最早结束的场地,每次更新 O(log n),结合保证 O(n log n) 的排序可得整体 O(n log n)。不能将优化版成本套到题目给出的逐场地遍历代码上。
专项题库练习(32 题)
本小节对应题库练习共 32 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 004
来源:知识点练习「算法基础」第 4 题(原站入口)。
Prim 与 Kruskal 都用于求无向连通网的最小生成树。Prim 从一个顶点出发,每次通过与当前树相连的最小权重边加入一个剩余顶点,直到成树。原题把 Kruskal 描述为从最小权重边开始,每次从“不在当前的生成树顶点之间的边”中选取最小权重边加入,直到成树。这两种算法都采用(4)设计策略,且(5)。
请作答:第 4 题。
-
A. 分治
-
B. 贪心
-
C. 动态规划
-
D. 回溯
答案与解析
平台答案:B。
整理解析
本问选 B。两者每次都作局部的最小权重选择,并由最小生成树的割性质保证这种选择可以构成全局最优解。需修正原题对 Kruskal 的含混描述:它按边权从小到大考察边,仅当两端属于不同连通分量、不产生环时才加入;中间结果通常是森林,不能简单限定为“尚未进入当前树的顶点之间的边”。
题目 005
来源:知识点练习「算法基础」第 5 题(原站入口)。
Prim 与 Kruskal 都用于求无向连通网的最小生成树。Prim 从一个顶点出发,每次通过与当前树相连的最小权重边加入一个剩余顶点,直到成树。原题把 Kruskal 描述为从最小权重边开始,每次从“不在当前的生成树顶点之间的边”中选取最小权重边加入,直到成树。这两种算法都采用(4)设计策略,且(5)。
请作答:第 5 题。
-
A. 若网较稠密,则Prim算法更好
-
B. 两个算法得到的最小生成树是一样的
-
C. Prim算法比kruskal算法效率更高
-
D. kruskal算法比Prim算法效率更高
答案与解析
平台答案:A。
整理解析
按常见实现比较选 A:邻接矩阵版 Prim 为 O(V2),基于排序和并查集的 Kruskal 通常为 O(E log E),稠密图中前者常更合适。这是实现与输入条件下的比较,堆版 Prim、边是否预排序等会改变性能,不能绝对断言某算法总更快,也不能说 Kruskal 完全与顶点数无关。两者都得到最小总权值;仅当最小生成树唯一时才保证边集相同,例如所有边权互异是一个充分条件。
同材料可参照第 4 题。
题目 019
展开题目 019(先作答,再查看解析)
来源:知识点练习「算法基础」第 19 题(原站入口)。
有 n=5 个物品,背包容量 W=10,重量依次为 w={2,2,6,5,4},价值依次为 v={6,3,5,4,6},求最大装包价值。若按 0-1 背包处理,利用最优子结构,原题给出的递推式如下图;c(i,j) 表示前 i 个物品、容量 j 的 0-1 背包最优值,最终求 c(n,W)。采用自底向上动态规划,最大价值为(19),时间复杂度为(20)。若按部分背包处理,先用归并排序按单位重量价值从大到小排列,再依次装入,直到全部物品装完或容量用尽;最大价值为(21),时间复杂度为(22)。
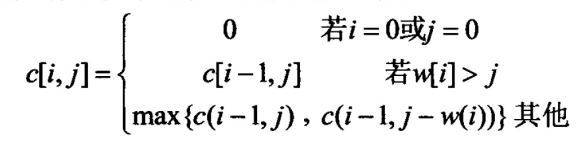
请作答:第 19 题。
-
A. 11
-
B. 14
-
C. 15
-
D. 16.67
答案与解析
平台答案:C。
整理解析
本问选 C。状态:dp[i][j] 是只用前 i 件、总重量不超过 j 的最大价值。边界:dp[0][j]=dp[i][0]=0。转移:装不下第 i 件则继承 dp[i−1][j];否则取 max(dp[i−1][j], dp[i−1][j−w[i]]+v[i])。按 i 递增填表,答案在 dp[5][10]=15,选物品 1、2、5,重量 8、价值 15,不必恰好装满。原图的“选第 i 件”分支漏了 +v[i];照原图从零边界递推会始终为 0,必须指出此误式。
题目 020
展开题目 020(先作答,再查看解析)
来源:知识点练习「算法基础」第 20 题(原站入口)。
有 n=5 个物品,背包容量 W=10,重量依次为 w={2,2,6,5,4},价值依次为 v={6,3,5,4,6},求最大装包价值。若按 0-1 背包处理,利用最优子结构,原题给出的递推式如下图;c(i,j) 表示前 i 个物品、容量 j 的 0-1 背包最优值,最终求 c(n,W)。采用自底向上动态规划,最大价值为(19),时间复杂度为(20)。若按部分背包处理,先用归并排序按单位重量价值从大到小排列,再依次装入,直到全部物品装完或容量用尽;最大价值为(21),时间复杂度为(22)。
请作答:第 20 题。
-
A. Θ(nW)
-
B. Θ(nlgn)
-
C. Θ(n2)
-
D. Θ(nlgnW)
答案与解析
平台答案:A。
整理解析
本问选 A。dp[i][j] 表示前 i 件、容量 j 的最优值,零件数或零容量边界为 0;每个状态只比较“不选”与“选后加 v[i]”,两者都取上一行,单次 O(1)。共约 nW 个状态,故 Θ(nW),结果读 dp[n][W]。用一维 IntArray 保存 dp[j] 时,j 必须从 W 向 w[i] 递减,防止同一件反复使用;最终读 dp[W]。该复杂度依赖整数容量,是伪多项式。原图仍须补上被漏掉的 +v[i]。
同材料可参照第 19 题。
题目 021
展开题目 021(先作答,再查看解析)
来源:知识点练习「算法基础」第 21 题(原站入口)。
有 n=5 个物品,背包容量 W=10,重量依次为 w={2,2,6,5,4},价值依次为 v={6,3,5,4,6},求最大装包价值。若按 0-1 背包处理,利用最优子结构,原题给出的递推式如下图;c(i,j) 表示前 i 个物品、容量 j 的 0-1 背包最优值,最终求 c(n,W)。采用自底向上动态规划,最大价值为(19),时间复杂度为(20)。若按部分背包处理,先用归并排序按单位重量价值从大到小排列,再依次装入,直到全部物品装完或容量用尽;最大价值为(21),时间复杂度为(22)。
请作答:第 21 题。
-
A. 11
-
B. 14
-
C. 15
-
D. 16.67
答案与解析
平台答案:D。
整理解析
本问是允许切分物品的部分背包,按单位价值贪心,选 D。密度依次为 3、1.5、⅚、0.8、1.5;先完整取 1、2、5,重量 8、价值 15,剩余容量 2 取第 3 件的 2/6,增加价值 5/3,总值为 50/3≈16.67。第 2、5 件密度相同,先后不影响结果。此方法依赖物品可任意分割、价值随重量成比例,不能直接用于前两问的0-1背包;共用题图的0-1递推漏项另见第19题。
同材料可参照第 19 题。
题目 022
展开题目 022(先作答,再查看解析)
来源:知识点练习「算法基础」第 22 题(原站入口)。
有 n=5 个物品,背包容量 W=10,重量依次为 w={2,2,6,5,4},价值依次为 v={6,3,5,4,6},求最大装包价值。若按 0-1 背包处理,利用最优子结构,原题给出的递推式如下图;c(i,j) 表示前 i 个物品、容量 j 的 0-1 背包最优值,最终求 c(n,W)。采用自底向上动态规划,最大价值为(19),时间复杂度为(20)。若按部分背包处理,先用归并排序按单位重量价值从大到小排列,再依次装入,直到全部物品装完或容量用尽;最大价值为(21),时间复杂度为(22)。
请作答:第 22 题。
-
A. Θ(nW)
-
B. Θ(nlgn)
-
C. Θ(n2)
-
D. Θ(nlgnW)
答案与解析
平台答案:B。
整理解析
本问选 B。部分背包先按单位价值做归并排序,成本 Θ(n log n),再顺序装入至容量耗尽或物品用完,扫描 O(n),合计 Θ(n log n)。这是题目指定“先归并排序”的实现;若密度顺序已知,后续装包本身仅需 O(n)。本问使用贪心,不需要前两问的 dp[i][j] 表;原图0-1递推的漏项不应被当成部分背包公式。
同材料可参照第 19 题。
题目 023
展开题目 023(先作答,再查看解析)
来源:知识点练习「算法基础」第 23 题(原站入口)。
用基本方法计算矩阵 Am×n 与 Bn×p 的乘积,需要 m×n×p 次数乘。矩阵连乘满足结合律,但不同括号次序的数乘次数可能不同。现用动态规划确定 Mi、Mi+1、…、Mj 的最优相乘次序,以 m[i,j] 表示最少数乘次数,原题递推式如下图。i、j、k 为矩阵下标,Mi 的维度为 pi-1×pi。自底向上求 n 个矩阵的最优次序,时间复杂度为(23);若四个矩阵 M1、M2、M3、M4 的维度序列为 2、6、3、10、3,则最少数乘次数为(24)。
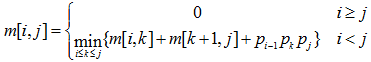
请作答:第 23 题。
-
A. O(n2)
-
B. O(n2lgn)
-
C. O(n3)
-
D. O(n3lgn)
答案与解析
平台答案:C。
整理解析
本问选 C。状态 m[i][j] 表示从第 i 到第 j 个矩阵的最少数乘次数。边界 m[i][i]=0;转移枚举切分点 i≤k<j,取 min(m[i][k]+m[k+1][j]+p[i−1]p[k]p[j])。按区间长度从短到长填表,答案在 m[1][n];O(n2) 个区间各枚举 O(n) 个切分点,共 Θ(n3)。图中上界写成 k≤j,应为 k<j,否则含空右区间并依赖当前状态本身。维度 2、6、3、10、3 的结果为 m[1][4]=144,对应 (M1M2)(M3M4),成本 36+90+18。
题目 024
展开题目 024(先作答,再查看解析)
来源:知识点练习「算法基础」第 24 题(原站入口)。
用基本方法计算矩阵 Am×n 与 Bn×p 的乘积,需要 m×n×p 次数乘。矩阵连乘满足结合律,但不同括号次序的数乘次数可能不同。现用动态规划确定 Mi、Mi+1、…、Mj 的最优相乘次序,以 m[i,j] 表示最少数乘次数,原题递推式如下图。i、j、k 为矩阵下标,Mi 的维度为 pi-1×pi。自底向上求 n 个矩阵的最优次序,时间复杂度为(23);若四个矩阵 M1、M2、M3、M4 的维度序列为 2、6、3、10、3,则最少数乘次数为(24)。
请作答:第 24 题。
-
A. 156
-
B. 144
-
C. 180
-
D. 360
答案与解析
平台答案:B。
整理解析
本问选 B。状态 m[i][j] 是第 i~j 个矩阵的最少数乘次数,单矩阵边界为 0;在 i≤k<j 处切成两段,比较两段最优成本加 p[i−1]p[k]p[j],按区间长度填表。相邻两矩阵的状态为 36、180、90,长度为3的状态 m[1][3]=96、m[2][4]=144。最终 m[1][4]=min(180,144,156)=144,对应 (M1M2)(M3M4)。原图切分上界 k≤j 应改为 k<j,不能把当前区间再次作为自己的子问题。
同材料可参照第 23 题。
题目 027
展开题目 027(先作答,再查看解析)
来源:知识点练习「算法基础」第 27 题(原站入口)。
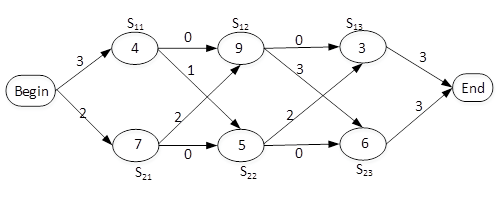
汽车工厂有装配线 L1、L2,每条有 n 个工位 Sij(i=1或2,j=1,2,…,n)。两线的对应工位做同样的工作,但加工时间 aij 可以不同;入线时间为 e1、e2,出线到结束的时间为 X1、X2,相邻工位之间还有迁移时间 tij(i=1或2,j=2,…,n)。目标是求装配一辆车耗时最少的路线。该问题有最优子结构:除首个工位外,到 L1 第 j 个工位的最短时间,可由 L1 或 L2 第 j-1 个工位的最短时间转移,见式(1);最终耗时从两线最后工位的离开时间中取较小值,见式(2)。求两线第 j 个状态都用到上一列的状态,存在重复子问题,采用迭代求解。算法设计策略为(27),时间复杂度为(28)。对于图中的具体实例,最短装配时间为(29),路线为(30)。
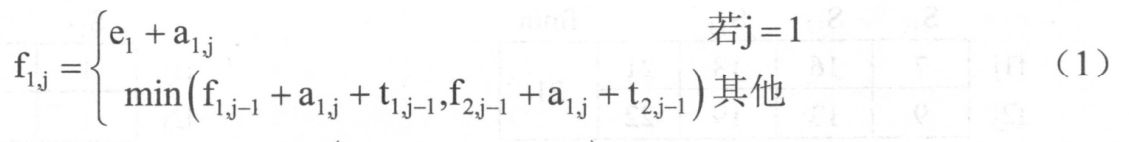

请作答:第 27 题。
-
A. 分治
-
B. 动态规划
-
C. 贪心
-
D. 回溯
答案与解析
平台答案:B。
整理解析
本问选 B。状态 f[i][j] 是完成第 i 条线第 j 个工位的最短累计时间;边界 f[i][1]=e[i]+a[i][1]。转移时比较“从本线上一工位来”与“从另一线上一工位来”,分别加图中对应迁移费用,再加工 a[i][j]。从左到右计算,答案为 min(f[1][n]+X1,f[2][n]+X2)。两个新状态复用上一列的两个状态,体现动态规划;迁移费应按实际有向边取值,不能把跨线费用加在图中标0的同线边上。
题目 028
展开题目 028(先作答,再查看解析)
来源:知识点练习「算法基础」第 28 题(原站入口)。
汽车工厂有装配线 L1、L2,每条有 n 个工位 Sij(i=1或2,j=1,2,…,n)。两线的对应工位做同样的工作,但加工时间 aij 可以不同;入线时间为 e1、e2,出线到结束的时间为 X1、X2,相邻工位之间还有迁移时间 tij(i=1或2,j=2,…,n)。目标是求装配一辆车耗时最少的路线。该问题有最优子结构:除首个工位外,到 L1 第 j 个工位的最短时间,可由 L1 或 L2 第 j-1 个工位的最短时间转移,见式(1);最终耗时从两线最后工位的离开时间中取较小值,见式(2)。求两线第 j 个状态都用到上一列的状态,存在重复子问题,采用迭代求解。算法设计策略为(27),时间复杂度为(28)。对于图中的具体实例,最短装配时间为(29),路线为(30)。
请作答:第 28 题。
-
A. Θ(lgn)
-
B. Θ(n)
-
C. Θ(n2)
-
D. Θ(nlgn)
答案与解析
平台答案:B。
整理解析
本问选 B。每列只有 f[1][j]、f[2][j] 两个状态,各检查上一列的两个来源,转移均为 O(1);从首列边界 e[i]+a[i][1] 迭代 n 列,时间 Θ(n),末列加出线费用后取最小值。只求时间可用两个旧值和两个新值做到 O(1) 额外空间;需要还原路线时保存各状态的前驱,通常用 O(n) 空间。更新时要先算完两个新值,避免第二个状态误用本列刚更新的值。
同材料可参照第 27 题。
题目 029
展开题目 029(先作答,再查看解析)
来源:知识点练习「算法基础」第 29 题(原站入口)。
汽车工厂有装配线 L1、L2,每条有 n 个工位 Sij(i=1或2,j=1,2,…,n)。两线的对应工位做同样的工作,但加工时间 aij 可以不同;入线时间为 e1、e2,出线到结束的时间为 X1、X2,相邻工位之间还有迁移时间 tij(i=1或2,j=2,…,n)。目标是求装配一辆车耗时最少的路线。该问题有最优子结构:除首个工位外,到 L1 第 j 个工位的最短时间,可由 L1 或 L2 第 j-1 个工位的最短时间转移,见式(1);最终耗时从两线最后工位的离开时间中取较小值,见式(2)。求两线第 j 个状态都用到上一列的状态,存在重复子问题,采用迭代求解。算法设计策略为(27),时间复杂度为(28)。对于图中的具体实例,最短装配时间为(29),路线为(30)。
请作答:第 29 题。
-
A. 21
-
B. 23
-
C. 20
-
D. 26
答案与解析
平台答案:A。
整理解析
本问选 A。状态是到各工位加工结束的最短累计时间。图中首列边界为 (3+4,2+7)=(7,9);第二列为 (min(7+0,9+2)+9,min(9+0,7+1)+5)=(16,13);第三列为 (min(16+0,13+2)+3,min(13+0,16+3)+6)=(18,19)。答案在末列加出口费用之后:min(18+3,19+3)=21,不能只取最后工位的18。
同材料可参照第 27 题。
题目 030
展开题目 030(先作答,再查看解析)
来源:知识点练习「算法基础」第 30 题(原站入口)。
汽车工厂有装配线 L1、L2,每条有 n 个工位 Sij(i=1或2,j=1,2,…,n)。两线的对应工位做同样的工作,但加工时间 aij 可以不同;入线时间为 e1、e2,出线到结束的时间为 X1、X2,相邻工位之间还有迁移时间 tij(i=1或2,j=2,…,n)。目标是求装配一辆车耗时最少的路线。该问题有最优子结构:除首个工位外,到 L1 第 j 个工位的最短时间,可由 L1 或 L2 第 j-1 个工位的最短时间转移,见式(1);最终耗时从两线最后工位的离开时间中取较小值,见式(2)。求两线第 j 个状态都用到上一列的状态,存在重复子问题,采用迭代求解。算法设计策略为(27),时间复杂度为(28)。对于图中的具体实例,最短装配时间为(29),路线为(30)。
请作答:第 30 题。
-
A. S11→S12→S13
-
B. S11→S22→S13
-
C. S21→S12→S23
-
D. S21→S22→S23
答案与解析
平台答案:B。
整理解析
本问选 B。先计算最短时间状态并记录每次转移选自哪条线;首列为 (7,9),后两列为 (16,13)、(18,19)。末尾加出线费用后选 L1,从状态 f[1][3] 回溯到 f[2][2],再到 f[1][1],倒序还原得到 S11→S22→S13。路径成本为入口3+加工4+跨线1+加工5+跨线2+加工3+出口3=21。求路线需要回溯最优前驱,不能只挑每列加工最快的工位。
同材料可参照第 27 题。
题目 032
展开题目 032(先作答,再查看解析)
来源:知识点练习「算法基础」第 32 题(原站入口)。
求两个长度均为 n 的序列 X、Y 的一个最长公共子序列。例如 ABCBDAB 与 BDCABA 的一个最长公共子序列是 BCBA。若用蛮力法枚举 X 的每个子序列,逐一判断它是否也是 Y 的子序列,再从中选最长者,时间复杂度为(32)。该问题有最优子结构,以 C[i,j] 表示 X 的前 i 项与 Y 的前 j 项的最长公共子序列长度,递推式如下图。用自底向上的方法求解,时间复杂度为(33)。
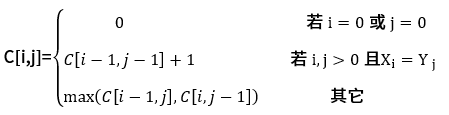
请作答:第 32 题。
-
A. O(n2)
-
B. O(n2lgn)
-
C. O(n3)
-
D. O(n2n)
答案与解析
平台答案:D。
整理解析
本问选 D,即 O(n·2n)。X 的 n 个位置各有取、不取两种选择,按位置枚举共有 2n 个子序列;逐个与 Y 顺序扫描核验,单次最坏 O(n)。公共子序列允许跳过字符,不要求连续。图中的 DP 状态 C[i][j] 是前缀的累计最优长度,不能按平台文字解析把它简化成“当前字符相同为1、否则0”。
题目 033
展开题目 033(先作答,再查看解析)
来源:知识点练习「算法基础」第 33 题(原站入口)。
求两个长度均为 n 的序列 X、Y 的一个最长公共子序列。例如 ABCBDAB 与 BDCABA 的一个最长公共子序列是 BCBA。若用蛮力法枚举 X 的每个子序列,逐一判断它是否也是 Y 的子序列,再从中选最长者,时间复杂度为(32)。该问题有最优子结构,以 C[i,j] 表示 X 的前 i 项与 Y 的前 j 项的最长公共子序列长度,递推式如下图。用自底向上的方法求解,时间复杂度为(33)。
请作答:第 33 题。
-
A. O(n2)
-
B. O(n2lgn)
-
C. O(n3)
-
D. O(n2n)
答案与解析
平台答案:A。
整理解析
本问选 A。状态 dp[i][j] 是 X 前 i 个字符与 Y 前 j 个字符的最长公共子序列长度;边界 dp[0][j]=dp[i][0]=0。若 X[i−1]=Y[j−1],取 dp[i−1][j−1]+1;否则取 max(dp[i−1][j],dp[i][j−1])。按行填表,等长 n 的答案在 dp[n][n],n2 个状态各 O(1),故 Θ(n2)。实际示例长7和6,答案在 dp[7][6]=4,可回溯得到 BCBA;长度状态不是平台所写的单个0/1标记。
同材料可参照第 32 题。
题目 037
展开题目 037(先作答,再查看解析)
来源:知识点练习「算法基础」第 37 题(原站入口)。
为 n 个活动申请尽量少的场地,每个活动有开始、结束时间。同一场地若后一活动在前一活动结束前开始,就发生冲突;活动 A 从 1 到 5、活动 B 从 5 到 8 则不冲突。设所需场地数为 m,场地集合为 P1、P2、…、Pm,初始均未安排活动。算法步骤如下:
(1)按开始时间从小到大,用快速排序得到 a1、a2、…、an,对 i=1 到 n 依次执行步骤(2)、(3)、(4)。
(2)从 P1 开始,检查活动 ai 是否与该场地最后一个活动冲突;若冲突,继续检查 P2 等后续场地。
(3)找到第一个不冲突的场地 Pj 就安排 ai,再处理下一活动。
(4)若所有已用场地都冲突,则为 ai 新增一个场地。
(5)原题写“将 n 减去没有安排活动的场地数”作为使用场地数。
快速排序采用的设计策略为(37),后续安排活动采用的策略为(38),整个算法的时间复杂度为(39)。下表给出 n=11 个活动,按此算法至少需要(40)个场地。
请作答:第 37 题。
-
A. 分治
-
B. 动态规划
-
C. 贪心
-
D. 回溯
答案与解析
平台答案:A。
整理解析
本问选 A。快速排序通过基准划分成较小区间并递归处理,采用分治。其平均或均衡划分时间是 Θ(n log n),普通实现最坏可退化到 Θ(n2),平台不应无条件把时间写成 Θ(n log n)。原题步骤(5)也有计数口径问题:“n减未用场地数”只有预先准备n个候选场地时才成立,直接统计实际启用场地数更明确。
题目 038
展开题目 038(先作答,再查看解析)
来源:知识点练习「算法基础」第 38 题(原站入口)。
为 n 个活动申请尽量少的场地,每个活动有开始、结束时间。同一场地若后一活动在前一活动结束前开始,就发生冲突;活动 A 从 1 到 5、活动 B 从 5 到 8 则不冲突。设所需场地数为 m,场地集合为 P1、P2、…、Pm,初始均未安排活动。算法步骤如下:
(1)按开始时间从小到大,用快速排序得到 a1、a2、…、an,对 i=1 到 n 依次执行步骤(2)、(3)、(4)。
(2)从 P1 开始,检查活动 ai 是否与该场地最后一个活动冲突;若冲突,继续检查 P2 等后续场地。
(3)找到第一个不冲突的场地 Pj 就安排 ai,再处理下一活动。
(4)若所有已用场地都冲突,则为 ai 新增一个场地。
(5)原题写“将 n 减去没有安排活动的场地数”作为使用场地数。
快速排序采用的设计策略为(37),后续安排活动采用的策略为(38),整个算法的时间复杂度为(39)。下表给出 n=11 个活动,按此算法至少需要(40)个场地。
请作答:第 38 题。
-
A. 分治
-
B. 动态规划
-
C. 贪心
-
D. 回溯
答案与解析
平台答案:C。
整理解析
本问选 C。按开始时间处理活动,优先复用已有可用场地,全部冲突时才新增,属于贪心。这里能证明最优:新增第 r 个场地时,之前 r−1 个场地各有一个尚未结束的活动,与新活动同时占用,因此任何方案都至少需要 r 个场地。结束时间等于新活动开始时间可复用,符合题设;不能只靠“局部最优”四个字断言正确。步骤(5)应统计实际已用场地,“n减未用数”依赖预置n个候选场地。
同材料可参照第 37 题。
题目 039
展开题目 039(先作答,再查看解析)
来源:知识点练习「算法基础」第 39 题(原站入口)。
为 n 个活动申请尽量少的场地,每个活动有开始、结束时间。同一场地若后一活动在前一活动结束前开始,就发生冲突;活动 A 从 1 到 5、活动 B 从 5 到 8 则不冲突。设所需场地数为 m,场地集合为 P1、P2、…、Pm,初始均未安排活动。算法步骤如下:
(1)按开始时间从小到大,用快速排序得到 a1、a2、…、an,对 i=1 到 n 依次执行步骤(2)、(3)、(4)。
(2)从 P1 开始,检查活动 ai 是否与该场地最后一个活动冲突;若冲突,继续检查 P2 等后续场地。
(3)找到第一个不冲突的场地 Pj 就安排 ai,再处理下一活动。
(4)若所有已用场地都冲突,则为 ai 新增一个场地。
(5)原题写“将 n 减去没有安排活动的场地数”作为使用场地数。
快速排序采用的设计策略为(37),后续安排活动采用的策略为(38),整个算法的时间复杂度为(39)。下表给出 n=11 个活动,按此算法至少需要(40)个场地。
请作答:第 39 题。
-
A. Θ(lgn)
-
B. Θ(n)
-
C. Θ(nlgn)
-
D. Θ(n2)
答案与解析
平台答案:D。
整理解析
平台选 D,指题设实现的最坏时间。每个活动按编号逐个扫描已用场地,若所有活动重叠,检查数为 0+1+…+(n−1)=Θ(n2);加上前面的快排,最坏仍为 Θ(n2)。它不是所有输入都必然的耗时。若改用按结束时间维护的最小堆,配合 O(n log n) 排序,可将分配降至 O(n log n)。原题的场地数计数需统计已用场地,或明确预置n个候选场地后再减未用数。
同材料可参照第 37 题。
题目 040
展开题目 040(先作答,再查看解析)
来源:知识点练习「算法基础」第 40 题(原站入口)。
为 n 个活动申请尽量少的场地,每个活动有开始、结束时间。同一场地若后一活动在前一活动结束前开始,就发生冲突;活动 A 从 1 到 5、活动 B 从 5 到 8 则不冲突。设所需场地数为 m,场地集合为 P1、P2、…、Pm,初始均未安排活动。算法步骤如下:
(1)按开始时间从小到大,用快速排序得到 a1、a2、…、an,对 i=1 到 n 依次执行步骤(2)、(3)、(4)。
(2)从 P1 开始,检查活动 ai 是否与该场地最后一个活动冲突;若冲突,继续检查 P2 等后续场地。
(3)找到第一个不冲突的场地 Pj 就安排 ai,再处理下一活动。
(4)若所有已用场地都冲突,则为 ai 新增一个场地。
(5)原题写“将 n 减去没有安排活动的场地数”作为使用场地数。
快速排序采用的设计策略为(37),后续安排活动采用的策略为(38),整个算法的时间复杂度为(39)。下表给出 n=11 个活动,按此算法至少需要(40)个场地。
请作答:第 40 题。
-
A. 4
-
B. 5
-
C. 6
-
D. 7
答案与解析
平台答案:B。
整理解析
本问选 B。在时刻3,a1=[0,6)、a2=[1,4)、a3=[2,13)、a4=[3,5)、a5=[3,8) 同时进行,故至少需要5个场地。按题设依次扫描可安排:P1放a1、a8、a11;P2放a2、a6、a9;P3放a3;P4放a4、a7;P5放a5、a10。每组都满足前一活动结束≤后一活动开始,5个场地足够,故最优值为5。直接数已用场地即可;“n减未用数”仅在预置n个候选场地时等价。
同材料可参照第 37 题。
题目 041
展开题目 041(先作答,再查看解析)
来源:知识点练习「算法基础」第 41 题(原站入口)。
一条直公路的一侧分布着房屋。消防栓的覆盖尺度远大于房屋尺寸,计算时将房屋和消防栓都当作直线上的点,要求确定覆盖全部房屋所需的最少消防栓数量及位置。
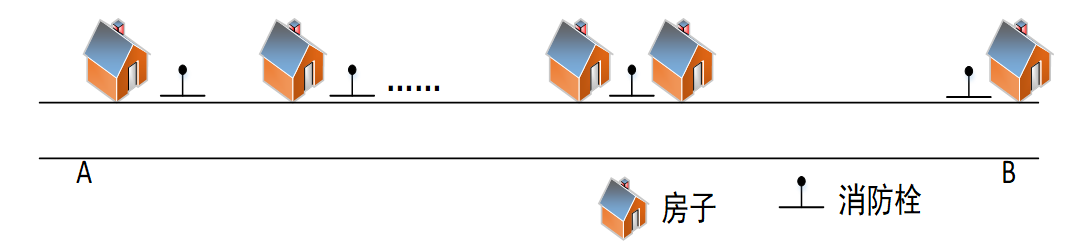
给定的算法反复执行:找到尚未覆盖的最左侧房屋,在其右方 m 米处设置消防栓,再移除这次已覆盖的房屋,直到没有房屋剩下。所用设计策略填入(41),时间复杂度填入(42)。
实例中,公路起点 A 的坐标为 0,覆盖半径为 20 米;10 栋房屋的坐标依次是(10,20,30,35,60,80,160,210,260,300),单位为米。该算法所需的消防栓数填入(43),关于该算法求解效果的正确表述填入(44)。
请作答:第 41 题。
-
A. 分治
-
B. 动态规划
-
C. 贪心
-
D. 回溯
答案与解析
平台答案:C。
整理解析
选 C。每一步都把消防栓放在“仍能覆盖最左侧未覆盖房屋的最右位置”,以尽量多覆盖右边的房屋;作出选择后直接处理剩余部分,属于贪心法。纠错:平台把贪心法概括为“得不到最优解”过于绝对。贪心是否最优取决于问题与选择规则,本题的等半径直线覆盖规则可以证明最优,见第 44 题。
题目 042
展开题目 042(先作答,再查看解析)
来源:知识点练习「算法基础」第 42 题(原站入口)。
一条直公路的一侧分布着房屋。消防栓的覆盖尺度远大于房屋尺寸,计算时将房屋和消防栓都当作直线上的点,要求确定覆盖全部房屋所需的最少消防栓数量及位置。
给定的算法反复执行:找到尚未覆盖的最左侧房屋,在其右方 m 米处设置消防栓,再移除这次已覆盖的房屋,直到没有房屋剩下。所用设计策略填入(41),时间复杂度填入(42)。
实例中,公路起点 A 的坐标为 0,覆盖半径为 20 米;10 栋房屋的坐标依次是(10,20,30,35,60,80,160,210,260,300),单位为米。该算法所需的消防栓数填入(43),关于该算法求解效果的正确表述填入(44)。
请作答:第 42 题。
-
A. Θ(lg n)
-
B. Θ(n)
-
C. Θ(n lg n)
-
D. Θ(n2)
答案与解析
平台答案:B。
整理解析
按房屋已依坐标排序、用下标向右扫描的实现,选 B,即 Θ(n)。每栋房屋只需经过一次,跳过已覆盖的前缀即可,无须真正删除数组元素。条件说明:若输入坐标无序,先作比较排序通常需 O(n lg n),总时间也相应增加;若每次删除都搬移数组,亦不能直接声称线性。平台的 Θ(n) 对应题中按从左到右顺序扫描的阶段。
题目 043
展开题目 043(先作答,再查看解析)
来源:知识点练习「算法基础」第 43 题(原站入口)。
一条直公路的一侧分布着房屋。消防栓的覆盖尺度远大于房屋尺寸,计算时将房屋和消防栓都当作直线上的点,要求确定覆盖全部房屋所需的最少消防栓数量及位置。
给定的算法反复执行:找到尚未覆盖的最左侧房屋,在其右方 m 米处设置消防栓,再移除这次已覆盖的房屋,直到没有房屋剩下。所用设计策略填入(41),时间复杂度填入(42)。
实例中,公路起点 A 的坐标为 0,覆盖半径为 20 米;10 栋房屋的坐标依次是(10,20,30,35,60,80,160,210,260,300),单位为米。该算法所需的消防栓数填入(43),关于该算法求解效果的正确表述填入(44)。
请作答:第 43 题。
-
A. 4
-
B. 5
-
C. 6
-
D. 7
答案与解析
平台答案:B。
整理解析
选 B,共 5 个。依次在坐标 30、80、180、230、280 处设置消防栓,覆盖区间分别为 [10,50]、[60,100]、[160,200]、[210,250]、[260,300]。这五轮分别覆盖 4、2、1、1、2 栋房屋;最后一轮同时覆盖端点 260 和 300,不能漏掉边界上的房屋。
题目 044
展开题目 044(先作答,再查看解析)
来源:知识点练习「算法基础」第 44 题(原站入口)。
一条直公路的一侧分布着房屋。消防栓的覆盖尺度远大于房屋尺寸,计算时将房屋和消防栓都当作直线上的点,要求确定覆盖全部房屋所需的最少消防栓数量及位置。
给定的算法反复执行:找到尚未覆盖的最左侧房屋,在其右方 m 米处设置消防栓,再移除这次已覆盖的房屋,直到没有房屋剩下。所用设计策略填入(41),时间复杂度填入(42)。
实例中,公路起点 A 的坐标为 0,覆盖半径为 20 米;10 栋房屋的坐标依次是(10,20,30,35,60,80,160,210,260,300),单位为米。该算法所需的消防栓数填入(43),关于该算法求解效果的正确表述填入(44)。
请作答:第 44 题。
-
A. 一定能得到问题的一个最优解
-
B. 能够得到问题的全部最优解
-
C. 某些实例可能无法得到最优解
-
D. 只能得到近似最优解
答案与解析
平台答案:C。
整理解析
纠错:平台答案保留为 C,但对题述算法和等半径直线覆盖模型,应选 A。令最左侧尚未覆盖的房屋坐标为 x、半径为 m。任何可行方案都必须有一个中心 c∈[x−m,x+m] 的消防栓覆盖 x;将它右移到 x+m,右端覆盖范围只会扩大,且所有尚未覆盖房屋均不在 x 左侧,因此不会丢失原来已由它覆盖的待覆盖房屋。于是至少一个最优方案包含该贪心选择;对剩余房屋重复论证,所得数量必为最少。算法只输出其中一种方案,不能保证列出全部最优方案。平台把“某些问题上的贪心规则不保证最优”套用到这个具体算法,因而误选 C。
题目 046
展开题目 046(先作答,再查看解析)
来源:知识点练习「算法基础」第 46 题(原站入口)。
用通常的矩阵乘法计算 m×n 矩阵 A 与 n×p 矩阵 B 的乘积,时间复杂度为 O(mnp)。矩阵连乘满足结合律,例如 (A×B)×C 与 A×(B×C) 的结果相同,但标量乘法次数可能相差很大,因此需要寻找 n 个矩阵 A1A2…Aₙ 的最优加括号顺序。
已知本问题具有最优子结构:若整段在 Aₖ 与 Aₖ₊1 之间切分,最优方案中两侧 A1…Aₖ、Aₖ₊1…Aₙ 也分别采用最优方案。原题此处的文字范围写作“1≤k”;递推式如下。
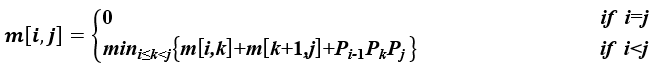
Ai 的维度是 pi₋1×pi,m[i,j] 记录 AiAi₊1…Aj 的最少标量乘法次数。现按自底向上的次序求解:设计策略填入(46),算法时间复杂度填入(47),空间复杂度填入(48)。当(p0,p1,…,p5)=(20,15,4,10,20,25)时,最优计算顺序填入(49)。
请作答:第 46 题。
-
A. 分治法
-
B. 动态规划法
-
C. 贪心法
-
D. 回溯法
答案与解析
平台答案:B。
整理解析
选 B。按区间长度递增计算并保存 m[i,j],枚举切分点 k,把两个已求好的子链代价加上最后一次相乘的 pi₋1pₖpj,再取最小值,这是动态规划。仅有最优子结构并不足以把所有算法都归为动态规划;这里还利用表格复用重叠子问题。边界说明:整条链的切分点须为 1≤k<n,区间递推须为 i≤k<j,且 m[i,i]=0;原题文字只写“1≤k”,其配图给出了完整的区间限制。
题目 047
展开题目 047(先作答,再查看解析)
来源:知识点练习「算法基础」第 47 题(原站入口)。
用通常的矩阵乘法计算 m×n 矩阵 A 与 n×p 矩阵 B 的乘积,时间复杂度为 O(mnp)。矩阵连乘满足结合律,例如 (A×B)×C 与 A×(B×C) 的结果相同,但标量乘法次数可能相差很大,因此需要寻找 n 个矩阵 A1A2…Aₙ 的最优加括号顺序。
已知本问题具有最优子结构:若整段在 Aₖ 与 Aₖ₊1 之间切分,最优方案中两侧 A1…Aₖ、Aₖ₊1…Aₙ 也分别采用最优方案。原题此处的文字范围写作“1≤k”;递推式如下。
Ai 的维度是 pi₋1×pi,m[i,j] 记录 AiAi₊1…Aj 的最少标量乘法次数。现按自底向上的次序求解:设计策略填入(46),算法时间复杂度填入(47),空间复杂度填入(48)。当(p0,p1,…,p5)=(20,15,4,10,20,25)时,最优计算顺序填入(49)。
请作答:第 47 题。
-
A. O(n2)
-
B. O(n2 lg n)
-
C. O(n3)
-
D. O(2n)
答案与解析
平台答案:C。
整理解析
选 C。算法要处理 Θ(n2) 个子链区间,每个区间枚举其内部切分点;总候选切分次数为 ∑(L=2…n)(n−L+1)(L−1)=(n3−n)/6,故时间为 Θ(n3),按选项写作 O(n3)。纠错:这里 n 是矩阵的个数,复杂度来自寻找括号方案,不能由一次矩阵相乘的 O(mnp) 直接推出。平台附的从 0 开始编号代码也有下标错误:若 m[i][j] 表示 Ai₊1…Aj₊1,切分项应为 p[i]×p[k+1]×p[j+1],不是 p[i]×p[k]×p[j];对角项还需先初始化为 0。
题目 048
展开题目 048(先作答,再查看解析)
来源:知识点练习「算法基础」第 48 题(原站入口)。
用通常的矩阵乘法计算 m×n 矩阵 A 与 n×p 矩阵 B 的乘积,时间复杂度为 O(mnp)。矩阵连乘满足结合律,例如 (A×B)×C 与 A×(B×C) 的结果相同,但标量乘法次数可能相差很大,因此需要寻找 n 个矩阵 A1A2…Aₙ 的最优加括号顺序。
已知本问题具有最优子结构:若整段在 Aₖ 与 Aₖ₊1 之间切分,最优方案中两侧 A1…Aₖ、Aₖ₊1…Aₙ 也分别采用最优方案。原题此处的文字范围写作“1≤k”;递推式如下。
Ai 的维度是 pi₋1×pi,m[i,j] 记录 AiAi₊1…Aj 的最少标量乘法次数。现按自底向上的次序求解:设计策略填入(46),算法时间复杂度填入(47),空间复杂度填入(48)。当(p0,p1,…,p5)=(20,15,4,10,20,25)时,最优计算顺序填入(49)。
请作答:第 48 题。
-
A. O(n2)
-
B. O(n2 lg n)
-
C. O(n3)
-
D. O(2n)
答案与解析
平台答案:A。
整理解析
选 A。m 表为每对区间端点保存一个最优代价,共 Θ(n2) 个状态;若另外保存最优切分点以恢复括号方案,也只增加一张同阶表。因此求连乘顺序的辅助空间为 O(n2)。这是优化顺序算法的空间,不是实际保存各矩阵数值的总空间。
题目 049
展开题目 049(先作答,再查看解析)
来源:知识点练习「算法基础」第 49 题(原站入口)。
用通常的矩阵乘法计算 m×n 矩阵 A 与 n×p 矩阵 B 的乘积,时间复杂度为 O(mnp)。矩阵连乘满足结合律,例如 (A×B)×C 与 A×(B×C) 的结果相同,但标量乘法次数可能相差很大,因此需要寻找 n 个矩阵 A1A2…Aₙ 的最优加括号顺序。
已知本问题具有最优子结构:若整段在 Aₖ 与 Aₖ₊1 之间切分,最优方案中两侧 A1…Aₖ、Aₖ₊1…Aₙ 也分别采用最优方案。原题此处的文字范围写作“1≤k”;递推式如下。
Ai 的维度是 pi₋1×pi,m[i,j] 记录 AiAi₊1…Aj 的最少标量乘法次数。现按自底向上的次序求解:设计策略填入(46),算法时间复杂度填入(47),空间复杂度填入(48)。当(p0,p1,…,p5)=(20,15,4,10,20,25)时,最优计算顺序填入(49)。
请作答:第 49 题。
-
A. (((A1×A2)×A3)×A4)×A5
-
B. A1×(A2×(A3×(A4×A5)))
-
C. ((A1×A2)×A3)×(A4×A5)
-
D. (A1×A2)×((A3×A4)×A5)
答案与解析
平台答案:D。
整理解析
选 D。五个矩阵的维度依次为 20×15、15×4、4×10、10×20、20×25。D 中先算 A1A2,需 1200 次;再算 A3A4,需 800 次,将所得 4×20 矩阵乘 A5 需 2000 次;最后把 20×4 与 4×25 两个结果相乘需 2000 次,总计 6000 次。A、B、C 的代价分别为 16000、15000、12000 次。进一步枚举五矩阵的全部 14 种括号结构,最小值仍为 6000,故 D 也是全局最优,而不只是四个选项中最小。
题目 052
展开题目 052(先作答,再查看解析)
来源:知识点练习「算法基础」第 52 题(原站入口)。
对于以下哪类问题,可以通过相应的贪心策略保证得到最优解( )?
-
A. 0-1背包
-
B. 矩阵链乘
-
C. 最长公共子序列
-
D. 部分(分数)背包
答案与解析
平台答案:D。
整理解析
选 D。分数背包允许按比例取用物品;按单位重量价值从高到低装入,若方案中存在低密度部分而高密度物品尚未取尽,就可以用等重的高密度部分替换,使价值不减,因此该规则保证最优。0-1 背包不能任意拆分,矩阵链乘和最长公共子序列也不能靠这种局部选择保证一般实例的最优解。
题目 060
展开题目 060(先作答,再查看解析)
来源:知识点练习「算法基础」第 60 题(原站入口)。
在含负数的 n 个整数构成的数组 A 中,寻找元素和最大的非空连续子数组。例如 A=(-2,11,-4,13,-5,-2) 时,子数组 B=(11,-4,13) 的和最大,等于 20(11−4+13=20)。
一种算法把数组分成两个各含 n/2 个整数的子数组,分别考虑最优子段完全位于左半部、完全位于右半部或跨过中点的三种情况,并继续递归划分直到求得结果。该算法的时间复杂度为( )。
-
A. O(n lg n)
-
B. O(n2)
-
C. O(n2 lg n)
-
D. O(n3)
答案与解析
平台答案:A。
整理解析
按左右递归并在线性时间求跨中点最优段的常规分治实现,选 A:T(n)=2T(n/2)+Θ(n),得到 Θ(n lg n)。纠错:平台代码把全负单元素的结果置 0,实际允许空子段,违反题目“非空”条件;基例应返回该元素本身,跨中点的左右最优和也不能统一初始化为 0。另外,左侧扫描写成 lefts
题目 061
展开题目 061(先作答,再查看解析)
来源:知识点练习「算法基础」第 61 题(原站入口)。
某问题具有最优子结构,且不同求解分支会遇到重叠的子问题。适合用来求最优解的设计策略填入(61);若建立解空间并按广度优先方式搜索,所对应的设计策略填入(62)。
请作答:第 61 题。
-
A. 分治
-
B. 贪心
-
C. 动态规划
-
D. 回溯
答案与解析
平台答案:C。
整理解析
选 C。最优子结构让整体最优解可以由适当的子问题最优解组合;重叠子问题意味着直接递归会重复求同一状态。动态规划用状态表或记忆化保存结果,再按转移关系求解,可避免这些重复计算。
题目 062
展开题目 062(先作答,再查看解析)
来源:知识点练习「算法基础」第 62 题(原站入口)。
某问题具有最优子结构,且不同求解分支会遇到重叠的子问题。适合用来求最优解的设计策略填入(61);若建立解空间并按广度优先方式搜索,所对应的设计策略填入(62)。
请作答:第 62 题。
-
A. 动态规划
-
B. 贪心
-
C. 回溯
-
D. 分支限界
答案与解析
平台答案:D。
整理解析
按教材常见分类选 D:FIFO 型分支限界法以队列按广度优先展开候选。限定说明:广度优先本身只是一种遍历顺序,完整的分支限界还要对候选分支计算界,并剪掉不可能改善当前最优解的分支;题干描述并不充分。分支限界也可按最有希望的界优先展开。平台把它概括为“找到一个满足约束的解即可”不适用于一般最优化任务,首个可行解未必最优。
题目 070
展开题目 070(先作答,再查看解析)
来源:知识点练习「算法基础」第 70 题(原站入口)。
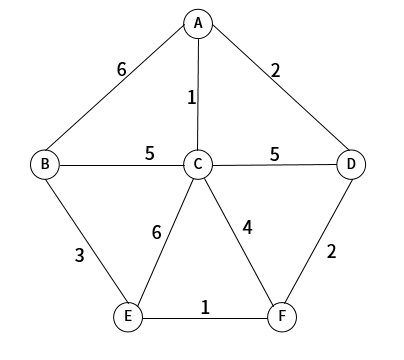
用 Dijkstra 算法在下图中求从 A 到 E 的最短路径。其设计策略填入(70),该最短路径的长度填入(71)。
请作答:第 70 题。
-
A. 分治法
-
B. 动态规划
-
C. 贪心算法
-
D. 回溯法
答案与解析
平台答案:C。
整理解析
选 C。Dijkstra 每轮从尚未确定最短距离的顶点中,选择当前暂定距离最小者,将其距离确定后再松弛相邻边,是贪心选择。本题图中边权均非负,满足该算法的适用条件。算法维护距离表并不使其设计策略自动归为动态规划。
题目 071
展开题目 071(先作答,再查看解析)
来源:知识点练习「算法基础」第 71 题(原站入口)。
用 Dijkstra 算法在下图中求从 A 到 E 的最短路径。其设计策略填入(70),该最短路径的长度填入(71)。
请作答:第 71 题。
-
A. 5
-
B. 6
-
C. 7
-
D. 9
答案与解析
平台答案:A。
整理解析
选 A,最短路为 A→D→F→E,长度为 2+2+1=5。按 Dijkstra 的松弛过程,从 A 出发有 d(C)=1、d(D)=2、d(B)=6;确定 C 后暂得 d(F)=5、d(E)=7,确定 D 后将 d(F) 更新为 4,再经 F 将 d(E) 更新为 5。此时 E 的暂定距离最小,且边权非负,可以确定它就是最短距离。仅找出长度为 5 的路径或只看最小选项,不能单独证明不存在更短路径。
五、复习时怎样抓关键词
关键词用来定位候选,最后必须核对条件与算法过程。
| 题干线索 | 优先想到 | 最后核对 |
|---|---|---|
| 基本有序、少量元素移动 | 直接插入 | 逆序对数量、是否要求稳定 |
| 有序表、每次排除一半 | 二分查找 | 随机访问、中点取整、边界更新 |
| 相同地址、不同关键字 | 哈希冲突 | 冲突处理方式、表长与模数 |
| 第一趟确定最终位置 | 极值归位、基准归位 | “一趟”的定义与具体划分实现 |
| 最坏复杂度低、必须稳定 | 归并 | 是否允许 O(n) 辅助数组 |
| 当前最优、每步固定标准 | 贪心 | 有没有全局最优证明或反例 |
| 最优子结构、重叠子问题 | 动态规划 | 状态、转移、边界、遍历顺序 |
| 冲突、撤销选择、退回上一层 | 回溯 | 回退前后的状态是否还原 |
章节回顾可以落实为四项自测:能从代码数出复杂度;能手算二分与哈希冲突;能逐趟模拟排序并解释稳定性、时间和空间;能区分四种设计策略并说出适用条件。代码填空则进一步检查初始化、循环边界、状态更新和返回值。
来源
教学图片已保存到本地;来源 URL、尺寸和 SHA256 见图片来源清单。