数据结构:课件整理与例题解析
本篇合并本章的课程提要、线性结构、数组与矩阵、树、图和章节回顾,共 6 篇课件。保留教学图片、原题和选项,例题统一编号;折叠区域中的**参考答案、推导与辨析由本笔记补充,并非官方答案**。图片中的简化表述或笔误在相邻正文中说明。
学习时先区分**逻辑关系**与**存储方式**:线性表、树和图描述元素之间的关系;顺序存储、链式存储等描述这些关系如何在内存中实现。同一种逻辑结构可以有多种实现。
常见存储方式还包括**索引存储**和**散列存储**。索引存储额外建立“关键字→记录位置”的索引,先查索引再定位记录;散列存储通过哈希函数计算桶或地址,再处理冲突。区分时看定位依据:顺序存储靠位置计算,链式存储靠链接,索引存储靠索引项,散列存储靠关键字映射。
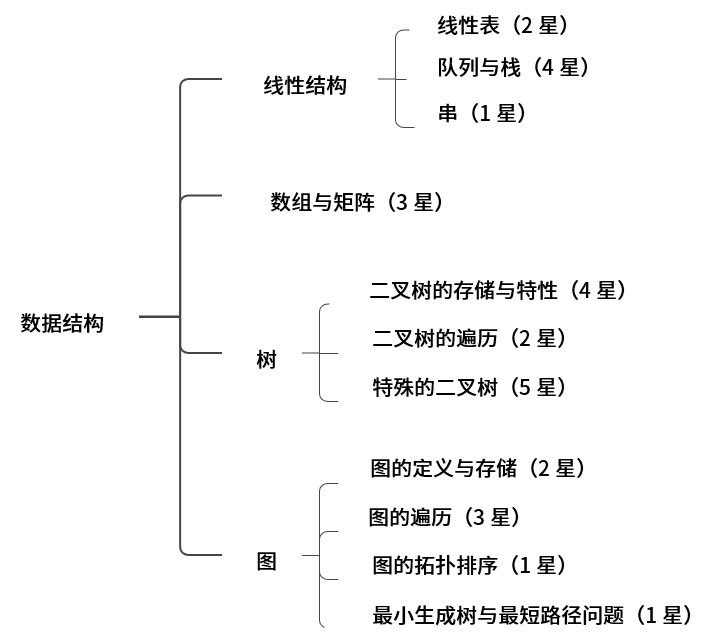
一、线性表:顺序表与链表
线性表是具有相同数据类型的 n 个数据元素构成的有限序列。非空线性表的第一个元素没有直接前驱,最后一个元素没有直接后继,其他元素各有一个直接前驱和直接后继。这里说的是**逻辑关系**。
顺序表:连续存储,按下标定位
顺序表把元素放在连续的存储单元中。若元素大小固定,知道首地址和下标,就能直接计算地址,因此随机访问为 O(1)。
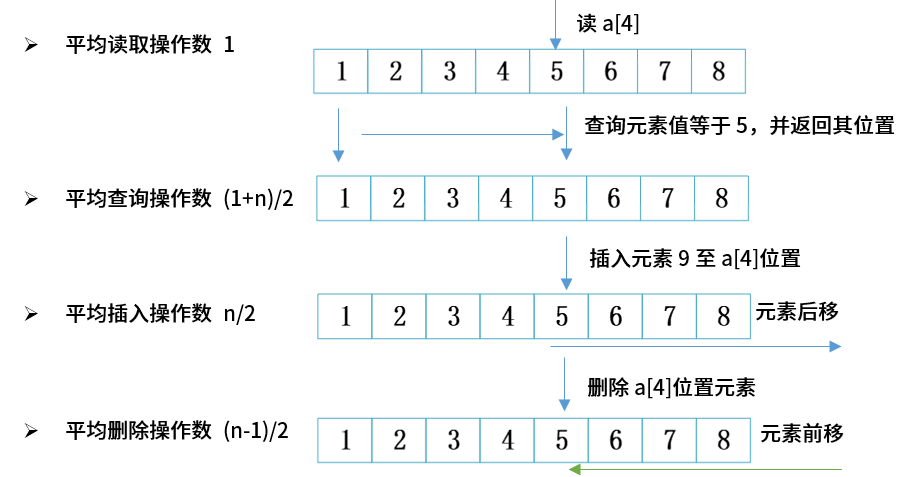

图中“平均查询操作数 (n+1)/2”指**等概率成功的顺序查找**,不代表一切查询方式。已排序的数组还可以二分查找,时间为 O(log n)。
- 在 n+1 个位置等概率插入,平均移动
n/2个元素。 - 在 n 个位置等概率删除,平均移动
(n−1)/2个元素。 - 末尾插入且容量足够、末尾删除,均不必移动其他元素。
连续分配不等于静态分配。 数组空间可以静态分配,也可以动态申请;动态数组还可以在容量不足时申请更大空间并搬移元素。连续性、容量是否可变、空间何时分配,是不同维度。动态数组按下标访问仍为 O(1),按倍数扩容时尾部追加的均摊时间可以是 O(1),一次扩容则可能需要 O(n)。
链表:指针连接,头结点可选
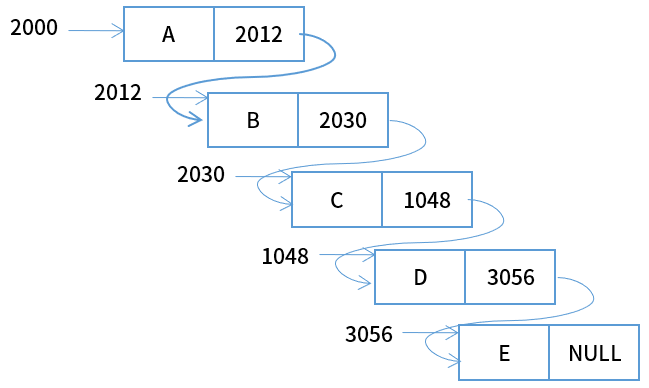
链表通过结点中的指针连接元素。相邻逻辑元素**不要求**在物理内存中相邻,并不意味着它们一定不相邻。链表无须为全部元素一次申请连续空间,但需要额外的指针存储。
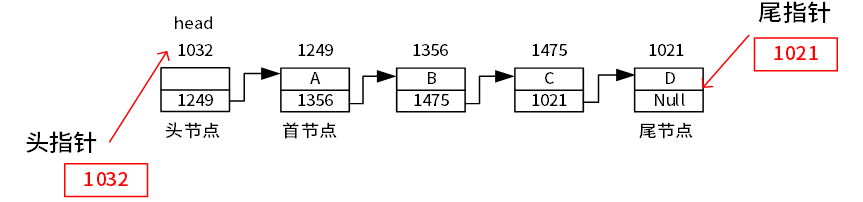
| 名称 | 含义 |
|---|---|
| 头指针 | 标识链表入口;有头结点时指向头结点,否则通常指向首元结点 |
| 头结点/哨兵结点 | 可选的辅助结点,位于首元结点之前,简化首部插入、删除和空表处理 |
| 首元结点 | 第一个存放有效元素的结点 |
| 尾结点 | 最后一个存放有效元素的结点 |
| 尾指针 | 指向尾结点的辅助指针;是否维护取决于实现 |
头结点通常不存放业务元素,数据域可以不用,也可以保存长度等辅助信息;并非“只能存链表首地址”。图中头结点的 next 指向首元结点。对非循环单链表,最后一个结点的 next 为 NULL。
next 是指向 struct student 的指针,自身并不内嵌另一个完整结点。
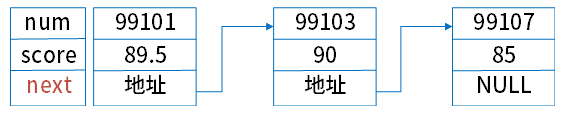
单链表、循环链表和双向链表
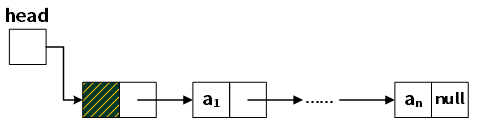
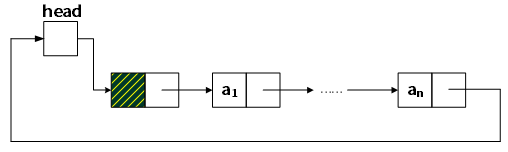
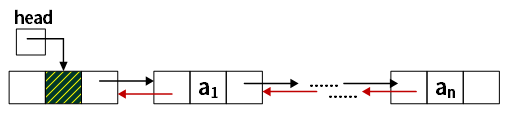
单链表沿 next 前进;循环链表的末尾指回入口;双向链表还保存 prior/prev,可沿前驱方向移动。是否带头结点、是否循环、是否双向是可以组合的设计选择。循环链表遍历的结束条件通常是“回到入口”,不能一律等待 NULL。
插入与删除:先保住原来的连接
以下代码片段说明指针关系;假设相关结点有效,内存已分配,边界情况按注释处理。
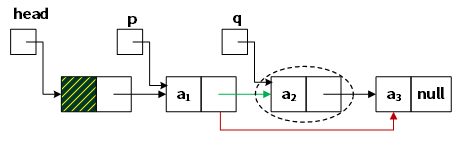
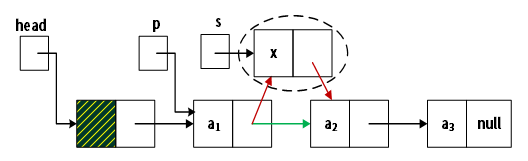
两行不能直接调换:若先执行 p->next = s,再执行 s->next = p->next,就会得到 s->next == s,并丢失原后继的连接。
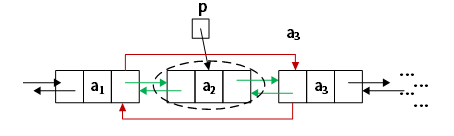
双向链表删除图中的 p,可令 p->prior->next = p->next、p->next->prior = p->prior,再释放 p。图中 p 两侧均有结点;若没有哨兵,删除首尾结点时须判断空指针并更新头尾指针。
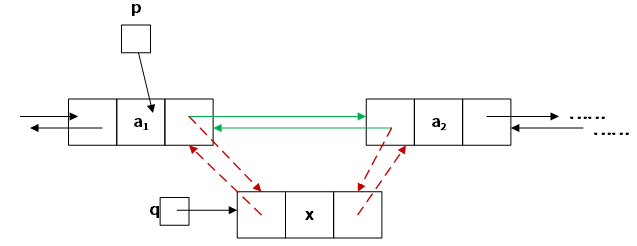
双向链表插入新结点 q 的一种安全顺序为:
q 指向原后继的关系必须在覆盖 p.next 前保存;没有尾哨兵时,还需在尾部插入后更新尾指针。
复杂度比较要说明“是否已定位”
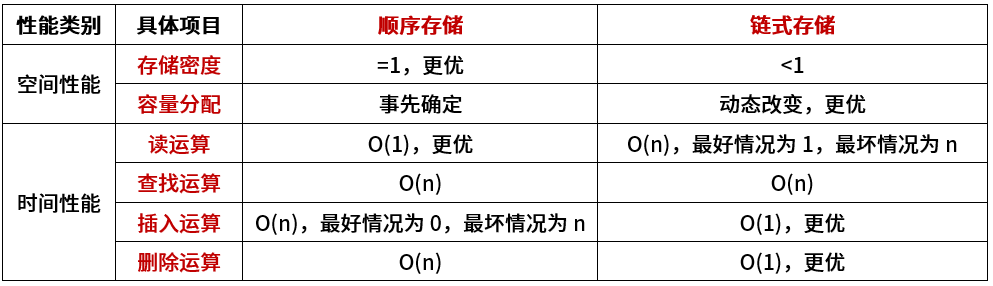
| 操作 | 顺序表 | 单链表 |
|---|---|---|
| 按下标访问 | O(1) | O(n) |
| 按值顺序查找 | O(n) | O(n) |
| 一般位置插入/删除 | 通常需移动后续元素,O(n) | **已定位前驱后**修改连接为 O(1);查找前驱可能为 O(n) |
| 额外空间 | 可预留尚未使用的容量 | 每个结点含指针,分配器也可能有额外开销 |
图中“链表插入、删除 O(1)”省略了定位条件;“顺序表存储密度=1”也是仅比较元素与指针开销的简化模型,不包含预留容量和管理信息。
例题 1:删除时移动多少元素
设有一个包含n个元素的有序线性表。在等概率情况下删除其中的一个元素,若采用顺序存储结构,则平均需要移动( )个元素;若采用单链表存储,则平均需要移动( )个元素。
第一空:A、1 B、(n-1)/2 C、logn D、n
第二空:A、0 B、1 C、(n-1)/2 D、n/2
参考答案与解析
答案:B、A。
顺序表删除第 i 个元素,需要移动后面的 n−i 个元素。平均移动数为 (0+1+…+n−1)/n=(n−1)/2。
链表只修改链接,不搬移其他数据元素,因此移动数为 0。题目问“移动元素数”,不是“寻找待删结点所需的总时间”;有序这一条件也不会让链表自动获得随机访问能力。
专项题库练习(5 题)
本小节对应题库练习共 5 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 001
来源:知识点练习「数据结构」第 1 题(原站入口)。
某线性表主要用于按任意给定序号访问元素,并在表尾插入、删除元素。适合采用哪一种存储方式( )?
-
A. 顺序表
-
B. 单链表
-
C. 双向链表
-
D. 哈希表
答案与解析
平台答案:A。
整理解析
选 A。顺序表可按下标 O(1) 访问任意元素,尾部删除也无需搬移其他元素。容量足够时尾部插入为 O(1);动态数组扩容时单次插入可能为 O(n),通常讨论摊还 O(1)。链表按序号定位通常需要遍历。
题目 005
来源:知识点练习「数据结构」第 5 题(原站入口)。
与顺序存储相比,使用链表存储线性表的缺点是( )。
-
A. 数据元素之间的关系需要占用存储空间,导致存储密度不高
-
B. 表中结点必须占用地址连续的存储单元,存储密度不高
-
C. 插入新元素时需要遍历整个链表,运算的时间效率不高
-
D. 删除元素时需要遍历整个链表,运算的时间效率不高
答案与解析
平台答案:A。
整理解析
选 A。链表除数据外还要存储链接指针,因此存储密度通常低于顺序表。链表结点无需地址连续;已知所需结点及其前驱时,插入、删除只需修改局部链接,不能说每次都必须遍历整个链表。链表仍受可用内存限制。
题目 026
来源:知识点练习「数据结构」第 26 题(原站入口)。
一个有序线性表含 n 个元素,等概率删除其中任意一个。若以顺序结构存储,平均要移动(26)个元素;若以单链表存储,平均要移动(27)个元素。
请作答:第 26 题。
-
A. 1
-
B. (n-1)/2
-
C. logn
-
D. n
答案与解析
平台答案:B。
整理解析
本问选 B。顺序表删除第 i 个元素需将后面的 n−i 个元素前移。各位置等概率,平均移动数为 [(n−1)+(n−2)+…+0]/n=(n−1)/2。这里只统计元素搬移,不含定位被删元素的比较次数。
题目 027
来源:知识点练习「数据结构」第 27 题(原站入口)。
一个有序线性表含 n 个元素,等概率删除其中任意一个。若以顺序结构存储,平均要移动(26)个元素;若以单链表存储,平均要移动(27)个元素。
请作答:第 27 题。
-
A. 0
-
B. 1
-
C. (n-1)/2
-
D. n/2
答案与解析
平台答案:A。
整理解析
本问选 A。单链表删除结点时调整其前驱的 next 链接并释放被删结点,其余元素无需搬移,所以移动数为 0。寻找目标及其前驱可能需要遍历,不能将“移动数为 0”等同于任意删除操作整体为 O(1)。
同材料可参照第 26 题。
题目 059
来源:知识点练习「数据结构」第 59 题(原站入口)。
用数据元素在存储空间中的相对位置表示它们之间的逻辑关系,是哪种存储方式的特征?
- A. 顺序存储
- B. 链表存储
- C. 索引存储
- D. 哈希存储
答案与解析
平台答案:A。
整理解析
顺序存储让逻辑上相邻的元素对应连续的存储位置,借位置关系确定前后次序,选 A。链式结构依靠链接,哈希依靠关键字到地址的映射,均不是这里的位置表达方式。
二、栈、队列与串
栈与队列的顺序约束
- 栈:后进先出(LIFO),在栈顶插入、删除。
- 队列:先进先出(FIFO),从队尾入队、队头出队。
- 栈和队列都是操作受限的线性表,可以使用数组或链表实现。
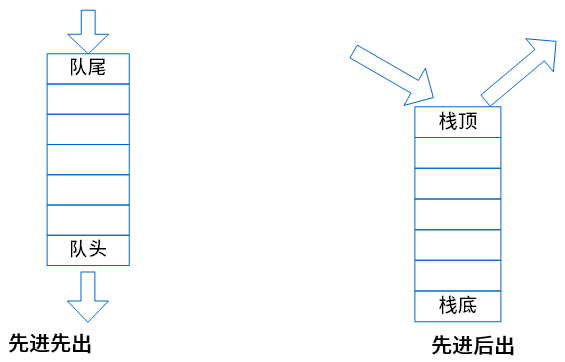
原习题:元素按照 a、b、c 的次序进入栈,请尝试写出其所有可能的出栈序列。
参考答案与推导:枚举出栈序列
在允许入栈、出栈交替进行的条件下,共 5 种:abc、acb、bac、bca、cba。
cab 不可能:c 最先出栈说明 a、b 都压在 c 下面,c 出栈后 b 位于 a 上面,因此必须先 b 后 a。如果题目额外规定“全部入栈后才出栈”,则只有 cba。
如何判断栈序列和最小容量
入栈顺序固定、允许入栈与出栈交替时,对期望输出逐个模拟:若目标已在栈顶,就弹出;若尚未入栈,就按输入次序一直压到它再弹出;若它已经入栈却被别的元素压住,且下一次必须输出它,则该序列不合法。记录模拟过程中的最大栈深,即可得到实现该序列所需的最小容量。
例如输入 1,2,3,4、输出要求 2,4,3,1:压入 1、2,弹出 2;压入 3、4,弹出 4,再弹出 3、1,最大深度为 3。判断 I/O 操作串还要检查:任意前缀的出栈数不得大于入栈数;全部元素进出完成后,两者总数相等。**全部入栈后再出栈**才必定是输入的逆序;栈后再接普通队列,队列会保持已有的出栈顺序。
表达式题还会分别考“中缀转后缀的运算符栈”和“后缀求值的操作数栈”,两者内容与峰值不一定相同。逐记号过程见程序设计语言讲义的“从表达式树到后缀式,再用栈求值”,按题目指定的栈模拟即可。
双端队列 deque 允许两端插入和删除,一般既不是纯 FIFO,也不是纯 LIFO。若另加“哪端进入就从哪端离开,且先全部入队”的限制,每端那一批元素内部必须逆序出队,两批之间可以交错;若允许提前出队,就要重新模拟,不能沿用这个局部逆序结论。
计数题可从已确定的出栈前缀看剩余约束:已在栈中的元素只能按从顶到底的相对顺序输出,尚未入栈的元素再按合法入栈时机穿插。例如依次输入 1~4 且第一个弹出 3 后,栈内剩 1、2,必须先 2 后 1;尚未入栈的 4 可在它们之前、之间或之后弹出,共三种。更一般的情况要分支模拟并检查栈顶,不能把剩余元素当作任意排列。
链栈、链队列与共享栈
单链表实现栈时,把表头作为栈顶:入栈在头部接入新结点,出栈删除头部,两者均为 O(1)。普通链队列同时维护头、尾指针,可在尾部入队、头部出队;不带头结点的循环单链表只维护尾指针 rear 时,rear.next 就是队头,两种操作也均为 O(1)。空队列和只有一个结点时需单独更新指针;仅有队头指针的单链表,寻找队尾仍可能需要 O(n)。
两个顺序栈可共享一段数组,从两端向中间增长,让暂时空闲的容量供另一栈使用。判满公式取决于栈顶指针的含义。以 V[0..M−1] 为例:
| 指针约定 | 初始空栈 | 总元素数 | 共享空间已满 |
|---|---|---|---|
left/right 指向最后一个有效元素 |
left=−1, right=M |
(left+1)+(M−right) |
left+1=right |
left/right 指向各自下一可写位置 |
left=0, right=M−1 |
left+(M−1−right) |
left=right+1 |
先用“左栈长度+右栈长度=数组长度”推导,再代入空栈或只剩一格检查,比背孤立的判满式可靠。
优先队列:按优先级取出
优先队列每次取出当前优先级最高的元素,进入时间通常不是唯一依据。常用二叉堆实现:堆是完全二叉树,小顶堆中父结点值不大于孩子,大顶堆反之;它只保证堆顶是极值,不保证兄弟有序或整个数组有序。
插入先占据完全二叉树的下一个位置,再与父结点比较并上移;取出堆顶后用末元素补根,再与较优孩子比较并下移。树高为 O(log n),两种操作最坏为 O(log n),查看堆顶为 O(1)。这里按容量足够或不计动态数组偶发扩容的堆操作模型分析。Java/Kotlin 的 PriorityQueue 默认按自然顺序取最小元素;自定义比较器可以改变优先级,相同优先级的先后通常不保证。建堆过程可接着阅读算法章的堆排序。
循环队列:复用已空出的数组槽位
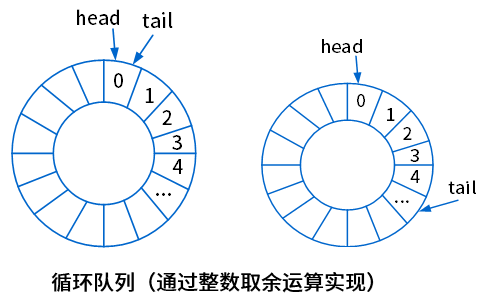
以下约定:数组容量为 size,head 指向队头元素,tail 指向下一个可写位置,**保留一个空槽位**用于区分队空和队满。
| 状态/操作 | 公式 |
|---|---|
| 队空 | head == tail |
| 队满 | (tail + 1) % size == head |
| 当前长度 | (tail - head + size) % size |
| 入队后 | tail = (tail + 1) % size |
| 出队后 | head = (head + 1) % size |
因此最多存 size−1 个元素。如果另设元素计数或满标志,可以用满全部槽位,但判空、判满公式需相应改变。
课件说循环队列使入队、出队“不需要移动其他元素”,这一点正确,但**普通队列也可以只移动头尾指针而不移动元素**。数组循环队列的关键优势是复用前部已经空出的槽位,避免尾指针到达数组末端造成“假溢出”;链式队列也无需搬移其他元素。
例题 2:栈接队列,求最大栈内容
设栈S和队列Q初始状态为空,数据元素序列a,b,c,d,e,f依次通过栈S,且多个元素从S出栈后立即进入队列Q,若出队的序列是b,d,f,e,c,a,则S中的元素最多时,栈底到栈顶的元素依次为( )。
A、a,b,c B、a,c,d C、a,c,e,f D、a,d,f,e
参考答案与解析
答案:C。 队列不改变先后顺序,所以栈的出栈顺序就是 b,d,f,e,c,a。
| 下一次需要出栈 | 为此压入元素后的栈,左边为栈底 | 出栈后 |
|---|---|---|
| b | a,b | a |
| d | a,c,d | a,c |
| f | a,c,e,f | a,c,e |
| e | a,c,e | a,c |
| c | a,c | a |
| a | a | 空 |
最大时有 4 个元素,为 a,c,e,f。解题关键是**出队顺序=入队顺序=出栈顺序**。
例题 3:同端进出的双端队列
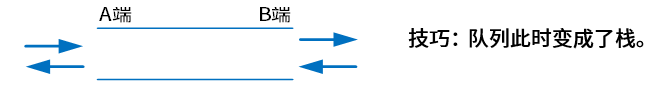
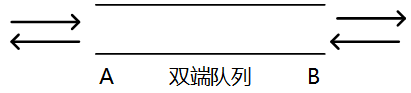
双端队列是指在队列的两个端口都可以加入和删除元素,如下图所示。现在要求元素进队列和出队列必须在同一端口,即从A端进队的元素必须从A端出、从B端进队的元素必须从B端出,则对于4个元素的序列a、b、c、d,若要求前2个元素(a、b)从A端口按次序全部进入队列,后两个元素(c、d)从B端口按次序全部进入队列,则不可能得到的出队序列是( )。
A、d、a、b、c B、d、c、b、a C、b、a、d、c D、b、d、c、a
参考答案与解析
答案:A。 按题目“全部进入队列”后出队的约束,A 端表现为栈:必须 b 在 a 前;B 端也表现为栈:必须 d 在 c 前。
两端出队可以交替,但不能破坏这两个局部顺序。A 选项让 a 先于 b 出队,违反 A 端约束;B、C、D 均满足 b→a 和 d→c。
串:字符组成的有限序列
串是元素为字符的线性表。S='a1a2…an' 中,S 为串名,引号内为串值,n 为串长。
| 概念 | 判断依据 | 示例 |
|---|---|---|
| 空串 | 长度为 0 | "" |
| 空格串 | 由一个或多个空格组成;空格计入长度 | " " 长度为 1 |
| 子串 | 在原串中连续 | "abcde" 的 "bcd" |
| 子序列 | 保持相对顺序,可以不连续 | "abcde" 的 "ace" |
| 串相等 | 长度相同且对应字符相同 | "ab" 与 "ab" |
空串是任意串的子串;子串也是子序列,反过来不一定成立。串可以顺序存储,也可以采用每个结点存放一个或多个字符的链式存储。
通常的字典序比较是从左到右找**第一对不同字符**,依据约定的字符顺序比较;只有一方是另一方的前缀时,才由长度决定。字符顺序可以基于编码,也可以使用语言环境的排序规则,不能把所有字符串比较都等同于比较 ASCII。
| 课件中的操作名 | 含义 |
|---|---|
StrAssign(s,t) |
课件约定把 s 赋给 t;不同教材的参数方向可能相反,应读接口定义 |
Concat(s,t) |
将 t 接到 s 之后 |
StrLength(s) |
求串长 |
StrCompare(s,t) |
课件约定小于、等于、大于分别返回 −1、0、1;实际语言 API 可能只保证返回值的正负 |
SubString(s,start,len) |
从指定位置取长度为 len 的子串;下标从 0 还是 1 开始由接口决定 |
子串计数与 KMP 模式匹配
长度为 n 的串,长度为 ℓ 的非空子串有 n−ℓ+1 个位置,因此按位置计数共有 n(n+1)/2 个非空子串。若字符互不相同,这些子串的内容也互异;排除整串本身再减 1。若有重复字符,内容去重后的数量可能更少,例如 "aaa" 的非空子串按位置有 6 个,按不同内容只有 "a"、"aa"、"aaa" 三种。子序列允许跳过字符,按位置选择则有 2ⁿ 种,不能套用子串公式。
**模式匹配**是在主串中找模式串连续出现的位置。朴素方法在失配后换一个起点重新比;KMP 利用模式串已经匹配部分的重复结构移动模式串,避免主串指针回退。它预处理模式串需 O(m),匹配需 O(n),总时间 O(n+m),其中 n、m 为主串和模式串长度。
前缀从串首开始,后缀到串尾结束;真前缀/真后缀不包含整个串。例如 "abab" 最长的相等真前后缀是 "ab",长度为 2。失配时,已经匹配的末尾 "ab" 可直接当作新一轮的开头,不必重比。
next 有多种下标约定。题目若规定模式字符从 1 编号、next[1]=0,常用定义为:next[j] 等于 p[1..j−1] 的最长相等真前后缀长度+1,j>1;没有非空匹配时为 1。例如:
模式 ababc 的字符位置 j |
1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| 当前字符之前的串 | 空 | a | ab | aba | abab |
| next[j] | 0 | 1 | 1 | 2 | 3 |
在第 5 个字符 c 处失配时,前面 abab 已匹配,可保留末尾 ab,令模式指针跳到 next[5]=3,主串当前字符不动。若仍失配,继续沿 next 回退模式指针;退到哨兵 0 后再推进主串。另一些资料用从 0 开始的前缀函数 π[i],记录**含当前位置**的前缀的匹配长度,或使用 −1 哨兵、优化的 nextval;它们数值不同,先读题给定义再计算。
例题 4:子串与子序列
下列有关于字符串的描述中,说法正确的是( )。
A.空串就是指含有空白字符构成的串
B.子串是指任意个连续的字符组成的子序列
C.子序列是特殊的子串
D.字符串的比较实质就是两个串的长度对比
参考答案与解析
答案:B。 关键词是**连续**。A 混淆空串和空格串;C 把包含关系说反;D 忽略了对应字符的比较。
专项题库练习(19 题)
本小节对应题库练习共 19 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 004
来源:知识点练习「数据结构」第 4 题(原站入口)。
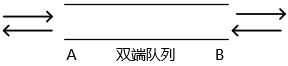
图示双端队列要求每个元素从哪一端入队,就从同一端出队。对 4 个元素的序列 e1、e2、e3、e4,前 2 个元素 e1、e2 按顺序全部从 A 端进入,后两个元素 e3、e4 按顺序全部从 B 端进入。下列哪一个出队序列可能出现( )?
-
A. e1、e2、e3、e4
-
B. e2、e3、e4、e1
-
C. e3、e4、e1、e2
-
D. e4、e3、e2、e1
答案与解析
平台答案:D。
整理解析
按题意理解为各元素已按指定次序全部入队,选 D。A 端出队须先 e2 后 e1,B 端须先 e4 后 e3,只有 e4、e3、e2、e1 同时满足两条约束。若允许在本端两个元素尚未全部入队时就穿插出队,约束会改变,平台结论依赖题中的“全部进入”阶段划分。
题目 006
来源:知识点练习「数据结构」第 6 题(原站入口)。
一个初始为空的栈依次接收 1,2,3,…,n-1,n。若第一个出栈元素是 k,且 1≤k≤「n/2」,则最后一个出栈元素为( )。
-
A. 值为n的元素
-
B. 值为1的元素
-
C. 值为n-k的元素
-
D. 不确定的
答案与解析
平台答案:D。
整理解析
一般不能据此确定最后一个元素,平台选 D。例如 n=4、k=2 时,2、1、3、4 与 2、3、4、1 都是合法出栈序列,末元素分别为 4 和 1。原页截图已确认界限写作「n/2」,左端横线在上、右端横线在下,是原站不规范的一对角括号,不能明确读作一对向上或向下取整符号。这里保留原符号;上述 n=4 反例不受影响。
题目 008
展开题目 008(先作答,再查看解析)
来源:知识点练习「数据结构」第 8 题(原站入口)。
KMP 字符串匹配算法使用模式串的 next 函数,其定义见下图,字符序号 j 从 1 开始。模式串 p 为“abaac”时,next 值依次为( )。
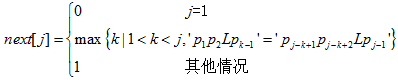
-
A. 01234
-
B. 01122
-
C. 01211
-
D. 01111
答案与解析
平台答案:B。
整理解析
选 B,即 0、1、1、2、2。按图中从 1 起算的 next 定义,首项为 0;其后考察当前字符之前子串的最长相等真前后缀,再加 1。“a”“ab”没有非空匹配,“aba”“abaa”的最长匹配都是“a”。第 5 个字符实际是 c,平台解析写成 a、并把前缀写成“abaa0”,属于文字错误。
题目 011
展开题目 011(先作答,再查看解析)
来源:知识点练习「数据结构」第 11 题(原站入口)。
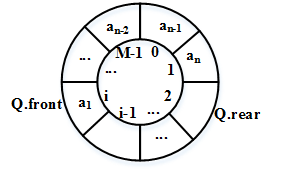
循环队列 Q 使用 front、rear 两个域变量:front 指向队头元素,rear 指向队尾元素之后的位置,如图所示。队列容量为 M 时,队列长度的计算式为( )。
-
A. (Q.rear-Q.front +1)
-
B. (Q.rear-Q.front+M)
-
C. (Q.rear-Q.front+1)%M
-
D. (Q.rear-Q.front+M)%M
答案与解析
平台答案:D。
整理解析
按常用循环队列约定选 D。rear 位于尾元素之后,从 front 沿环到 rear 的距离为 (Q.rear−Q.front+M)%M。这个公式通常配合预留一个空槽来区分队空、队满;若 M 个槽全可占用,还须增加计数或满标志,否则 front=rear 无法区分长度 0 与 M。
题目 012
展开题目 012(先作答,再查看解析)
来源:知识点练习「数据结构」第 12 题(原站入口)。
栈 S 与队列 Q 最初都为空,元素 a、b、c、d、e、f、g 按此顺序进入 S,每个元素一出栈就立即进入 Q。若这 7 个元素的出队顺序为 b、d、f、e、c、a、g,则 S 至少需要容纳( )个元素。
-
A. 5
-
B. 4
-
C. 3
-
D. 2
答案与解析
平台答案:B。
整理解析
选 B,最小容量为 4。先压入 a、b 后弹出 b,再压入 c、d 后弹出 d;为下一个弹出 f,必须再压入 e、f,此时栈为 a、c、e、f,共 4 个。随后依次弹出 f、e、c、a,再让 g 入栈出栈即可,故 4 既必要又足够。
题目 014
展开题目 014(先作答,再查看解析)
来源:知识点练习「数据结构」第 14 题(原站入口)。
优先队列通常以(14)作为实现的数据结构;向其中插入一个元素的时间复杂度为(15)。
请作答:第 14 题。
-
A. 堆
-
B. 栈
-
C. 队列
-
D. 线性表
答案与解析
平台答案:A。
整理解析
本问选 A。二叉堆把最高优先级元素保持在堆顶,支持高效插入和取出。优先级与数值的对应关系可采用大根堆或小根堆,并非所有场景都固定为最大数值先出。
题目 015
展开题目 015(先作答,再查看解析)
来源:知识点练习「数据结构」第 15 题(原站入口)。
优先队列通常以(14)作为实现的数据结构;向其中插入一个元素的时间复杂度为(15)。
请作答:第 15 题。
-
A. O(n)
-
B. O(1)
-
C. O(lgn)
-
D. O(n2)
答案与解析
平台答案:C。
整理解析
本问选 C。沿用前一空的二叉堆实现,插入时先放到完全二叉树的末尾,再向上调整,最坏经过 O(log n) 层,因此最坏时间为 O(lg n)。最好情况可不需上移,不能据此把一般复杂度答成 O(1)。
同材料可参照第 14 题。
题目 016
展开题目 016(先作答,再查看解析)
来源:知识点练习「数据结构」第 16 题(原站入口)。
一个长度为 n(n>1)、元素互不相同的序列,依次经过初始为空的栈,再经过初始为空的队列。两者容量均足够大;栈非空时允许出栈,队列非空时允许出队。以下哪项关系必然成立( )?
-
A. 出队序列和出栈序一定互为逆序
-
B. 出队序列和出栈序列一定相同
-
C. 入栈序列与入队序列一定相同
-
D. 入栈序列与入队序列一定互为逆序
答案与解析
平台答案:B。
整理解析
选 B。每个元素出栈后按同一次序入队,队列的先进先出性质又保持该次序,所以出队序列必定等于出栈序列。入栈与出栈可交错进行,出栈序列既不必等于入栈序列,也不必是其逆序。
题目 020
展开题目 020(先作答,再查看解析)
来源:知识点练习「数据结构」第 20 题(原站入口)。
初始为空的栈按 a、b、c、d、e 的次序接收元素,每个元素只入栈、出栈各 1 次。要求第一个出栈的是 d,共有( )种合法的出栈序列。
-
A. 4
-
B. 5
-
C. 6
-
D. 24
答案与解析
平台答案:A。
整理解析
选 A。d 第一个弹出后,栈中 a、b、c 的相对出栈顺序只能是 c、b、a,e 尚未入栈。把 e 的出栈位置放在 c、b、a 的前面、两个间隙或后面,共 4 种。
题目 032
展开题目 032(先作答,再查看解析)
来源:知识点练习「数据结构」第 32 题(原站入口)。
关于字符串,下列说法正确的是( )。
-
A. 包含任意个空格字符的字符串称为空串
-
B. 字符串不是线性数据结构
-
C. 字符串的长度是指串中所含字符的个数
-
D. 字符串的长度是指串中所含非空格字符的个数
答案与解析
平台答案:C。
整理解析
选 C。串是字符组成的线性序列,长度计入全部字符,包括空格。空串长度为 0;只含一个或多个空格的串属于空白串,长度不为 0。
题目 033
展开题目 033(先作答,再查看解析)
来源:知识点练习「数据结构」第 33 题(原站入口)。
栈 S 初始为空,I 表示入栈,O 表示出栈。元素按 a1、a2、a3、a4、a5 的顺序入栈;要得到 a2、a4、a5、a3、a1 的出栈序列,应采用操作序列( )。
-
A. IIOIIOIOOO
-
B. IOIOIOIOIO
-
C. IOOIIOIOIO
-
D. IIOOIOIOOO
答案与解析
平台答案:A。
整理解析
选 A。IIOIIOIOOO 依次执行压入 a1、a2,弹出 a2;压入 a3、a4,弹出 a4;压入 a5,随后弹出 a5、a3、a1。B 得到原顺序,C 的第三步就对空栈出栈,D 只有 4 次入栈却有 6 次出栈。
题目 035
展开题目 035(先作答,再查看解析)
来源:知识点练习「数据结构」第 35 题(原站入口)。
非空字符串 S 长度为 n,所有字符互不相同。它的互异非平凡子串,即非空且不等于 S 本身的子串,共有( )个。
-
A. 2n-1
-
B. n2
-
C. n(n+1)/2
-
D. (n+2) (n-1)/2
答案与解析
平台答案:D。
整理解析
选 D。长度为 l 的连续子串有 n−l+1 个,各字符互异保证不同位置的同长度子串也不同。全部非空子串共 n(n+1)/2 个,去掉 S 本身后为 n(n+1)/2−1=(n+2)(n−1)/2;n=1 时结果为 0。
题目 039
展开题目 039(先作答,再查看解析)
来源:知识点练习「数据结构」第 39 题(原站入口)。
队列遵循先进先出规则。若采用循环单链表表示队列,下列说法正确的是( )。
-
A. 入队列和出队列操作都不需要遍历链表
-
B. 入队列和出队列操作都需要遍历链表
-
C. 入队列操作需要遍历链表而出队列操作不需要
-
D. 入队列操作不需要遍历链表而出队列操作需要
答案与解析
平台答案:A。
整理解析
平台选 A,依赖维护尾指针 rear 等实现条件。对不带头结点的循环单链表,rear→next 可直接定位队头;尾部插入并更新 rear、删除队头并修复链接,都可 O(1) 完成,单结点情况需另作处理。原题没有说明保存尾指针:若仅保存队头指针,入队通常要遍历找尾结点,对应 C。循环链接本身不等于必带尾指针。
题目 043
展开题目 043(先作答,再查看解析)
来源:知识点练习「数据结构」第 43 题(原站入口)。
用单链表实现后进先出的栈,头指针同时作为栈顶指针。入栈与出栈是否需要遍历链表?
- A. 两种操作都不需要遍历
- B. 两种操作都需要遍历
- C. 入栈需要遍历,出栈不需要
- D. 入栈不需要遍历,出栈需要
答案与解析
平台答案:A。
整理解析
入栈把新结点接在表头,出栈移除表头并把头指针移向下一结点,两者只需修改少量链接,均为 O(1),选 A。把栈顶设在表头,使弹出栈顶时无需寻找前驱。
题目 050
展开题目 050(先作答,再查看解析)
来源:知识点练习「数据结构」第 50 题(原站入口)。
双端队列的 A、B 两端都允许入队和出队,但要求每个元素从哪端进入,就必须从同一端离开。对 4 个元素 a、b、c、d,前 2 个 a、b 按顺序全部从 A 端进入,后 2 个 c、d 按顺序全部从 B 端进入。按这一入队安排,以下哪种出队顺序不可能得到?
- A. d、a、b、c
- B. d、c、b、a
- C. b、a、d、c
- D. b、d、c、a
答案与解析
平台答案:A。
整理解析
按题目先全部入队再考察出队的口径,队列由 A 到 B 排列为 b、a、c、d。A 端必须先出 b 后出 a,B 端必须先出 d 后出 c,两组可交错。A 项把 a 排在 b 前面,不可实现;其余三项均保持这两个先后约束,故选 A。
题目 063
展开题目 063(先作答,再查看解析)
来源:知识点练习「数据结构」第 63 题(原站入口)。
栈 S 和队列 Q 初始均为空,元素 a,b,c,d,e,f 依次进入 S;每次从 S 弹出后立即进入 Q。若最终出队顺序为 b,d,f,e,c,a,S 元素最多时,从栈底到栈顶依次是什么?
- A. a,b,c
- B. a,c,d
- C. a,c,e,f
- D. a,d,f,e
答案与解析
平台答案:C。
整理解析
队列保持入队次序,所以出栈顺序也为 b,d,f,e,c,a。先压 a、b 弹 b,再压 c、d 弹 d,此时栈为 a、c;随后压 e、f 才能弹出 f,栈达到最大 4 项:a、c、e、f,选 C。之后连续弹 e、c、a 即可。
题目 066
展开题目 066(先作答,再查看解析)
来源:知识点练习「数据结构」第 66 题(原站入口)。
两个顺序栈共用 V[1..n],栈 1、栈 2 的栈底分别在 V[1]、V[n]。top[i] 表示第 i 个栈的栈顶位置(i=1,2),两栈都空时 top[1]=1、top[2]=n。共存满 n 个元素时,满足哪个条件?
- A. top[1]=top[2]
- B. top[1]+top[2]==1
- C. top[1]+top[2]==n
- D. top[1]−top[2]==1
答案与解析
平台答案:D。
整理解析
按题设初值及平台图示,top 实际指向各栈下一可用位置,而非最后一个元素。两栈的元素数分别为 top[1]−1、n−top[2],相加等于 n 时,得到 top[1]−top[2]=1,选 D。若 top[1]=top[2],仍剩一个可用单元,不能直接套用其他栈顶指针约定下的判满公式。
题目 067
展开题目 067(先作答,再查看解析)
来源:知识点练习「数据结构」第 67 题(原站入口)。
采用循环队列能带来下列哪项优点?
- A. 入队、出队可在同一端点操作
- B. 入队、出队均无需移动其他元素
- C. 不会出现队列满
- D. 不会出现队列空
答案与解析
平台答案:B。
整理解析
循环队列通过首尾下标按容量取模回绕,复用前端释放的空间,无需为入队或出队整体搬移其他元素,选 B。纠错:平台称头部“不为空继续存放”不妥,只有空闲位置才能写入;循环队列仍会真正空或满,可用计数、标志位或预留一格来区分。
题目 074
展开题目 074(先作答,再查看解析)
来源:知识点练习「数据结构」第 74 题(原站入口)。
栈初始为空,元素按 1,2,3,…,n 的次序入栈,出栈序列记为 p1,p2,p3,…,pn。已知 p3=4,以下哪组数不可能依次作为 p1、p2?
- A. 6,5
- B. 2,3
- C. 3,1
- D. 3,5
答案与解析
平台答案:C。
整理解析
若先弹出 3,则 1、2 都已入栈且 2 压在 1 上面,在不先弹 2 的情况下,第二个不可能是 1,所以选 C。其他三项可分别形成前三个输出 6,5,4;2,3,4;3,5,4。条件说明:选项默认 n 至少为 6;若 n 更小,还会出现数字超出入栈序列的额外不可行项。
三、数组与矩阵
数组地址:先算前面有多少元素
设二维数组有 m 行、n 列,首元素地址为 base,每个元素占 w 字节;行、列下界分别为 L₁、L₂。
- 行优先:
LOC(a[i][j]) = base + ((i−L₁)×n + (j−L₂))×w。 - 列优先:
LOC(a[i][j]) = base + ((j−L₂)×m + (i−L₁))×w。 - 一维数组:
LOC(a[i]) = base + (i−L)×w。
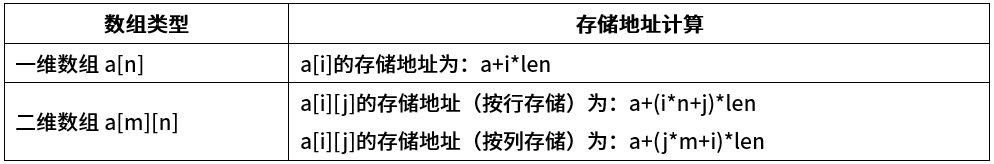
口诀“行列列”“列行行”只帮助记顺序,使用前仍需检查**下标起点、行列数、元素字节数、首地址**。公式针对连续矩形数组,不直接适用于 Java 等语言中行对象可分别分配的“数组的数组”。
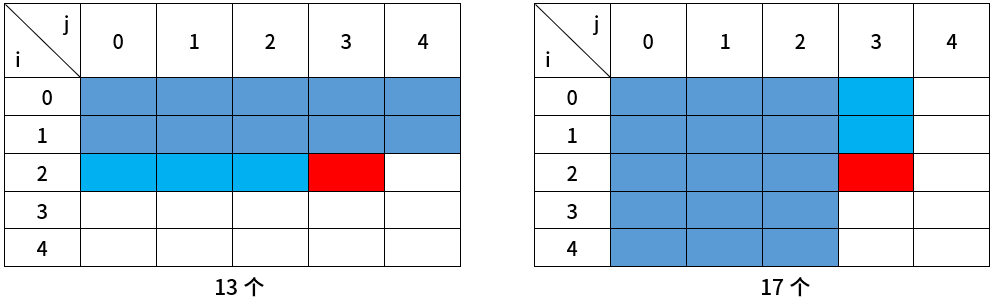
原例:5×5 数组 a,每个元素占两个字节,求 a[2][3] 按行优先存储的地址。
参考答案与推导:数组偏移
图中下标从 0 开始。行优先有 2×5+3=13 个元素排在前面,所以地址为 base+26 字节。没有给出首地址,就不能编造绝对地址。
若改为列优先,则前面有 3×5+2=17 个元素,地址为 base+34 字节。注意“元素个数”和“字节偏移”差一个乘数 w。
例题 5:行优先和列优先的相同偏移
二维数组a[1..N,1..N]可以按行存储或按列存储。对于数组元素a[i,j](1<=i,j<=N),当( )时,在按行和按列两种存储方式下,其偏移量相同。
A、i≠j B、i=j C、i>j D、i<j
参考答案与解析
答案:B。 相等条件为 (i−1)N+(j−1)=(j−1)N+(i−1),即 (N−1)(i−j)=0。
N>1 时得到 i=j;N=1 时唯一元素本身也满足 i=j。因此方阵的主对角线元素偏移相同。
特殊矩阵与稀疏矩阵的压缩存储
特殊矩阵的相同值或非零元素具有规律,例如对称矩阵、三角矩阵、带状矩阵。稀疏矩阵强调**非零元素相对很少**,位置未必有规则;普通三角矩阵不宜直接当作“稀疏矩阵”的定义。
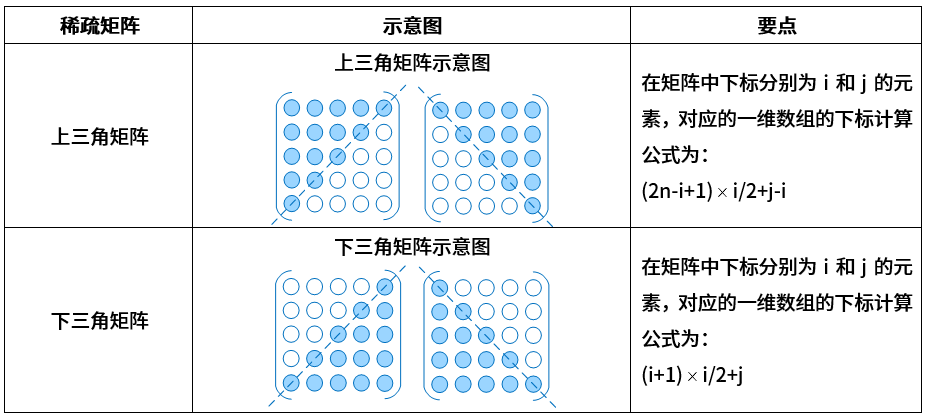
图中的公式使用**矩阵下标与压缩数组下标均从 0 开始、按行存储并包含主对角线**的约定:
| 存储区域 | 条件 | 一维数组下标 k |
|---|---|---|
| 下三角 | 0≤j≤i<n |
i(i+1)/2+j |
| 上三角 | 0≤i≤j<n |
i(2n−i+1)/2+(j−i) |
若改用下标从 1 开始的 B,则下三角为 k=i(i−1)/2+j。不同下标约定的公式不可直接混用。对称矩阵可只存一侧,访问另一侧时交换 i、j。
稀疏矩阵常用三元组 (行号,列号,元素值),如 (1,1,5)、(1,2,10),并保存矩阵规模、非零元素数等元信息。三元组顺序表按约定顺序保存记录;**十字链表**把同一非零结点同时链接到所属行和所属列,便于按行、按列访问。
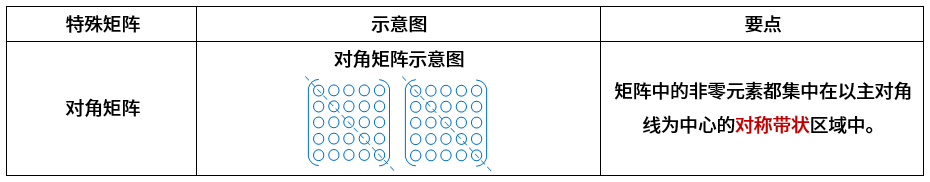
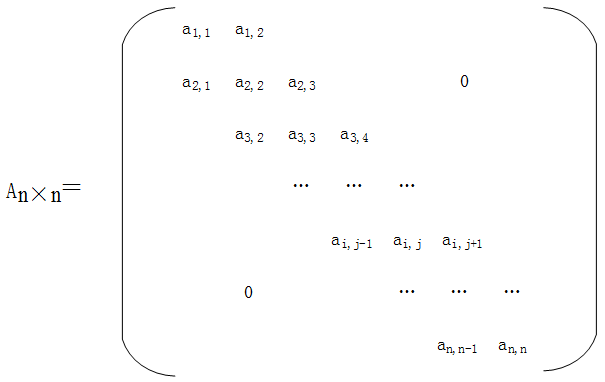
图中“对角矩阵”文字描述了主对角线附近的对称带状区域。严格来说,对角矩阵只允许主对角线元素非零;三对角矩阵允许主对角线及上下各一条相邻对角线非零。
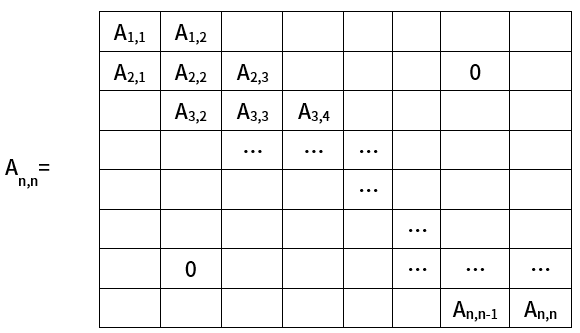
上三角位置满足 i<j,下三角位置满足 i>j,主对角线满足 i=j。说“存上三角/下三角”时还需说明是否包含主对角线。
三对角带也可用“前面各行的槽位+本行偏移”定位。以矩阵和压缩数组都从 1 编号为例,n≥2 时首、尾行各 2 格,中间每行 3 格,共 3n−2 格。中间第 i 行之前有 2+3(i−2) 格,本行从列 i−1 开始,所以其一维下标为 2+3(i−2)+(j−i+2)=2i+j−2。例如 6 阶矩阵的 (4,3) 是第 9 格;若矩阵改为零基下标而压缩数组仍从 1 编号,同一位置写成 (3,2),公式须相应变为 2i+j+1。这类固定公式为带内位置保留槽位,包括其中碰巧为零的值。
例题 6:三对角矩阵的压缩下标
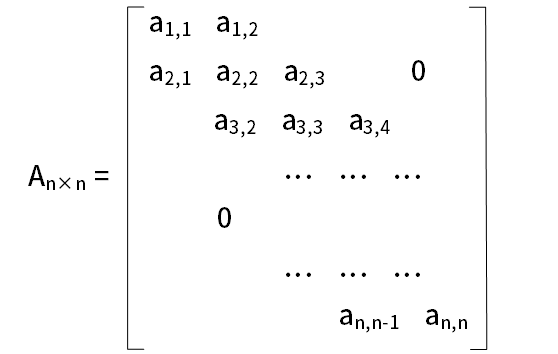
设某n阶三对角矩阵的示意图如下图所示。若将该三对角矩阵的非零元素按行存储在一维数组B[k](1≤k≤3*n-2)中,则k与i、j的对应关系是( )。
A、k=2i+j-2 B、k=2i-j+2 C、k=3i+j-1 D、k=3i-j+2
参考答案与解析
答案:A。 矩阵和 B 均从 1 编号。第一行存 2 个位置,中间每行 3 个,最后一行 2 个,总数 3n−2(通常 n≥2)。
对中间第 i 行,其前面有 2+3(i−2)=3i−4 个位置;本行从 j=i−1 开始,元素在本行的序号为 j−i+2,因此 k=(3i−4)+(j−i+2)=2i+j−2。
代入边界检查:a[1,1]→B[1],a[1,2]→B[2],a[n,n]→B[3n−2]。
该公式为**带内每个位置都保留槽位**的布局。如果只按实际非零值动态存三元组,带内恰好等于 0 的元素被省略,就不能用这一固定下标公式。
专项题库练习(6 题)
本小节对应题库练习共 6 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 017
来源:知识点练习「数据结构」第 17 题(原站入口)。
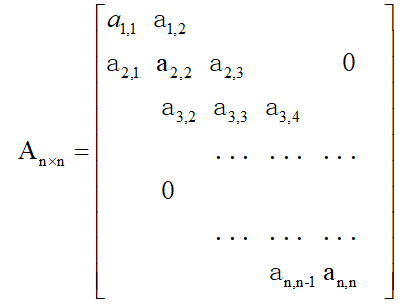
n 阶三对角矩阵 An×n 如图所示。把其非零元素按行存入一维数组 B[k],其中 1≤k≤3*n-2。元素 A[i,j] 对应的下标 k 为( )。
-
A. k=2i+j-2
-
B. k=2i-j+2
-
C. k=3i+j-1
-
D. K=3i-j+2
答案与解析
平台答案:A。
整理解析
选 A。图中 A 的下标从 1 开始,首行占 2 个位置;对 i≥2,第 i 行之前有 2+3(i−2)=3i−4 个位置,本行 A[i,j] 的行内序号为 j−i+2,相加得到 k=2i+j−2,首行也适用。这里按固定的三条对角带存储 3n−2 个位置;若连带内偶然出现的零也逐个删去,下标公式就不能只由 i、j 决定。
题目 024
来源:知识点练习「数据结构」第 24 题(原站入口)。
二维数组 a[1..N,1..N] 分别采用按行与按列存储。对元素 a[i,j](1≤i,j≤N),当( )时,两种方式下的偏移量相同。
-
A. i≠j
-
B. i=j
-
C. i > j
-
D. i < j
答案与解析
平台答案:B。
整理解析
选 B。以元素个数计,按行偏移为 (i−1)N+(j−1),按列偏移为 (j−1)N+(i−1),两者相减得 (N−1)(i−j)。N>1 时相等当且仅当 i=j;N=1 时唯一合法下标也满足 i=j。
题目 040
来源:知识点练习「数据结构」第 40 题(原站入口)。
n 阶三对角矩阵 A 的非零元素仅位于主对角线和与其平行、紧邻的两条对角线上。现按行压缩存入数组 B:A 的下标从 0 开始,B 的下标从 1 开始,A[0,0] 对应 B[1],A[n-1,n-1] 对应 B[3n-2]。对非零元素 A[i,j](0≤i<n,0≤j<n,|i-j|≤1),它应存入 B[( )]。
-
A. 2i+j-1
-
B. 2i+j
-
C. 2i+j+1
-
D. 3i-j+1
答案与解析
平台答案:C。
整理解析
选 C。A 下标从 0 开始,而 B 从 1 开始。第 i 行(i≥1)之前共有 2+3(i−1)=3i−1 个带内位置,A[i,j] 在本行的序号为 j−i+2,相加得 2i+j+1,首行也适用。代入 (0,0) 得 1,代入 (n−1,n−1) 得 3n−2。它与第 17 题的矩阵下标起点不同,不能直接套用 2i+j−2。
题目 048
来源:知识点练习「数据结构」第 48 题(原站入口)。
n 阶三对角矩阵 A 如图,将三条对角线上的元素按行依次存入一维数组 M,且 a1,1 位于 M[1]。对于 1≤i,j≤n 且位于三条对角线内的 ai,j,其在 M 中的下标是哪项?
- A. i+2j
- B. 2i+j
- C. i+2j−2
- D. 2i+j−2
答案与解析
平台答案:D。
整理解析
对 i≥2,第 i 行前共有首行的 2 项以及 i−2 个完整中间行,即 2+3(i−2)=3i−4 项。本行从列 i−1 开始,ai,j 是本行第 j−i+2 项,所以一维下标为 3i−4+j−i+2=2i+j−2,选 D。第一行单独代入也得到 a1,1→M[1]、a1,2→M[2]。
题目 051
来源:知识点练习「数据结构」第 51 题(原站入口)。
n 阶对称矩阵 A 的下三角部分(含主对角线)按行存入数组 S。矩阵下标从 0 开始,且 S[1]=A[0][0]。若 A[i][j] 对应 S[k],在 i≤j 时,k 与 i、j 的关系是哪项?
- A. k=i(i+1)/2+j−1
- B. k=j(j+1)/2+i+1
- C. k=i(i+1)/2+j+1
- D. k=j(j+1)/2+i−1
答案与解析
平台答案:B。
整理解析
i≤j 时利用对称性 A[i][j]=A[j][i],实际访问存储的下三角位置。第 j 行前有 1+2+…+j=j(j+1)/2 项,本行到列 i 共 i+1 项,所以 k=j(j+1)/2+i+1,选 B。纠错:n 阶矩阵从 0 编号时末下标为 n−1,平台示意中写到 A[n] 的额外行列越界;它不应改变上述计数。
题目 065
来源:知识点练习「数据结构」第 65 题(原站入口)。
以下哪一组是稀疏矩阵常用的压缩存储结构?
- A. 二维数组和双向链表
- B. 三元组顺序表和十字链表
- C. 邻接矩阵和十字链表
- D. 索引顺序表和双向链表
答案与解析
平台答案:B。
整理解析
稀疏矩阵只需记录非零元素及其行、列位置。三元组顺序表保存“行、列、值”,十字链表把非零结点同时接入相应行链和列链,因此选 B。
四、树与二叉树的存储、性质
基本术语与高度约定
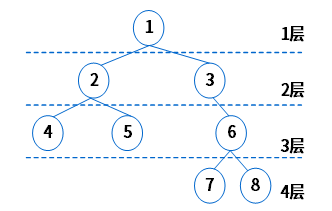
| 术语 | 含义 |
|---|---|
| 结点的度 | 结点拥有的子结点数/子树数 |
| 树的度 | 全部结点度的最大值 |
| 叶子结点 | 度为 0 的结点 |
| 分支结点/非终端结点 | 度不为 0 的结点 |
| 父、子、兄弟 | 上一层的直接连接关系;具有同一父结点的结点互为兄弟 |
| 层次 | 本篇约定根在第 1 层,沿一条边下行加 1 |
| 树高 | 本篇按层数计;空树高度为 0,单结点树高度为 1 |
“内部结点”常指**非叶结点,包含非叶的根**;课件采用“除根之外的分支结点”的局部口径。做题时读定义,平时建议使用更明确的“非叶结点”“非根非叶结点”。另一类教材按边数定义高度,单结点树高度为 0;涉及 2^h−1 等公式时要先确认高度的约定。
二叉树、满二叉树和完全二叉树
二叉树可为空;非空时由根结点和互不相交的左、右二叉子树组成。左右有区别,即使只有一个孩子,也要说明是左孩子还是右孩子。
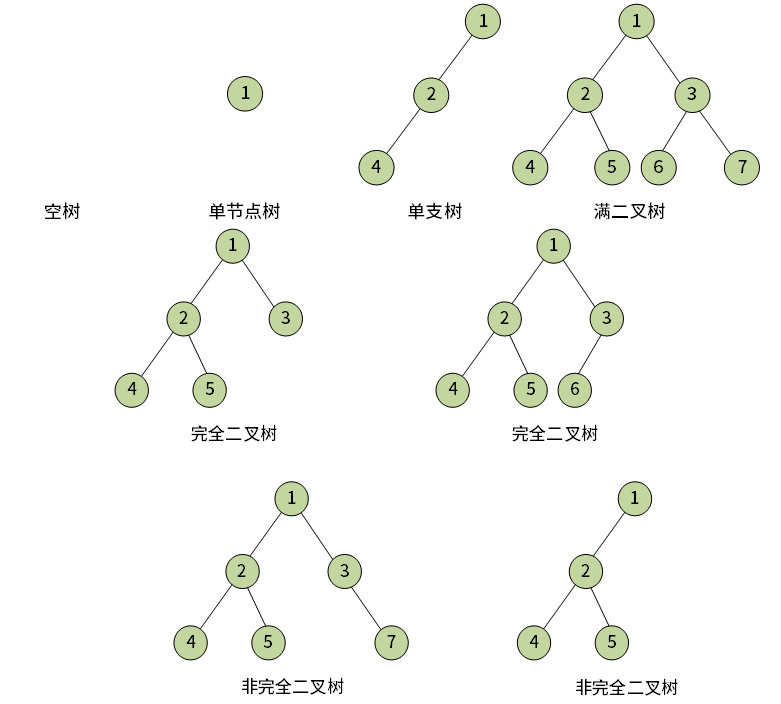
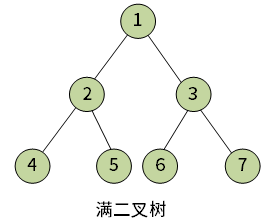
- 本课件的**满二叉树**:每一层都达到最大结点数,高度 h 时有
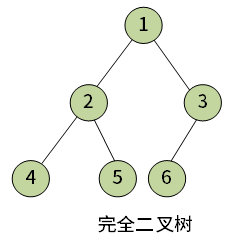
2^h−1个结点。 - 完全二叉树:除最后一层外各层全满,最后一层从左到右连续排列;与同高度满二叉树的前 n 个编号位置一一对应。
- 满二叉树必为完全二叉树;完全二叉树不一定满。
英文 full binary tree 有时只指“每个结点有 0 或 2 个孩子”,不等于这里层层填满的定义;层层填满通常称 perfect binary tree。
顺序存储要保留空位置
按满二叉树位置编号,根为 1,结点 i 的左、右孩子位置分别为 2i、2i+1。一般二叉树缺失的孩子位置需要保留标记,不能把有效结点紧挨着塞进数组就认为保留了树形。
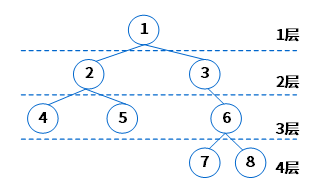


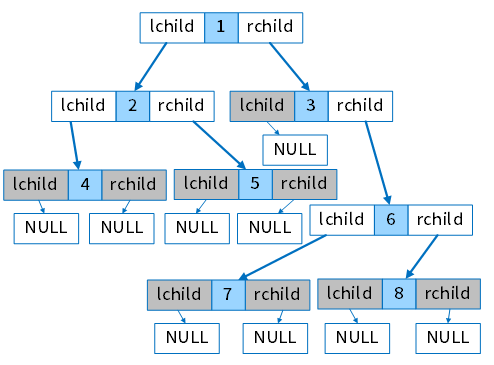
图中值为 1、2、3、4、5、6、7、8 的结点分别占位置 1、2、3、4、5、7、14、15;结点值不等于存储下标。图示占用 15 个有效编号位置;如果使用 C、Java 等从 0 开始的数组并闲置下标 0,则须申请至少 16 个槽位。
完全二叉树顺序存储紧凑;高度很大的稀疏二叉树可能浪费大量空位置。链式存储用左右指针直接保留关系,不要求为缺失位置预留完整数组。
常用性质与前提
| 性质 | 公式及前提 |
|---|---|
| 第 i 层最多结点数 | 2^(i−1),根为第 1 层 |
| 高度 h 最多结点数 | 2^h−1,高度按层数计 |
| n 个结点的完全二叉树高度 | ⌊log₂n⌋+1,n≥1 |
| 完全二叉树中 i 的父结点 | ⌊i/2⌋,i>1、编号从 1 开始 |
| 完全二叉树中 i 的左孩子 | 2i≤n 时存在 |
| 完全二叉树中 i 的右孩子 | 2i+1≤n 时存在 |
| 非空二叉树的叶子数 | n₀=n₂+1 |
| 非空树的边数 | 结点总数−1 |
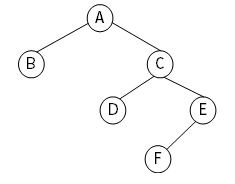
原思考:下图中各个结点的编号为多少?
参考答案与推导:区分位置编号与层序连续编号
按**满二叉树位置**编号:A=1,B=2,C=3,D=6,E=7,F=14。D 是 C 的左孩子,E 是 C 的右孩子,F 是 E 的左孩子。
这里不能因图中只有 6 个结点就把位置连续编号为 1~6;带空缺的普通二叉树也不能用“2i>结点数”判断某个孩子是否存在。
高度范围与空指针数量
非空二叉树若有 n 个结点,高度按层数计,满足 ⌈log₂(n+1)⌉≤h≤n:左界来自 n≤2ʰ−1,完全二叉树可以达到;右界是一条单支链。例如 20 个结点的最小高度为 5,最大高度为 20。反过来,高度 h 的一般二叉树最少只需 h 个结点,不能把完全二叉树最后一层的约束套给它。
空指针用“总指针域数−有效连接数”计算。n≥1 时二叉链表有 2n 个孩子指针,n−1 条父子边各占一个,故空孩子指针为 n+1;若每结点另有一个父指针,则每条边占父、子两个方向的指针,空指针为 3n−2(n−1)=n+2,其中包括根的空父指针。这里不统计树外部的入口指针,也不适用于已把空指针改作线索的实现。
一般树或森林可用**左孩子、右兄弟**转换成二叉树:左指针连原树的第一个孩子,右指针连下一个兄弟;森林中各棵树的根也按给定次序视作兄弟,第一棵树的根成为二叉树根。右指针因而不一定表示原树中的父子关系。
例如森林第一棵树的根 P 有孩子 Q、R,第二棵树的根 S 有孩子 T,其余均无孩子。转换后有 P.left=Q、Q.right=R、P.right=S、S.left=T。原森林的叶子 Q、R、T 恰好是**左指针为空**的三个结点;Q 还有右兄弟 R,所以不一定是转换后二叉树的叶子。二叉树根 P 的右子树包含 S、T,正好是第一棵树以外的全部结点;多棵树时也按这一关系求和。
用“边数=结点数−1”推导叶子数量
设度为 k 的结点数为 nₖ。把每条父子边按父结点统计,边数为 Σk·nₖ;按子结点统计,除根以外每个结点恰好贡献一条边,因此:
Σnₖ−1 = Σk·nₖ。
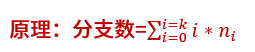
由此得到一般非空树的公式:
n₀ = 1 + n₂ + 2n₃ + 3n₄ + … = 1 + Σ(k−1)nₖ(k≥2)。
二叉树最高度为 2,因此化简为 n₀=n₂+1,与度为 1 的结点数无关。
二叉树的形态数:卡特兰数
若只区分左右结构、不为结点另行赋不同标签,n 个结点的二叉树形态数 Cₙ 满足:
C₀=1,Cₙ=Σ Cᵢ·Cₙ₋₁₋ᵢ(i=0…n−1)。
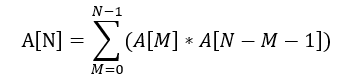
取 1 个结点为根,剩余 n−1 个分给左右子树;左右各自的形态数相乘,再对所有分配方式求和。空树算 1 种。

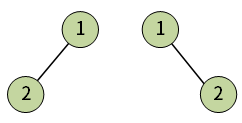
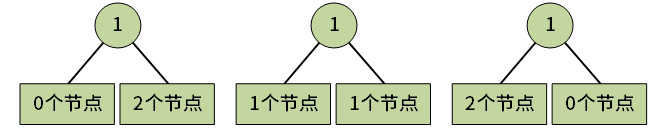
前三步为 C₁=1、C₂=2、C₃=1×2+1×1+2×1=5;继续可得 C₄=14,C₅=42。
例题 7:二叉树的数组位置
对下面的二叉树进行顺序存储(用数组MEM表示),已知节点A、B、C在MEM中对应元素的下标分别为1、2、3,那么节点D、E、F对应的数组元素下标为( )。
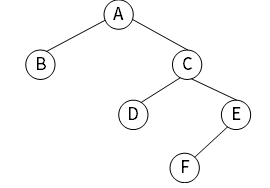
A、4、5、6 B、4、7、10 C、6、7、8 D、6、7、14
参考答案与解析
答案:D。 D 是 C 的左孩子:2×3=6;E 是 C 的右孩子:2×3+1=7;F 是 E 的左孩子:2×7=14。
例题 8:二叉链表中的空指针
设某二叉树采用二叉链表表示(即节点的两个指针分别指示左、右孩子)。当该二叉树包含k个节点时,其二叉链表节点中必有( )个空的孩子指针。
A、k-1 B、k C、k+1 D、2k
参考答案与解析
答案:C。 对非空二叉树(k≥1),共有 2k 个孩子指针域,k−1 条父子边各占用一个非空指针,所以空指针数 2k−(k−1)=k+1。
这里不统计树外部的根指针。空树 k=0 时没有结点指针域,不能把这个非空树公式直接套入。
例题 9:四个结点的二叉树形态
具有3个节点的二叉树有5种,可推测出具有4个节点的二叉树有( )种。
A、10 B、11 C、14 D、15
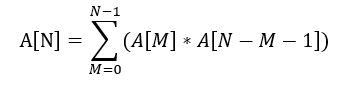
参考答案与解析
答案:C。 左右子树规模分别为 (0,3)、(1,2)、(2,1)、(3,0),对应 1×5+1×2+2×1+5×1=14 种。
例题 10:由各类结点数求叶子数
已知树T的度为4,且度为4的节点数为7个、度为3的节点数为5个、度为2的节点数为8个、度为1的节点数为10个,那么T的叶子节点个数为( )。(注:树中节点个数称为节点的度,节点的度中的最大值称为树的度。)
A、30 B、35 C、40 D、49
参考答案与解析
原题括号内“树中节点个数称为节点的度”是笔误:结点的度是**该结点的子结点数**;树的度是结点度的最大值。
答案:C。 n₀=1+3×7+2×5+1×8=40。
也可列边数等式:n₀+7+5+8+10−1=4×7+3×5+2×8+1×10。度为 1 的结点对等式两边贡献相同,因此不会改变叶子数结果。
专项题库练习(11 题)
本小节对应题库练习共 11 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 002
来源:知识点练习「数据结构」第 2 题(原站入口)。
下图二叉树若用一维数组顺序存储,结点间的关系由下标表示:下标为 i 的结点,其左、右孩子下标分别为 2i、2i+1。数组至少需要(2)个存储位置。若改用三叉链表,每个结点包含数据、父结点指针、左孩子指针和右孩子指针,则全部结点的空指针总数为(3)。
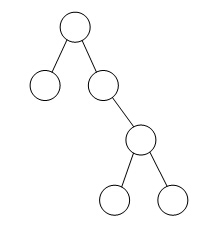
请作答:第 2 题。
-
A. 6
-
B. 10
-
C. 12
-
D. 15
答案与解析
平台答案:D。
整理解析
本问选 D。以根下标为 1,图中 6 个结点的位置依次为 1、2、3、7、14、15,故最大使用下标为 15,按题目的一基存储口径需 15 个位置。不能仅凭高度 h 就断言任意二叉树都必须占满 2h−1 个位置;本图恰有最右下结点。若在零基编程数组中闲置下标 0,实际分配长度应为 16,这是另一种计数口径。
题目 003
来源:知识点练习「数据结构」第 3 题(原站入口)。
下图二叉树若用一维数组顺序存储,结点间的关系由下标表示:下标为 i 的结点,其左、右孩子下标分别为 2i、2i+1。数组至少需要(2)个存储位置。若改用三叉链表,每个结点包含数据、父结点指针、左孩子指针和右孩子指针,则全部结点的空指针总数为(3)。
请作答:第 3 题。
-
A. 6
-
B. 8
-
C. 12
-
D. 14
答案与解析
平台答案:B。
整理解析
本问选 B。图中有 n=6 个结点,共 3n=18 个指针域。5 条父子边各占一个孩子指针和一个父指针,非空指针为 2(n−1)=10 个,故空指针有 18−10=8 个,即 n+2;根的父指针也计为空。
同材料可参照第 2 题。
题目 022
展开题目 022(先作答,再查看解析)
来源:知识点练习「数据结构」第 22 题(原站入口)。
一棵二叉树的高度按层数计为 h,下列关于它的结点数量的说法正确的是( )。
-
A. 有2h个节点
-
B. 有2h-1个节点
-
C. 最少有2h-1个节点
-
D. 最多有2h-1个节点
答案与解析
平台答案:D。
整理解析
选 D。第 i 层最多有 2i−1 个结点,h 层相加为 1+2+…+2h−1=2h−1,满二叉树达到该上限。非空树高度为 h 时最少只需 h 个结点,即一条单枝链。
题目 028
展开题目 028(先作答,再查看解析)
来源:知识点练习「数据结构」第 28 题(原站入口)。
恰好包含 3 个结点的二叉树,共有( )种不同形态。
-
A. 2
-
B. 3
-
C. 5
-
D. 7
答案与解析
平台答案:C。
整理解析
选 C。二叉树区分左、右孩子。除根外的两个结点可分配为左 0 右 2、左 1 右 1、左 2 右 0,对应 2、1、2 种,共 5 种。这里计算树形,不给结点附加不同标签。
题目 037
展开题目 037(先作答,再查看解析)
来源:知识点练习「数据结构」第 37 题(原站入口)。
一棵二叉树用二叉链表存储,每个结点有分别指向左、右孩子的两个指针。若树中有 k 个结点,全部结点的空孩子指针共有( )个。
-
A. k-1
-
B. k
-
C. k+1
-
D. 2k
答案与解析
平台答案:C。
整理解析
对非空树选 C。k 个结点共有 2k 个孩子指针域,而树的 k−1 条边恰好占用 k−1 个非空孩子指针,因此空指针为 2k−(k−1)=k+1。这个计数针对 k≥1;空树没有结点内部的指针域,外部根指针是另一种统计口径。
题目 041
展开题目 041(先作答,再查看解析)
来源:知识点练习「数据结构」第 41 题(原站入口)。
把图示二叉树按顺序存储方式放入数组 MEM。已知 A、B、C 的下标依次为 1、2、3,那么 D、E、F 的下标依次是多少?
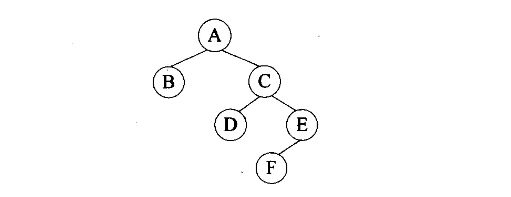
- A. 4、5、6
- B. 4、7、10
- C. 6、7、8
- D. 6、7、14
答案与解析
平台答案:D。
整理解析
数组从 1 起编号时,下标 i 的左、右孩子位置分别为 2i、2i+1,缺失孩子的位置仍需保留。原图中 D、E 是 C 的左右孩子,因此为 6、7;F 是 E 的左孩子,下标为 2×7 = 14,选 D。已核对题干指定的 2018-05/d137… 原图,不能把实际结点按层简单挤紧编号。
题目 049
展开题目 049(先作答,再查看解析)
来源:知识点练习「数据结构」第 49 题(原站入口)。
已知 3 个结点的二叉树有 5 种形态,按同样的计数规则,4 个结点的二叉树共有多少种?
- A. 10
- B. 11
- C. 14
- D. 15
答案与解析
平台答案:C。
整理解析
按区分左右子树、只计形状的规则,固定根后剩余 3 个结点可按 (0,3)、(1,2)、(2,1)、(3,0) 分配。空树、1、2、3 结点树的数量依次为 1、1、2、5,故总数为 1×5+1×2+2×1+5×1=14,选 C。一般式为 T(n)=ΣT(m)T(n−1−m),m 从 0 到 n−1,T(0)=1。纠错:平台文字说明把乘积首项误写成 A[N],应为 A[M];其公式图片本身正确。
题目 053
展开题目 053(先作答,再查看解析)
来源:知识点练习「数据结构」第 53 题(原站入口)。
一棵树有 n 个结点,所有非叶子结点都恰有 k 棵子树,即这些结点的度均为 k。叶子数应如何表示?
- A. [n(k+1)−1]/k
- B. [n(k+1)+1]/k
- C. [n(k−1)+1]/k
- D. [n(k−1)−1]/k
答案与解析
平台答案:C。
整理解析
设非叶子数为 I,树的边数既是 n−1,也是 kI,所以 I=(n−1)/k。叶子数为 n−I=[n(k−1)+1]/k,选 C。公式采用 k≥1 的通常情形,且实际树须满足 n−1 能被 k 整除。
题目 064
展开题目 064(先作答,再查看解析)
来源:知识点练习「数据结构」第 64 题(原站入口)。
在二叉树结点总数固定时,下列哪一类树一定能达到最小高度?
- A. 二叉排序树
- B. 完全二叉树
- C. 线索二叉树
- D. 最优二叉树
答案与解析
平台答案:B。
整理解析
高度为 h 的二叉树最多容纳 2h−1 个结点。完全二叉树逐层尽量填满,达到给定结点数所允许的最小高度,选 B。它不一定是唯一达到该高度的形状;排序、线索化或最小带权路径长度都不直接保证最小高度。
题目 068
展开题目 068(先作答,再查看解析)
来源:知识点练习「数据结构」第 68 题(原站入口)。
二叉树高度按层数计算:空树为 0,仅根结点为 1。若共有 1024 个结点,高度可以取哪个整数区间中的任一值?
- A. (10,1024)
- B. [10,1024]
- C. (11,1024)
- D. [11,1024]
答案与解析
平台答案:D。
整理解析
10 层最多容纳 210−1=1023 个结点,因此最小高度是 11;将全部 1024 个结点连成单支树可达到高度 1024,两个端点均可取,中间整数高度也可构造,选 D。纠错:最大高度来自同一棵树的一条长链,不能按平台所说把 1024 棵单结点树的高度相加。
题目 072
展开题目 072(先作答,再查看解析)
来源:知识点练习「数据结构」第 72 题(原站入口)。
树 T 的度为 4,其中度为 4、3、2、1 的结点数分别为 7、5、8、10。T 有多少个叶子结点?原题注释把“结点的度”描述成树中结点个数,并将结点度的最大值称为树的度。
- A. 30
- B. 35
- C. 40
- D. 49
答案与解析
平台答案:C。
整理解析
记叶子数为 n0。树的边数等于各结点孩子数之和,也等于总结点数减 1,因此 n0=1+(4−1)×7+(3−1)×5+(2−1)×8+(1−1)×10=40,选 C。纠错:结点的度是它的孩子或子树数量,不是整棵树的结点数;本题为度最大 4 的一般树,平台也不应称其为二叉树题。
五、二叉树的遍历与重建
四种遍历:明确根的访问时机
| 遍历 | 顺序 | 常见实现 |
|---|---|---|
| 前序/先序 | 根、左、右 | 递归或栈 |
| 中序 | 左、根、右 | 递归或栈 |
| 后序 | 左、右、根 | 递归或栈 |
| 层次 | 从上到下,每层从左到右 | 队列 |
“根”指每次递归的**当前子树根**,不是只访问一次整棵树的根。每个结点访问一次,遍历时间为 O(n)。
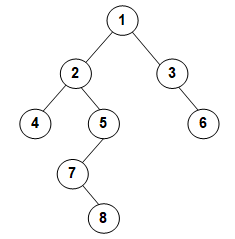
原思考:图中层次、前序、中序、后序遍历结果分别是什么?
参考答案与推导:沿子树逐步展开
- 层次:
1,2,3,4,5,6,7,8。 - 前序:
1,2,4,5,7,8,3,6。 - 中序:
4,2,7,8,5,1,3,6。 - 后序:
4,8,7,5,2,6,3,1。
读图要注意:5 的左孩子是 7,7 的右孩子是 8,3 只有右孩子 6。例如 5 的子树中序是 7,8,5,后序是 8,7,5。
用中序划分左右子树
当结点标识**互异**且序列合法时,“前序+中序”或“后序+中序”可以唯一重建二叉树:前序第一个/后序最后一个确定根,在中序中找到根的位置,然后递归处理左右两部分。
只有前序与后序通常不能唯一重建,例如单个孩子位于左侧还是右侧无法区分。存在重复结点值时,即使有中序,也不能不加条件地保证唯一。
结点标识互异且序列合法时,**层序+中序**也能重建:层序第一个是根;用根切开中序后,分别筛选属于左、右子树的层序元素,保留原来的相对次序,再对子树重复。例如层序 PQRSTU、中序 SQTPUR,根 P 把中序分为 SQT 与 UR;左侧层序筛成 QST,右侧筛成 RU,于是 P 的孩子为 Q、R,Q 的孩子为 S、T,R 的左孩子为 U。不能按左右子树的结点数直接截断原层序,因为同层的左右结点会交错出现。
原例:前序 ABHFDECG,中序 HBEDFAGC。
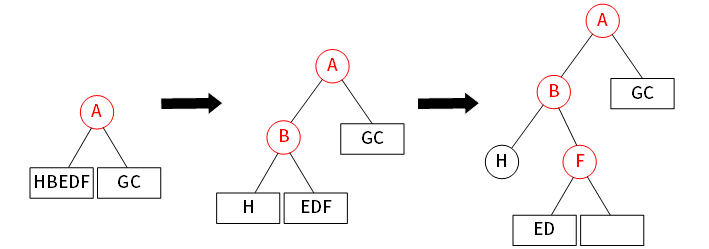
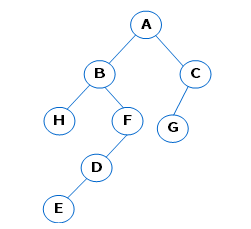
A 为根,中序分成左侧 HBEDF 与右侧 GC;左子树根 B,右子树根 C。继续划分得到 B 的左孩子 H、右孩子 F,F 的左孩子 D,D 的左孩子 E,C 的左孩子 G。后序可检验为 HEDFBGCA。
例题 11:由先序和中序求后序
某二叉树的中序、先序遍历序列分别为{20,30,10,50,40}、{10,20,30,40,50},则该二叉树的后序遍历序列为( )。
A、50,40,30,20,10 B、30,20,10,50,40
C、30,20,50,40,10 D、20,30,10,40,50
参考答案与解析
答案:C。 根为 10;中序中 10 左侧的 20,30 是左子树,右侧的 50,40 是右子树。
左子树根为 20、右孩子为 30,后序为 30,20;右子树根为 40、左孩子为 50,后序为 50,40;最后访问根 10,合并得到 30,20,50,40,10。
专项题库练习(6 题)
本小节对应题库练习共 6 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 013
来源:知识点练习「数据结构」第 13 题(原站入口)。
某二叉树的先序遍历为 c、a、b、f、e、d、g,中序遍历为 a、b、c、d、e、f、g。该树属于( )。
-
A. 完全二叉树
-
B. 最优二叉树
-
C. 平衡二叉树
-
D. 满二叉树
答案与解析
平台答案:C。
整理解析
选 C。由两种遍历还原:根为 c,左子树为 a 的右孩子 b;右子树根为 f,左孩子 e 的左孩子为 d,右孩子为 g。每个结点的左右子树高度差均不超过 1,且中序有序,符合平衡二叉查找树。a 无左孩子却有右孩子,因此不是完全二叉树,也不是满二叉树。
题目 018
来源:知识点练习「数据结构」第 18 题(原站入口)。
对于非空二叉树,D 表示根结点,L、R 分别表示左、右子树。图示二叉树的遍历结果是 7、6、5、4、3、2、1,对应的遍历方式为( )。
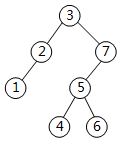
-
A. LRD
-
B. DRL
-
C. RLD
-
D. RDL
答案与解析
平台答案:D。
整理解析
选 D,即递归按右子树、根、左子树访问。图中根为 3,右子树按此规则得到 7、6、5、4,然后访问 3,最后左子树得到 2、1,合起来正是题设序列。
题目 034
来源:知识点练习「数据结构」第 34 题(原站入口)。
一棵二叉树的先序遍历为 ABCDEF,中序遍历为 BADCFE。该树的高度(层数)是( )。
-
A. 3
-
B. 4
-
C. 5
-
D. 6
答案与解析
平台答案:B。
整理解析
选 B。先序首结点 A 为根,中序将其分为左子树 B 和右子树 DCFE;右子树根为 C,其左孩子 D、右孩子 E,E 的左孩子为 F。最长根叶路径 A→C→E→F 含 4 个结点,因此高度为 4 层。
题目 044
来源:知识点练习「数据结构」第 44 题(原站入口)。
某二叉树的先序序列为 ABCDEF,中序序列为 BADCFE。依据这两种遍历,可以确定下列哪项成立?
- A. 是单支树,即每个非叶子结点都只有一个孩子
- B. 高度为 4,即共有 4 层结点
- C. 根的左子树为空
- D. 根的右子树为空
答案与解析
平台答案:B。
整理解析
先序首项 A 是根,中序在 A 左侧只有 B。右子树根为 C,其左孩子是 D、右孩子是 E,E 的左孩子为 F。因此最长根到叶路径为 A→C→E→F,共 4 层,选 B。根两侧均非空,且 A、C 都有两个孩子,不是单支树。
题目 052
来源:知识点练习「数据结构」第 52 题(原站入口)。
某二叉树的中序序列为 {20,30,10,50,40},先序序列为 {10,20,30,40,50}。它的后序遍历序列是哪项?
- A. 50,40,30,20,10
- B. 30,20,10,50,40
- C. 30,20,50,40,10
- D. 20,30,10,40,50
答案与解析
平台答案:C。
整理解析
先序首项 10 为根。中序将左侧分成 20、30,右侧分成 50、40;左子树根 20 的右孩子为 30,右子树根 40 的左孩子为 50。按左、右、根进行后序遍历,得到 30、20、50、40、10,选 C。
题目 075
来源:知识点练习「数据结构」第 75 题(原站入口)。
m、n 是同一棵二叉树中的两个结点。要使中序遍历时 n 先于 m,下列哪项符合题目对左右位置的描述?
- A. m 是 n 的祖先
- B. m 是 n 的子孙
- C. m 在 n 的左边
- D. m 在 n 的右边
答案与解析
平台答案:D。
整理解析
中序按左子树、根、右子树访问,按题目通常的左右位置用语选 D;只有祖先或子孙关系并不能决定顺序。严谨地说,应是 n 在 m 的左子树、m 在 n 的右子树,或两者分别处在最近公共祖先的左、右子树。任意画图坐标中的“右边”本身不是可通用的判据。
六、二叉搜索树、AVL 树与哈夫曼树
二叉搜索树:约束整棵子树
二叉搜索树(BST),也称二叉排序树、二叉查找树。以下约定关键字互异:
- 左子树中**所有**关键字小于当前根。
- 右子树中**所有**关键字大于当前根。
- 左右子树也分别满足同样约束。
只比较直接孩子是不够的。例如根为 10,左孩子为 5,5 的右孩子为 12,虽然两条父子边各自看似符合大小关系,但 12 位于 10 的左子树,整棵树不是 BST。有重复值时,必须额外约定重复值存放方向或计数方式。
BST 中序遍历得到递增序列;最小值结点无左孩子,最大值结点无右孩子。同一层从左到右的关键字也递增:任意两个同层结点在其最近公共祖先的两侧,左子树全部小于该祖先,右子树全部大于该祖先。
插入时**从根一路比较**,向左或向右下降,直到遇到空位置,再建立新结点;不能只比较最终父结点就跳过祖先限制。
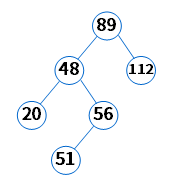
相同数据,不同插入顺序可能得到不同树形:
89,48,112,20,56,51得到图中树,高度为 4 层。112,89,56,51,48,20会形成向左的单支链,高度为 6 层。
查找、插入和删除通常为 O(h),h 是当前高度;一般 BST 最坏可以退化为 O(n),不能一概写成 O(log n)。
例题 12:由插入序列判断 BST
可以构造出下图所示二叉排序树(二叉检索树、二叉查找树)的关键码序列是( )。
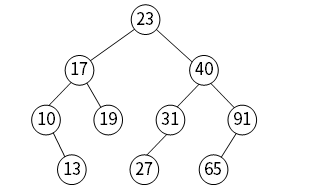
A、10 13 17 19 23 27 31 40 65 91
B、23 40 91 17 19 10 31 65 27 13
C、23 19 40 27 17 13 10 91 65 31
D、27 31 40 65 91 13 10 17 23 19
参考答案与解析
答案:B。 第一个插入的关键字必须是根 23,排除 A、D。左子树第一个插入的关键字必须是 17,C 却先插入 19,因此也不符合。
验证 B:左侧建立 17→左10/右19,13 成为 10 的右孩子;右侧以 40 为根,左孩子 31、右孩子 91,再分别插入 27 和 65,吻合题图。
例题 13:BST 的性质
以下关于二叉排序树(或二叉查找树、二叉搜索树)的叙述中,正确的是( )。
A、对二叉排序树进行先序、中序和后序遍历,都得到节点关键字的有序序列
B、含有n个节点的二叉排序树高度为⌊log2n⌋+1
C、从根到任意一个叶子节点的路径上,节点的关键字呈有序排列的特点
D、从左到右排列同层次的节点,其关键字呈有序排列的特点
参考答案与解析
答案:D。 A 只有中序遍历保证递增;B 把完全二叉树的高度公式套给一般 BST;C 中根到叶路径可以先向左再向右,例如 23→17→19 并非单调序列。
D 成立的原因是整棵子树的大小约束。不要误推成“整个层序遍历序列递增”,不同层之间没有这样的保证。
补充:平衡二叉搜索树 AVL
章节回顾提到了平衡二叉树。AVL 树是 BST,每个结点左右子树高度之差的绝对值不超过 1;常用平衡因子为“左高−右高”,取值为 −1、0、1。
插入、删除破坏平衡时用旋转恢复:LL 型通常右旋,RR 型左旋,LR 型先左旋再右旋,RL 型先右旋再左旋。旋转保持中序顺序和 BST 性质。AVL 的高度为 O(log n),因而查找、插入、删除为 O(log n)。平衡不等于完全,AVL 不要求按层从左到右填满。
给定高度求**最少结点数**时,设空树高度为 0、单结点高度为 1。高度 h 的根至少有一棵高 h−1 的子树;为了满足高度差至多 1,另一棵最矮为 h−2。两边都取各自最少结点形态,便有 N(0)=0、N(1)=1、N(h)=1+N(h−1)+N(h−2)(h≥2)。逐项得到 0、1、2、4、7、12、20,所以高 6 的 AVL 最少 20 个结点,而同高满二叉树有 63 个。单支链只符合一般二叉树的最低数量要求,高度超过 2 就不再是 AVL。
B 树与 B+ 树:多路平衡查找
B 树(也写 B-树,其中短横不是减号)是多路平衡查找树;一个结点含多个有序关键字,关键字之间的区间对应不同子树。按本章“m 阶=最多 m 个孩子”的约定,每个结点最多有 m−1 个关键字;非根结点至少有 ⌈m/2⌉−1 个关键字,非叶根至少有两个孩子,根本身为叶子时另论。所有叶子同层,插入或删除通过分裂、借位或合并维持这些条件。
| 对比 | B 树 | 常见 B+ 树 |
|---|---|---|
| 数据条目 | 内部结点与叶子均可保存 | 全部数据条目在叶层,内部结点用于索引导航 |
| 查找终点 | 可能在内部结点命中 | 沿索引下降到叶层 |
| 叶子链 | 定义不要求叶子串成有序链 | 叶子通常顺序相连,方便范围扫描 |
多关键字结点适合按磁盘页组织,较大的分支数可降低树高和访问页数;这也是数据库索引常采用这类结构的原因。它们均不是二叉树,不能套用 2i、2i+1 的孩子位置公式。
哈夫曼树:让高频字符使用短码
从根到某结点经过的边数是路径长度,根的路径长度为 0。若叶子 i 的权为 wᵢ、路径长度为 lᵢ,则带权路径长度:
WPL = Σ wᵢ·lᵢ。
给定叶子权值,使 WPL 最小的二叉树称为**哈夫曼树/最优二叉树**;目标是加权总代价最小,并非单纯让树高最小。L 个叶子的标准二叉哈夫曼树没有单孩子结点,故有 L−1 个内部结点、共 2L−1 个结点。同权重叶子不一定同深度;较大权重的叶子也可能与较小权重的叶子同深度。
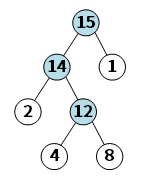
课件把“树的路径长度”写为“所有叶子路径长度之和”;不少教材会把所有结点都计入“树的路径长度”。本节计算哈夫曼代价时明确使用**叶子的带权路径长度 WPL**,避免混淆。
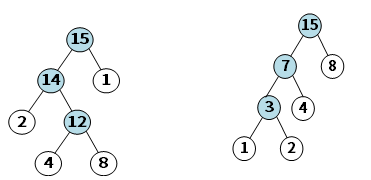
原思考:上图两棵树的代价分别是多少?
参考答案与推导:带权路径长度
第一棵树:1×1+2×2+4×3+8×3=41。
第二棵树:1×3+2×3+4×2+8×1=25。
相同叶子权值的二叉树中,WPL 最小的树称哈夫曼树/最优二叉树。把权较大的叶子安排在较浅处,有利于减小总代价。
哈夫曼算法使用贪心策略:每次取权值最小的两棵树,合并成一个新父结点,其权为两者之和;放回候选集合,重复直到只剩一棵树。内部结点都是二分合并生成,因此无度为 1 的结点。
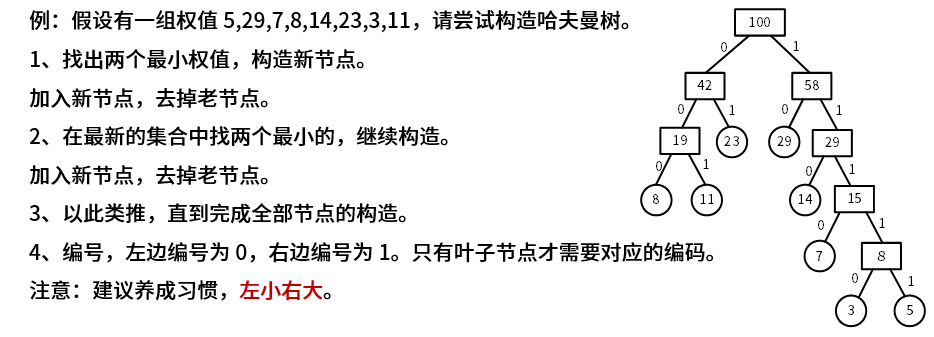
图中一组合法合并过程为 3+5=8,7+8=15,8+11=19,14+15=29,19+23=42,29+29=58,42+58=100;所有合并权之和 8+15+19+29+42+58+100=271,等于最终 WPL。
从根到叶路径上的 0、1 组成字符编码。约定左边为 0、右边为 1 后即可读码;“左小右大”只是选树的一种习惯,交换左右孩子仍得到等价的最优编码。权值相同时也可能有不同树形,因此最优编码通常不唯一。
由于字符只放在叶子上,一个字符的码字不会是另一个字符码字的前缀,这称为**前缀码**。WPL 除以总频数可得平均码长;文件真实大小还可能包括码表、文件头和字节对齐开销。
给定码表后,编码是拼接字符的码字;译码则从根逐位走,走到叶子输出字符并回到根。例如前缀码 p=0、q=10、r=110、s=111,位串 101110 可切为 10|111|0,译为 qsp。前缀性质保证在**码表固定**时无须分隔符即可唯一译码,不意味着仅凭频率就唯一确定 0/1 标记。
有 q 种字符时,最短定长二进制编码每字符需 ⌈log₂q⌉ 位(通常 q≥2)。设原码长为 b,压缩后平均码长为 L,则“压缩后/压缩前”为 L/b,“节省比例”为 1−L/b。例如原来每字符 4 位,平均改成 3 位,前者为 75%,后者为 25%;必须先明确指标和原始编码,不能混用。
例题 14:霍夫曼编码与压缩口径
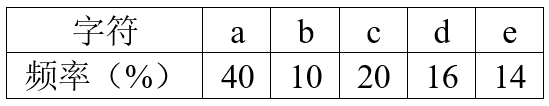
已知某文档包含5个字符,每个字符出现的频率如下表所示。采用霍夫曼编码对该文档压缩存储,则单词“cade”的编码为( ),文档的压缩比为( )。

第一空:A、1110110101 B、1100111101 C、1110110100 D、1100111100
第二空:A、20% B、25% C、27% D、30%
参考答案与解析:编码确定,压缩比需说明基准
课件提供的编码树如下:
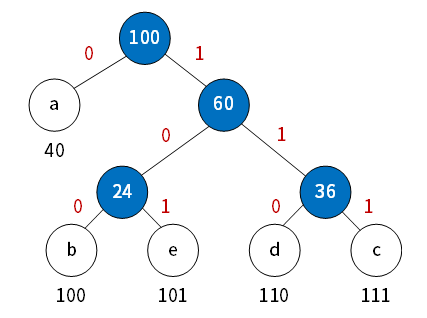
第一空按课件编码树选 A;第二空按“相对 3 位定长编码节省的比例”理解,对应 C,约 27%。题干没有明确压缩比的定义和原始编码基准,计算时应注明这一条件。
表中频率为 a:40%,b:10%,c:20%,d:16%,e:14%。依次合并 10+14=24,16+20=36,24+36=60,40+60=100。按题图左 0 右 1,得到:
| 字符 | a | b | c | d | e |
|---|---|---|---|---|---|
| 编码 | 0 | 100 | 111 | 110 | 101 |
因而 cade = 111 · 0 · 110 · 101 = 1110110101。没有给定编码树或左右分配规则时,不能仅凭频率认定码字唯一;本题用课件提供的树明确规则。
平均码长为 0.40×1+(0.10+0.20+0.16+0.14)×3=2.2 位/字符。5 个字符采用最短**定长二进制编码**需要 ⌈log₂5⌉=3 位/字符。若“压缩比”指节省比例,则为 (3−2.2)/3≈26.67%,近似为 C 的 27%。
若定义为“压缩后/压缩前”,在相同基准下应是 2.2/3≈73.33%;若原始编码为每字符 8 位,则为 2.2/8=27.5%,节省比例为 72.5%。这些是不同指标,不能混算,也不能把 8 位基准当作题干已给条件。以上均暂不计码表和文件头开销。
专项题库练习(15 题)
本小节对应题库练习共 15 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 007
来源:知识点练习「数据结构」第 7 题(原站入口)。
对二叉查找树(二叉排序树)进行查找时,哪一种树形会造成最差的查找效率( )?
-
A. 完全二叉树
-
B. 平衡二叉树
-
C. 单枝树
-
D. 满二叉树
答案与解析
平台答案:C。
整理解析
选 C。单枝树退化为一条长度为 n 的链,最坏需比较 n 个结点,查找为 O(n)。高度受控的平衡树能将最坏查找路径降至 O(log n)。
题目 009
来源:知识点练习「数据结构」第 9 题(原站入口)。
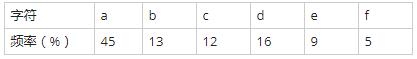
某文件的字符及其出现频率见下表。若使用二进制定长编码,每个字符需要(9)位;若使用 Huffman 编码,字符序列“face”的编码为(10)。
请作答:第 9 题。
-
A. 2
-
B. 3
-
C. 4
-
D. 5
答案与解析
平台答案:B。
整理解析
本问选 B。图中有 a、b、c、d、e、f 共 6 种字符,二进制定长码需要满足 2b≥6,最小 b 为 3。频率 45%、13%、12%、16%、9%、5% 用于后一问的不等长编码,不改变定长码的最低位数。
题目 010
展开题目 010(先作答,再查看解析)
来源:知识点练习「数据结构」第 10 题(原站入口)。
某文件的字符及其出现频率见下表。若使用二进制定长编码,每个字符需要(9)位;若使用 Huffman 编码,字符序列“face”的编码为(10)。
请作答:第 10 题。
-
A. 110001001101
-
B. 001110110011
-
C. 101000010100
-
D. 010111101011
答案与解析
平台答案:A。
整理解析
按平台使用的码表,a=0、b=101、c=100、d=111、e=1101、f=1100,故 face=1100|0|100|1101,选 A。哈夫曼合并权重为 5+9=14、12+13=25、14+16=30、25+30=55、45+55=100。频率并不唯一确定各边标 0 还是 1,题干未给分支约定;A 是选项中可由该哈夫曼树产生的编码,不应把这张具体码表说成唯一结果。
同材料可参照第 9 题。
题目 021
展开题目 021(先作答,再查看解析)
来源:知识点练习「数据结构」第 21 题(原站入口)。
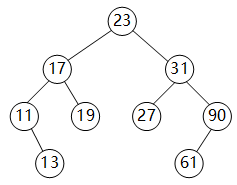
依次插入关键码以建立图示二叉排序树(二叉查找树),下列哪个序列不可能得到该树( )?
-
A. 23 31 17 19 11 27 13 90 61
-
B. 23 17 19 31 27 90 61 11 13
-
C. 23 17 27 19 31 13 11 90 61
-
D. 23 31 90 61 27 17 19 11 13
答案与解析
平台答案:C。
整理解析
选 C。图中根为 23,右子树根为 31。C 在插入 23、17 后就插入 27,此时 27 会占据 23 的右孩子位置,随后插入 31 也不会把它改成图示结构。其余三组按二叉查找树规则插入都能得到原图。
题目 029
展开题目 029(先作答,再查看解析)
来源:知识点练习「数据结构」第 29 题(原站入口)。
关于二叉排序树(也称二叉查找树、二叉搜索树),下列说法正确的是( )。
-
A. 对二叉排序树进行先序、中序和后序遍历,都得到结点关键字的有序序列
-
B. 含有n个结点的二叉排序树高度为[log2n]+1
-
C. 从根到任意一个叶子结点的路径上,结点的关键字呈现有序排列的特点
-
D. 从左到右排列同层次的结点,其关键字呈现有序排列的特点
答案与解析
平台答案:D。
整理解析
选 D。同层从左到右的任意两个结点,在其最近公共祖先处分别落入左、右子树,故关键字按该方向有序。二叉查找树只有中序遍历保证有序;高度可退化为 n;根到叶的路径也可先减后增,如 30→19→25。左子树所有关键字受祖先约束,不能像平台解析的部分措辞那样仅理解为父子大小关系。
题目 030
展开题目 030(先作答,再查看解析)
来源:知识点练习「数据结构」第 30 题(原站入口)。
某文件中各字符的出现频率见下表。按霍夫曼编码,字符序列“bee”的编码为(30);位串“110001001101”对应的字符序列为(31)。
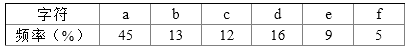
请作答:第 30 题。
-
A. 10111011101
-
B. 10111001100
-
C. 001100100
-
D. 110011011
答案与解析
平台答案:A。
整理解析
平台选 A。其码表取 b=101、e=1101,故 bee=101|1101|1101。原题只给频率,未指定分支 0/1 的标记;把同一哈夫曼树中 e、f 的边标互换,令 e=1100、f=1101,仍是合法最优前缀码,此时 bee=101|1100|1100,正好是 B。因此单独按题干不能唯一排除 B,A 依赖平台使用的具体码表。
题目 031
展开题目 031(先作答,再查看解析)
来源:知识点练习「数据结构」第 31 题(原站入口)。
某文件中各字符的出现频率见下表。按霍夫曼编码,字符序列“bee”的编码为(30);位串“110001001101”对应的字符序列为(31)。
请作答:第 31 题。
-
A. bad
-
B. bee
-
C. face
-
D. bace
答案与解析
平台答案:C。
整理解析
按平台码表 a=0、b=101、c=100、d=111、e=1101、f=1100,位串可唯一切分为 1100|0|100|1101,即 face,选 C。“唯一解码”以码表已确定为前提;仅给字符频率而未给分支标记,不能认为位串的译文天然唯一。本问与第 30 题共用材料,但作答内容和选项不同。
同材料可参照第 30 题。
题目 036
展开题目 036(先作答,再查看解析)
来源:知识点练习「数据结构」第 36 题(原站入口)。
一条消息只含 7 种字符 {a,b,c,d,e,f,g},对应出现次数为 {5,24,8,17,34,4,13}。用哈夫曼树(最优二叉树)为这 7 种字符构造满足前缀编码条件的不等长编码,下列哪组字符码长符合要求( )?
-
A. a:4,b:2,c:3,d:3,e:2,f:4,g:3
-
B. a:6,b:2,c:5,d:3,e:1,f:6,g:4
-
C. a:3,b:3,c:3,d:3,e:3,f:2,g:3
-
D. a:2,b:6,c:3,d:5,e:6,f:1,g:4
答案与解析
平台答案:A。
整理解析
选 A。一种合法合并顺序为 4+5=9、8+9=17、13+17=30、17+24=41、30+34=64、41+64=105;其中把原字符 d 的权重 17 与 13 合并,可得 a、b、c、d、e、f、g 的码长 4、2、3、3、2、4、3,加权路径长度为 266。中途有两个权重 17,另一种合并也可能得到不同码长的最优树,故 A 是选项中的正确方案,不是唯一最优码长分配。平台解析图将 13+17 标为 29,应为 30。
题目 045
展开题目 045(先作答,再查看解析)
来源:知识点练习「数据结构」第 45 题(原站入口)。
从空树开始,依次插入下列哪组关键码,能得到图中的二叉排序树(又称二叉检索树、二叉查找树)?
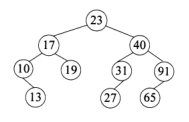
- A. 10 13 17 19 23 27 31 40 65 91
- B. 23 40 91 17 19 10 31 65 27 13
- C. 23 19 40 27 17 13 10 91 65 31
- D. 27 31 40 65 91 13 10 17 23 19
答案与解析
平台答案:B。
整理解析
图中根为 23,因此首项为 10、27 的 A、D 不符;C 会先把 19 放成根的左孩子,而原图该位置是 17。逐项插入 B 可得到左侧 17 的孩子 10、19,10 的右孩子 13;右侧 40 的孩子 31、91,31 的左孩子 27、91 的左孩子 65,与原图一致,选 B。
题目 056
展开题目 056(先作答,再查看解析)
来源:知识点练习「数据结构」第 56 题(原站入口)。
某文档使用 5 种字符,字符及出现频率见表:a、b、c、d、e 分别为 40%、10%、20%、16%、14%。采用 Huffman 编码压缩,第(56)空求单词 cade 的编码,第(57)空求文档的“压缩比”。本题回答第(56)空。
- A. 1110110101
- B. 1100111101
- C. 1110110100
- D. 1100111100
答案与解析
平台答案:A。
整理解析
按平台解析选择的码表,a=0、b=100、c=111、d=110、e=101,所以 cade 连接为 111|0|110|101,即 A。题面条件不足:仅给频率不能唯一确定每条分支的 0/1,互换 c、d 的左右位置或 b、e 的左右位置不会改变最优码长,四个选项都可对应合法 Huffman 码表。平台 A 依赖其采用的分支约定,不能说原题无条件只有 A。
题目 057
展开题目 057(先作答,再查看解析)
来源:知识点练习「数据结构」第 57 题(原站入口)。
某文档使用 5 种字符,字符及出现频率见表:a、b、c、d、e 分别为 40%、10%、20%、16%、14%。采用 Huffman 编码压缩,第(56)空求单词 cade 的编码,第(57)空求文档的“压缩比”。本题回答第(57)空。
- A. 20%
- B. 25%
- C. 27%
- D. 30%
答案与解析
平台答案:C。
整理解析
若压缩前用最短定长二进制码表示 5 种字符,每字符需 3 位。Huffman 合并权重为 10+14=24、16+20=36、24+36=60、40+60=100,得到 a 长 1 位、其余长 3 位,平均为 0.4×1+0.6×3=2.2 位。节省率为 (3−2.2)/3≈26.67%,取整约 27%,选 C。纠错与口径:这实际是空间节省率;压缩后/压缩前为约 73.33%,且计算未计码表、文件头等开销。
题目 058
展开题目 058(先作答,再查看解析)
来源:知识点练习「数据结构」第 58 题(原站入口)。
以下关于 Huffman 树的说法,哪项错误?
- A. 叶子权值越大,离根越近
- B. 不存在只有一棵子树的结点
- C. 树的结点总数一定为奇数
- D. 权值相同的结点到根的路径长度一定相同
答案与解析
平台答案:D。
整理解析
平台选 D:例如 3 个叶子的权重全为 1,Huffman 树的叶深可以是 1、2、2,同权值不保证同深度。标准二叉 Huffman 树每次合并两个结点,没有度为 1 的结点,叶子数为 L 时总数为 2L−1。表述限定:A 的“越近”应理解为较大权重的叶深不更大,可能相等,并非权值一增大就严格更靠近根。
题目 070
展开题目 070(先作答,再查看解析)
来源:知识点练习「数据结构」第 70 题(原站入口)。
文件中字符 a、b、c、d、e、f 的频率见表,依次为 45%、13%、12%、16%、9%、5%。采用 Huffman 编码,第(70)空求 a、c 的码长;第(71)空给出比特序列 110001001101 并询问其“编码”,选项为字符序列。本题回答第(70)空,两个长度依次对应 a、c。

- A. 1 和 3
- B. 1 和 4
- C. 3 和 3
- D. 3 和 4
答案与解析
平台答案:A。
整理解析
依次合并最小权重:5+9=14、12+13=25、14+16=30、25+30=55、45+55=100。a 位于根下一层,c 从权重 12 经 25、55 到根,故码长分别为 1、3,选 A。分支的 0/1 标号可交换,但不改变这里的码长。
题目 071
展开题目 071(先作答,再查看解析)
来源:知识点练习「数据结构」第 71 题(原站入口)。
文件中字符 a、b、c、d、e、f 的频率见表,依次为 45%、13%、12%、16%、9%、5%。采用 Huffman 编码,第(70)空求 a、c 的码长;第(71)空给出比特序列 110001001101 并询问其“编码”,选项为字符序列。本题回答第(71)空。
- A. face
- B. bace
- C. acde
- D. fade
答案与解析
平台答案:A。
整理解析
按平台解析所采用的码表,f=1100、a=0、c=100、e=1101,故比特串可分为 1100|0|100|1101,译为 face,选 A。纠错:由比特恢复字符是译码,不是题干所称的编码。仅给频率仍不足以固定左右分支的 0/1,这一具体译码依赖平台码表,不能视为未约定码表时的唯一结果。
同材料可参照第 70 题。
题目 077
展开题目 077(先作答,再查看解析)
来源:知识点练习「数据结构」第 77 题(原站入口)。
对于 m 阶 B-树,以下哪项说法错误?
- A. 根最多有 m 棵子树
- B. 所有叶子处于同一层
- C. 结点内的关键字有序排列
- D. 叶子之间通过指针连接成有序表
答案与解析
平台答案:D。
整理解析
标准 B-树不要求把叶子串成链表,叶子链是常见 B+树的特征,故选 D。m 阶 B-树的结点最多有 m 个孩子、m−1 个关键字,叶子处于同层。表述修正:B-树是多路平衡查找树,不是平台开头所称的二叉树。
七、图的定义与存储
顶点、边、连通与完全
图由顶点集合和边集合组成。无向边没有方向;有向边/弧有起点与终点。以下边数公式针对**无自环、无重边的简单图**。
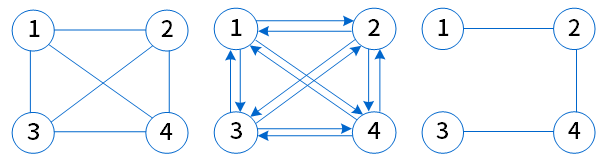
- 无向完全图每一对不同顶点都相连,n 个顶点有
n(n−1)/2条边。 - 有向完全图每一对不同顶点在两个方向均有弧,共
n(n−1)条弧。 - 无向连通图任意两个顶点之间都有路径。
- 有向图需进一步区分**强连通**(任意顶点对双向可达)与**弱连通**(忽略方向后连通),不能只说“有一条路径”而省略方向。
度数求和要按边贡献计算:每条无向边给两个端点各加 1,所以 Σ度数=2e;每条有向弧贡献一个出度和一个入度,所以 Σ入度=Σ出度=e。未要求连通时可以没有边,不能把连通图的边数下界套给所有图。
若简单无向图有 n≥2 个顶点且**不连通**,边数上界为 (n−1)(n−2)/2。把各分量内部补成完全图仍不连通;为了让边数最多,再把结点尽量集中在一个分量中,仅留下一个孤立点,得到 K(n−1)+孤立点。例如不连通图有 15 条边,6 个顶点最多只能有 10 条,7 个顶点可由 K₆ 加孤立点达到 15 条,故至少需要 7 个顶点。允许重边或自环时不能套这个上界。
邻接矩阵:行、列都对应顶点
n 个顶点使用 n×n 矩阵。无权图常以 1 表示有边、0 表示无边;带权图保存权值,并使用无穷大等标记不存在的边,需特别区分权值为 0 的边。
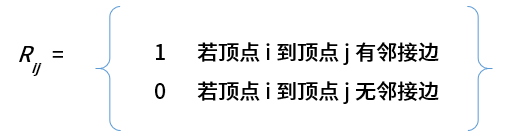
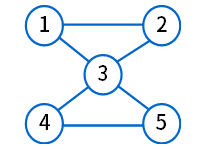
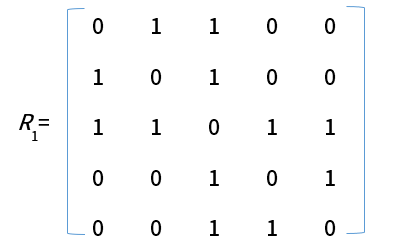
无向图的邻接矩阵对称;不对称的邻接矩阵不能表示普通无向图。但有向图若每条弧都存在反向弧,矩阵也可以对称,因此**对称不足以判断图一定无向**。矩阵空间为 O(n²),查询一条指定边为 O(1)。
邻接表:每个顶点保存相邻顶点
每个顶点维护一条邻接链表,再用数组等结构保存表头。对有向图,常见邻接表保存**出边**;保存入边的称逆邻接表。
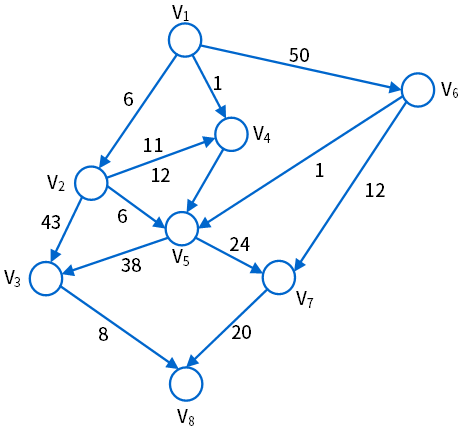
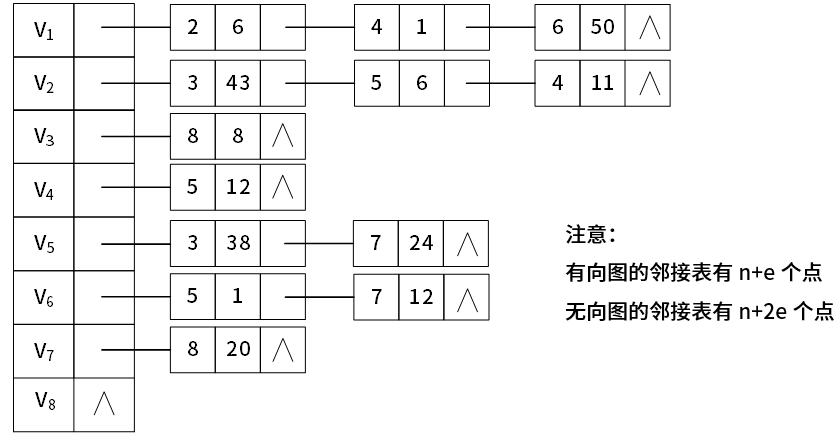
图中 V₁ 表含 (V₂,6)、(V₄,1)、(V₆,50),对应 V₁ 发出的三条弧。出边表中表结点数等于该顶点的出度,不能把入度也加进来。
图有 n 个顶点、e 条边/弧时,有向图通常存 n 个顶点记录和 e 个边记录;无向图一条边在两端各记一次,通常为 n 个顶点记录和 2e 个边记录。两者空间量级均为 O(n+e),更适合稀疏图;图中“n+e 个点”指**存储记录数**,不是图增加了顶点。
例题 15:简单无向连通图的边数
某简单无向连通图G的顶点数为n,则图G最少和最多分别有( )条边。
A、n,n²/2 B、n-1,n*(n-1)/2 C、n,n*(n-1)/2 D、n-1,n²/2
参考答案与解析
答案:B。 最少时是一棵覆盖全部顶点的树,有 n−1 条边;最多时是无向完全图,任意两个顶点形成一条边,共 C(n,2)=n(n−1)/2 条。
关键词是**简单、无向、连通**:连通给出下界,简单无向给出上界。
例题 16:邻接矩阵规模与邻接表长度
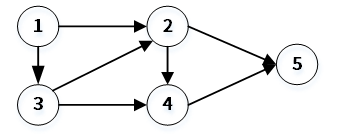
对于如下所示的有向图,其邻接矩阵是一个( )的矩阵。采用邻接链表存储时,顶点1的表节点个数为2,顶点5的表节点个数为0,顶点2和3的表节点个数分別为( )。
第一空:A、5×5 B、5×7 C、7×5 D、7×7
第二空:A、2和1 B、2和2 C、3和4 D、4和3
参考答案与解析
答案:A、B。 有 5 个顶点,因此矩阵为 5×5,与有多少条边无关。
图中出边为 1→2、1→3、2→4、2→5、3→2、3→4、4→5。顶点 2 指向 4、5;顶点 3 指向 2、4,表结点数均为 2。题干用顶点 5 的表结点数为 0 提示了“按出边建表”。
专项题库练习(7 题)
本小节对应题库练习共 7 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 019
来源:知识点练习「数据结构」第 19 题(原站入口)。
一个简单有向图有 n 个顶点、e 条弧,以邻接矩阵存储。A[i][j] 为 1 表示有从 i 到 j 的弧,为 0 表示没有,则矩阵中非零元素共有( )个。
-
A. e
-
B. 2e
-
C. n-e
-
D. n+e
答案与解析
平台答案:A。
整理解析
选 A。有向弧 i→j 只对应 A[i][j] 中的一个 1,因此 e 条弧贡献 e 个非零元素。2e 是无向图中每条普通边在对称位置各记一次时的计数。
题目 038
来源:知识点练习「数据结构」第 38 题(原站入口)。
对于无向连通图 G,下列说法不正确的是( )。
-
A. G中任意两个顶点之间均有边存在
-
B. G中任意两个顶点之间存在路径
-
C. 从G中任意顶点出发可遍历图中所有顶点
-
D. G的邻接矩阵是对称矩阵
答案与解析
平台答案:A。
整理解析
选 A。连通要求任意两点之间有路径,不要求每对顶点直接相邻;任意两点都有边是完全图的条件。无向图的邻接关系对称,连通性也保证从任意顶点可遍历全图。平台所说“不一定有边”应理解为“两点之间不一定有直接边”,不能理解为多个顶点的连通图可以一条边都没有。
题目 054
来源:知识点练习「数据结构」第 54 题(原站入口)。
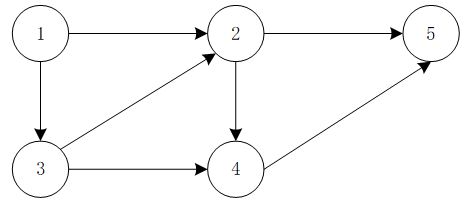
下图是一幅有向图。第(54)空询问其邻接矩阵的行列规模;采用邻接链表时,已知顶点 1 有 2 个边表结点,顶点 5 有 0 个,第(55)空依次询问顶点 2、3 的边表结点数。本题回答第(54)空。
- A. 5×5
- B. 5×7
- C. 7×5
- D. 7×7
答案与解析
平台答案:A。
整理解析
原图有 5 个顶点,邻接矩阵每一行、每一列都对应一个顶点,所以规模为 5×5,选 A。图中有多少条弧并不改变矩阵的行列数。
题目 055
来源:知识点练习「数据结构」第 55 题(原站入口)。
下图是一幅有向图。第(54)空询问其邻接矩阵的行列规模;采用邻接链表时,已知顶点 1 有 2 个边表结点,顶点 5 有 0 个,第(55)空依次询问顶点 2、3 的边表结点数。本题回答第(55)空,选项中的两个数依次对应顶点 2、3。
- A. 2、1
- B. 2、2
- C. 3、4
- D. 4、3
答案与解析
平台答案:B。
整理解析
由顶点 1 的表结点数为 2、顶点 5 为 0,可知这里按出边建立邻接表。原图中 2→4、2→5,3→2、3→4,因此两者出度都是 2,选 B。此处统计边表结点,不把顶点自身的表头算进去。
题目 062
来源:知识点练习「数据结构」第 62 题(原站入口)。
简单无向连通图 G 有 n 个顶点。它最少、最多分别能有多少条边?
- A. n,n2/2
- B. n−1,n(n−1)/2
- C. n,n(n−1)/2
- D. n−1,n2/2
答案与解析
平台答案:B。
整理解析
连通图至少含一棵生成树,需要 n−1 条边;简单无向图每对不同顶点至多一条边,最多有组合数 n(n−1)/2 条,选 B。取树和完全图时分别达到两个界限。
题目 073
来源:知识点练习「数据结构」第 73 题(原站入口)。
图 G 的邻接表中,表示边的表结点总数为奇数。按通常的邻接表存储约定,可以判断哪项?
- A. 顶点数为奇数
- B. 顶点数为偶数
- C. 是无向图
- D. 是有向图
答案与解析
平台答案:D。
整理解析
通常无向边在两个端点的邻接表中各记录一次,e 条边对应 2e 个边表结点,一定为偶数。现在表结点为奇数,按此约定应是有向图,选 D,与顶点个数的奇偶无关。纠错:平台把无向图的“边表结点数为偶数”误说成“边数为偶数”;无向图本身完全可以有奇数条边。
题目 076
来源:知识点练习「数据结构」第 76 题(原站入口)。
无向图 G 有 n 个顶点、e 条边,用邻接矩阵存储时,矩阵包含多少个元素?
- A. n*e
- B. n2
- C. n2+e2
- D. (n+e)2
答案与解析
平台答案:B。
整理解析
矩阵的行、列都按 n 个顶点编号,所以共有 n×n=n2 个元素,选 B,与边数多少无关。纠错:对无自环的普通无向图,一条边对应两个对称的非零项,二值邻接矩阵中应有 2e 个 1,平台写成 e 个不准确。
八、图的遍历与拓扑排序
DFS 与 BFS:一直深入和分层扩展
- 深度优先 DFS:访问一个未访问邻接点后继续深入,没有新的邻接点才回溯,通常用递归/栈。
- 广度优先 BFS:先访问当前顶点的所有未访问邻接点,再按发现顺序扩展它们,通常用队列。
两者都要维护访问标记;邻接点扫描顺序未指定时,合法遍历序列可能不唯一。有向图须沿箭头前进;若从一个起点不能到达所有顶点,要遍历整张图还需从未访问顶点继续启动。
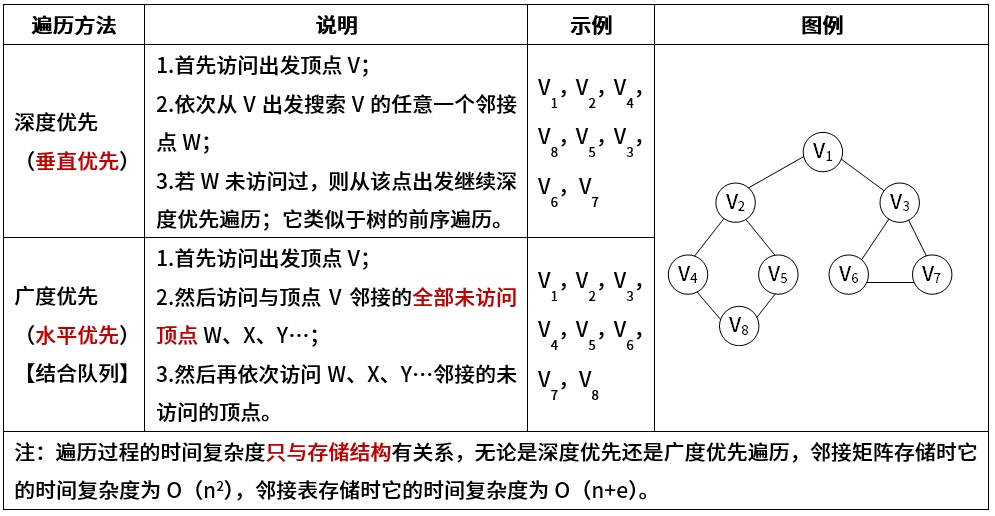
图中采用从 V₁ 起、按示例邻接顺序访问,DFS 为 V₁,V₂,V₄,V₈,V₅,V₃,V₆,V₇,BFS 为 V₁,V₂,V₃,V₄,V₅,V₆,V₇,V₈。这不是任意邻接顺序下都唯一的结果。
对完整遍历,邻接矩阵需扫描行,时间通常为 O(n²);邻接表只扫描顶点和边记录,时间为 O(n+e)。图中“时间复杂度只与存储结构有关”是针对这两种常规遍历实现的对比,实际仍取决于顶点数、边数和访问范围等。
例题 17:判断可能的 DFS 和 BFS 序列
某有向图如下所示,从顶点v1出发对其进行深度优先遍历,可能得到的遍历序列是( );从顶点v1出发对其进行广度优先遍历,可能得到的遍历序列是( )。
①v1 v2 v3 v4 v5 ②v1 v3 v4 v5 v2 ③v1 v3 v2 v4 v5 ④v1 v2 v4 v5 v3
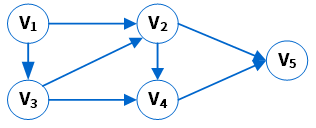
第一空:A、①②③ B、①③④ C、①②④ D、②③④
第二空:A、①② B、①③ C、②③ D、③④
参考答案与解析
答案:D、B。
DFS 的 ① 不可能:从 v1 到 v2 后,v2 还有未访问的出邻接点 v4、v5,必须继续深入,不能直接退回 v1 去访问 v3。② 可走 v1→v3→v4→v5 后回溯访问 v2;③ 可走 v1→v3→v2→v4→v5;④ 可走 v1→v2→v4→v5 后回到 v1 访问 v3。
BFS 中,v1 的一层邻接点 v2、v3 必须都先于更深层的 v4、v5 被访问,所以只有 ①、③ 符合。DFS 看是否过早回溯,BFS 看是否跳过尚未访问的同层结点。
拓扑排序:所有前置条件先出现
AOV 网用顶点表示活动,有向边表示先后依赖。对有向无环图 DAG,拓扑序列包含所有顶点恰好一次,且每条 u→v 都满足 u 在 v 前。
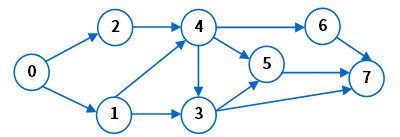
图中 02143567、01243657 是合法序列;02413657 违反 1→4,01423567 违反 2→4。
仅仅“没有直接边”不代表可任意交换:还要检查是否通过其他顶点存在**间接路径**。一个拓扑序中 u 在 v 前,并不证明 u→v 或 u 到 v 有路径;但可以肯定不存在 v→u,也不存在 v 到 u 的路径。
常用算法反复选一个入度为 0 的顶点输出,删除其出边并更新入度。每次可以有多个候选;如果未输出全部顶点却找不到入度为 0 的顶点,图中存在环。
若把邻接矩阵的行、列**同时按某个拓扑序重排**,并约定 A[i][j] 表示 i→j,则每条边都从较小下标指向较大下标,非零项只在主对角线上方,得到严格上三角矩阵。原编号未必如此:Q→P、P→R 构成 DAG,但按 P、Q、R 排列时非零项在 (2,1) 和 (1,3),既非上三角也非下三角;改按 Q、P、R 排列才在上三角。存在拓扑序不等于任意编号下的邻接矩阵已经是三角矩阵。
例题 18:选择合法拓扑序列
拓扑序列是有向无环图中所有顶点的一个线性序列,若有向图中存在弧<v,w>或存在从顶点v到w的路径,则在该有向图的任一拓扑序列中,v一定在w之前。下面有向图的拓扑序列是( )。
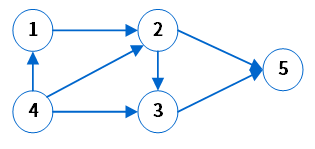
A、41235 B、43125 C、42135 D、41325
参考答案与解析
答案:A。 图中包含约束链 4→1→2→3→5,因此这里的拓扑顺序被确定为 4,1,2,3,5。
B 把 3 放在 2 前,违反 2→3;C 把 2 放在 1 前,违反 1→2;D 同样违反 2→3。逐条检查边是否从序列前面指向后面即可,不必凭图形的上下左右位置猜测。
例题 19:拓扑序中“在前”能推出什么
对有向图G进行拓扑排序得到的拓扑序列中,顶点Vi在顶点Vj之前,则说明G中( )。
A、一定存在有向弧<Vi, Vj>
B、一定不存在有向弧<Vj, Vi>
C、必定存在从Vi到Vj的路径
D、必定存在从Vj到Vi的路径
参考答案与解析
答案:B。 如果存在 Vj→Vi,拓扑序必须先 Vj 后 Vi,与题设矛盾。
Vi、Vj 也可能互相不可达,只是本次排序恰好先选了 Vi,因此不能推出 A 或 C。关键词是**“一定”**,需要判断所有符合题设的图都成立的结论。
专项题库练习(8 题)
本小节对应题库练习共 8 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 023
来源:知识点练习「数据结构」第 23 题(原站入口)。
关于图的遍历,下列说法正确的是( )。
-
A. 图的遍历是从给定的源点出发对每一个顶点仅访问一次的过程
-
B. 图的深度优先遍历方法不适用于无向图
-
C. 使用队列对图进行广度优先遍历
-
D. 图中有回路时则无法进行遍历
答案与解析
平台答案:C。
整理解析
平台选 C。广度优先遍历用先进先出的队列保存待扩展顶点;深度优先也适用于无向图,回路可通过访问标记处理。A 的表述有歧义:它接近常见遍历定义,但从一个给定源点未必能到达非连通图或有向图的全部顶点,完整遍历须在有未访问顶点时另选起点。若限定所有顶点均从源点可达,A 也可成立;平台以“未写沿路径”为由直接否定 A 并不充分。
题目 025
来源:知识点练习「数据结构」第 25 题(原站入口)。
有向无环图的拓扑序列包含其全部顶点;若存在弧(v,w)或从 v 到 w 的路径,则 v 必须排在 w 之前。下列哪一个序列是图示有向图的拓扑序列( )?
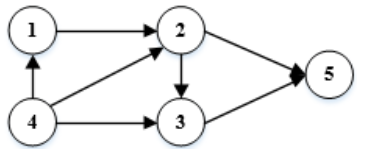
-
A. 41235
-
B. 43125
-
C. 42135
-
D. 41325
答案与解析
平台答案:A。
整理解析
选 A。图中的 4→1→2→3→5 已形成包含全部顶点的先后约束链,另有 4→2、4→3、2→5,故唯一拓扑序列为 4、1、2、3、5。平台解析说访问 2 后可以先访问 3 或 5,忽略了图中的 3→5;必须先 3 后 5。
题目 042
来源:知识点练习「数据结构」第 42 题(原站入口)。
无向图有 n 个结点、e 条边,采用邻接矩阵(数组表示法)存储。对整个图进行深度优先遍历,其时间复杂度是哪项?
- A. O(n2)
- B. O(e2)
- C. O(n+e)
- D. O(n*e)
答案与解析
平台答案:A。
整理解析
每个顶点至多展开一次,但寻找它的邻接点需检查矩阵一整行的 n 个位置;遍历 n 个顶点共需 O(n2),选 A。若用邻接表则通常为 O(n+e)。纠错:平台解析提到“把边终点的入度加 1”,那不是深度优先遍历的步骤,DFS 应依据访问标记递归或用栈展开邻接点。
题目 046
来源:知识点练习「数据结构」第 46 题(原站入口)。
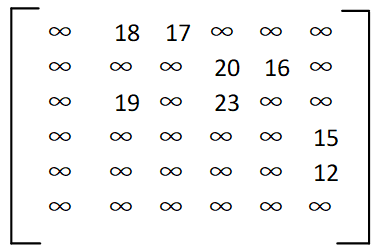
图 G 的邻接矩阵见图,行、列顶点顺序均为 v0、v1、v2、v3、v4、v5。第(46)空判断 G 的图类型,第(47)空选择从 v0 开始的一种可能的广度优先遍历顺序。本题回答第(46)空。
- A. 无向图
- B. 有向图
- C. 完全图
- D. 强连通图
答案与解析
平台答案:B。
整理解析
矩阵的 v0→v1 位置为 18,而 v1→v0 为 ∞,连接关系不对称,因此是有向图,选 B。v5 没有出边,不能到达其他顶点,故不是强连通图;矩阵中也存在许多未连接的不同顶点对,不是完全图。
题目 047
来源:知识点练习「数据结构」第 47 题(原站入口)。
图 G 的邻接矩阵见图,行、列顶点顺序均为 v0、v1、v2、v3、v4、v5。第(46)空判断 G 的图类型,第(47)空选择从 v0 开始的一种可能的广度优先遍历顺序。本题回答第(47)空。
- A. v0、v1、v2、v3、v4、v5
- B. v0、v2、v4、v5、v1、v3
- C. v0、v1、v3、v5、v2、v4
- D. v0、v2、v4、v3、v5、v1
答案与解析
平台答案:A。
整理解析
先访问 v0,再发现其邻接点 v1、v2;按编号先处理 v1,可依次发现 v3、v4,之后从 v3 或 v4 发现 v5,得到 A。其余选项都在 v0 的某个直接邻接点尚未访问时就进入了更深一层,不符合 BFS。边权不影响广度优先遍历的层次。
题目 060
来源:知识点练习「数据结构」第 60 题(原站入口)。
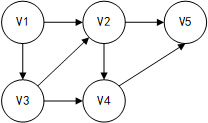
有向图见下图。从 v1 出发,第(60)空选择可能的深度优先序列,第(61)空选择可能的广度优先序列。候选序列如下:
① v1 v2 v3 v4 v5 ② v1 v3 v4 v5 v2 ③ v1 v3 v2 v4 v5 ④ v1 v2 v4 v5 v3
本题回答第(60)空。
- A. ①②③
- B. ①③④
- C. ①②④
- D. ②③④
答案与解析
平台答案:D。
整理解析
若 DFS 先到 v2,就必须先沿其未访问的出边去 v4 或 v5,不能立即回到 v1 再去 v3,所以①不可能。②可先走 v1→v3→v4→v5,回溯后到 v2;③可走 v1→v3→v2→v4→v5;④可先走 v1→v2→v4→v5,回溯后到 v3。因此选 D。
题目 061
来源:知识点练习「数据结构」第 61 题(原站入口)。
有向图见下图。从 v1 出发,第(60)空选择可能的深度优先序列,第(61)空选择可能的广度优先序列。候选序列如下:
① v1 v2 v3 v4 v5 ② v1 v3 v4 v5 v2 ③ v1 v3 v2 v4 v5 ④ v1 v2 v4 v5 v3
本题回答第(61)空。
- A. ①②
- B. ①③
- C. ②③
- D. ③④
答案与解析
平台答案:B。
整理解析
v2、v3 是 v1 的直接邻接点,BFS 必须先访问完这一层,才访问 v4、v5。按邻接点次序不同,①和③都可实现;②、④在第一层尚未完成时进入了更深一层,故选 B。
题目 069
来源:知识点练习「数据结构」第 69 题(原站入口)。
对有向图 G 得到一条拓扑序列,其中 Vi 排在 Vj 前。由此一定能推出哪项?
- A. 一定有弧 ⟨Vi,Vj⟩
- B. 一定没有弧 ⟨Vj,Vi⟩
- C. 一定有从 Vi 到 Vj 的路径
- D. 一定有从 Vj 到 Vi 的路径
答案与解析
平台答案:B。
整理解析
拓扑序列要求每条弧的起点先于终点;若存在 Vj→Vi,就必须把 Vj 放在 Vi 前面,与题设矛盾,故选 B。两个互不依赖的顶点也可按此先后排列,所以不能反推一定存在正向的弧或路径。
九、最小生成树与最短路径
最小生成树:连通全部顶点的总成本最低
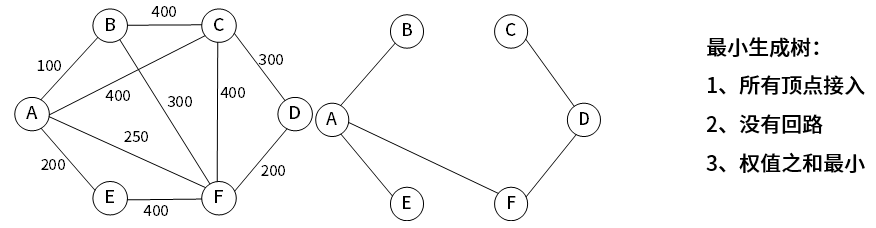
对带权无向连通图,生成树保留全部 n 个顶点,包含 n−1 条边且无环。最小生成树 MST 使**整棵树的边权总和最小**;它不保证树上任意两点之间的路径都是原图最短路径。图不连通时不存在覆盖全图的生成树,可以求最小生成森林。
| 算法 | 每一步选择 | 检查条件 |
|---|---|---|
| Kruskal/克鲁斯卡尔 | 按全图边权从小到大考虑边 | 只选连接两个不同连通分量的边,避免成环;常用并查集 |
| Prim/普里姆 | 选择跨越“已选顶点集合/未选顶点集合”的最小权边 | 一端在集合内、另一端在集合外,逐步扩大一棵树 |
Prim 不是从“全部现有点相关的边”随便选最小值,必须选**跨越集合边界**的边。Kruskal 与 Prim 都采用贪心策略。
图中最小生成树为 AB=100、AE=200、DF=200、AF=250、CD=300,总权为 1050。Kruskal 会在考虑 BF=300 时发现 B、F 已通过 A 相连,因而跳过该边;选入 CD 后 6 个顶点、5 条边全部连通。图中交叉线没有画结点,交叉处不额外产生连接。
Dijkstra:从一个起点到各点的最短距离
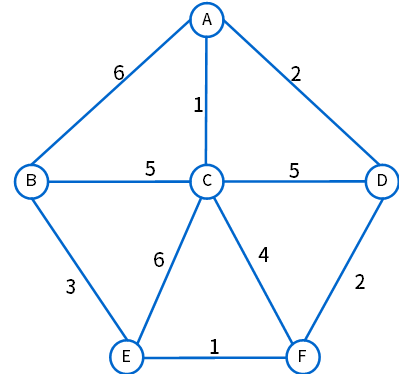
Dijkstra(迪杰斯特拉)也使用贪心策略。维护每个顶点的暂定最短距离:起点为 0,其余为无穷大;每次确定未处理顶点中距离最小的顶点 u,再用 dist[u]+w(u,v) 尝试改小邻点 v 的距离,这称为**松弛**。
适用前提:边权非负。 负权边可能破坏“当前最小距离已确定”的性质,不能直接照用标准 Dijkstra;无权图/等权图的最短边数可以用 BFS。
原思考:Dijkstra 采用什么算法设计策略?上图 A 到 E 的最短路径为多少?
参考答案与推导:Dijkstra 的确定与松弛
策略:贪心。最短路径为 A→D→F→E,长度 5。
| 已确定的顶点 | d(B) | d(C) | d(D) | d(E) | d(F) |
|---|---|---|---|---|---|
| A | 6 | 1 | 2 | ∞ | ∞ |
| A,C | 6 | 1 | 2 | 7 | 5 |
| A,C,D | 6 | 1 | 2 | 7 | 4 |
| A,C,D,F | 6 | 1 | 2 | 5 | 4 |
| A,C,D,F,E | 6 | 1 | 2 | 5 | 4 |
从 A 经 D 到 F 为 2+2=4,再到 E 为 4+1=5。路径 A→C→F→E 为 1+4+1=6,虽然第一步更短,总代价却更大。因此不能每一步都只挑“当前点最短的出边”。
十、章节回顾与做题关键词
| 看到的条件/关键词 | 先做什么 | 容易误用的结论 |
|---|---|---|
| 顺序表、随机访问 | 找首地址与下标 | “数组一定静态分配” |
| 链表删除、移动元素 | 分开计算查找、改指针与搬移 | “删除总是 O(1)” |
| 依次入栈、出栈序列 | 模拟栈顶,检查何时允许交替操作 | 把“全部入栈后”当作默认条件 |
| 栈后接队列 | 先利用队列保持顺序 | 把队列看成再次逆序 |
| 循环队列、判满 | 确认 head/tail 定义、是否留空槽 | 不同实现混用取模公式 |
| 子串/子序列 | 检查连续性与相对顺序 | “子序列一定是子串” |
| 数组地址、压缩矩阵 | 数前面的位置,再乘元素大小 | 漏减下界、漏乘字节数 |
| 二叉树顺序存储 | 按父子位置算 2i、2i+1 |
用连续层序编号填平空缺 |
| 叶子数、结点的度 | 写边数=结点数−1 | 把结点总数当结点的度 |
| 遍历重建 | 用前序/后序找根,中序划分 | 没有互异标识也断言唯一 |
| BST | 检查所有祖先给出的上下界 | 只比较直接孩子;保证 O(log n) |
| AVL | 检查左右子树高度差 | 等同于完全二叉树 |
| 哈夫曼、频率 | 每次合并最小两权,算叶子 WPL | 编码唯一;压缩比例无须指定基准 |
| 邻接表、表结点数 | 分清出度、入度和边记录数 | 把边数用作矩阵阶数 |
| DFS/BFS | DFS 检查回溯时机,BFS 检查层次 | 忽略箭头和已访问标记 |
| 拓扑序、一定 | 检查每条边的前后关系与间接路径 | “排在前面必有直接边” |
| 连接全图、总代价最小 | Prim/Kruskal | 等同于起点到各点最短路 |
| 单源最短路、非负权 | Dijkstra 的最小暂定距离与松弛 | 只贪心挑当前点最短的一条边 |
关键词帮助定位方法,条件决定方法能否使用。计算题至少检查一次边界或极小实例;图题则先写出边/父子关系,再判断序列,避免被图形布局误导。
课件来源
整理依据:希赛《2026 版本软件设计师考试精讲班视频教程讲义电子版》,本章 6 篇课件;内容来自逐篇打开课件后的 Obsidian Web Clipper 正文。
| 原课件 | 页面 |
|---|---|
| 课程内容提要 | 161703 |
| 线性结构 | 161705 |
| 数组与矩阵 | 161706 |
| 树 | 161707 |
| 图 | 161708 |
| 章节回顾 | 161709 |
63 张教学图片的原地址、文件名、尺寸和 SHA-256 记录于同目录资源清单 image-sources.json。