04. 数据结构
线性结构、数组与矩阵、树和图。
配套阅读:数据结构:课件笔记,含课程配图、例题和参考解析。
本章目录
线性结构、数组、树与图
---
markmap:
height: 760
initialExpandLevel: 2
autoFit: true
colorFreezeLevel: 2
maxWidth: 280
spacingHorizontal: 80
spacingVertical: 12
nodeMinHeight: 24
paddingX: 10
---
# 线性结构、栈队列与字符串
## 线性表
- 元素在逻辑上有先后关系,除首尾外各有唯一直接前驱与后继
- 顺序表
- 用连续空间保存元素,按下标访问 O(1)
- 未排序时按值查找最坏 O(n);有序数组可用二分查找
- 中间插入、删除通常需要移动元素,最坏 O(n)
- 静态数组容量固定;动态数组可重新分配更大空间
- 几何倍增的动态数组末尾追加,摊还 O(1),单次扩容 O(n)
- 链表
- 单链表:每个结点有后继指针
- 双向链表:结点含前驱与后继指针
- 循环链表:尾结点的后继指向头结点或首结点,形成环
- 结点无需连续,容量可动态变化,但指针占用额外空间
- 已定位且具备所需前驱信息时,插入、删除可为 O(1)
- 单链表删除一般需要前驱;按位置或按值定位最坏 O(n)
## 栈
- 后进先出 LIFO;入栈和出栈都在栈顶
- 可用数组或链表实现,基本操作通常为 O(1)
- 应用:函数调用、表达式求值、括号匹配、深度优先搜索
## 队列
- 先进先出 FIFO;队尾入队,队头出队
- 链式队列同时维护头尾指针,可实现 O(1) 入队与出队
- 循环队列用取模运算复用数组空间
- 若预留一个空槽,长度为 m 的数组最多保存 m - 1 个元素
- 空:front = rear;满:(rear + 1) mod m = front
- 元素数:(rear - front + m) mod m
- 也可用计数器或标志位区分空满,容量约定相应改变
## 字符串
- 字符串是字符的有限序列,空串长度为 0
- 子串:主串中连续的一段字符
- 子序列:可不连续,但保持原有相对顺序
- 模式匹配:查找模式串在主串中的出现位置
- 朴素匹配逐个起点尝试;KMP 利用已匹配前缀信息减少重复比较
循环单链表实现队列(仅维护尾指针 rear)
在数据结构中,用循环单链表表示队列时,仅设置一个指向尾节点的尾指针(rear),即可实现入队和出队操作均达到 O(1) 时间复杂度,完全无需遍历链表。
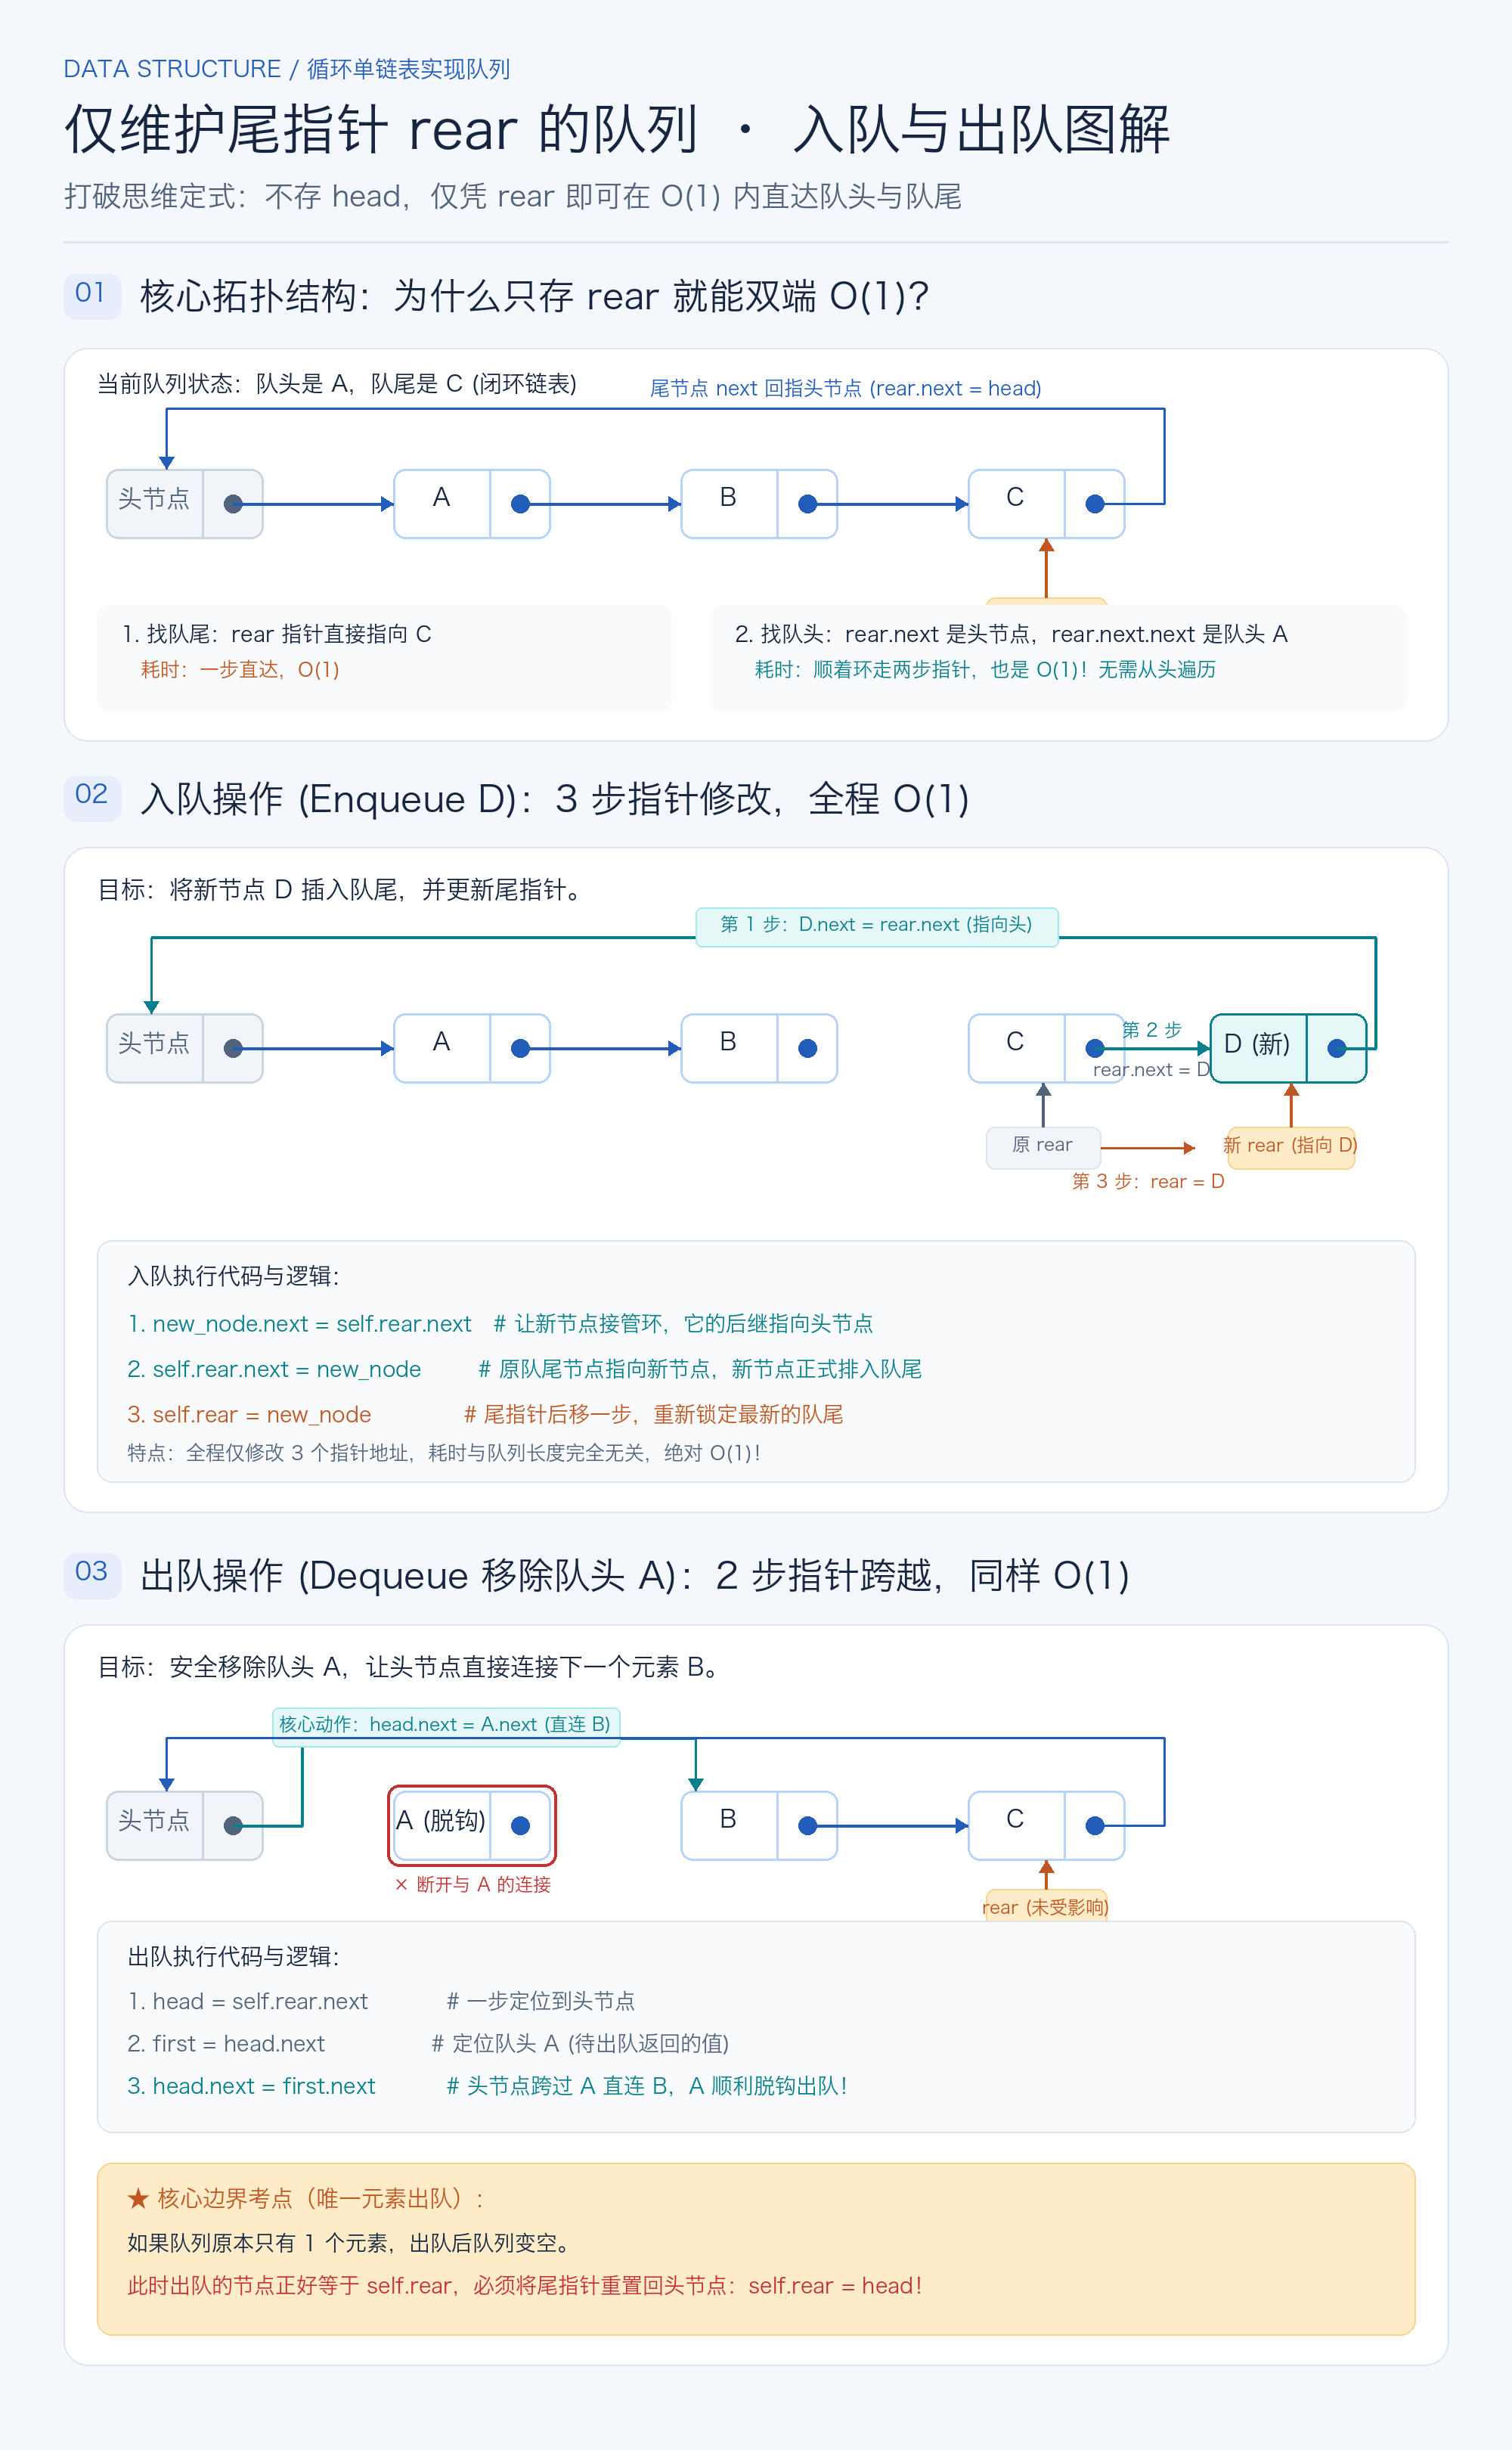
核心机制与推导
- 结构约定:链表首尾相连成环,带有一个哨兵头节点(head)。整套结构**只维护一个尾指针
rear**。 - 队尾操作(入队):
- 尾指针
rear直接指向队尾元素,耗时 O(1)。 - 新元素插入到
rear之后,并让新节点的next回指头节点(new_node.next = rear.next)。 rear指针后移指向新节点(rear = new_node)。- 队头操作(出队):
- 通过循环关系,
rear.next一步直达头节点,rear.next.next一步直达队头元素,耗时也是 O(1)。 - 让头节点跨过队头元素直连下一个节点(
head.next = head.next.next),队头脱钩出队。 - 边界情况(唯一元素出队):
- 若队列原本只有 1 个元素,出队后队列变空,此时需将尾指针重置回指着头节点(
rear = head)。
---
markmap:
height: 760
initialExpandLevel: 2
autoFit: true
colorFreezeLevel: 2
maxWidth: 280
spacingHorizontal: 80
spacingVertical: 12
nodeMinHeight: 24
paddingX: 10
---
# 数组寻址与矩阵压缩
## 地址计算约定
- B 为首元素地址,w 为每个元素占用的字节数
- 数组元素等宽、连续存储,下标范围须先明确
- 一维数组,下界为 L:`addr(a[i]) = B + (i - L) × w`
## 二维数组
- m 行 n 列,行列下标从 0 开始
- 行优先:`addr(a[i][j]) = B + (i × n + j) × w`
- 列优先:`addr(a[i][j]) = B + (j × m + i) × w`
- 下界非零时,先分别减去行、列下界
- 这些公式适用于连续的矩形数组;指针数组、嵌套列表不能直接套用
## 三角矩阵
- n 阶矩阵,下标均从 0 开始,按行压缩,包含主对角线
- 下三角:保存满足 j ≤ i 的元素
- 压缩数组下标 `k = i(i + 1) / 2 + j`
- 上三角:保存满足 i ≤ j 的元素
- 压缩数组下标 `k = i(2n - i + 1) / 2 + (j - i)`
- 三角区域共保存 n(n + 1) / 2 个元素
- 区域外若是统一常量,可另存一个常量;若均为零,通常隐含表示
## 其他特殊矩阵
- 对称矩阵:a[i][j] = a[j][i],存一个三角区域即可
- 对角矩阵:只有主对角线可能非零,通常保存 n 个值
- 带状矩阵:非零元素集中在主对角线及其附近若干条对角线上
- 三对角矩阵:主对角线及相邻两条对角线可能非零,n ≥ 1 时最多 3n - 2 个值
- 稀疏矩阵:非零元素远少于总元素,可用三元组、压缩行等结构保存
---
markmap:
height: 760
initialExpandLevel: 2
autoFit: true
colorFreezeLevel: 2
maxWidth: 280
spacingHorizontal: 80
spacingVertical: 12
nodeMinHeight: 24
paddingX: 10
---
# 树与二叉树
## 树的术语
- 结点的度:子结点个数;树的度:所有结点度的最大值
- 叶结点:没有子结点,度为 0
- 分支结点或内部结点:至少有一个子结点,根也可能是内部结点
- 父子关系:由直接连接的上下级结点形成
- 兄弟结点:具有同一个父结点;同层并不一定是兄弟
- 本图约定:根在第 1 层,树高为最大层数;路径长度按边数计算
## 二叉树结构与存储
- 每个结点至多有两个子结点,且区分左、右子树
- 顺序存储:按完全二叉树的位置编号,适合完全或接近完全的树
- 下标从 0 开始:左孩子 2i + 1,右孩子 2i + 2
- 非根结点父下标为 ⌊(i - 1) / 2⌋;孩子下标须小于数组有效长度
- 链式存储:数据域加左、右孩子指针,可再加父指针
- 满二叉树:每层都达到最大结点数
- 完全二叉树:最后一层可不满,但结点从左到右连续,其余层全满
## 二叉树性质
- 第 i 层最多 2^(i - 1) 个结点,i ≥ 1
- 高度为 h 的非空二叉树最多 2^h - 1 个结点
- 非空二叉树:叶子数 n₀ = 度为 2 的结点数 n₂ + 1
- n 个结点的完全二叉树:高度 ⌊log₂ n⌋ + 1,n ≥ 1
- n 个结点、左右有序且不带标号的二叉树形态数为 Catalan 数
- C₀ = 1,Cₙ = Σ Cᵢ × Cₙ₋₁₋ᵢ,求和范围 i = 0 到 n - 1
- 闭式:Cₙ = (2n)! / (n! × (n + 1)!)
## 遍历
- 先序:根、左、右
- 中序:左、根、右
- 后序:左、右、根
- 层序:按层从左到右,通常用队列
- 访问所有 n 个结点的时间为 O(n),递归遍历栈空间与树高有关
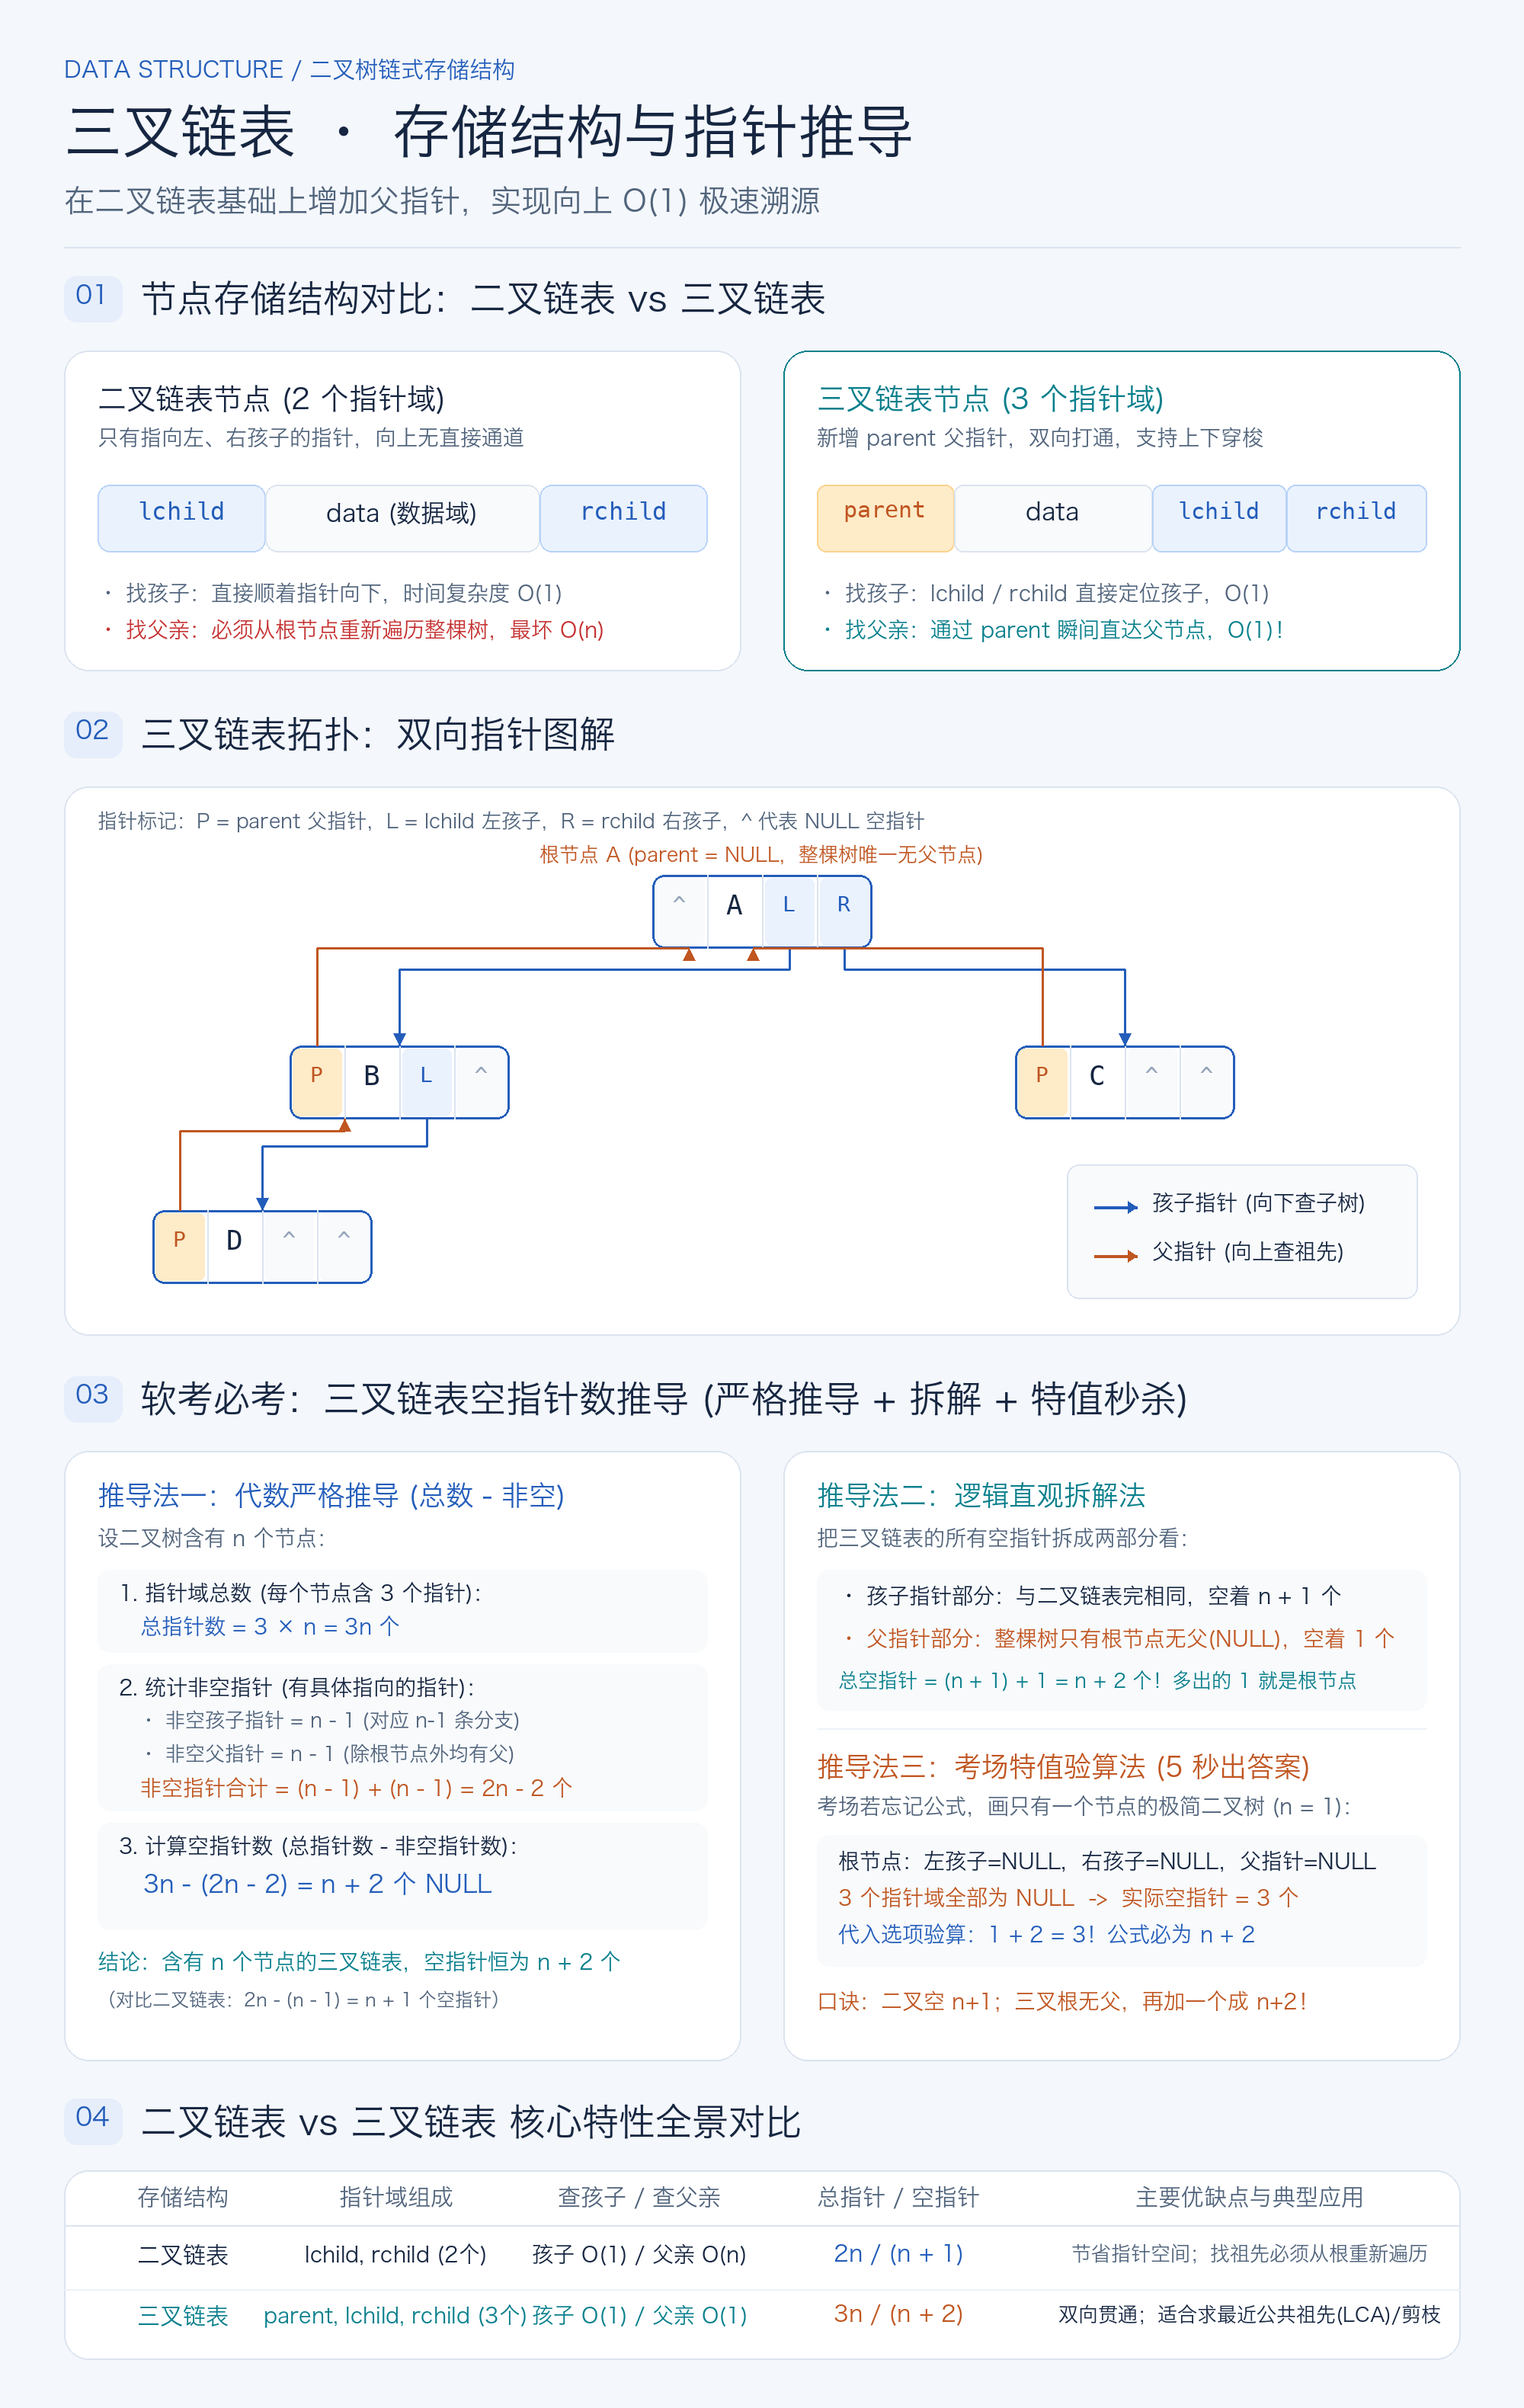
二叉树的链式存储:二叉链表与三叉链表
---
markmap:
height: 520
initialExpandLevel: 2
autoFit: true
colorFreezeLevel: 2
maxWidth: 280
spacingHorizontal: 80
spacingVertical: 12
nodeMinHeight: 24
paddingX: 10
---
# 二叉树链式存储与指针推导
## 二叉链表
- 节点结构:[lchild | data | rchild],包含 2 个指针域
- 查找特点:向下查孩子为 O(1);向上查父亲必须从根重新遍历,最坏 O(n)
- 指针总数:2n 个指针域
- 非空指针:n - 1 个(除根外每个节点占一条下行分支)
- 空指针数:2n - (n - 1) = n + 1 个 NULL
## 三叉链表
- 节点结构:[parent | data | lchild | rchild],包含 3 个指针域
- 查找特点:向下查孩子为 O(1);通过 parent 指针向上查父亲也是 O(1)
- 根节点特点:parent 恒为 NULL,是整棵树中唯一没有父节点的节点
- 指针总数:3n 个指针域
## 空指针推导 (软考高频考点)
- 代数推导:
- 非空孩子指针 = n - 1 个
- 非空父指针 = n - 1 个
- 非空指针合计 = (n - 1) + (n - 1) = 2n - 2 个
- 空指针数 = 3n - (2n - 2) = n + 2 个 NULL
- 逻辑拆解:
- 孩子部分空着 n + 1 个
- 父指针部分仅根节点空着 1 个
- 总空指针 = (n + 1) + 1 = n + 2 个
- 考场特值法:
- n = 1(仅一个孤立根节点):左右孩子为 NULL,父为 NULL,共 3 个空指针
- 代入验证:1 + 2 = 3,秒选 n + 2
## 优缺点与适用场景
- 优点:父子双向贯通,极大方便求最近公共祖先(LCA)、计算节点深度与剪枝
- 缺点:每个节点多占一个指针空间;插入、删除与旋转需同步更新父指针
1. 结构与指针域区别
二叉树最常用的链式存储是**二叉链表**,每个节点包含一个数据域和两个孩子指针:[lchild | data | rchild]。在二叉链表中,顺着孩子指针可以快速向下访问子树;但如果只知道某个节点的指针,想要找到它的父节点或祖先节点,必须从根节点重新遍历整棵树,最坏时间复杂度为 O(n)。
为了解决向上追溯效率低下的问题,**三叉链表**在每个节点中增加了一个指向其父节点的指针:[parent | data | lchild | rchild]。通过 node->parent,可以在 O(1) 时间内直接定位父节点。
2. 空指针数量的推导过程
设二叉树包含 n 个节点(n ≥ 1):
- 二叉链表:
- 每个节点有 2 个指针域,总指针域为
2n个。 - 除了根节点外,树中每一个节点都有且仅有一条来自父节点指向它的分支,因此有实际指向的非空指针数恰好为
n - 1个。 -
空指针数 = 总指针数 - 非空指针数 =
2n - (n - 1) = n + 1个。 -
三叉链表:
- 每个节点有 3 个指针域(parent、lchild、rchild),总指针域为
3n个。 - 非空指针统计:
- 所有非空的孩子指针(下行分支)有
n - 1个; - 所有的父指针中,除根节点的 parent 为 NULL 外,其余每个节点都有父节点,非空父指针有
n - 1个; - 有效非空指针合计为
(n - 1) + (n - 1) = 2n - 2个。
- 所有非空的孩子指针(下行分支)有
- 空指针数 = 总指针数 - 非空指针数 =
3n - (2n - 2) = n + 2个。
也可以通过直观拆解理解:三叉链表的孩子指针部分和二叉链表完全一样,贡献了 n + 1 个空指针;而父指针部分只有根节点无父(为 NULL),贡献了 1 个空指针。两者相加即为 (n + 1) + 1 = n + 2 个。
---
markmap:
height: 760
initialExpandLevel: 2
autoFit: true
colorFreezeLevel: 2
maxWidth: 280
spacingHorizontal: 80
spacingVertical: 12
nodeMinHeight: 24
paddingX: 10
---
# 搜索树、平衡树与哈夫曼树
## 二叉搜索树 BST
- 无重复键时:左子树所有键小于根,右子树所有键大于根
- 每棵子树也须满足同一性质,不只比较直接孩子
- 有重复键时,须明确放置规则或在结点内记录计数
- 中序遍历得到有序序列
- 查找、插入、删除与树高有关;退化为链时最坏 O(n)
## AVL 平衡二叉搜索树
- 每个结点左右子树高度差的绝对值不超过 1
- 平衡因子可定义为左子树高度减右子树高度
- 插入或删除破坏平衡时,通过旋转恢复
- 树高 O(log n),查找、插入和删除最坏 O(log n)
## 路径与权
- 根到某结点的路径长度:路径中的边数
- 树的路径长度:根到所有结点的路径长度之和
- 哈夫曼问题的叶结点带权路径长度:叶权重乘以根到该叶的边数
- WPL:所有叶结点的带权路径长度之和
## 哈夫曼树
- 对给定的非负叶权重,构造 WPL 最小的二叉树
- 初始:每个权值各成一棵树
- 反复选择当前根权值最小的两棵树合并
- 新根权值为两者之和,合并后的树放回候选集合
- 直到只剩一棵树;用最小堆实现通常为 O(n log n)
- 同权重的不同选择可能得到不同形态,但最小 WPL 相同
## 哈夫曼编码
- 给左右边分配 0、1,根到叶路径形成对应符号的码字
- 只有叶结点代表符号,因而形成前缀码
- 权重较大的符号通常使用较短码字
- 只有一个符号时,实际编码系统需约定码字长度与解码方式
---
markmap:
height: 760
initialExpandLevel: 2
autoFit: true
colorFreezeLevel: 2
maxWidth: 280
spacingHorizontal: 80
spacingVertical: 12
nodeMinHeight: 24
paddingX: 10
---
# 图的存储、遍历与路径
## 基本概念
- 图由顶点集 V 与边集 E 组成,可有向或无向、带权或不带权
- 无向连通图:任意两顶点间存在路径
- 有向强连通图:任意两顶点可以相互到达
- 简单无向完全图:任意不同顶点间都有边,n 个顶点共有 n(n - 1) / 2 条边
## 存储结构
- 邻接矩阵:空间 O(|V|²),检查两顶点是否相邻为 O(1)
- 邻接表:空间 O(|V| + |E|),适合稀疏图
- 无向图的一条边通常在两个顶点的邻接表中各保存一次
## 图的遍历
- DFS 深度优先:沿未访问邻点深入,无法继续时回退,用递归或显式栈
- BFS 广度优先:先访问近邻,再逐层扩展,用队列
- 记录访问状态防止重复;非连通图需从剩余未访问顶点继续
- 完整遍历:邻接矩阵 O(|V|²),邻接表 O(|V| + |E|)
- 邻点访问次序不同,遍历序列可能不同
## 拓扑排序
- 适用于有向无环图 DAG,使每条边 u → v 的起点排在终点前
- 可反复输出入度为 0 的顶点,并删除其出边
- 若未能输出所有顶点,图中存在有向环
- 合法拓扑序可能不唯一;邻接表实现时间 O(|V| + |E|)
## 最小生成树
- 在连通无向带权图中,连接所有顶点且总边权最小
- 含 |V| - 1 条边且无环;非连通图可求最小生成森林
- Prim:从一个顶点出发,每次选连接当前树与树外顶点的最轻边
- Kruskal:按边权从小到大考察,只加入连接不同连通分量的边
- 常用并查集判断是否成环,排序通常需 O(|E| log |E|)
- 最小生成树优化总连接成本,不保证任意两点之间的路径最短
## 最短路径
- 无权图或所有边权相同:BFS 可求最少边数路径
- Dijkstra:要求边权非负
- 从未确定顶点中选暂定距离最小者,确定其距离
- 用该顶点到邻点的边松弛距离,不断扩展已确定集合
- 普通数组实现 O(|V|²);邻接表加二叉堆通常 O((|V| + |E|) log |V|)
- 存在负权边时需采用适用算法;可达负权环会使相关最短距离无下界