数据库系统:课件整理与例题解析
本篇整理数据库系统整章 9 篇课件,保留 23 道例题及全部选项、推理例子、思考题和 43 张原图,图片均引用本地文件。折叠解析、补充说明、计算结果与纠错均由本笔记整理,非课件官方答案。 原题有瑕疵时保留题干并说明条件,不强行把错误选项当作正确结论。
可结合第 09 章知识导图复习。正文按原课件内容分节;同一课件内原本重复的例题编号已统一,具体来源见文末。
课程内容提要
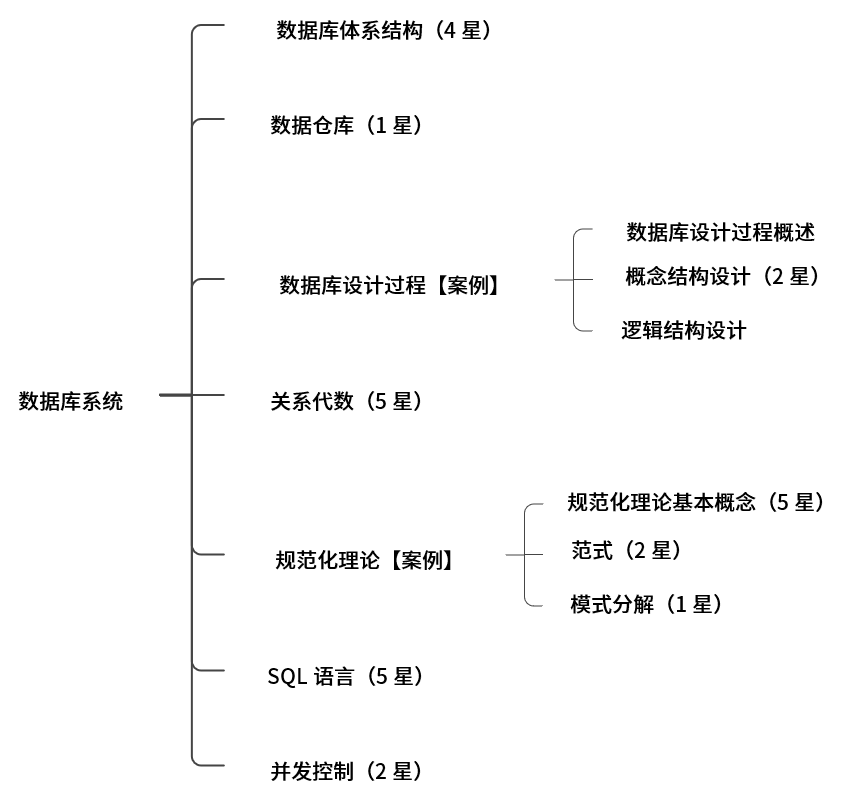
图中建议重点:关系代数、候选键/函数依赖与 SQL 为 5 星,体系结构 4 星;范式、概念结构设计、并发控制 2 星,数据仓库、模式分解 1 星。星级属于讲义的复习建议,不代表固定考试分值。
数据库体系结构
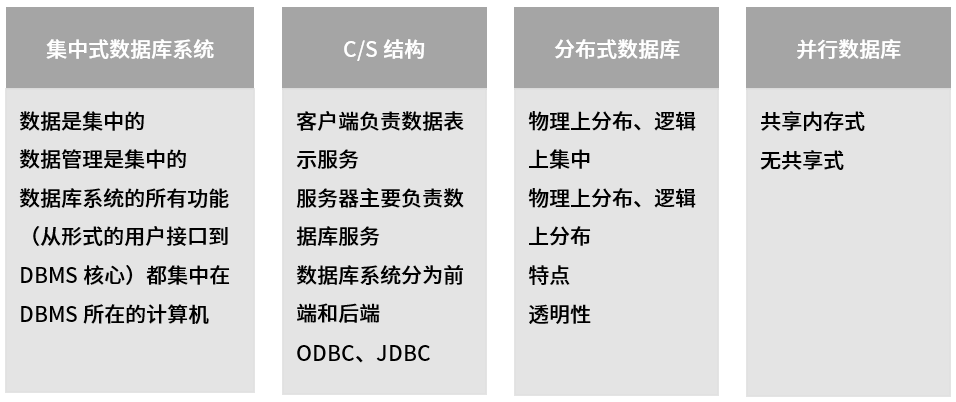
| 架构 | 核心识别条件 |
|---|---|
| 集中式 | 数据、管理及主要 DBMS 功能集中 |
| C/S | 客户端承担表示与部分应用逻辑,服务器提供数据库服务;ODBC、JDBC 是常见访问接口 |
| 分布式 | 物理分布,由全局机制协调局部数据库;逻辑上可提供统一视图 |
| 并行 | 多处理器/节点协作执行;常见共享内存、共享磁盘、无共享架构 |
分布式与并行的侧重点不同,也可以共存,不能只凭“多台机器”二选一。
三级模式和两级映像
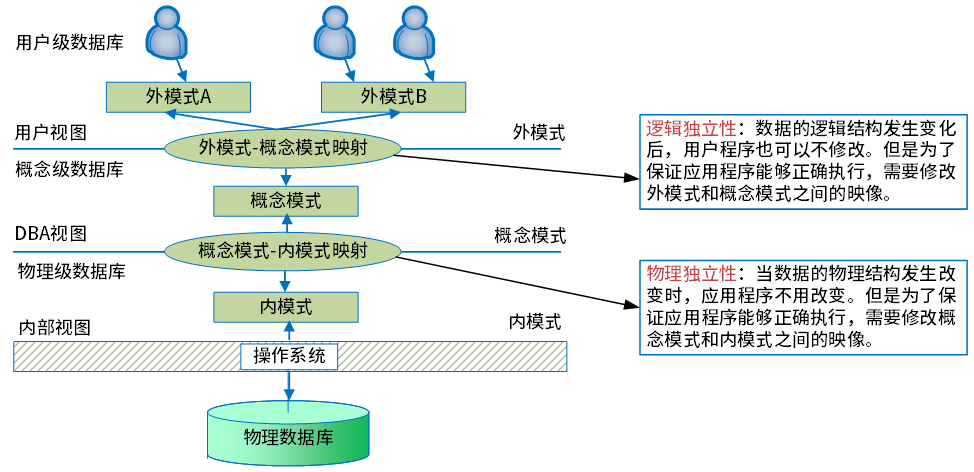
| 层级/映射 | 内容或作用 | 关键词 |
|---|---|---|
| 外模式 | 特定用户或应用看到的数据结构 | 用户视图,可有多个 |
| 概念模式(模式) | 全数据库的逻辑结构及约束 | 全局逻辑结构 |
| 内模式 | 存储组织、索引、访问路径 | 文件、物理存储 |
| 外模式/模式映射 | 模式改变时调整映射,尽量保持应用视图不变 | 逻辑独立性 |
| 模式/内模式映射 | 物理存储改变时调整映射,保持逻辑结构不变 | 物理独立性 |
模式不是“一张表”,而是整体逻辑定义;“表级”只是帮助记忆的简写。
注:聚簇索引修改的是内模式。
索引可以理解为便于定位记录的检索结构。**聚簇索引**还影响表记录或数据页按索引键组织的方式,常见实现把记录放在索引叶层;非聚簇索引则另存键及行定位信息。由于改变的是存储组织和访问路径,创建聚簇索引属于内模式变化,表的业务列含义不必改变。不同 DBMS 的实现不同,“聚簇”不表示所有磁盘地址永远连续,也不代表查询结果会自动有序,输出次序仍由 ORDER BY 指定。
两级映像的意义是由系统吸收变化:例如把普通文件组织改为索引组织,通过模式/内模式映像仍让应用查询原来的逻辑表;把逻辑表拆分后,则可调整外模式/模式映像,尽量保留应用所见接口。前者是物理独立性,后者是逻辑独立性,均不意味着任何结构变更都完全无须调整数据库定义。
外模式(用户视图):视图级
概念模式(概念视图):表级
内模式(内部视图):文件级
分布式数据库特点
- 集中与自治共享结合的控制结构。各局部的DBMS可以独立地管理局部数据库,具有自治的功能。同时,系统又设有集中控制机制,协调各局部DBMS的工作,执行全局应用。
- 适当增加数据冗余度。在不同的场地存储同一数据的多个副本,可以提高系统的可靠性和可用性,同时也能提高系统性能。(提高系统的可用性,即当系统中某个节点发生故障时,因为数据有其他副本在非故障场地上,对其他所有场地来说,数据仍然是可用的,从而保证数据的完备性。)
- 全局的一致性、可串行性和可恢复性。
- 数据独立性。除了数据的逻辑独立性与物理独立性外,还有数据分布独立性。
分布式数据透明性
- 分片透明:是指用户不必关心数据是如何分片的,它们对数据的操作在全局关系上进行,即如何分片对用户是透明的。
- 复制透明:用户不用关心数据库在网络中各个节点的复制情况,被复制的数据的更新都由系统自动完成。
- 位置透明:是指用户不必知道所操作的数据放在何处,即数据分配到哪个或哪些站点存储对用户是透明的。
- 局部映像透明性(逻辑透明):是最低层次的透明性,该透明性提供数据到局部数据库的映像,即用户不必关心局部DBMS支持哪种数据模型、使用哪种数据操纵语言,数据模型和操纵语言的转换是由系统完成的。因此,局部映像透明性对异构型和同构异质的分布式数据库系统是非常重要的。
例题 1:三级模式
数据库系统通常采用三级模式结构:外模式、模式和内模式。这三级模式分别对应数据库的( )。
A、基本表、存储文件和视图 B、视图、基本表和存储文件
C、基本表、视图和存储文件 D、视图、存储文件和基本表
参考答案与解析(本笔记补充,非官方)
B。 外模式对应用户视图,模式对应整体逻辑结构(在本题中以基本表表示),内模式对应存储文件。关键词要按题目给出的先后顺序配对。
例题 2:聚簇索引
采用三级结构/两级映像的数据库体系结构,如果对数据库的一张表创建聚簇索引,改变的是数据库的( )。
A、用户模式 B、外模式 C、模式 D、内模式
参考答案与解析(本笔记补充,非官方)
D。 创建聚簇索引影响物理组织与访问路径,属于内模式。不要因 SQL 里用了 CREATE 就判成概念模式。
例题 3:两级独立性
数据的物理独立性和逻辑独立性分别是通过修改( )来完成的。
A、外模式与内模式之间的映像、模式与内模式之间的映像
B、外模式与内模式之间的映像、外模式与模式之间的映像
C、外模式与模式之间的映像、模式与内模式之间的映像
D、模式与内模式之间的映像、外模式与模式之间的映像
参考答案与解析(本笔记补充,非官方)
D。 物理独立性:模式/内模式映射;逻辑独立性:外模式/模式映射。映射在上下两层之间吸收下层的变化。
例题 4:副本与可用性
当某一场地故障时,系统可以使用其他场地上的副本而不至于使整个系统瘫痪。这称为分布式数据库的( )。
A、共享性 B、自治性 C、可用性 D、分布性
参考答案与解析(本笔记补充,非官方)
C。 题目强调故障后仍能提供服务,是可用性。副本也会增加一致性维护成本,不能据此保证任意网络故障下均可用。
例题 5:分布透明性
在分布式数据库中有分片透明、复制透明、位置透明和逻辑透明等基本概念,其中:( )是指局部数据模型透明,即用户或应用程序无需知道局部使用的是哪种数据模型;( )是指用户或应用程序不需要知道逻辑上访问的表具体是如何分块存储的。
A、分片透明 B、复制透明 C、位置透明 D、逻辑透明
A、分片透明 B、复制透明 C、位置透明 D、逻辑透明
参考答案与解析(本笔记补充,非官方)
D、A。 “局部采用何种数据模型”对应逻辑/局部映像透明;“如何分块”对应分片透明。
专项题库练习(9 题)
本小节对应题库练习共 9 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 019
来源:知识点练习「数据库系统」第 19 题(原站入口)。
数据库的三级模式依次为外模式、模式、内模式。下列哪一组选项与这三级模式的顺序对应( )?
-
A. 基本表、存储文件和视图
-
B. 视图、基本表和存储文件
-
C. 基本表、视图和存储文件
-
D. 视图、存储文件和基本表
答案与解析
平台答案:B。
整理解析
选 B。外模式是用户可见的局部逻辑视图;模式描述全库的逻辑结构,在关系数据库中常对应基本表等定义;内模式描述实际存储组织。视图—基本表—存储文件是本题在关系数据库语境下的简化对应,外模式不必逐一对应某条SQL CREATE VIEW语句。
题目 021
来源:知识点练习「数据库系统」第 21 题(原站入口)。
分布式数据库有分片、复制、位置、逻辑等透明性。用户或应用无需知道局部数据库采用何种数据模型,称为(21);无需知道逻辑上访问的表如何分块存储,称为(22)。
请作答:第 21 题。
-
A. 分片透明
-
B. 复制透明
-
C. 位置透明
-
D. 逻辑透明
答案与解析
平台答案:D。
整理解析
选 D。此处逻辑透明指局部映像透明:系统屏蔽各局部数据库模型或操作语言的差异,使用户面对统一接口。它不是位置透明所屏蔽的具体存放站点。
题目 022
展开题目 022(先作答,再查看解析)
来源:知识点练习「数据库系统」第 22、55 题(原站入口)。
分布式数据库有分片、复制、位置、逻辑等透明性。用户或应用无需知道局部数据库采用何种数据模型,称为(21);无需知道逻辑上访问的表如何分块存储,称为(22)。
请作答:第 22 题。
-
A. 分片透明
-
B. 复制透明
-
C. 位置透明
-
D. 逻辑透明
答案与解析
平台答案(来源第 22 题):A。
整理解析(来源第 22 题)
选 A。分片透明使用户仍可操作完整的逻辑关系,由系统把请求转换成对各分片的访问。复制透明隐藏副本,位置透明隐藏存放地点,关注层次不同。
来源第 55 题对照
原题题干
分布式数据库对用户或应用隐藏逻辑表如何分块存储的细节,这称为什么透明性?( )
原题选项对照
| 原选项 | 内容 | 本页选项 |
|---|---|---|
| A | 逻辑透明 | D |
| B | 位置透明 | C |
| C | 分片透明 | A |
| D | 复制透明 | B |
原平台答案(来源第 55 题,原题选项):C;对应本页选项:A;本页平台答案:A。
整理解析(来源第 55 题)
隐藏全局关系如何划分为片段,是分片透明,选C。位置透明隐藏数据所在站点,复制透明隐藏副本配置与维护,局部映像透明隐藏局部数据模型等差异。物理存储细节与站点位置不是同一个概念,不能像平台部分表述那样一概归为位置透明。
题目 025
展开题目 025(先作答,再查看解析)
来源:知识点练习「数据库系统」第 25 题(原站入口)。
为实现数据的物理独立性和逻辑独立性,分别需要调整哪两级映像( )?
-
A. 外模式与内模式之间的映像、模式与内模式之间的映像
-
B. 外模式与内模式之间的映像、外模式与模式之间的映像
-
C. 外模式与模式之间的映像、模式与内模式之间的映像
-
D. 模式与内模式之间的映像、外模式与模式之间的映像
答案与解析
平台答案:D。
整理解析
选 D。存储组织改变时,通过模式—内模式映像保持逻辑结构不变;逻辑模式改变时,通过外模式—模式映像尽量保持用户视图和应用接口不变。题目先问物理、再问逻辑,顺序不能颠倒。
题目 043
展开题目 043(先作答,再查看解析)
来源:知识点练习「数据库系统」第 43、84 题(原站入口)。
数据库采用三级模式和两级映像。对一张表创建聚簇索引时,改变的主要是哪一级模式( )?
-
A. 用户模式
-
B. 外模式
-
C. 模式
-
D. 内模式
答案与解析
平台答案(来源第 43 题):D。
整理解析(来源第 43 题)
选 D。聚簇索引涉及记录的存储组织或访问路径,属于内模式范畴;用户看到的逻辑列定义不因此改变。不同DBMS实现聚簇的方式有所差异,不必将其解释为所有物理文件中的记录永远连续有序。
来源第 84 题对照
原题题干
在数据库三级模式结构下,为表创建聚簇索引,改变的是哪一级模式?( )
原题选项对照
| 原选项 | 内容 | 本页选项 |
|---|---|---|
| A | 外模式 | B |
| B | 模式 | C |
| C | 内模式 | D |
| D | 用户模式 | A |
原平台答案(来源第 84 题,原题选项):C;对应本页选项:D;本页平台答案:D。
整理解析(来源第 84 题)
聚簇索引影响记录的存储组织及访问路径,属于内模式,选C。表的概念逻辑结构归模式,用户所见的局部视图归外模式。
题目 054
展开题目 054(先作答,再查看解析)
来源:知识点练习「数据库系统」第 54 题(原站入口)。
数据库的视图、存储文件、基本表,按此顺序分别属于三级模式结构的哪一层?( )
-
A. 模式、内模式和外模式
-
B. 外模式、模式和内模式
-
C. 模式、外模式和内模式
-
D. 外模式、内模式和模式
答案与解析
平台答案:D。
整理解析
视图提供用户所见的外部表示,对应外模式;存储文件涉及物理组织,对应内模式;基本表属于全局逻辑结构,对应模式。因此顺序为外模式、内模式、模式,选D。
题目 065
展开题目 065(先作答,再查看解析)
来源:知识点练习「数据库系统」第 65、76 题(原站入口)。
分布式数据库某个场地发生故障时,可使用其他场地的副本继续工作,避免整个系统瘫痪。这体现哪项特性?( )
-
A. 共享性
-
B. 自治性
-
C. 可用性
-
D. 分布性
答案与解析
平台答案(来源第 65 题):C。
整理解析(来源第 65 题)
局部故障后仍能通过其他副本提供服务,体现可用性,选C。自治性关注站点管理本地数据,分布性关注数据分散存放,共享性关注跨站点访问数据。
来源第 76 题对照
原题题干
企业采用分布式数据库:当一处场地失效,系统仍可使用其他场地上的副本,避免全系统停摆。这属于哪项特性?( )
原题选项对照
| 原选项 | 内容 | 本页选项 |
|---|---|---|
| A | 共享性 | A |
| B | 自治性 | B |
| C | 可用性 | C |
| D | 分布性 | D |
原平台答案(来源第 76 题,原题选项):C;对应本页选项:C;本页平台答案:C。
整理解析(来源第 76 题)
故障后仍能利用其他副本持续提供服务,是可用性,选C。共享性描述数据共享,自治性描述站点对本地数据的管理,分布性描述跨场地存储。
题目 077
展开题目 077(先作答,再查看解析)
来源:知识点练习「数据库系统」第 77 题(原站入口)。
关于数据库三级模式之间的两级映像,哪项表述正确?( )
-
A. 模式/内模式映像实现了外模式到内模式之间的相互转换
-
B. 模式/内模式映像实现了概念模式到内模式之间的相互转换
-
C. 外模式/模式的映像实现了概念模式到内模式之间的相互转换
-
D. 外模式/内模式的映像实现了外模式到内模式之间的相互转换
答案与解析
平台答案:B。
整理解析
模式/内模式映像连接概念层与内部存储层,选B,并支持物理数据独立性。外模式/模式映像连接用户视图与概念层,支持逻辑数据独立性;标准的两级映像不另设直接的外模式/内模式映像。
题目 090
展开题目 090(先作答,再查看解析)
来源:知识点练习「数据库系统」第 90 题(原站入口)。
视图是虚拟表。基于user表创建名为user1的视图后,数据字典保存什么?( )
-
A. user1查询语句
-
B. user1视图定义
-
C. user1查询结果
-
D. 所引用的基本表
答案与解析
平台答案:B。
整理解析
保存的是user1的视图定义,选B,其中包含定义视图的查询及相关元数据。普通视图不会因此把每次查询结果另存一份;这里也不是保存用户每次查询user1所提交的语句。物化视图另有结果存储机制,不属于本题的普通虚拟视图。
数据仓库
数据仓库特点
- 面向主题:数据按主题组织。
- 集成的:消除了源数据中的不一致性,提供整个企业的一致性全局信息。
- 相对稳定的(非易失的):主要进行查询操作,只有少量的修改和删除操作(或是不删除)。
- 反映历史变化(随着时间变化):记录了企业从过去某一时刻到当前各个阶段的信息,可对发展历程和未来趋势做定量分析和预测。
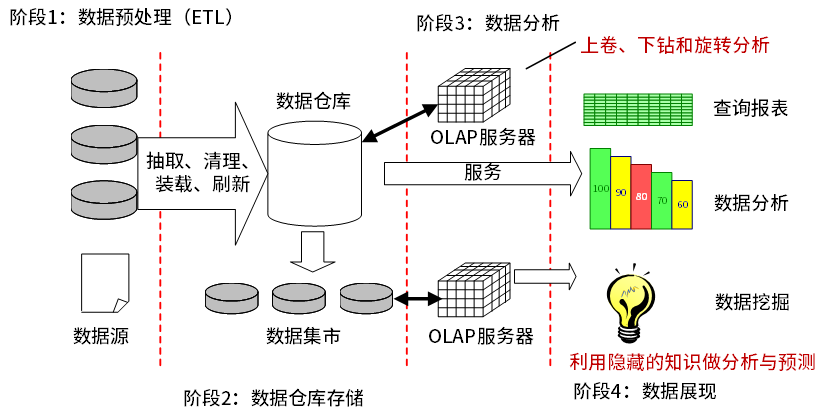
图中流程可转写为:数据源 → ETL(抽取、清理/转换、装载、刷新)→ 数据仓库/数据集市 → OLAP 分析 → 报表、可视化和数据挖掘。 上卷汇总到更粗粒度,下钻查看更细粒度,旋转切换观察维度。相对稳定不等于永不更新;仓库仍需增量装载和数据修正。
OLTP、OLAP 与分析算法
OLTP(联机事务处理)面向下单、付款、修改库存等日常业务,常是较短的读写事务,强调并发与一致性;OLAP(联机分析处理)面向跨时间、地区、品类的汇总分析,常扫描和聚合较多历史记录。ETL 负责把不同来源的数据抽取、清理转换后装载,数据抽取只是其中一步,均不等于多维分析本身。
在销售分析中,时间、地区、商品是**维度**,销售额、销量是**度量**。把日销售汇总为月销售是上卷,从省细看各市是下钻,切片是固定某个维度值,旋转是调整维度的展示方向。数据仓库提供分析基础,具体建模或搜索方法另有选择。
题库还涉及启发式搜索中的**遗传算法**:把候选方案编码成个体,以一组个体组成种群,用适应度评价质量;通过选择保留较优候选,通过交叉重组父代片段,通过变异引入新的变化,多代迭代寻找较好方案。这三种操作是其识别特征,但不保证每次得到全局最优。粒子群依据个体与群体经验调整位置,蚁群利用信息素引导选择,神经网络通过训练调整连接参数,机制不同。
例题 6:多维分析
某集团公司下属有多个超市,每个超市的所有销售数据最终要存入公司的数据仓库中。假设该公司高管需要从时间、地区和商品种类三个维度来分析某家电商品的销售数据,那么最适合采用( )来完成。
A、Data Extraction B、OLAP C、OLTP D、ETL
参考答案与解析(本笔记补充,非官方)
B(OLAP)。 按时间、地区、商品种类等维度分析是联机分析处理。ETL 负责抽取、转换和装载;Data Extraction 只描述抽取;OLTP 面向日常业务事务。
专项题库练习(2 题)
本小节对应题库练习共 2 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 015
来源:知识点练习「数据库系统」第 15 题(原站入口)。
哪一种算法用选择(繁殖)、交叉(重组)、变异(突变)这三个过程模拟生物进化( )?
-
A. 粒子群
-
B. 人工神经网络
-
C. 遗传
-
D. 蚁群
答案与解析
平台答案:C。
整理解析
选 C。遗传算法以编码个体组成种群,按适应度选择,再经交叉和变异产生新候选解。该机制用于启发式搜索,不保证每次运行都找到全局最优解。
题目 053
来源:知识点练习「数据库系统」第 53 题(原站入口)。
某集团旗下有多个超市,各店销售数据最终汇入集团数据仓库。高管要按时间、地区、商品种类三个维度分析某家电商品的销售数据,最适合使用哪项技术?( )
-
A. Data Extraction
-
B. OLAP
-
C. OLTP
-
D. ETL
答案与解析
平台答案:B。
整理解析
按多个维度交互分析销售汇总属于联机分析处理OLAP,选B。Data Extraction只负责抽取,ETL负责抽取、转换和加载,OLTP主要处理日常交易;它们都不直接对应本题的多维分析目标。
数据库设计
数据库设计过程概述
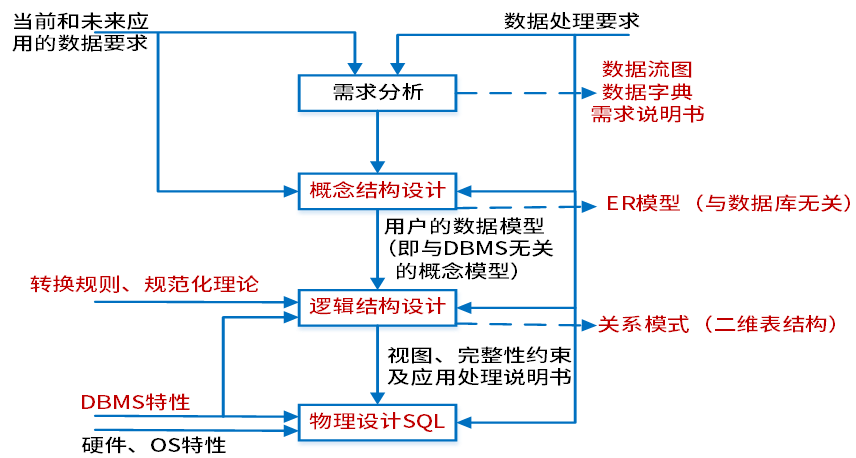
| 阶段 | 主要产物/决策 | 易混点 |
|---|---|---|
| 需求分析 | 数据流图、数据字典、需求说明 | 识别“需要什么数据和处理” |
| 概念设计 | E-R 模型 | 不依赖具体 DBMS |
| 逻辑设计 | 关系模式、键、视图、约束与规范化 | E-R 转表、范式在这里 |
| 物理设计 | 存储结构、索引、访问路径 | 与 DBMS、硬件、OS 有关 |
| 实施与运行维护 | 建库、装载、测试、监控、备份、调优 | 将设计落地并持续维护 |
原图将物理设计标为“物理设计 SQL”,只是简写;SQL 不仅用于物理设计,也用于逻辑定义、查询、权限与事务。
例题 7:规范化所属阶段
关系规范化在数据库设计的( )阶段进行。
A、需求分析 B、概念设计 C、逻辑设计 D、物理设计
参考答案与解析(本笔记补充,非官方)
C。 概念设计得到与 DBMS 无关的 E-R 模型;逻辑设计转换为关系模式并规范化;物理设计决定具体存储与访问路径。
概念结构设计
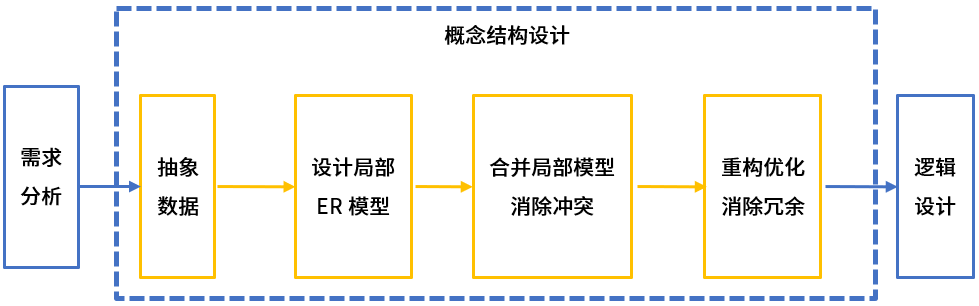
概念设计的四步:抽象数据 → 建立局部 E-R 模型 → 合并并消除冲突 → 重构优化、消除冗余。属性冲突看类型、单位、取值域;命名冲突看名字是否同义;结构冲突看同一对象被抽象成什么以及包含哪些属性,命名冲突也可能发生于实体/联系,不能只限定在属性上。
-
集成的方法:
-
多个局部E-R图一次集成。
-
逐步集成,用累加的方式一次集成两个局部E-R。
-
集成产生的冲突及解决办法:
-
属性冲突(属性层面):包括属性域冲突和属性取值冲突。
-
命名冲突(属性层面):包括同名异义和异名同义。
-
结构冲突(表层面):包括同一对象在不同应用中具有不同的抽象,以及同一实体在不同局部E-R图中所包含的属性个数和属性排列次序不完全相同。
例题 8:合并局部 E-R 图
某高校信息系统设计的分E-R图中,人力部门定义的职工实体具有属性:职工号、姓名、性别和出生日期;教学部门定义的教师实体具有属性:教师号、姓名和职称。这种情况属于( ),在合并E-R图时,( )解决这一冲突。
A、属性冲突 B、命名冲突 C、结构冲突 D、实体冲突
A、职工和教师实体保持各自属性不变
B、职工实体中加入职称属性,删除教师实体
C、教师也是学校的职工,故直接将教师实体删除
D、将教师实体所有属性并入职工实体,删除教师实体
参考答案与解析(本笔记补充,非官方)
第一空 C;第二空参考选 D(合并时保留所需属性)。 同一类人员在不同局部图中属性集合不同,核心是结构冲突。教师有“教师号、姓名、职称”,职工有“职工号、姓名、性别、出生日期”;合并同义的姓名,并保留其他所需信息,才能避免未说明前提就丢失教师号。
语义边界: 原题没有明确教师号与职工号是否同一标识。若业务已确认二者同义、并统一命名,B 的“仅增加职称”也可以实现合并;不能凭想当然认定两种编号相同。真实系统还可能保留教师子类型,并需明确非教师的职称是否适用。本题不能推出“任何教师实体都应该删除”。
E-R模型
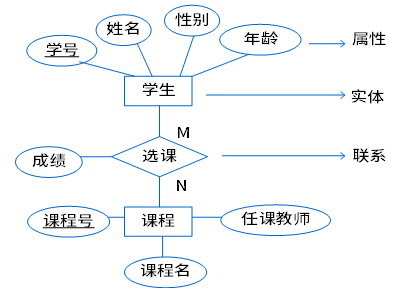
本图采用 Chen 记法:矩形为学生、课程两个实体型;椭圆为属性;菱形“选课”为联系。成绩属于某个学生选某门课程这一联系,不是学生或课程单方的属性。下划线标识键属性:学号、课程号。
- 实体:实体是现实世界中可以区别于其他对象的事件或事物。
(实体集—实体的集合)
- 属性:属性是实体某方面的特性。
- 联系:实体的联系分为实体内部的联系和实体与实体间的联系。实体间联系类型:1∶1,1∶*,*∶*。
属性
-
简单属性和复合属性
-
简单属性是原子的,不可再分的;
-
复合属性可以细分为更小的部分(即划分为别的属性)。
-
单值属性和多值属性:
-
定义的属性对于一个特定的实体都只有单独的一个值,称为单值属性;
-
在某些特定情况下,一个属性可能对应一组值,称为多值属性。
-
NULL:表示未知、缺失或不适用等情形,需结合业务含义;不是普通值,也不是数值 0 或空字符串。
- 派生属性:可以从其他属性得来。
二元联系的基数
-
两个不同实体集之间联系:
-
一对一 (1∶1)
-
一对多 (1∶n)
-
多对多 (m∶n)
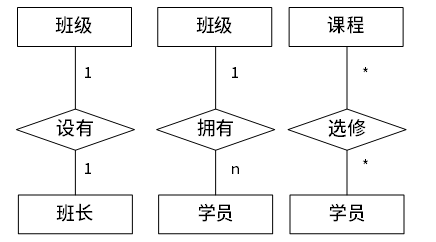
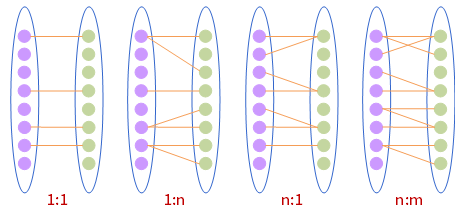
二元基数的两端要分别问:一个 A 最多对应几个 B,一个 B 最多对应几个 A。本图为班级—班长 1:1、班级—学员 1:n、学员—课程 m:n;均以题目给定业务规则为前提,不凭名词猜基数。
在本课件采用的 Chen 记法中,实体间联系用菱形表示;其他 E-R 记法(如乌鸦脚记法)可能直接用线及端点标记,不能把“必须有菱形”推广到所有 E-R 图。
三元联系与自联系
- 两个以上不同实体集之间的联系(三元联系)
多重度的确定(可根据语义直接转换)
以三元关系中的一个实体作为中心,假设另两个实体都只有一个实例:
若中心实体只有一个实例能与另两个实体的一个实例进行关联,则中心实体的连通数为“一”。
若中心实体有多于一个实例能与另两个实体实例进行关联,则中心实体的连通数为“多”。
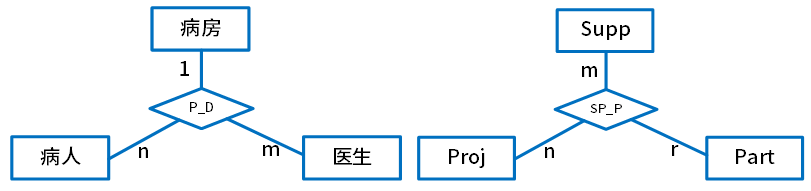
三元联系不要直接套二元读法。 病房端标“1”严格表达:固定一个病人和一个医生后,最多对应一个病房,即 (病人,医生)→病房。仅凭这个“1”,不能推出“每个医生只负责一个病房”或“每个病人只属于一个病房”;后两条必须另有业务约束。原文下方的解释应当理解为附加假设。
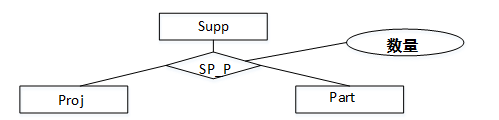
供应关系 SP_P(供应商号,项目号,零件号,数量) 在没有额外约束时,用三方编号的组合标识一次供货汇总。若同一组合还允许多批次,需要增加批次/时间等标识。
技巧:对比ER图和关系表。
P_D:表示一个病房有多个病人和多个医生,一个医生只负责一个病房,一个病人只属于一个病房。
SP_P:表示供应商为多个项目供应多种零件,每个项目可用多个供应商供应的零件,每种零件可由不同的供应商供应。
- 同一个实体集内的二元联系
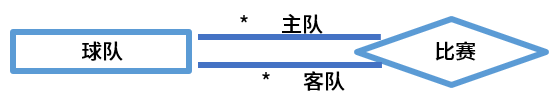
同一实体型“球队”以主队、客队两个角色参与“比赛”。实现时可用主队号、客队号两个外键分别引用球队;两队能重复比赛时,还需要比赛号或日期/轮次等标识。
扩充的E-R模型
- 弱实体:在现实世界中有一种特殊的依赖联系,该联系是指某实体是否存在对于另一些实体具有很强的依赖关系,即一个实体的存在必须以另一个实体为前提,而将这类实体称为弱实体,如家属与职工的联系,附件与邮件。
- 特殊化:在现实世界中,某些实体一方面具有一些共性,另一方面还具有各自的特性,一个实体集可以按照某些特征区分为几个子实体。
- 聚集:一个联系作为另一个联系的一端。
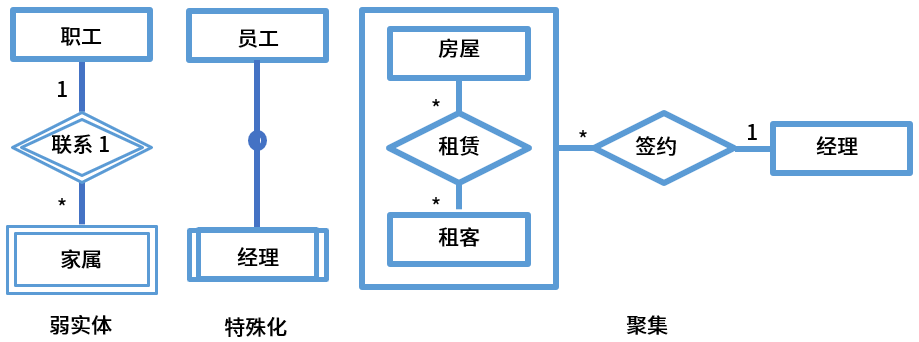
| 扩展结构 | 图中例子 | 建模含义 |
|---|---|---|
| 弱实体 | 职工—家属,双矩形及识别联系 | 弱实体通常需结合所属强实体的键及自身部分键标识;仅有存在依赖还不足以断定识别方式 |
| 特殊化 | 员工—经理 | 经理是员工的子类型,继承共同属性并可增加特有属性 |
| 聚集 | 房屋—租客的租赁联系,再与经理发生签约联系 | 将一次联系及其参与者当作整体参与另一联系 |
逻辑结构设计
关系模式相关概念
数据模型
- 层次模型
- 网状模型
- 关系模型
- 面向对象模型
数据模型三要素:
- 数据结构
- 数据操作
- 数据的约束条件
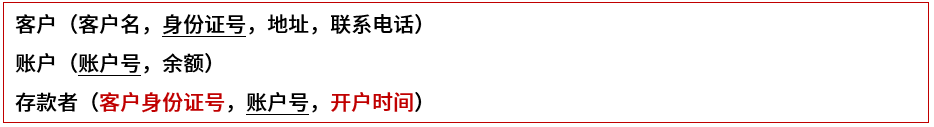
图中的关系及键:客户(客户名,身份证号,地址,联系电话),键为身份证号;账户(账户号,余额),键为账户号;存款者(客户身份证号,账户号,开户时间)。在后文“一名客户可有多个账户、一个账户只属一名客户”的模型下,存款者的键为账户号,两编号分别引用客户、账户。
完整性约束
- 实体完整性约束(主键:唯一且非空)
- 参照完整性约束:外键按引用的键与空值规则取值,详见下方纠正。
- 用户自定义完整性约束(自定义)
关系的3种类型
- 基本关系(通常又称为基本表或基表):实际存在的表,实际存储数据的逻辑表示。
- 查询表:查询结果对应的表。
- 视图表:由基表或其他视图表导出的表,普通视图不独立存储结果数据,数据库保存其定义,常称为虚表;物化视图另当别论。
关系模型相关概念
- 目或度:关系模式中属性的个数。
- 候选码/候选键(多组)
- 主码/主键(1组)
- 主属性与非主属性:组成候选码的属性就是主属性,其它的就是非主属性。
- 外码/外键
- 全码/ALL-Key:关系模式的所有属性组组成的关系模式的候选码。
学生(学号,性别,身份证号,年龄,班号)
班级(班号,名称,位置)
选课(学号,科目号)
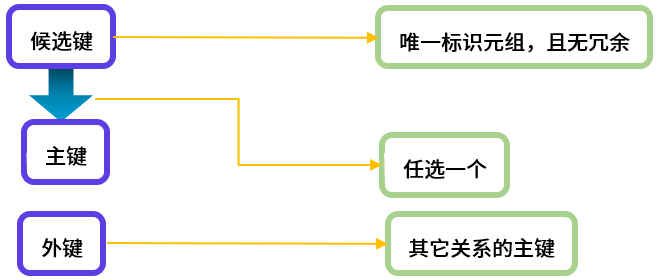
图示补充: 超键能唯一标识元组;候选键是没有冗余属性的超键,主键从候选键中选一个。主属性属于**至少一个候选键**,不是仅属于所选主键。全码表示全部属性共同构成一个**最小候选键**;“所有属性一定是超键”不等于“任何关系都是全码”。
学生例若约定学号、身份证号各自唯一,两者各为候选键;班号是引用班级的外键。选课例若同一学生同一科目只能出现一次且无其他依赖,(学号,科目号) 为全码。
外键纠正: 被引用列通常由主键或符合 DBMS 要求的唯一约束支撑,也可引用本表。外键只有在列及匹配规则允许 NULL 时才可为空,NOT NULL 会禁止空值;复合外键还需结合 MATCH 规则,不能一概写成“其他表主键或者空”。
E-R 模型转换规则
- 一个实体型必须转换为一个关系模式
- 联系转关系模式:
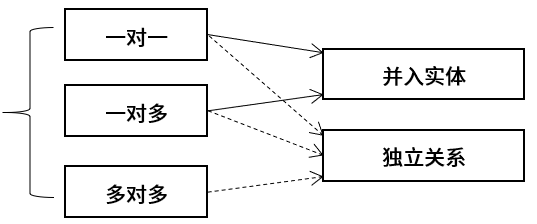
下列转换采用“每种联系实例至多一条”的常规假设。1:1 合并时在外键上设置 UNIQUE,并按参与约束决定是否 NOT NULL;1:n 把 1 端键放入 n 端;m:n 另建联系表。若业务包含历史任职、多次考试等,应另外建模时间/次数,不能机械沿用此处的键。
(1)一对一联系的转换有两种方式。
独立的关系模式:并入两端主键及联系自身属性。(主键:任一端主键)
归并(任意一端):并入另一端主键及联系自身属性。(主键:保持不变)
(2)一对多联系的转换有两种方式。
独立的关系模式:并入两端主键及联系自身属性。(主键:多端主键)
归并(多端):并入另一端主键及联系自身属性。(主键:保持不变)
(3)多对多联系的转换只有一种方式。
独立的关系模式:并入两端主键及联系自身属性。(主键:两端主键的组合键)
1:1 示例:校长与学校
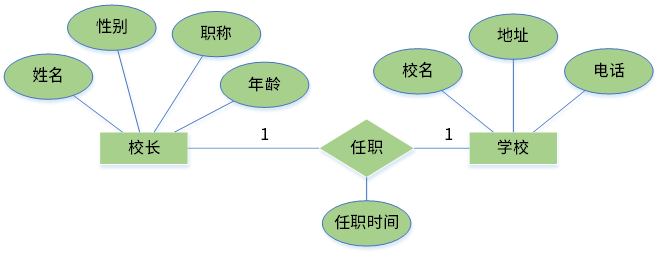
图中联系属性为“任职时间”。独立任职表时,姓名或校名各自可作候选键;合并到一端时,对另一端标识设置唯一约束以保证 1:1。原例暂把姓名、校名当唯一标识;实际设计通常用校长编号、学校编号,姓名未必唯一。
第一种转换方式:
校长(姓名,性别,职称,年龄)
学校(校名,地址,电话)
任职(任职时间,姓名,校名)
第二种转换方式:
校长(姓名,性别,职称,年龄,校名,任职时间)
学校(校名,地址,电话)
第三种转换方式:
校长(姓名,性别,职称,年龄)
学校(校名,地址,电话,姓名,任职时间)
1:n 示例:客户与账户
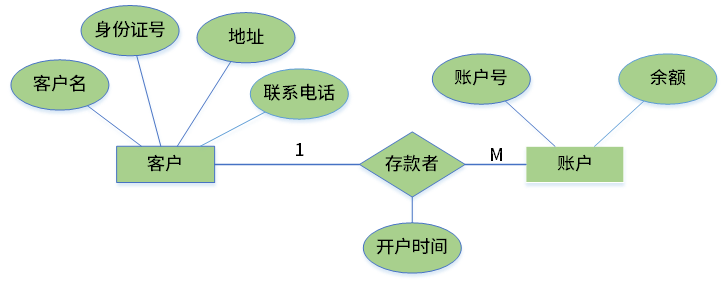
图中客户端 1、账户端 M:独立“存款者”表以账户号为键;并入账户表时保留账户号为主键,添加客户身份证号外键及开户时间。该模型未表达联名账户,不适合据此推出真实银行账户一定是 1:n。
第一种转换方式:
客户(客户名,身份证号,地址,联系电话)
账户(账户号,余额)
存款者(客户身份证号,账户号,开户时间)
第二种转换方式:
客户(客户名,身份证号,地址,联系电话)
账户(客户身份证号,账户号,余额,开户时间)
m:n 示例:学生与课程
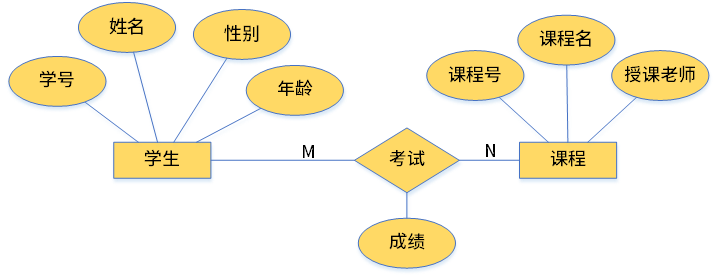
图中 M:N 考试联系带成绩。按“一名学生对一门课只有一条成绩”的假设,考试表键为 (课程号,学号);允许补考/重修时须增加考试批次等。
第一种转换方式:
学生(学号,姓名,性别,年龄)
课程(课程号,课程名,授课老师)
考试(课程号,学号,成绩)
联系转换对照表
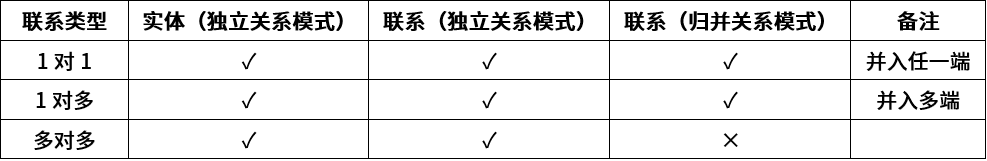
| 联系 | 可独立建表 | 可合并到实体表 | 独立联系表的常规键 |
|---|---|---|---|
| 1:1 | 是 | 任一端,需唯一性及参与约束 | 任一端的键 |
| 1:n | 是 | n 端 | n 端的键 |
| m:n | 是 | 不能仅靠给一端加单个外键表达 | 两端键的组合 |
视图、索引、触发器与存储过程:区分能力和边界
| 对象 | 作用 | 不能直接得出的结论 |
|---|---|---|
| 普通视图 | 保存查询定义,可限制暴露的行列,简化查询;部分可更新 | 不独立保存结果数据,不等于永远只读 |
| 物化视图 | 存储查询结果并按机制刷新 | 不是普通视图的同义词,刷新会影响时效性 |
| 触发器 | 在配置的 INSERT、UPDATE、DELETE 等事件发生时执行;种类依 DBMS | 不是每次 CRUD 都执行,普通 SELECT 通常不触发这些 DML 触发器;也不自动保证业务完全正确 |
| 存储过程 | 封装多步数据库操作,供调用者按权限执行 | 支持的语法、事务及权限规则依 DBMS,不是“什么都能做” |
| 索引 | 为某些查询提供更高效的访问路径 | 有存储及更新成本,不保证所有查询都更快 |
**数据字典**存储描述数据库的元数据,例如表与列的定义、约束、视图定义和授权信息。CREATE VIEW 把视图的查询定义等元数据登记进去;查询普通视图时,再按定义读取基表,它不是把当次查询结果永久复制为一张新表。可更新视图上的 WITH CHECK OPTION 要求通过该视图插入或修改后的行仍满足视图条件;它与“允许继续转授权”的 WITH GRANT OPTION 无关。
完整性与安全性也要分开:PRIMARY KEY、FOREIGN KEY、CHECK 等约束限制数据是否合法;授权限制**谁能对什么对象执行哪些操作**。第三方只调用存储过程时,可以结合执行权限、基表权限和元数据权限减少其对底层结构的直接访问;单独创建过程不会自动隐藏所有表定义。
例题 9:封装更新接口
数据库的安全机制中,通过提供( )供第三方开发人员调用进行数据更新,从而保证数据库的关系模式不被第三方所获取。
A、触发器 B、存储过程 C、视图 D、索引
参考答案与解析(本笔记补充,非官方)
B(存储过程)。 题干强调“供第三方调用进行数据更新”,存储过程可暴露操作接口,并配合执行权限隐藏底层表结构。视图也能限制列、行,但可更新性受定义与 DBMS 限制;触发器由配置的数据库事件触发,索引是访问路径。
专项题库练习(10 题)
本小节对应题库练习共 10 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 007
来源:知识点练习「数据库系统」第 7 题(原站入口)。
进行数据库逻辑结构设计时,要以(7)阶段形成的(8)作为设计依据。
请作答:第 7 题。
-
A. 需求分析
-
B. 概念结构设计
-
C. 物理结构设计
-
D. 数据库运行和维护
答案与解析
平台答案:A。
整理解析
结合第8空所列文档,选 A。需求分析产生需求说明、数据字典和数据流图,为后续逻辑结构设计提供需求依据。逻辑设计也会使用概念设计阶段的E-R等模型,因此不能把此题解释为它不需要概念结构设计成果。该材料两小问均未提供平台解析。
题目 008
来源:知识点练习「数据库系统」第 8 题(原站入口)。
进行数据库逻辑结构设计时,要以(7)阶段形成的(8)作为设计依据。
请作答:第 8 题。
-
A. 程序文档、数据字典和数据流图。
-
B. 需求说明文档、程序文档和数据流图
-
C. 需求说明文档、数据字典和数据流图
-
D. 需求说明文档、数据字典和程序文档
答案与解析
平台答案:C。
整理解析
选 C。需求说明文档描述业务要求,数据字典明确数据项及结构含义,数据流图表达数据流动和处理需求;这些均可在需求分析阶段形成。程序文档涉及具体实现,不是此阶段应有的必备成果。平台与相同材料第7题均无解析。
题目 017
展开题目 017(先作答,再查看解析)
来源:知识点练习「数据库系统」第 17 题(原站入口)。
给定三个关系模式及下图,实下划线标识主键:
部门(部门代码,部门名称,电话);员工(员工代码,姓名,部门代码,联系方式,薪资);项目(项目编号,项目名称,承担任务)。
部门与员工自然连接后为(16)元关系。员工与项目的联系类型为(17),须将此联系转成独立关系模式,其主键为(18)。
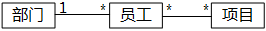
请作答:第 17 题。
-
A. 1对1
-
B. 1对多
-
C. 多对1
-
D. 多对多
答案与解析
平台答案:D。
整理解析
选 D。原图员工和项目两端均标*,表示多对多:员工可参与多个项目,项目也可有多个员工参与。上述联系类型已据原图核实。
题目 018
展开题目 018(先作答,再查看解析)
来源:知识点练习「数据库系统」第 18 题(原站入口)。
给定三个关系模式及下图,实下划线标识主键:
部门(部门代码,部门名称,电话);员工(员工代码,姓名,部门代码,联系方式,薪资);项目(项目编号,项目名称,承担任务)。
部门与员工自然连接后为(16)元关系。员工与项目的联系类型为(17),须将此联系转成独立关系模式,其主键为(18)。
请作答:第 18 题。
-
A. (项目名称,员工代码)
-
B. (项目编号,员工代码)
-
C. (项目名称,部门代码)
-
D. (项目名称,承担任务)
答案与解析
平台答案:B。
整理解析
选 B。原图的主键下划线表明,员工实体的主键是员工代码,项目实体的主键是项目编号。原图员工—项目为多对多且未显示联系属性,按普通二元联系转换规则,用这两个实体键共同标识一条联系;键中列的先后顺序不影响唯一性。项目名称等未被给定唯一性,不能代替项目编号。
题目 026
展开题目 026(先作答,再查看解析)
来源:知识点练习「数据库系统」第 26 题(原站入口)。
数据库设计的哪个阶段通常进行关系规范化( )?
-
A. 需求分析
-
B. 概念设计
-
C. 逻辑设计
-
D. 物理设计
答案与解析
平台答案:C。
整理解析
选 C。逻辑设计把概念模型转换成关系模式,并用键、函数依赖和范式分析调整结构。物理设计侧重索引、存储组织等实现安排。
题目 071
展开题目 071(先作答,再查看解析)
来源:知识点练习「数据库系统」第 71 题(原站入口)。
某高校合并各部门的分E-R图。人力部门将职工定义为(职工号、姓名、性别、出生日期),教学部门将教师定义为(教师号、姓名、职称)。这种差异属于(71),合并时拟采用(72)处理。
请作答:第71题。
-
A. 属性冲突
-
B. 命名冲突
-
C. 结构冲突
-
D. 实体冲突
答案与解析
平台答案:C。
整理解析
按题目把两者看作同一类人员的局部表示时,属性集合不同属于结构冲突,选C。属性冲突通常指同一属性的类型、范围或单位不一致;命名冲突指同名异义或异名同义。此处职工与教师的名称及标识还须统一,且教师是否仅是职工子集应由业务规则决定。
题目 072
展开题目 072(先作答,再查看解析)
来源:知识点练习「数据库系统」第 72 题(原站入口)。
某高校合并各部门的分E-R图。人力部门将职工定义为(职工号、姓名、性别、出生日期),教学部门将教师定义为(教师号、姓名、职称)。这种差异属于(71),合并时拟采用(72)处理。
请作答:第72题。
-
A. 职工和教师实体保持各自属性不变
-
B. 职工实体中加入职称属性,删除教师实体
-
C. 教师也是学校的职工,故直接将教师实体删除
-
D. 将教师实体所有属性并入职工实体,删除教师实体
答案与解析
平台答案:B。
整理解析
平台答案B:保留职工实体并增加职称,按其意图还需统一教师号与职工号。该方案隐含两个编号可等同或已有映射、可将教师特有属性并入职工的假设;若编号各有含义,直接删除教师实体可能丢失信息。平台称D必然重复记录姓名也不充分,属性集合合并可以消除同名项。因此B应作为题设教材口径,不能当作无需业务约束的唯一合并规则。
题目 078
展开题目 078(先作答,再查看解析)
来源:知识点练习「数据库系统」第 78 题(原站入口)。
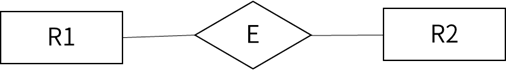
下图中实体R1与R2通过联系E关联。当E具有什么基数时,必须把该联系单独转换成关系模式?( )
-
A. 1:1
-
B. 1:*
-
C. *:1
-
D. *:*
答案与解析
平台答案:D。
整理解析
多对多联系(:)需建立独立关系,包含两侧实体键及联系自身的属性,选D。1:1通常可在适当一侧加入外键,1:或:1可在多端保存一端的键,因此这些联系不一定需要独立表。
题目 089
展开题目 089(先作答,再查看解析)
来源:知识点练习「数据库系统」第 89 题(原站入口)。
为第三方开发者提供可调用的数据更新接口,题目要求由此保证数据库关系模式不被第三方获取,应采用哪项机制?( )
-
A. 触发器
-
B. 存储过程
-
C. 视图
-
D. 索引
答案与解析
平台答案:B。
整理解析
存储过程可封装更新操作,对外提供调用接口,选B;要隐藏表结构还需配合执行权限、表权限及元数据访问控制,单独创建过程并不自动保证保密。平台称视图不能更新有误,满足数据库可更新条件的视图可以支持INSERT、UPDATE或DELETE。触发器通常由指定事件自动触发,不是这里供外部主动调用的接口。
题目 093
展开题目 093(先作答,再查看解析)
来源:知识点练习「数据库系统」第 93 题(原站入口)。
把E-R模型转成关系模型时,实体E1与E2之间的多对多联系R需建立独立关系。按通常转换规则,该关系的关键字由什么组成?( )
-
A. 联系R的属性
-
B. E1或E2的关键字
-
C. E1和E2的关键字
-
D. E1和E2的关键字加上R的属性
答案与解析
平台答案:C。
整理解析
通常由E1、E2各自的键组合而成,选C;组合键标识一对相联系的实体,联系自身的描述属性随该键确定。若业务允许同一实体对发生多次不同联系,还须额外建模事件或序号,不能无条件套用简单二元联系的规则。
关系代数
符号速查与表达式读法
关系代数用符号描述“怎样从表中取数据”。关系可以理解为表,元组是行,属性是列。阅读表达式时,先认出运算符,再看下标和括号里的输入关系。
| 符号 | 名称/读法 | 做什么 | 对应的 SQL 写法或思路 |
|---|---|---|---|
π |
投影;希腊字母 pi,读“派” | 保留指定列,并去掉重复行 | SELECT DISTINCT 列清单 |
σ |
选择;希腊字母 sigma,读“西格玛” | 按条件筛选行,保留原有列 | WHERE 条件 |
∪ |
并 | 合并两边的行,去重 | UNION |
∩ |
交 | 只保留两边都有的行 | INTERSECT |
− |
差 | 保留左边有、右边没有的行 | SQLite 使用 EXCEPT |
× |
笛卡尔积 | 左右两边的行进行所有可能的配对 | CROSS JOIN |
⋈ |
自然连接 | 所有同名列同时相等才配对,输出时合并同名列 | NATURAL JOIN |
⋈ 带条件下标 |
条件连接,也称 θ 连接;θ 读 theta | 只保留满足下标条件的配对;θ 代表连接条件 | JOIN ... ON 条件 |
÷ |
除 | 找出与右侧关系中每个值都有关联的左侧剩余属性值 | 常用两层 NOT EXISTS 表达“没有缺项” |
ρ |
重命名;希腊字母 rho | 为关系或属性改名 | 表别名、列别名 AS |
表中是理解上的对应:经典关系代数采用集合语义,SQL 默认可能保留重复,投影要注意 DISTINCT;SQL 中的 NULL 也有额外语义。本节练习数据不含 NULL。
下标写“取哪些列”或“筛选条件”,括号里写输入关系。 例如下面两种写法只是排版不同,含义相同:
π_{Sno,Sname}(S1),也可以排成 πSno,Sname(S1):从 S1 中取学号和姓名。σ_{Sno='No0003'}(S1),也可以排成 σSno='No0003'(S1):从 S1 中筛选学号为 No0003 的行。
有些题不用列名,改用**从 1 开始的列号**:
| 写法 | 应该怎样读 | 容易误解的地方 |
|---|---|---|
π_{1,4}(T) |
从 T 取第 1 列和第 4 列,并去重 | 不是第 1 列到第 4 列 |
σ_{2=5}(T) |
在题目的列号记法下,保留第 2 列值等于第 5 列值的行 | 不是判断常数 2 是否等于常数 5 |
σ_{B=5}(T) |
当 B 是列名、5 是数值常量时,保留 B 值等于 5 的行 | 条件中也可以出现常量,不能把所有数字都当列号 |
σ_{Sdept='IS'}(T) |
保留 Sdept 值等于字符串 IS 的行 | 引号内的 IS 是常量,不是列名 |
把列号记法翻译成 SQL 时,要先替换成实际列名;不能照抄成 WHERE 2=5,因为 SQL 会把它解释为两个数值常量的比较。
条件里的 ∧ 表示“并且”(SQL 的 AND),∨ 表示“或者”(OR),¬ 表示“非”(NOT);=、≠、<、>、≤、≥ 都是比较符号。例如 R.C=S.C ∧ R.D=S.D 要求两个条件同时成立。点号表示“表名.列名”,如 R.C 是关系 R 的 C 列。
嵌套表达式从里往外读。 对 π_{1,4}(σ_{2=5}(T)),先取得 T,再按第 2、5 列相等筛选行,最后取第 1、4 列。每完成一步都要重新确认当前表的列顺序:选择不改变列结构,投影和自然连接可能改变列数与编号。这里的括号用于指定输入关系和嵌套顺序,不表示乘法。
示例关系 S1、S2
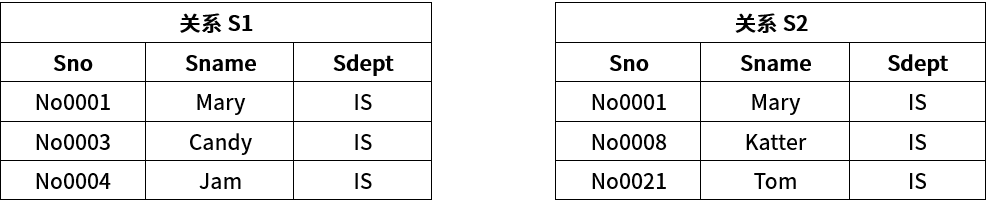
两表的列为 (Sno,Sname,Sdept),图中全部 Sdept 均为 IS。数据转写如下:
| 所属关系 | Sno | Sname | Sdept |
|---|---|---|---|
| S1、S2 | No0001 | Mary | IS |
| S1 | No0003 | Candy | IS |
| S1 | No0004 | Jam | IS |
| S2 | No0008 | Katter | IS |
| S2 | No0021 | Tom | IS |
并、交、差要求并相容:属性数相同且对应属性域兼容;必要时先重命名。经典关系代数采用集合语义,没有重复元组。
用 SQLite 创建练习数据
后面的 SQL 使用上图中的 S1、S2,可以直接在 SQLite 中运行。终端执行 sqlite3 relation-algebra.db 打开一个新的练习数据库,再执行一次以下建表和插入语句。这里将学号 Sno 设为各表的主键,字段均不允许为 NULL。
关系代数中的**关系可以理解为表,元组是行,属性是列**。下文用姓名简写部分结果,但并、交、差比较的都是查询返回的整行数据。SQL 未指定 ORDER BY 时不保证输出顺序,核对时看结果内容和行数即可。
并、交、差
(1)并【∪】:综合2个表的所有元组,且去除重复。
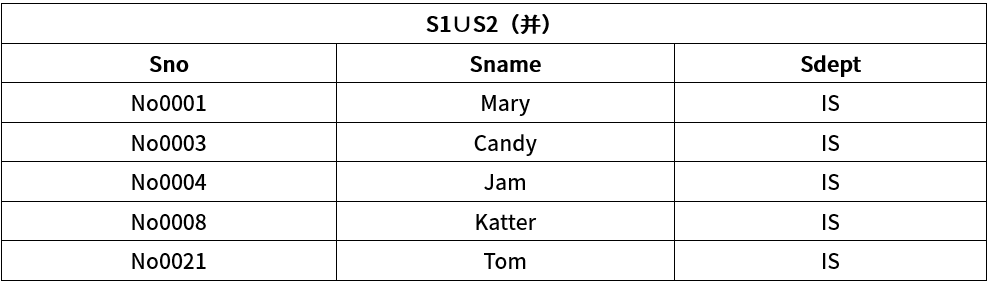
计算 S1 ∪ S2:
结果包含 Mary、Candy、Jam、Katter、Tom,共 5 行、3 列。Mary 的整行数据在两张表中相同,只保留一份。UNION 自带去重;如果改成 UNION ALL,则会保留两行 Mary,共返回 6 行,不符合关系代数并集的集合语义。
(2)交【∩】:列出2个表都有的元组。
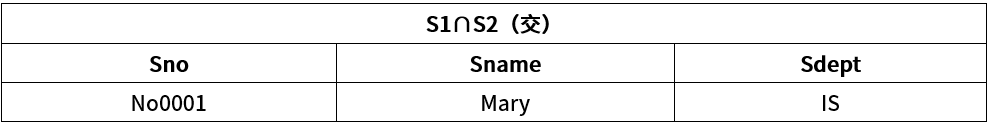
计算 S1 ∩ S2:
结果只有 (No0001,Mary,IS),共 1 行、3 列。即使姓名相同,只要学号或系别不同,也不算两张表共有的同一行。
(3)差【-】:以左侧对象为主,在左侧对象的元组集合中去除右侧对象已有的元组,则为差集。
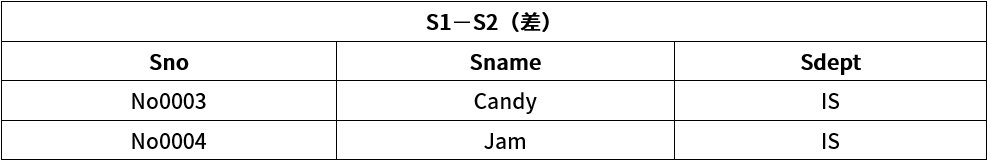
计算 S1 − S2,即 S1 有、S2 没有的行:
结果是 Candy、Jam,共 2 行、3 列。反过来计算 S2 − S1:
结果是 Katter、Tom,共 2 行、3 列。SQLite 中用 EXCEPT 表示差集;差集通常不可交换,交换两边的关系可能改变结果。
写这些集合运算的 SQL 时,两边查询的列数必须相同,列的顺序和含义应对应,例如都按 Sno,Sname,Sdept 输出。它们按列的位置比较,不会自动根据列名重新排列。
笛卡尔积
笛卡尔积【×】:二元运算,属性列数是二者之和,元组行数是二者乘积。元组结果是以左侧对象的元组分别拼接右侧对象的元组,形成不同的排列组合。
不同表的同名属性,需要以“表名.列名”加以区分。
特点:所有列保留,所有行全映射。
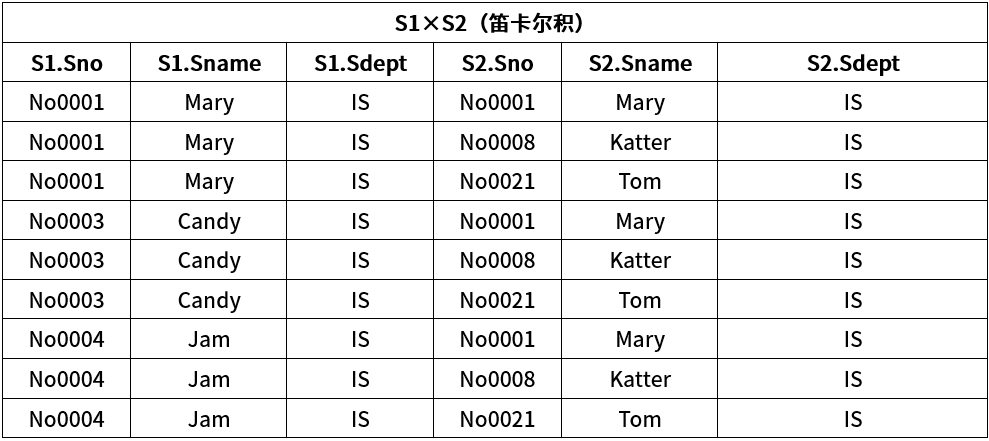
本例笛卡尔积为 3×3=9 行、3+3=6 列。每个 S1 元组分别与 S2 的三个元组拼接;即使字段同名也先保留为两列。一般地,行数为 |R|×|S|,列数为 degree(R)+degree(S)。
SQLite 使用 CROSS JOIN 表示笛卡尔积。AS 只是给结果列起别名,便于区分左右两张表的同名列:
为了看清配对关系,可以只显示两边的姓名。这条查询在笛卡尔积后取了两列,因此显示 2 列,而上面的完整笛卡尔积仍然是 6 列。
| 左边姓名 | 右边姓名 |
|---|---|
| Mary | Mary |
| Mary | Katter |
| Mary | Tom |
| Candy | Mary |
| Candy | Katter |
| Candy | Tom |
| Jam | Mary |
| Jam | Katter |
| Jam | Tom |
并集是把行合并,笛卡尔积是把行两两配对。 本例并集仍有 3 列,完整笛卡尔积有 6 列;笛卡尔积不要求两张表有相同的列,也不要求配对的学生相同。
- 笛卡尔积:所有列保留,所有行全映射
- 投影:选择列
- 选择:选择行
投影和选择
投影和选择都是一元运算:只需要一个输入关系,与挑选几列或筛出几行无关。并、交、差、笛卡尔积都需要两个输入关系,属于二元运算。
投影【π】:垂直方向上对属性列进行选择。
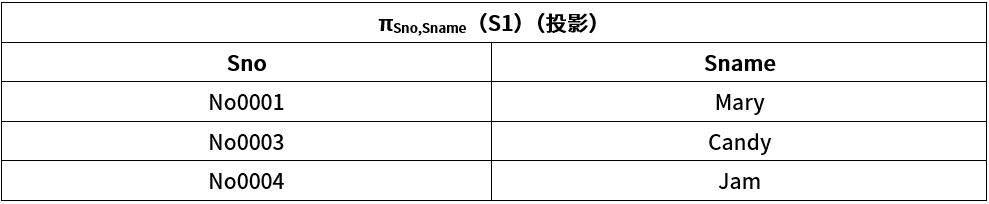
图中投影结果为 (No0001,Mary)、(No0003,Candy)、(No0004,Jam)。若仅投影 Sdept,则结果只有一行 (IS),因为投影会去重;SQL SELECT Sdept 默认保留重复,要用 DISTINCT 才有相同集合语义。
π 表示投影,下标指定保留的列,括号里是输入关系。例如 π_{Sno,Sname}(S1) 就是从 S1 中只取学号和姓名,对应 SQL:
DISTINCT 的英文意思是“不同的、互不相同的”,在 SQL 中表示**去掉重复行**。比较下面两条查询:
查询多列时,只有**这些列的值全部相同**才算重复行,并不是分别对每一列去重。上面的学号各不相同,因此投影学号、姓名后仍有 3 行。
选择【σ】:水平方向上对元组行进行选择。
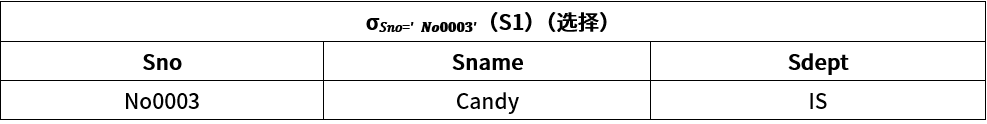
选择条件为 Sno='No0003',得到 (No0003,Candy,IS) 一行,列结构不变。σ 选择行,π 投影列;先按连接条件选择,再投影所需列,可避免提前丢掉比较需要的属性。
σ 表示选择,下标是筛选条件。例如 σ_{Sno='No0003'}(S1) 对应 SQL:
结果只保留 Candy 这一行,仍包含学号、姓名、系别 3 列。
投影主要对应 SQL 中 SELECT DISTINCT 后的列清单;关系代数中的“选择”主要对应 WHERE 条件,容易与 SQL 关键字 SELECT 混淆。笛卡尔积对应 CROSS JOIN,再加条件筛选配对,就能表达条件连接。
自然连接
自然连接:二元运算,属性列数是二者之和去除重复,结果元组是同名属性列取值相等的元组。
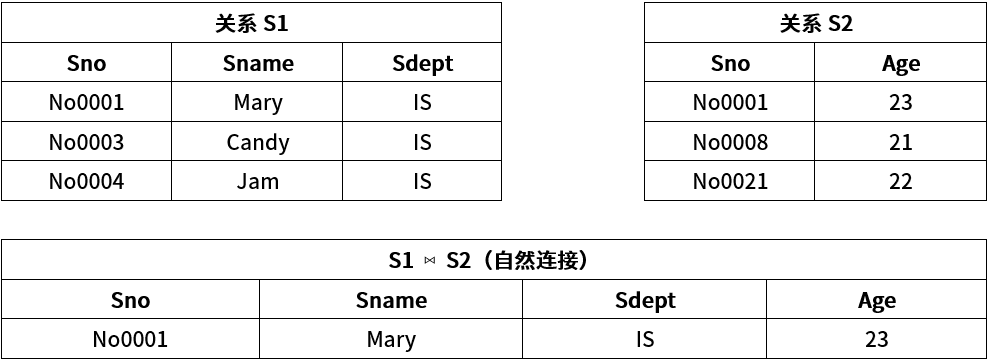
此图换用了另一张 S2:(Sno,Age) 三行分别为 (No0001,23)、(No0008,21)、(No0021,22)。共有列只有 Sno,故自然连接结果仅 (No0001,Mary,IS,23)。
按笛卡尔积列号 (S1.Sno,Sname,Sdept,S2.Sno,Age),先筛选 1=4,再投影 1,2,3,5。若先投影,原第 4 列 S2.Sno 被删,新第 4 列变成 Age;再按 1=4 比較已改变含义。
等价:π 1,2,3,5 (σ 1=4 (S1×S2))
不等价:σ 1=4 (π 1,2,3,5 (S1×S2))
自然连接、外连接与列号换算
自然连接要求**所有同名属性同时相等**,再合并各对同名列。若 R、S 分别有 r、s 列,共有 k 个同名列,结果列数是 r+s−k;行数则取决于匹配情况,不能由列数推出。等值连接仅按指定的相等条件匹配,一般保留两边的连接列;不要把仅按一个字段相等的查询自行改成自然连接。
数值列号必须针对**当前运算的输入**解释。例如 R(P,Q)、S(Q,T) 的笛卡尔积列序为 R.P,R.Q,S.Q,S.T,其第 3 列是 S.Q;自然连接后常按 P,Q,T 排列,第 3 列才是 T。把自然连接改写成笛卡尔积时,要补齐同名列相等条件,再投影去掉重复列;进一步嵌套投影后,列号又要重新编号。σ₂₌₃ 是比较第 2、3 列,写成 σ₂₌'3' 则变成与字符串常量比较。
内连接只保留匹配行;外连接还保留指定一侧或两侧的未匹配行,对缺少的另一侧属性补 NULL:
| 连接类型 | 保留的行 |
|---|---|
| 左外连接 | 所有匹配结果,加左表未匹配行 |
| 右外连接 | 所有匹配结果,加右表未匹配行 |
| 全外连接 | 所有匹配结果,加两表各自未匹配行 |
例如 R={(1,a),(2,b)}、S={(2,x),(2,y),(3,z)},按第一列连接,有 (2,b,x)、(2,b,y) 两个匹配结果;左外连接再加 (1,a,NULL) 共 3 行,右外连接再加 (3,NULL,z) 共 3 行,全外连接共 4 行。一行可匹配多行,所以左外连接行数未必等于左表原行数。SQL 的 LEFT JOIN ... ON ... 用于左外连接;若随后在 WHERE 中要求右表某列等于普通值,补 NULL 的行通常会被排除,可能改变保留未匹配行的意图。
查询优化:尽早筛选,保留连接列
在内连接中,只涉及单表属性的条件通常可以先在该表上执行,再连接,称为**选择下推**。例如要查某状态的订单和某城市的客户,可先分别筛订单、筛客户,再按客户号连接,减少中间结果。这个变换保持结果语义,但实际性能还取决于索引、统计信息与执行计划。
**投影下推**则提前去掉后续不需要的列,降低中间记录宽度;必须保留最终输出、连接条件和后续筛选需要的全部列。例如最终只输出客户名和订单金额,连接前仍须保留双方客户号。不能删除连接键后再期待自然连接按原条件匹配。对外连接,条件放在 ON、WHERE 或连接前可能改变哪些未匹配行被保留,不能无条件套用内连接的下推规则。
除法表达“满足全部要求”。 对关系 R(X,Y) 和 S(Y),R÷S 返回这样的 X:它与 S 中每个 Y 的组合都出现在 R 中。例:课程完成记录 Completion(person,course) 为 {(甲,A),(甲,B),(乙,A),(丙,A),(丙,B),(丙,C)},必修集合 Required(course)={A,B},相除得到 {甲,丙}。乙缺 B;丙多学了 C 不影响满足要求。“全部”既不是“至少一门”,也不是“只能学这些课”。
推导时可先找缺项:候选人集合 C=π_person(Completion),应有组合为 C×Required,缺失组合为 (C×Required)−Completion。投影出有缺项的人并排除,就得到 C−π_person((C×Required)−Completion)。必修集合为空时没有任何缺项,结果是整个候选集合 C;未出现在 Completion 中的人不属于这里的候选范围。不能只比较总课程数:学了 A、C 两门,数量虽等于必修课数,仍缺 B。
例题 10:自然连接后的列号
给定关系R(A,B,C,D)和S(C,D,E),若关系R与S进行自然连接运算,则运算后的元组属性列数为( );关系代数表达式π 1,4 (σ 2=5 (R⋈S))与( )等价。
A、4 B、5 C、6 D、7
A、π A,D (σ C=D (R×S))
B、π R.A,R.D (σ R.B=S.C (R×S))
C、π A,R.D (σ R.C=S.D (R×S))
D、π R.A,R.D (σ R.B=S.E (R×S))
参考答案与解析(本笔记补充,非官方)
第一空 B(5 列);第二空按字面没有完全正确的选项。 自然连接的列顺序按题目惯例为 (A,B,C,D,E),因此第 1、4 列是 A、D,第 2、5 列是 B、E。完整等价式是:
π[R.A,R.D](σ[R.C=S.C ∧ R.D=S.D ∧ R.B=S.E](R×S))。
D 仅对应附加条件 R.B=S.E,遗漏自然连接要求的 R.C=S.C 和 R.D=S.D。 若试卷意图只是考列号,D 可能是预期选项,但不能把它当成严格等价式。
反例:R={(a,9,1,2)}、S={(3,4,9)}。自然连接因 C、D 均不相等得到空集;D 的笛卡尔积筛选却得到 (a,2)。A、B、C 连附加比较的列都不对应。
把题干表达式逐层拆开。 π_{1,4}(σ_{2=5}(R⋈S)) 依次执行以下三步:
| 步骤 | 操作 | 输入与输出 |
|---|---|---|
| 1 | R⋈S:自然连接 |
R 的 4 列与 S 的 3 列中,C、D 是同名列;要求 R.C=S.C AND R.D=S.D,合并后为 A、B、C、D、E 共 5 列 |
| 2 | σ_{2=5}:筛选行 |
此时第 2 列是 B,第 5 列是 E,只保留 B=E 的行,列仍是 A、B、C、D、E |
| 3 | π_{1,4}:保留列 |
此时第 1 列是 A,第 4 列是 D,最终只输出 A、D,并去重 |
第一步后的列号必须先写清楚,不能直接拿原表 S 的列号来套:
| 列号 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| 属性 | A | B | C | D | E |
用一组假设数据演示,先给出关系 R:
| A | B | C | D |
|---|---|---|---|
| a1 | 9 | c1 | d1 |
| a2 | 7 | c2 | d2 |
关系 S:
| C | D | E |
|---|---|---|
| c1 | d1 | 9 |
| c2 | d2 | 8 |
自然连接后,两组 C、D 分别匹配,得到:
| A | B | C | D | E |
|---|---|---|---|---|
| a1 | 9 | c1 | d1 | 9 |
| a2 | 7 | c2 | d2 | 8 |
再检查 B=E:第一行 9=9,保留;第二行 7≠8,排除。最后只取 A、D,结果是一行 (a1,d1)。
下面用 SQLite 的 WITH ... VALUES 临时提供 R、S 两组数据,可以直接运行,不需要额外建表:
从 SQL 转回关系代数时,也要保留 ON 中的两个同名列匹配条件;只写 WHERE 中的 B=E,并不能代替自然连接。
专项题库练习(18 题)
本小节对应题库练习共 18 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 016
来源:知识点练习「数据库系统」第 16 题(原站入口)。
给定三个关系模式及下图,实下划线标识主键:
部门(部门代码,部门名称,电话);员工(员工代码,姓名,部门代码,联系方式,薪资);项目(项目编号,项目名称,承担任务)。
部门与员工自然连接后为(16)元关系。员工与项目的联系类型为(17),须将此联系转成独立关系模式,其主键为(18)。
请作答:第 16 题。
-
A. 5
-
B. 6
-
C. 7
-
D. 8
答案与解析
平台答案:C。
整理解析
选 C。部门有3个属性,员工有5个属性,共同属性只有部门代码;自然连接合并这一列,结果的度为3+5−1=7。“7元”指7个属性,不是7条记录。原图及其中的主键下划线已核实。
题目 034
来源:知识点练习「数据库系统」第 34 题(原站入口)。
给定R(A,B,C,D)和S(A,C,E,F)。自然连接R⋈S有(34)个属性列;与选择表达式 σ_{R.B>S.E}(R⋈S) 等价的关系代数式是(35)。
请作答:第 34 题。
-
A. 4
-
B. 5
-
C. 6
-
D. 8
答案与解析
平台答案:C。
整理解析
选 C。两个关系各有4列,同名列为A、C,自然连接各保留一份,因此结果有4+4−2=6列,可排列为A、B、C、D、E、F。
题目 035
展开题目 035(先作答,再查看解析)
来源:知识点练习「数据库系统」第 35 题(原站入口)。
给定R(A,B,C,D)和S(A,C,E,F)。自然连接R⋈S有(34)个属性列;与选择表达式 σ_{R.B>S.E}(R⋈S) 等价的关系代数式是(35)。
请作答:第 35 题。
-
A. σ2 > 7(R×S)
-
B. π1,2,3,4,7,8(σ1=5^2 > 7^3=6(R×S))
-
C. σ2 > '7'(R×S)
-
D. π1,2,3,4,7,8(σ1=5^2 > ’7’^3=6(R×S))
答案与解析
平台答案:B。
整理解析
选 B。R×S的8列依次为R.A、R.B、R.C、R.D、S.A、S.C、S.E、S.F;自然连接需1=5且3=6,另加2>7,再投影1、2、3、4、7、8删除重复连接列。题中^按逻辑且理解。A缺连接条件与投影;C、D把7放入引号中,变成常量而不是第7列。
题目 036
展开题目 036(先作答,再查看解析)
来源:知识点练习「数据库系统」第 36 题(原站入口)。
在使用关系R、S的下列表达式中,要求筛选B='大数据'且F='开发平台',最终输出A、B、C、F。按题意选择查询效率最高者( )。
-
A. π1,2,3,8(σ2=‘大数据’ ^ 1=5 ^ 3=6 ^ 8=‘开发平台’(R×S))
-
B. π1,2,3,8(σ1=5 ^ 3=6 ^ 8=‘开发平台’(σ2=‘大数据’(R)×S))
-
C. π1,2,3,8(σ2=‘大数据’ ^ 1=5 ^ 3=6(R×σ4=‘开发平台’(S))
-
D. π1,2,3,8(σ1=5 ^ 3=6(σ2=‘大数据’(R)×σ4=‘开发平台’(S)))
答案与解析
平台答案:D。
整理解析
平台选 D,依据是在两侧尽早筛选,减少连接前的行数。原页已核实,本题没有重列或明确引用R、S的模式,因此不能把相邻题模式直接当成本题已给条件。若仅作为条件性参考沿用Q34—35的R(A,B,C,D)、S(A,C,E,F),B在R第2列、F在S第4列,D的下标可对应所求。原选项C有3个左括号、2个右括号,属原站缺括号,已保留而未补齐。选择下推是逻辑优化原则,实际耗时仍由执行计划、索引和数据分布决定。
题目 058
展开题目 058(先作答,再查看解析)
来源:知识点练习「数据库系统」第 58 题(原站入口)。
已知R(A,B,C,D)、S(C,D,E)。R与S自然连接后的属性列数为(58);关系代数式π1,4(σ2=5(R⋈S))与第(59)空哪一选项等价?
请作答:第58题。
-
A. 4
-
B. 5
-
C. 6
-
D. 7
答案与解析
平台答案:B。
整理解析
自然连接要求同名属性C、D分别相等,并合并重复的同名列,结果为A、B、C、D、E,共4+3−2=5列,选B。本空计算独立成立;同材料第59题的备选式都遗漏连接条件,不能照搬为自然连接。
题目 059
展开题目 059(先作答,再查看解析)
来源:知识点练习「数据库系统」第 59 题(原站入口)。
已知R(A,B,C,D)、S(C,D,E)。R与S自然连接后的属性列数为(58);关系代数式π1,4(σ2=5(R⋈S))与第(59)空哪一选项等价?
请作答:第59题。
-
A. πA,D(σC=D(R×S))
-
B. πR.A,R.D(σR.B=S.C(R×S))
-
C. πA,R.D(σR.C=S.D(R×S))
-
D. πR.A,R.D(σR.B=S.E(R×S))
答案与解析
平台答案:D。
整理解析
平台答案D保留,但四个选项均不与原式严格等价,平台解析也承认这一点。自然连接后的第2、5列分别是B、E,第1、4列为A、D;若改用笛卡尔积,正确表达式应为πR.A,R.D(σR.B=S.E ∧ R.C=S.C ∧ R.D=S.D(R×S))。D只保留B=E,漏掉两个同名列相等条件。例如R={(1,9,3,4)}、S={(8,7,9)}时,自然连接为空,D却得到{(1,4)},因此只能说D最接近题意,不能称其等价。
题目 060
展开题目 060(先作答,再查看解析)
来源:知识点练习「数据库系统」第 60 题(原站入口)。
已知R(A,B,C,D,E)和S(A,C,E,F,G),进行自然连接R⋈S后,结果保留哪些属性列?( )
-
A. R.A,R.C,R.E,S.A,S.C,S.E
-
B. R.A,R.B,R.C,R.D,R.E,S.F,S.G
-
C. R.A,R.B,R.C,R.D,R.E,S.A,S.C,S.E
-
D. R.A,R.B,R.C,R.D,R.E,S.A,S.C,S.E,S.F,S.G
答案与解析
平台答案:B。
整理解析
共同属性为A、C、E,自然连接在这三列上匹配,并各保留一份。因此可表示为R的A、B、C、D、E加S的F、G,合计7列,选B。此处以前一个关系的列标记同名列只是表示习惯,不是说自然连接只按左表数据保留行。
题目 074
展开题目 074(先作答,再查看解析)
来源:知识点练习「数据库系统」第 74 题(原站入口)。
关系R、S的数据如下表。第(74)空选择自然连接R⋈S的结果;第(75)空依次求两者的左外连接、右外连接、完全外连接的元组数。
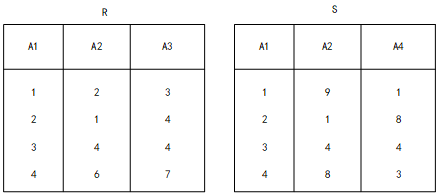
请作答:第74题。
-
A. { (2,1,4),(3,4,4)}
-
B. { (2,1,4,8),(3,4,4,4)}
-
C. { (1.4.2,1.8),(3.4.4.3,4,4)}
-
D. { (1,2,3,1,9,1),(2,1,4,2,1,8),(3,4,4,3,4,4).(4,6,7.4,8,3)}
答案与解析
平台答案:B。
整理解析
两表共同属性是A1、A2,必须同时匹配。只有(2,1)和(3,4)两组匹配,将R中的A3与S中的A4接在共同列后,得到{(2,1,4,8),(3,4,4,4)},选B。不能仅按A1相等进行连接。
题目 075
展开题目 075(先作答,再查看解析)
来源:知识点练习「数据库系统」第 75 题(原站入口)。
关系R、S的数据如下表。第(74)空选择自然连接R⋈S的结果;第(75)空依次求两者的左外连接、右外连接、完全外连接的元组数。
请作答:第75题。
-
A. 2,2,4
-
B. 2,2,6
-
C. 4,4,4
-
D. 4,4,6
答案与解析
平台答案:D。
整理解析
自然连接有2个匹配元组;R另有(1,2,3)、(4,6,7)两个未匹配元组,S另有(1,9,1)、(4,8,3)两个未匹配元组。左外连接补上R侧两行,得4行;右外连接补上S侧两行,得4行;完全外连接保留两侧未匹配行,得2+2+2=6行,选D。缺失的对侧属性用NULL补齐,共同属性仍保留原值。
题目 081
展开题目 081(先作答,再查看解析)
来源:知识点练习「数据库系统」第 81 题(原站入口)。
销售公司有员工表E(工号、姓名、部门名、电话、住址)、商品表C(商品号、商品名、库存数)、销售表EC(工号、商品号、销售数、销售日期)。要求查询销售部1在2020年11月11日售出“HUWEI Mate40”的员工工号、姓名、部门名,以及商品名和销售数,补全表达式:
π1,2,3,7,8((81)⋈((82)⋈(83)))。
请作答:第81题。
-
A. σ3=销售部1(E)
-
B. σ3=销售部1(C)
-
C. σ3=‘销售部1’(E)
-
D. σ3=‘销售部1’(C)
答案与解析
平台答案:C。
整理解析
部门名是E的第3列,因此应在员工表上筛选3=‘销售部1’,选C。按本题常量记号约定,部门名作为字符串需要引号。C表的第3列为库存数,不是部门名;商品名HUWEI Mate40按题面拼写保留。
题目 082
展开题目 082(先作答,再查看解析)
来源:知识点练习「数据库系统」第 82 题(原站入口)。
销售公司有员工表E(工号、姓名、部门名、电话、住址)、商品表C(商品号、商品名、库存数)、销售表EC(工号、商品号、销售数、销售日期)。要求查询销售部1在2020年11月11日售出“HUWEI Mate40”的员工工号、姓名、部门名,以及商品名和销售数,补全表达式:
π1,2,3,7,8((81)⋈((82)⋈(83)))。
请作答:第82题。
-
A. π2,3(σ2=‘HUWEI Mate40’(C))
-
B. π1,2(σ2=‘HUWEI Mate40’(C))
-
C. π2,3(σ2=‘HUWEI Mate40’(EC))
-
D. π1,2(σ2=‘HUWEI Mate40’(EC))
答案与解析
平台答案:B。
整理解析
商品名在C的第2列,先筛选‘HUWEI Mate40’,再保留第1、2列的商品号与商品名,选B。商品号用于与EC连接,商品名用于最终输出;A丢掉连接所需的商品号。按题面列序完成两次自然连接后,第7、8列确为商品名与销售数。
题目 083
展开题目 083(先作答,再查看解析)
来源:知识点练习「数据库系统」第 83 题(原站入口)。
销售公司有员工表E(工号、姓名、部门名、电话、住址)、商品表C(商品号、商品名、库存数)、销售表EC(工号、商品号、销售数、销售日期)。要求查询销售部1在2020年11月11日售出“HUWEI Mate40”的员工工号、姓名、部门名,以及商品名和销售数,补全表达式:
π1,2,3,7,8((81)⋈((82)⋈(83)))。
请作答:第83题。
-
A. σ4=‘2020年11月11日’(C)
-
B. σ3=‘2020年11月11日’(C)
-
C. σ4=‘2020年11月11日’(EC)
-
D. σ3=‘2020年11月11日’(EC)
答案与解析
平台答案:C。
整理解析
销售日期在EC的第4列,故应使用σ4=‘2020年11月11日’(EC),选C。EC第3列是销售数;C没有销售日期且只有三列,不能在C上使用日期条件。
题目 087
展开题目 087(先作答,再查看解析)
来源:知识点练习「数据库系统」第 87 题(原站入口)。
学生关系S(学号、姓名、学院名、电话、家庭住址)、课程关系C(课程号、课程名、选修课程号)、选课关系SC(学号、课程号、成绩)。查询“张晋”选修“市场营销”课程的学号、学生名、学院名、成绩,题面表达式为:
π1,2,3,7(π1,2,3(87)∞(88))。
请作答:第87题。
-
A. σ2=张晋(S)
-
B. σ2='张晋'(S)
-
C. σ2=张晋(SC)
-
D. σ2='张晋'(SC)
答案与解析
平台答案:B。
整理解析
姓名是S的第2列,先筛选2='张晋',再投影学号、姓名、学院名,平台答案B。原站可见页面已核实:连接符确以∞显示,外层投影确为1,2,3,7,关系与选项没有缺失。按平台解析的自然连接语义并填入第88题C,两层连接最终只有6列,成绩是第6列,第7列不存在。这是原题错误,题面保留原式,不改平台答案。
题目 088
展开题目 088(先作答,再查看解析)
来源:知识点练习「数据库系统」第 88 题(原站入口)。
学生关系S(学号、姓名、学院名、电话、家庭住址)、课程关系C(课程号、课程名、选修课程号)、选课关系SC(学号、课程号、成绩)。查询“张晋”选修“市场营销”课程的学号、学生名、学院名、成绩,题面表达式为:
π1,2,3,7(π1,2,3(87)∞(88))。
请作答:第88题。
-
A. π2,3(σ2='市场营销'(C))∞SC
-
B. π2,3(σ2=市场营销(SC))∞C
-
C. π1,2(σ2='市场营销'(C))∞SC
-
D. π1,2(σ2=市场营销(SC))∞C
答案与解析
平台答案:C。
整理解析
按平台的自然连接意图,先在C第2列筛选课程名,再投影课程号、课程名,并与SC按课程号连接,应选C。共享解析末尾“答案选B”属于第87题。原站可见页面已核实题干及选项的∞字形和外层投影第7列,未丢失条件;按自然连接最终为学号、姓名、学院名、课程号、课程名、成绩,共6列,因此原式第7列错误。正确意图可用属性名投影成绩或第6列表示,源式及平台答案仍保留。
题目 091
展开题目 091(先作答,再查看解析)
来源:知识点练习「数据库系统」第 91 题(原站入口)。
给定R(A,B,C,D)与S(A,D,E,F)。自然连接R▷◁S的结果含(91)个属性;σR.B>S.F(R▷◁S)与第(92)空哪一式等价?
请作答:第91题。
-
A. 4
-
B. 5
-
C. 6
-
D. 8
答案与解析
平台答案:C。
整理解析
两个关系各有4列,同名属性为A、D,自然连接合并这两列,得到A、B、C、D、E、F,共4+4−2=6列,选C。
题目 092
展开题目 092(先作答,再查看解析)
来源:知识点练习「数据库系统」第 92 题(原站入口)。
给定R(A,B,C,D)与S(A,D,E,F)。自然连接R▷◁S的结果含(91)个属性;σR.B>S.F(R▷◁S)与第(92)空哪一式等价?
请作答:第92题。
-
A. σ2>8(RxS)
-
B. π1,2,3,4,7,8(σ1=5 ∧ 2>8 ∧ 4=6(R×S))
-
C. σ”2">"8"(RxS)
-
D. π1,2,3,4,7,8(σ1=5 ∧ "2">"8" ∧ 4=6(RxS))
答案与解析
平台答案:B。
整理解析
在R×S中列序为R.A、R.B、R.C、R.D、S.A、S.D、S.E、S.F。自然连接需1=5且4=6,再筛选2>8,最后投影1、2、3、4、7、8去掉重复同名列,故B等价。A遗漏自然连接条件与合并重复列的投影;C、D把列号加引号后变成字面量比较,不是比较第2、8列。
题目 097
展开题目 097(先作答,再查看解析)
来源:知识点练习「数据库系统」第 97 题(原站入口)。
员工关系E(员工号、员工名、部门名、电话、家庭住址)、工程关系P(工程号、工程名、前期工程号)、参与关系EP(员工号、工程号、工作量)。查询员工“005”参与“虎头山隧道”工程时的员工名、部门名、工程名、工作量,补全下式:
π2,3,5,6(π1,2,3((97))⋈((98)))。
请作答:第97题。
-
A. 𝜎2=‘005’(E)
-
B. 𝜎1=‘005’(E)
-
C. 𝜎2=‘005’(P)
-
D. 𝜎1=‘005’(P)
答案与解析
平台答案:B。
整理解析
员工号为E的第1列,需在E上选择1=‘005’,故选B。保留引号可明确005是带前导零的标识符;E第2列是员工名,P中也没有员工号。
题目 098
展开题目 098(先作答,再查看解析)
来源:知识点练习「数据库系统」第 98 题(原站入口)。
员工关系E(员工号、员工名、部门名、电话、家庭住址)、工程关系P(工程号、工程名、前期工程号)、参与关系EP(员工号、工程号、工作量)。查询员工“005”参与“虎头山隧道”工程时的员工名、部门名、工程名、工作量,补全下式:
π2,3,5,6(π1,2,3((97))⋈((98)))。
请作答:第98题。
-
A. π2,3(σ2=’虎头山隧道’(P)) ⋈ EP
-
B. π2,3(σ2=’虎头山隧道’(EP)) ⋈ P
-
C. π1,2(σ2=’虎头山隧道’(EP)) ⋈ P
-
D. π1,2(σ2=’虎头山隧道’(P)) ⋈ EP
答案与解析
平台答案:D。
整理解析
在P第2列筛选工程名,投影第1、2列以保留工程号、工程名,再按工程号与EP自然连接,选D。不能先丢掉工程号,也不能在EP里按工程名筛选。与E的前三列连接后,列序为员工号、员工名、部门名、工程号、工程名、工作量,外层投影2、3、5、6恰好得到所需结果。
规范化理论
规范化理论基本概念
规范化理论 – 函数依赖
设R(U)是属性U上的一个关系模式,X和Y是U的子集,r为R的任一关系,如果对于r中的任意两个元组u,v,只要有u[X]=v[X],就有u[Y]=v[Y],则称X函数决定Y,或称Y函数依赖于X,记为X→Y。
特殊函数依赖如下所示:
(1)关系模式:R1(A,B,C,D)
依赖集1:{AB→D,A→C}
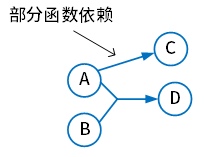
AB→D 且 A→C:AB 能决定全体属性,是候选键;C 依赖键的真子集 A,所以 C 对 AB 是部分依赖。D 对 AB 是否完全依赖,要检查 A、B 单独都不能推出 D,在本依赖集下确实如此。不要把“左侧多个属性”直接等同于部分依赖。
(2)关系模式:R2(A,B,C)
依赖集2:{A→B,B→C}
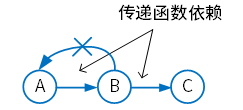
A→B→C 得到 A→C,键是 A。规范化里的传递依赖问题还要看中间决定因素是否为超键、右部是否为非主属性;“有可传递推导”并不自动意味着违反 3NF。
由:A→B,B→C,可得出A→C。此为传递函数依赖
函数依赖是对**所有合法数据状态**的约束,不是从一张当前样本表偶然观察到的规律。X→Y 表示 X 相同就必须 Y 相同,并不要求不同 X 对应不同 Y。若 Y⊆X,称为平凡依赖,例如 AB→A;否则为非平凡依赖。Y 对 X 完全依赖要求 X 的任何真子集都不能决定 Y;只要有真子集能决定 Y,就是部分依赖。后续范式检查还要结合候选键、主属性与非主属性,不能只看箭头长短。
规范化理论 – Armstrong公理
关系模式R(U,F)有以下推理规则:
A1.自反律(Reflexivity):若Y⊆X⊆U,则X→Y成立。
A2.增广律(Augmentation):若Z⊆U且X→Y,则XZ→YZ成立。
A3.传递律(Transitivity):若X→Y且Y→Z,则X→Z成立。
根据A1,A2,A3这三条推理规则可以得到下面三条推理规则:
合并规则:由X→Y,X→Z,有X→YZ。
伪传递规则:由X→Y,WY→Z,有XW→Z。 特点:中间多了一个朋友。
分解规则:由X→Y及Z⊆Y,有X→Z。
规范化理论 - 键
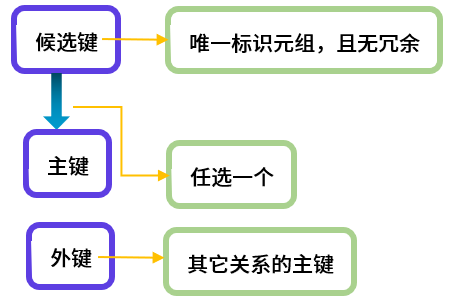
求候选键使用闭包:从 X 本身出发,反复应用所有“左部已包含在当前集合中”的依赖,直到不再增长。X⁺=U 说明 X 是超键,再逐个删属性检验最小性。只在依赖左部出现、从不在右部出现的属性必须进入每个键,但右部属性也可能参与不同候选键,仍需计算。外键的完整定义见本篇前文,图中“其他关系主键”只是简写。
- 主属性与非主属性:组成候选码的属性就是主属性,其它的就是非主属性。
规范化理论 - 求候选键实例
闭包的“当前已知属性”要累计保留。例如 U={P,Q,R,S,T}、F={P→Q,Q→R,PS→T}:P、S 都不在依赖右部,每个键都必须含它们;从 PS 出发依次加入 Q、R、T,得到 (PS)⁺=U,且不能删去 P 或 S,因此 PS 是唯一候选键。只在左右两边都不出现的属性,也必须放入每个键,因为没有依赖能把它推出来。
若必含属性的闭包还不覆盖 U,就继续尝试加入其他属性,并在每个超键中删去多余属性。找出一个候选键不表示只有这一个;判定主属性要看**全部候选键的并集**,而“每个候选键都包含”的属性取的是交集。
冗余依赖与最小覆盖
检验一整条 X→A 是否冗余,应先从 F 中**临时删掉该依赖**,再求 X 的闭包;若仍包含 A,就能删掉。检验左部的某个属性 B 是否多余,则在当前 F 下求 (X−{B})⁺,看能否推出右部。两者不同:缩短左部不等于能删除整条依赖。
例如 {P→Q,Q→R,P→R,PQ→S} 中,P→R 可由前两条推出,整条冗余;PQ→S 的 Q 可省,因为 P 先推出 Q 再推出 S,但该依赖不能整条删掉,否则得不到 S。最小覆盖通常依次做右部拆成单属性、约简左部、删除冗余依赖,直到不能继续;它保持原来的全部可推导依赖,但形式未必唯一。
例题 11:十属性关系的候选码
关系模式P(A,B,C,D,E,F,G,H,I,J)满足下列函数依赖:FD={ABD→E,AB→G,B→F,C→J,CJ→I,G→H},求候选码。
参考答案与解析(本笔记补充,非官方)
唯一候选码为 ABCD。
A、B、C、D 均没有出现在任一依赖的右部,任何候选码都必须包含它们。
(ABCD)⁺ = ABCD → ABCDEFGJ → ABCDEFGHIJ:ABD 推出 E,AB 推出 G,B 推出 F,C 推出 J,再由 CJ 推出 I、G 推出 H。ABCD 已覆盖全部属性,且去掉 A、B、C、D 中任一个都无法补回,所以最小且唯一。
例题 12:单属性候选键
关系R(A,B,C)满足下列函数依赖:F={B→C,B→A,A→BC},关系R的候选关键字为( )。
A、AB B、A和B C、A和BC D、AC和AB
参考答案与解析(本笔记补充,非官方)
B。 A⁺=ABC,B⁺=ABC,C⁺=C。A 和 B 分别是候选键;AB、AC、BC 虽有的可作超键,但不满足最小性。
例题 13:重叠候选键与主属性
若给定的关系模式为R,U={A,B,C},F = {AB→C,C→B},则关系R( )。
A、有2个候选关键字AC和BC,并且有3个主属性
B、有2个候选关键字AC和AB,并且有3个主属性
C、只有一个候选关键字AC,并且有1个非主属性和2个主属性
D、只有一个候选关键字AB,并且有1个非主属性和2个主属性
参考答案与解析(本笔记补充,非官方)
B。 A⁺=A,B⁺=B,C⁺=BC;(AB)⁺=(AC)⁺=ABC,(BC)⁺=BC。候选键为 AB、AC,三个属性都是主属性。此模式达到 3NF,但 C→B 的左部不是超键,因此不属于 BCNF。
例题 14:主键与冗余依赖
给定关系模式R(U,F),其中:U为关系模式R中的属性集,F是U上的一组函数依赖。假设U={A1,A2,A3,A4},F={A1→A2,A1A2→A3,A1→A4,A2→A4},那么关系R的主键应为( )。函数依赖集F中的( )是冗余的。
A、A1 B、A1A2 C、A1A3 D、A1A2A3
A、A1→A2 B、A1A2→A3 C、A1→A4 D、A2→A4
参考答案与解析(本笔记补充,非官方)
A、C。 A1⁺={A1,A2,A3,A4},A1 是唯一候选键,因此可选作主键。删掉 A1→A4 后,仍由 A1→A2→A4 推出它,故该依赖冗余。
另一方面,A1A2→A3 的左部 A2 是多余属性,因为 A1 已能先推出 A2;可化简成 A1→A3。左部属性冗余与整条依赖冗余不是同一问题。 一组最小覆盖为 {A1→A2,A1→A3,A2→A4}。
例题 15:伪传递律
给定关系模式R(U,F),其中U为属性集,F是U上的一组函数依赖,那么Armstrong公理系统的伪传递律是指( )。
A、若X→Y,X→Z,则X→YZ为F所蕴涵
B、若X→Y,WY→Z,则XW→Z为F所蕴涵
C、若X→Y,Y→Z为F所蕴涵,则X→Z为F所蕴涵
D、若Ⅹ→Y为F所蕴涵,且Z⊆U,则XZ→YZ为F所蕴涵
参考答案与解析(本笔记补充,非官方)
B。 X 决定 Y,而 WY 决定 Z,就有 XW 决定 Z。推导:对 X→Y 增广 W 得 XW→YW,再用传递律。A 是合并律,C 是传递律,D 是增广律。
范式
规范化要解决“一张表混存不同事实”造成的异常。例如把客户地址重复写在每张订单中:改地址要同时改多行,是更新异常风险;新客户没有订单时无法独立登记地址,是插入异常;删除某客户最后一张订单时连地址也丢失,是删除异常。应按依赖把客户事实与订单事实分开,再检查分解是否无损、是否保持约束,不能仅以表越多或范式越高判断设计质量。
规范化理论 – 第一范式
第一范式(1NF):在关系模式R中,当且仅当所有域只包含原子值,即每个属性都是不可再分的数据项时,则称关系模式R是第一范式。
例如:关系模式R(系名称,高级职称人数)是否满足1NF,如果不满足,应如何调整?
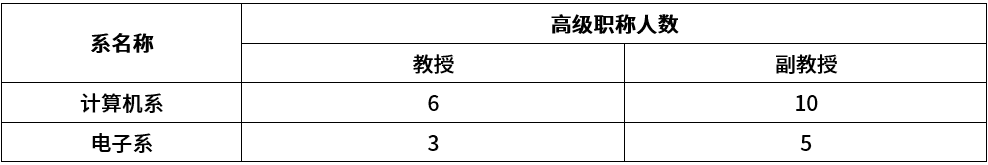
图中“高级职称人数”是由教授人数、副教授人数组成的复合栏头:
| 系名称 | 教授人数 | 副教授人数 |
|---|---|---|
| 计算机系 | 6 | 10 |
| 电子系 | 3 | 5 |
若模式真只有 (系名称,高级职称人数),且第二列存一对数值,则不符合本题所用的 1NF 原子域要求;可改为上表的三个原子列。也可改成 (系名称,职称,人数) 四行,以便增加职称种类。若实际表本来就有“教授人数”“副教授人数”两个独立原子列,仅展示时用了合并表头,则不能仅凭表头判为非 1NF。
规范化理论 – 第二范式
第二范式(2NF):当且仅当实体E是第一范式(1NF),且每一个非主属性完全依赖每一个候选键(不存在对任一候选键的部分依赖;原文“主键”的说法不充分)时,则称实体E是第二范式。
思考题:请思考该关系模式会存在哪些问题(从数据冗余、更新异常、插入异常、删除异常这几个方面来考虑),解决方案是什么?
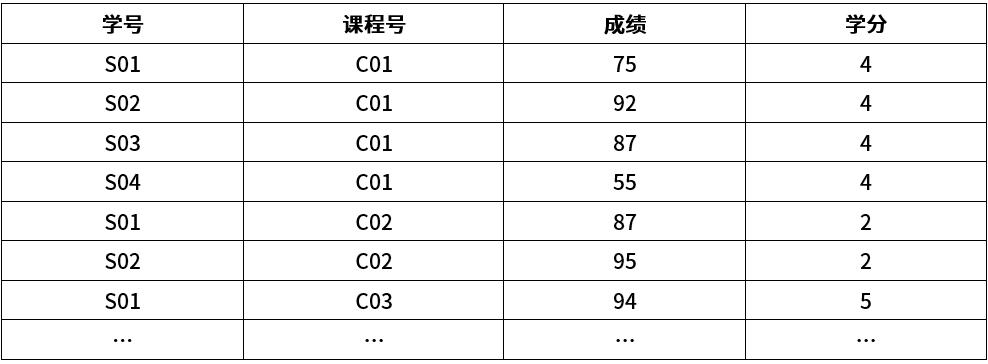
原图数据转写:
| 学号 | 课程号 | 成绩 | 学分 |
|---|---|---|---|
| S01 | C01 | 75 | 4 |
| S02 | C01 | 92 | 4 |
| S03 | C01 | 87 | 4 |
| S04 | C01 | 55 | 4 |
| S01 | C02 | 87 | 2 |
| S02 | C02 | 95 | 2 |
| S01 | C03 | 94 | 5 |
参考答案与解析(本笔记补充,非官方)
候选键为 (学号,课程号),有 (学号,课程号)→成绩、课程号→学分。学分部分依赖候选键,故原表满足 1NF 而不满足 2NF。
- 冗余:C01 的学分 4 保存了四次。
- 更新异常:修改 C01 学分必须同步多行,否则不一致。
- 插入异常:尚无人选的新课程难以独立登记。
- 删除异常:删除最后一名选课学生,可能连课程学分也一起丢失。
拆成 选课(学号,课程号,成绩) 与 课程(课程号,学分)。交集课程号决定课程表,无损;两条原依赖均能分别检查,依赖保持;在给定依赖下两表均达 BCNF。
规范化理论 – 第三范式
第三范式(3NF):当且仅当实体E是第二范式(2NF),且E中没有非主属性传递依赖于候选码时(此处强调非主属性经非超键产生的传递依赖;精确定义见下方对照表),则称实体E是第三范式。
思考题:请思考该关系模式会存在哪些问题(从数据冗余、更新异常、插入异常、删除异常这几个方面来考虑),解决方案是什么?
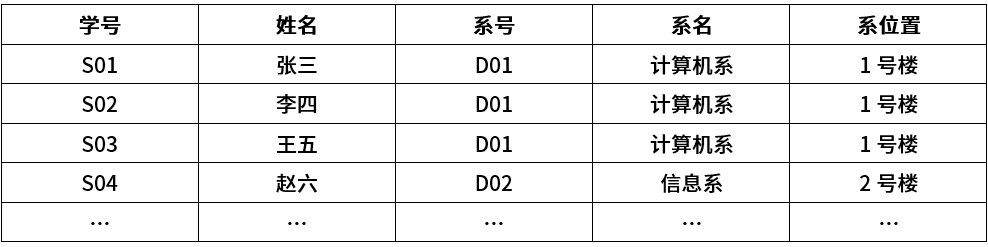
原图数据转写:
| 学号 | 姓名 | 系号 | 系名 | 系位置 |
|---|---|---|---|---|
| S01 | 张三 | D01 | 计算机系 | 1号楼 |
| S02 | 李四 | D01 | 计算机系 | 1号楼 |
| S03 | 王五 | D01 | 计算机系 | 1号楼 |
| S04 | 赵六 | D02 | 信息系 | 2号楼 |
参考答案与解析(本笔记补充,非官方)
业务约束取 学号→姓名,系号、系号→系名,系位置,候选键是学号。单属性键不存在真子集导致的非平凡部分依赖,表满足 2NF;但系名、系位置经非超键“系号”传递依赖学号,不满足 3NF。
同一系名称和位置重复存储;换楼需改多行;新系没有学生难以登记;删除某系最后一个学生会丢失该系资料。拆成 学生(学号,姓名,系号)、系(系号,系名,系位置),公共系号决定系表,分解无损且依赖保持;在给定依赖下均达 BCNF。注意不能仅凭当前样本推断“姓名唯一”或“系位置唯一”。
规范化理论 – BC范式
BC范式(BCNF):设R是一个关系模式,F是它的依赖集,R属于BCNF当且仅当F⁺ 中每个非平凡依赖的决定因素必定包含 R 的某个候选码(即是超键)。
例:关系模式STJ(S,T,J)中,S表示学生,T表示老师,J表示课程。每一个老师只教一门课程。每门课程有若干老师,某一学生选定某门课,就对应一个固定老师。
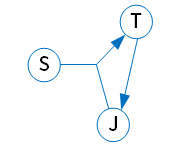
根据题意,函数依赖为 T→J、SJ→T。(ST)⁺=(SJ)⁺=STJ,T⁺=TJ,S⁺=S,J⁺=J,因此候选键是 ST 和 SJ,三个属性全是主属性。
- 属于 3NF:对每条非平凡
X→A,即使 X 不是超键,右部 A 仍是主属性。 - 不属于 BCNF:
T→J中 T 不能决定 S,故 T 不是超键。 - 可分解为
TJ(T,J)、ST(S,T),交集 T 决定 TJ,故无损,两表均达 BCNF。 - 但该 BCNF 分解**不保持
SJ→T**。TJ 的投影依赖只有T→J等推论,ST 无非平凡依赖;合并后(SJ)⁺=SJ,推不出 T。
例如教师 t1、t2 都教 j1,而学生 s1 同时对应 t1、t2:两张子表分别合法,连接后却违反“一位学生选定课程只有一位老师”。这说明无损连接与依赖保持是两项独立检查。
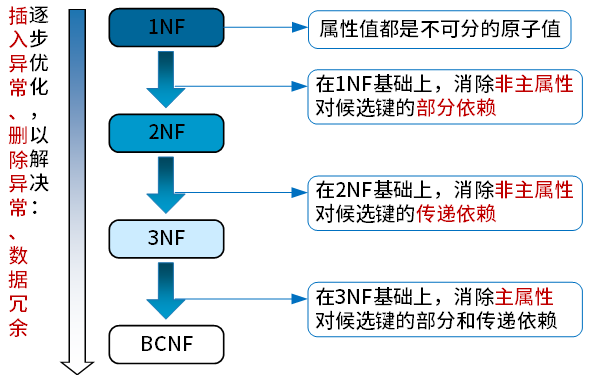
| 范式 | 精确检查条件 | 常见误判 |
|---|---|---|
| 1NF | 在当前模型中各属性域取原子值 | 把合并表头直接判为复合字段 |
| 2NF | 1NF,且每个非主属性完全依赖**每个候选键** | 只检查人为选定的主键 |
| 3NF | 对 F⁺ 中每个非平凡 X→A,X 是超键,或 A 是主属性 |
认为有传递推导就一定不满足 |
| BCNF | 对 F⁺ 中每个非平凡 X→Y,X 必须是超键 |
忽略“非平凡”,或忽略涉及主属性的依赖 |
层级为 BCNF ⇒ 3NF ⇒ 2NF ⇒ 1NF,反向不成立。图中的“消除部分/传递依赖”可作提示,最终判断应使用上表定义。
多值依赖与第四范式
**多值属性**表示一个实体可有多个同类值;若多个集合彼此独立,把它们放在同一关系会形成不必要的交叉组合。例如用户 U 有设备 {d1,d2} 和兴趣 {h1,h2},设备与兴趣互不相关时,R(U,设备,兴趣) 为完整表示两组事实需保存四种组合。这里 U 不能函数决定某一台设备,却能独立决定一组设备,记为多值依赖 U↠设备;相对于剩余的兴趣列,设备集合可独立组合。
在模式 R 中,X↠Y 若 Y⊆X 或 X∪Y=R,属于平凡多值依赖。4NF 要求每个非平凡多值依赖的决定因素都是超键。上例 U 不是原表超键,故违反 4NF;可拆为 用户设备(U,设备)、用户兴趣(U,兴趣),分别用两列组合为键,保留归属而消除独立集合的笛卡尔冗余。若设备与兴趣本来存在配对关系,就不能这样拆;4NF 的判断依赖实际语义,不能仅凭没写多值依赖就保证成立。本章练习已涉及 4NF,需掌握这一基本情况;5NF 不在这些题的所需范围内。
例题 16:元件关系规范化
某公司数据库中的元件关系模式为P(元件号,元件名称,供应商,供应商所在地,库存量),函数依赖集F如下所示:F={元件号→元件名称,(元件号,供应商)→库存量,供应商→供应商所在地},元件关系的主键为( ),该关系存在冗余以及插入异常和删除异常等问题。为了解决这一问题需要将元件关系分解为( ),分解后的关系模式可以达到( )。
A、元件号,元件名称 B、元件号,供应商
C、元件号,供应商所在地 D、供应商,供应商所在地
A、元件1(元件号,元件名称,库存量)、元件2(供应商,供应商所在地)
B、元件1(元件号,元件名称)、元件2(供应商,供应商所在地,库存量)
C、元件1(元件号,元件名称)、元件2(元件号,供应商,库存量)、元件3(供应商,供应商所在地)
D、元件1(元件号,元件名称)、元件2(元件号,库存量)、元件3(供应商,供应商所在地)、元件4(供应商所在地,库存量)
A、1NF B、2NF C、3NF D、BCNF
参考答案与解析(本笔记补充,非官方)
B、C、D。 候选键是 (元件号,供应商),它能推出名称、所在地和库存量;单独任一属性都不能推出全部属性。
原关系只有 1NF:元件名称依赖键的一部分“元件号”,供应商所在地依赖另一部分“供应商”。应拆为:
| 子关系 | 候选键 | 非平凡依赖 |
|---|---|---|
| 元件1(元件号,元件名称) | 元件号 | 元件号→元件名称 |
| 元件2(元件号,供应商,库存量) | 元件号、供应商 | (元件号,供应商)→库存量 |
| 元件3(供应商,供应商所在地) | 供应商 | 供应商→供应商所在地 |
在题目给定的依赖下,各决定因素都是子关系的超键,均达 BCNF;当然也满足 3NF,但选项应选最高范式 D。全部原依赖都可在单表检查,故依赖保持。先按“元件号→元件名称”、再按“供应商→所在地”分解,公共属性各自决定被拆出的表,故无损。A、B、D 的分解不能正确保存每个“元件—供应商”的库存量。
模式分解
规范化理论 - 模式分解
先检查子模式的属性并集是否等于原属性集,漏掉属性不能算完整分解。之后分别检查两件事:**无损连接**关心原来的记录关联能否准确重建;**依赖保持**关心只检查各子表,能否保证原来的依赖约束。无损不会自动带来依赖保持,反之也一样。
对二元分解 R→R1,R2,令 X=R1∩R2,在只考虑函数依赖的模型下,无损的充要条件为 X→R1 或 X→R2 可由原 F 推出。操作上求 X 在 F 下的闭包,看它是否包含一整边。例:R(K,L,M)、F={K→L} 分成 KL、KM,公共 K 决定 KL,所以无损;分成 KL、LM 时,公共 L 不能决定任一边,有损。原来的 (1,x,p)、(2,x,q) 投影到 KL、LM 再连接会多出 (1,x,q)、(2,x,p),这就是伪元组。多元分解可以逐次证明无损,或用追赶法;不能随便挑两张表测试一次就代表全部。
依赖保持的检查方法是:求 F 在各子模式上的**投影依赖**,合并为 G,再对原 F 的每条 X→Y 用 G 求 X⁺,看能否覆盖 Y。投影依赖包含原 F 所能推出、且两端均在子模式内的依赖,不能只拣原 F 里写出来的箭头。例如 {P→Q,Q→R} 投影到 PR 时仍有 P→R,虽然原列表没有直接写这一条。
- 保持函数依赖分解
设数据库模式ρ={R1,R2,…,Rk}是关系模式R的一个分解,F是R上的函数依赖集,ρ中每个模式Ri上的FD集是Fi。如果投影依赖的并集 F1∪F2∪…∪Fk 与 F 是等价的(即相互逻辑蕴涵),那么称分解ρ保持FD。
例:设关系模式R(U,F),其中U={A,B,C,D,E},F={A→BC,C→D,BC→E,E→A},则分解ρ={R1(ABCE),R2(CD)}是否保持函数依赖?而分解ρ={R1(ABE),R2(CD)}是否保持函数依赖?
参考答案与解析(本笔记补充,非官方)
第一种 {ABCE,CD} 保持依赖且无损;第二种 {ABE,CD} 不保持依赖且有损。不能只把原 F 中“表面上完全落在子表内”的依赖挑出来,更不能只“排除传递依赖”;应求 F⁺ 在每个子模式上的投影。
本模式的全部候选键为 A、BC、E;闭包为 A⁺=E⁺=(BC)⁺=ABCDE,C⁺=CD。
| 分解 | 投影依赖的一组等价表示 | 对原依赖逐项检查 |
|---|---|---|
| ABCE、CD | ABCE 上 A→BC, BC→E, E→A;CD 上 C→D |
四条原依赖全可直接或间接推出 |
| ABE、CD | ABE 上 A→BE, E→AB;CD 上 C→D |
合并后 A⁺=ABE、(BC)⁺=BCD、E⁺=ABE;不能推出 A→C、BC→E,原 E→A 与 C→D 仍保留 |
无损分别检查公共属性:第一种交集 C,C→CD,满足二元无损条件;第二种交集为空,空集闭包仍为空,不能决定任一非空子模式,故有损。第二种连接是笛卡尔积:原表如 (a1,b1,c1,d1,e1)、(a2,b2,c2,d2,e2) 满足 F,分解再连接却会变成四种组合。
例:设关系模式R(U,F),其中U={A,B,C},F={A→B,B→C,A→C},则分解ρ={R1(AB),R2(BC)}是否保持函数依赖?
参考答案与解析(本笔记补充,非官方)
保持依赖,也无损。 AB 上投影得 A→B,BC 上得 B→C,合并后 A 的闭包是 ABC,因而仍能推出 A→C。原关系唯一候选键是 A。
无损条件:交集 B 可决定整个 BC。某条依赖未原样出现在子表内,并不等于不保持;关键是投影依赖的并集能否**推导**出来。
纠正:不能把“排除传递依赖”当作判断方法。 应先求投影依赖,再求闭包检验能否推出原 F;可推导出的传递依赖无需在单表中原样出现,但不能无条件忽略。
- 无损分解
什么是有损,什么又是无损?
有损:不能准确还原,常见表现是连接生成额外的伪元组,而不只是“少了数据”。无损:对每一个满足依赖约束的合法关系实例,投影后自然连接都恰好恢复原关系。
无损连接分解:指将一个关系模式分解成若干个关系模式后,通过自然连接等运算仍能还原到原来的关系模式。
思考题:
有关系模式:成绩(学号,姓名,课程号,课程名,分数)
函数依赖:学号→姓名,课程号→课程名,(学号,课程号)→分数
若将其分解为:
成绩(学号,课程号,分数)
学生(学号,姓名)
课程(课程号,课程名)
请思考该分解是否为无损分解?
参考答案与解析(本笔记补充,非官方)
无损,且保持依赖。 设 S=学号、N=姓名、C=课程号、M=课程名、G=分数,F 为 S→N,C→M,SC→G。全部候选键只有 SC。
先把 SN 从原模式拆出,公共 S 决定 SN;剩余 SCMG 再拆成 CM 与 SCG,公共 C 决定 CM。两次均满足二元无损条件,故最终三表无损。三条原依赖也分别在学生、课程、成绩中保留。逐表合法不自动保证任意连接都满足外键等业务约束,仍应在实际数据库中声明参照完整性。
例题 17:遗漏属性的分解题
给定关系模式R(A1,A2,A3,A4)上的函数依赖集F={A1A3→A2,A2→A3}。若将R分解为p ={(A1,A2),(A1,A3)},则该分解是( )的。
A、无损连接且不保持函数依赖 B、无损连接且保持函数依赖
C、有损连接且保持函数依赖 D、有损连接且不保持函数依赖
参考答案与解析(本笔记补充,非官方)
原题不严谨:A4 在所有子模式中都消失,子模式属性的并集不等于 U,因此它不是 R 的合法分解。 不能对其直接套用完整模式分解的结论并称某项严格正确。
如果将题干修正为 R(A1,A2,A3),仍取 F={A1A3→A2,A2→A3},分解为 {A1A2,A1A3},则选 D:有损且不保持依赖。
- 两子模式交集为
{A1},A1⁺={A1},不能决定任何一边,故有损。 - 在 A1A2 和 A1A3 上投影得到的依赖均只有平凡依赖,其并集既不能推出
A2→A3,也不能推出A1A3→A2,故不保持依赖。 - 反例:原关系两行
(a,b1,c1)、(a,b2,c2)满足 F。投影再连接得到 4 行,多出(a,b1,c2)、(a,b2,c1)。
原四属性模式的候选键为 {A1,A2,A4}、{A1,A3,A4};修正后三属性模式的候选键为 {A1,A2}、{A1,A3}。A4 不受任何依赖决定,不能无故删除。
专项题库练习(31 题)
本小节对应题库练习共 31 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 012
来源:知识点练习「数据库系统」第 12 题(原站入口)。
给定关系模式R(U,F),属性集U={A,B,C,D,E,H},函数依赖F={A→B,A→C,C→D,AE→H}。以下哪组属性是候选键( )?
-
A. AC
-
B. AB
-
C. AE
-
D. DE
答案与解析
平台答案:C。
整理解析
选 C。A、E都未出现在任何依赖的右部,无法由其他属性推出,所以每个候选键必须含二者。从AE出发,A推出B、C,再由C推出D,AE还推出H,闭包覆盖全部六个属性;去掉A或E都不能覆盖U,因此AE是唯一候选键。
题目 013
来源:知识点练习「数据库系统」第 13 题(原站入口)。
关系R(H,L,M,P)的主键被说明为全码(All-key)。那么这个主键应由哪些属性组成( )?
-
A. 为HLMP
-
B. 在集合{H,L,M,P)中任选一个
-
C. 在集合{ HL,HM,HP,LM,LP,MP}中任选一个
-
D. 在集合{HLM,HLP,HMP,LMP}中任选一个
答案与解析
平台答案:A。
整理解析
选 A。全码表示全部属性一起构成候选键,因此主键为HLMP。这里不是任意取几个属性都能唯一标识元组;全码作为候选键仍要求最小性。
题目 014
展开题目 014(先作答,再查看解析)
来源:知识点练习「数据库系统」第 14 题(原站入口)。
关系模式R(A1,A2,A3,A4)具有函数依赖F={A1A3→A2,A2→A3}。题给分解ρ={(A1,A2),(A1,A3)},问其连接损失及依赖保持情况( )。
-
A. 无损联接且不保持函数依赖
-
B. 无损联接且保持函数依赖
-
C. 有损联接且保持函数依赖
-
D. 有损联接且不保持函数依赖
答案与解析
平台答案:D。
整理解析
平台选 D。原页已核实原题确含A4,分解却只有(A1,A2)、(A1,A3),属于原题缺项。两个子模式的并集未覆盖A4,严格说不满足分解应覆盖原属性集的前提,不能直接对原四属性模式套二元无损连接判据。即便只考察前三列,两表公共列A1也不能决定A2或A3,连接仍会产生伪元组;如合法的(a,b1,c1)、(a,b2,c2)投影后还会拼出(a,b1,c2)。投影到两个子模式均无非平凡依赖,也不能推出原来的两条依赖。平台D可概括信息丢失及依赖不保持,但原题遗漏A4的缺陷须保留。
题目 020
展开题目 020(先作答,再查看解析)
来源:知识点练习「数据库系统」第 20 题(原站入口)。
数据库逻辑设计中,若实体有多值属性,怎样将E-R图转换成关系模式,才能按题目所述得到4NF的设计( )?
-
A. 将所有多值属性组成一个关系模式
-
B. 使多值属性不在关系模式中出现
-
C. 将实体的码分别和每个多值属性独立构成一个关系模式
-
D. 将多值属性和其它属性一起构成该实体对应的关系模式
答案与解析
平台答案:C。
整理解析
选 C。将实体键与每个多值属性分别建表,可以保留归属关系,同时避免把彼此独立的多值集合交叉组合。例如学号、电话和兴趣不能因各有多个值就任意配对。严格说,4NF要求每个非平凡多值依赖的决定项都是超键;本题结论按各多值属性彼此独立且没有其他违规依赖的通常前提理解,不能宣称任意复杂模式只做这一步就必定满足4NF。
题目 023
展开题目 023(先作答,再查看解析)
来源:知识点练习「数据库系统」第 23 题(原站入口)。
给定R(A1,A2,A3,A4,A5,A6),函数依赖为F={A1→A2,A1A3→A4,A5A6→A1,A2A5→A6,A3A5→A6}。选择R的一个主键(23),并判断它最高达到的范式(24)。
请作答:第 23 题。
-
A. A1A4
-
B. A2A4
-
C. A3A5
-
D. A4A5
答案与解析
平台答案:C。
整理解析
选 C。A3、A5从不出现在依赖右部,任何候选键都必须含它们。由A3A5推出A6,再由A5A6推出A1,继而得到A2,并由A1A3得到A4,闭包覆盖全部属性。两个单属性闭包均只有自身,所以A3A5是唯一候选键。
题目 024
展开题目 024(先作答,再查看解析)
来源:知识点练习「数据库系统」第 24 题(原站入口)。
给定R(A1,A2,A3,A4,A5,A6),函数依赖为F={A1→A2,A1A3→A4,A5A6→A1,A2A5→A6,A3A5→A6}。选择R的一个主键(23),并判断它最高达到的范式(24)。
请作答:第 24 题。
-
A. 1NF
-
B. 2NF
-
C. 3NF
-
D. BCNF
答案与解析
平台答案:B。
整理解析
选 B。唯一候选键是A3A5,A3和A5各自都推不出任何非主属性,没有部分依赖,按属性值原子的常规前提满足2NF。A1→A2中,A1不是超键,A2也不是主属性,因此不满足3NF。纠错:平台以A1→A6举传递依赖,但A1的闭包只有A1、A2,该箭头不能由题给F推出;使用题中明确的A1→A2即可完成正确论证。
题目 027
展开题目 027(先作答,再查看解析)
来源:知识点练习「数据库系统」第 27 题(原站入口)。
给定关系模式R,属性集U={A,B,C},函数依赖F={AB→C,C→B},原公式见下图。以下关于R的候选键和主属性的说法,哪项成立( )?
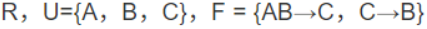
-
A. 有2个候选关键字AC和BC,并且有3个主属性
-
B. 有2个候选关键字AC和AB,并且有3个主属性
-
C. 只有一个候选关键字AC,并且有1个非主属性和2个主属性
-
D. 只有一个候选关键字AB,并且有1个非主属性和2个主属性
答案与解析
平台答案:B。
整理解析
选 B。A不在任何依赖右部,候选键必须含A。AB由题给依赖推出C;AC先由C→B补出B,因此两者闭包都覆盖ABC。A、B、C各自均不能决定所有属性,BC也得不到A,所以候选键恰为AB、AC;三个属性均属于某个候选键,都是主属性。该属性集及函数依赖均与原题公式图一致。
题目 028
展开题目 028(先作答,再查看解析)
来源:知识点练习「数据库系统」第 28 题(原站入口)。
某公司使用元件关系P(元件号,元件名称,供应商,供应商所在地,库存量),已知F={元件号→元件名称,(元件号,供应商)→库存量,供应商→供应商所在地}。选择主键(28)。为消除冗余以及插入、删除异常,应采用分解(29),分解后可达到(30)范式。
请作答:第 28 题。
-
A. 元件号,元件名称
-
B. 元件号,供应商
-
C. 元件号,供应商所在地
-
D. 供应商,供应商所在地
答案与解析
平台答案:B。
整理解析
选 B。元件号和供应商都未在依赖右部出现,必须一起纳入键。二者分别推出名称与所在地,合在一起又推出库存量,因此其闭包覆盖全部属性;删去任意一项均不够。
题目 029
展开题目 029(先作答,再查看解析)
来源:知识点练习「数据库系统」第 29 题(原站入口)。
某公司使用元件关系P(元件号,元件名称,供应商,供应商所在地,库存量),已知F={元件号→元件名称,(元件号,供应商)→库存量,供应商→供应商所在地}。选择主键(28)。为消除冗余以及插入、删除异常,应采用分解(29),分解后可达到(30)范式。
请作答:第 29 题。
-
A. 元件1(元件号,元件名称,库存量)、元件2(供应商,供应商所在地)
-
B. 元件1(元件号,元件名称)、元件2(供应商,供应商所在地,库存量)
-
C. 元件1(元件号,元件名称)、元件2(元件号,供应商,库存量)、元件3(供应商,供应商所在地)
-
D. 元件1(元件号,元件名称)、元件2(元件号,库存量)、元件3(供应商,供应商所在地)、元件4(供应商所在地,库存量)
答案与解析
平台答案:C。
整理解析
选 C。把元件号决定的名称、供应商决定的所在地分别保存,再用(元件号,供应商,库存量)保留供应联系及库存量,三条原依赖可各自在一张表中检查。按元件号、供应商依次连接又可无损重建原关系。其余分解没有正确保留完整的元件—供应商—库存量对应,不能只因每个属性都出现过就认为分解正确。
题目 030
展开题目 030(先作答,再查看解析)
来源:知识点练习「数据库系统」第 30 题(原站入口)。
某公司使用元件关系P(元件号,元件名称,供应商,供应商所在地,库存量),已知F={元件号→元件名称,(元件号,供应商)→库存量,供应商→供应商所在地}。选择主键(28)。为消除冗余以及插入、删除异常,应采用分解(29),分解后可达到(30)范式。
请作答:第 30 题。
-
A. 1NF
-
B. 2NF
-
C. 3NF
-
D. 4NF
答案与解析
平台答案:C。
整理解析
平台选 C,分解后确实满足3NF。进一步按给出的函数依赖检查,各子表的每个非平凡函数依赖的决定项都是其键,因此实际上也满足BCNF,不能说最高只能到3NF。4NF还要检查完整的非平凡多值依赖;题中只列函数依赖,不能把没有相关分析当成已经证明不满足4NF。
题目 032
展开题目 032(先作答,再查看解析)
来源:知识点练习「数据库系统」第 32 题(原站入口)。
关系模式R(U,F)中,U={A1,A2,A3,A4},F={A1→A2,A1A2→A3,A1→A4,A2→A4}。选择R的主键(32),并指出F中的冗余依赖(33)。
请作答:第 32 题。
-
A. A1
-
B. A1A2
-
C. A1A3
-
D. A1A2A3
答案与解析
平台答案:A。
整理解析
选 A。由A1先得到A2、A4,再利用已有的A1与A2得到A3,闭包为全部四个属性。A1本身不由其他属性推出,且单属性已构成键,因此含A1的更大组合只是非最小的超键。
题目 033
展开题目 033(先作答,再查看解析)
来源:知识点练习「数据库系统」第 33 题(原站入口)。
关系模式R(U,F)中,U={A1,A2,A3,A4},F={A1→A2,A1A2→A3,A1→A4,A2→A4}。选择R的主键(32),并指出F中的冗余依赖(33)。
请作答:第 33 题。
-
A. A1→A2
-
B. A1A2→A3
-
C. A1→A4
-
D. A2→A4
答案与解析
平台答案:C。
整理解析
选 C。删除A1→A4后,仍可由A1→A2和A2→A4推出它,所以这条依赖冗余。A1A2→A3虽可把左部约简成A1,却不能直接整条删除,否则无法推出A3;左部多余属性与冗余依赖是不同问题。
题目 039
展开题目 039(先作答,再查看解析)
来源:知识点练习「数据库系统」第 39 题(原站入口)。
设R(U,F),U={A1,A2,A3},F={A1A3→A2,A1A2→A3}。R的每个候选键中必定含哪个属性( )?
-
A. A1
-
B. A2
-
C. A3
-
D. A2A3
答案与解析
平台答案:A。
整理解析
选 A。A1没有出现在任何依赖右部,不含A1的属性组无法将它推出,故所有候选键都必须含A1。再加A2或A3均可覆盖全部属性,候选键恰为A1A2、A1A3。
题目 044
展开题目 044(先作答,再查看解析)
来源:知识点练习「数据库系统」第 44 题(原站入口)。
培训关系R(培训科目,培训师,学生,成绩,时间,教室)满足F={培训科目→培训师,(学生,培训科目)→成绩,(时间,教室)→培训科目,(时间,培训师)→教室,(时间,学生)→教室}。选择主键(44)及该关系最高达到的范式(45)。
请作答:第 44 题。
-
A. (学生,培训科目)
-
B. (时间,教室)
-
C. (时间,培训师)
-
D. (时间,学生)
答案与解析
平台答案:D。
整理解析
选 D。时间、学生不在任何依赖右部,候选键必须含它们。由二者推出教室,再连同时间推出培训科目,由科目推出培训师,最后连同学生推出成绩,闭包包含所有属性;二者单独都不足,故组成唯一候选键。纠错:推导过程中不能丢掉时间或学生,平台写成“教室→培训科目→成绩”的单列箭头链不成立。
题目 045
展开题目 045(先作答,再查看解析)
来源:知识点练习「数据库系统」第 45 题(原站入口)。
培训关系R(培训科目,培训师,学生,成绩,时间,教室)满足F={培训科目→培训师,(学生,培训科目)→成绩,(时间,教室)→培训科目,(时间,培训师)→教室,(时间,学生)→教室}。选择主键(44)及该关系最高达到的范式(45)。
请作答:第 45 题。
-
A. 1NF
-
B. 2NF
-
C. 3NF
-
D. BCNF
答案与解析
平台答案:B。
整理解析
选 B。唯一候选键为(时间,学生),时间和学生各自都不能推出非主属性,因此不存在对该键的部分依赖,在属性原子的前提下满足2NF。培训科目→培训师的决定项不是超键,培训师也不是主属性,直接违反3NF,故最高为2NF。
题目 046
展开题目 046(先作答,再查看解析)
来源:知识点练习「数据库系统」第 46 题(原站入口)。
设R(U,F),U={A,B,C,D,E},F={A→B,DE→B,CB→E,E→A,B→D}。选择R的候选键(46),以及同时无损连接并保持函数依赖的分解(47)。
请作答:第 46 题。
-
A. AB
-
B. DE
-
C. DB
-
D. CE
答案与解析
平台答案:D。
整理解析
选 D。C不在任何依赖右部,所以必须是每个候选键的组成部分,不能误说C自身就是候选键。CE中由E推出A,再推出B、D,故CE覆盖全部属性且最小。完整计算还可得到AC、BC两个候选键;本空选项中只有CE符合。
题目 047
展开题目 047(先作答,再查看解析)
来源:知识点练习「数据库系统」第 47 题(原站入口)。
设R(U,F),U={A,B,C,D,E},F={A→B,DE→B,CB→E,E→A,B→D}。选择R的候选键(46),以及同时无损连接并保持函数依赖的分解(47)。
请作答:第 47 题。
-
A. ρ={R1(AC),R2(ED),R3(B)}
-
B. ρ={R1(AC),R2(E),R3(DB)}
-
C. ρ={R1(AC),R2(ED),R3(AB)}
-
D. ρ={R1(ABC),R2(ED),R3(ACE)}
答案与解析
平台答案:D。
整理解析
平台答案保留 D,但它只满足无损连接,不满足保持依赖。原页已核实,题干确要求两者同时成立,F确含B→D,D确为{ABC,ED,ACE}且没有其他子模式。无损性可分两步证明:把R分成ABCE和ED,交集E可决定ED;再把ABCE分成ABC和ACE,交集AC可决定两边。然而F投影到ABC、ED、ACE后,联合依赖下B的闭包仍只有{B},推不出B→D。平台追赶表出现全a行仅证明无损,不能证明保持依赖。逐项检查四个选项都不同时满足两项要求,这是已核实原题的矛盾。
题目 048
展开题目 048(先作答,再查看解析)
来源:知识点练习「数据库系统」第 48 题(原站入口)。
对关系模式R(U,F)中的函数依赖应用Armstrong推理规则,以下哪项是伪传递律( )?
-
A. 若X→Y,X→Z,则X→YZ为F所蕴涵
-
B. 若X→Y,WY→Z,则XW→Z为F所蕴涵
-
C. 若X→Y,Y→Z为F所蕴涵,则X→Z为F所蕴涵
-
D. 若Ⅹ→Y为F所蕴涵,且Z⊆U,则XZ→YZ为F所蕴涵
答案与解析
平台答案:B。
整理解析
选 B。由X→Y增广W可得XW→YW,再结合WY→Z,用传递律得到XW→Z。A是合并律,C是传递律,D是增广律;伪传递律是由基本公理推出的规则。
题目 056
展开题目 056(先作答,再查看解析)
来源:知识点练习「数据库系统」第 56 题(原站入口)。
关系模式R(A1,A2,A3,A4,A5,A6),函数依赖集F={A1→A3,A1A2→A4,A5A6→A1,A3A5→A6,A2A5→A6}。第(56)空选择R的一个主键,第(57)空选择由F可得出的范式结论。
请作答:第56题。
-
A. A1A4
-
B. A2A5
-
C. A3A4
-
D. A4A5
答案与解析
平台答案:B。
整理解析
依赖右端从未出现A2和A5,两者都必须包含在任何候选键中。由A2A5先推出A6,再由A5A6推出A1,继而推出A3、A4,故其闭包包含全部六个属性,且不能删去任一属性。唯一候选键为A2A5,可选作主键,选B。平台说“唯一入度为0的是A2”遗漏了A5。
题目 057
展开题目 057(先作答,再查看解析)
来源:知识点练习「数据库系统」第 57 题(原站入口)。
关系模式R(A1,A2,A3,A4,A5,A6),函数依赖集F={A1→A3,A1A2→A4,A5A6→A1,A3A5→A6,A2A5→A6}。第(56)空选择R的一个主键,第(57)空选择由F可得出的范式结论。
请作答:第57题。
-
A. 不存在传递依赖,故R为1NF
-
B. 不存在传递依赖,故R为2NF
-
C. 存在传递依赖,故R为3NF
-
D. 每个非主属性完全函数依赖于主键,故R为2NF
答案与解析
平台答案:D。
整理解析
唯一候选键为A2A5;单独A2或A5的闭包都只有自身,非主属性不存在对候选键真子集的依赖,故在属性原子的通常前提下达到2NF,选D。但A1→A3中A1不是超键,A3也不是主属性,所以不满足3NF。2NF允许传递依赖。平台“只有A2入度为0”还漏掉了同样必在候选键内的A5。
题目 061
展开题目 061(先作答,再查看解析)
来源:知识点练习「数据库系统」第 61 题(原站入口)。
关系R的属性集U={A1,A2,A3,A4},函数依赖集F={A1A3→A2,A1A2→A3,A2→A4}。候选键情况为(61),每个候选键都必须包含的属性及主属性分类见(62)。
请作答:第61题。
-
A. 有1个候选关键字A2A3
-
B. 有1个候选关键字A2A4
-
C. 有2个候选关键字A1A2和A1A3
-
D. 有2个候选关键字A1A2和A2A3
答案与解析
平台答案:C。
整理解析
A1未出现在任何依赖右端,所以候选键都必须含它。(A1A2)+和(A1A3)+都包含全部四个属性,且各自删去任一属性后不能覆盖U;只含A1A4则无法推出A2、A3。故恰有A1A2和A1A3两个候选键,选C。
题目 062
展开题目 062(先作答,再查看解析)
来源:知识点练习「数据库系统」第 62 题(原站入口)。
关系R的属性集U={A1,A2,A3,A4},函数依赖集F={A1A3→A2,A1A2→A3,A2→A4}。候选键情况为(61),每个候选键都必须包含的属性及主属性分类见(62)。
请作答:第62题。
-
A. A1,其中A1A2A3为主属性,A4为非主属性
-
B. A2,其中A2A3A4为主属性,A1为非主属性
-
C. A2A3,其中A2A3为主属性,A1A4为非主属性
-
D. A2A4,其中A2A4为主属性,A1A3为非主属性
答案与解析
平台答案:A。
整理解析
两个候选键分别是A1A2、A1A3,交集为必含属性A1;候选键的并集A1、A2、A3为主属性,只有A4是非主属性,选A。“主属性”指属于任一候选键,并不要求出现在每个候选键中。
题目 066
展开题目 066(先作答,再查看解析)
来源:知识点练习「数据库系统」第 66 题(原站入口)。
R的属性为{A,B,C,D},依赖集Fr={A→BC,B→D};S的属性为{A,C,E},依赖集Fs={A→C,C→E}。R、S的主键分别为(66);关于这两个依赖集的正确说法为(67)。
请作答:第66题。
-
A. A、A
-
B. AB、A
-
C. A、AC
-
D. AB、AC
答案与解析
平台答案:A。
整理解析
在R中,A先决定B、C,再通过B决定D,A+={A,B,C,D};在S中,A→C→E,A+={A,C,E}。A都未出现在依赖右端,且单属性键不可再约简,故两个关系都以A为唯一候选键,可作为主键,选A。AB或AC即使覆盖全部属性,也因不最小而不是候选键。
题目 067
展开题目 067(先作答,再查看解析)
来源:知识点练习「数据库系统」第 67 题(原站入口)。
R的属性为{A,B,C,D},依赖集Fr={A→BC,B→D};S的属性为{A,C,E},依赖集Fs={A→C,C→E}。R、S的主键分别为(66);关于这两个依赖集的正确说法为(67)。
请作答:第67题。
-
A. Fr蕴含A→B、A→C,但Fr不存在传递依赖
-
B. Fs蕴含A→E,Fs存在传递依赖,但Fr不存在传递依赖
-
C. Fr、Fs分别蕴含A→D,A→E,故Fr、Fs都存在传递依赖
-
D. Fr蕴含A→D,Fr存在传递依赖,但是Fs不存在传递依赖
答案与解析
平台答案:C。
整理解析
由分解规则A→BC可得A→B,再结合B→D得A→D;S中由A→C与C→E得A→E。这里B、C分别不是相应关系的超键,D、E是非主属性,确实构成对键的传递依赖,选C。
题目 073
展开题目 073(先作答,再查看解析)
来源:知识点练习「数据库系统」第 73 题(原站入口)。
关系R的属性集U={A,B,C,D},函数依赖集F={A→BC,AC→D,B→D}。关于候选键与传递依赖,哪项正确?( )
-
A. 不存在传递依赖,候选关键字A
-
B. 不存在传递依赖,候选关键字AC
-
C. 存在传递依赖A→D,候选关键字A
-
D. 存在传递依赖B→D,候选关键字C
答案与解析
平台答案:C。
整理解析
A→BC,且B→D,所以A+={A,B,C,D};A未出现于右端,故唯一候选键为A。经A→B→D可得到非主属性D对键A的传递依赖,选C。AC虽能决定全部属性,却含有多余属性C,不是候选键;AC→D也可从其余依赖推出。
题目 079
展开题目 079(先作答,再查看解析)
来源:知识点练习「数据库系统」第 79 题(原站入口)。
关系R(U,F),U={A,B,C,D,E,H},F={A→B,B→DH,A→H,C→E}。候选码情况为(79);传递依赖与冗余依赖情况为(80)。
请作答:第79题。
-
A. 1个候选码A
-
B. 2个候选码A、B
-
C. 1个候选码AC
-
D. 2个候选码A、C
答案与解析
平台答案:C。
整理解析
A、C都没有出现在依赖右端,所有候选码必须包含AC。A可推出B、D、H,C可推出E,因此(AC)+=U;去掉A或C都不能覆盖U,故只有一个候选码AC,选C。A和C各自都不是候选码。
题目 080
展开题目 080(先作答,再查看解析)
来源:知识点练习「数据库系统」第 80 题(原站入口)。
关系R(U,F),U={A,B,C,D,E,H},F={A→B,B→DH,A→H,C→E}。候选码情况为(79);传递依赖与冗余依赖情况为(80)。
请作答:第80题。
-
A. 不存在传递依赖,但存在冗余函数依赖
-
B. 既不存在传递依赖,也不存在冗余函数依赖
-
C. 存在传递依赖A→D和A→H,但不存在冗余函数依赖
-
D. 存在传递依赖A→D和A→H,并且还存在冗余函数依赖
答案与解析
平台答案:D。
整理解析
由A→B和B→DH可推出A→D、A→H,且B不能反推A,存在题目所指的传递依赖。即使从F删除显式的A→H,该依赖仍可沿A→B→H推出,所以A→H是冗余依赖,选D。A本身不是整个关系的候选码,这里讨论的是属性间传递依赖;不能把A误当作第79题的键。
题目 085
展开题目 085(先作答,再查看解析)
来源:知识点练习「数据库系统」第 85 题(原站入口)。
关系R(U,F),U={A1,A2,A3,A4},F={A1→A2,A1→A3,A2→A4}。第(85)空选择候选码,第(86)空选择错误结论。
请作答:第85题。
-
A. A1
-
B. A2
-
C. A1A2
-
D. A1A3
答案与解析
平台答案:A。
整理解析
A1先推出A2、A3,再经A2推出A4,其闭包覆盖U;它也未出现在任何依赖右端,故唯一候选码为A1,选A。A1A2、A1A3不是最小超键。
题目 086
展开题目 086(先作答,再查看解析)
来源:知识点练习「数据库系统」第 86 题(原站入口)。
关系R(U,F),U={A1,A2,A3,A4},F={A1→A2,A1→A3,A2→A4}。第(85)空选择候选码,第(86)空选择错误结论。
请作答:第86题。
-
A. A1→A2A3为F所蕴涵
-
B. A1→A4为F所蕴涵
-
C. A1A2→A4为F所蕴涵
-
D. A2→A3为F所蕴涵
答案与解析
平台答案:D。
整理解析
A2的闭包只有{A2,A4},推不出A3,所以D错误。A可由合并规则得到,B由传递律得到;C由A2→A4在左侧增加A1即可得到,不必先证明A1也决定A4。
题目 094
展开题目 094(先作答,再查看解析)
来源:知识点练习「数据库系统」第 94 题(原站入口)。
高校人力资源数据库的教师关系为T(教师号、姓名、部门号、岗位、联系地址、薪资),F={教师号→(姓名、部门号、岗位、联系地址),岗位→薪资}。第(94)空选择主键及异常情况,第(95)空选择依赖和最高范式结论。
请作答:第94题。
-
A. 教师号,T存在冗余以及插入异常和删除异常的问题
-
B. 教师号,T不存在冗余以及插入异常和删除异常的问题
-
C. (教师号,岗位),T存在冗余以及插入异常和删除异常的问题
-
D. (教师号,岗位),T不存在冗余以及插入异常和删除异常的问题
答案与解析
平台答案:A。
整理解析
教师号直接确定姓名、部门号、岗位、联系地址,再经岗位确定薪资,因此单独教师号就是候选键,可作为主键。多个教师共享岗位时会重复存储该岗位薪资;没有教师便不便单独登记岗位薪资,删除该岗位最后一位教师也可能丢失薪资信息。存在这些冗余与异常风险,选A。
题目 095
展开题目 095(先作答,再查看解析)
来源:知识点练习「数据库系统」第 95 题(原站入口)。
高校人力资源数据库的教师关系为T(教师号、姓名、部门号、岗位、联系地址、薪资),F={教师号→(姓名、部门号、岗位、联系地址),岗位→薪资}。第(94)空选择主键及异常情况,第(95)空选择依赖和最高范式结论。
请作答:第95题。
-
A. 存在传递依赖,故关系模式T最高达到1NF
-
B. 存在传递依赖,故关系模式T最高达到2NF
-
C. 不存在传递依赖,故关系模式T最高达到3NF
-
D. 不存在传递依赖,故关系模式T最高达到4NF
答案与解析
平台答案:B。
整理解析
教师号是唯一单属性候选键,在属性原子的通常前提下不存在部分依赖,达到2NF。教师号→岗位→薪资是非主属性对键的传递依赖;岗位不是超键,薪资也不是主属性,违反3NF,因此最高为2NF,选B。可将岗位与薪资分离到独立关系以消除此项冗余。
SQL语言
普通查询
SQL语言
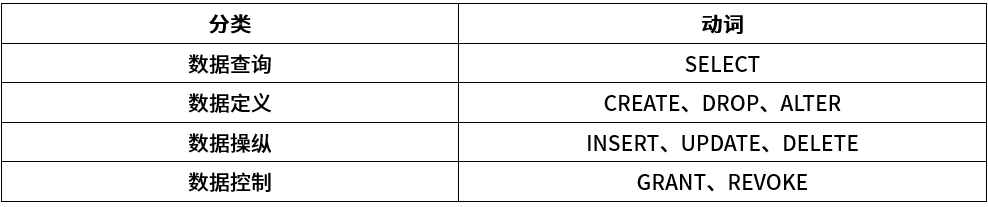
| 用途 | 关键字 |
|---|---|
| 查询 | SELECT |
| 数据定义 | CREATE、ALTER、DROP |
| 数据操纵 | INSERT、UPDATE、DELETE |
| 权限控制 | GRANT、REVOKE |
| 事务控制(补充) | COMMIT、ROLLBACK、SAVEPOINT |
分类名称在不同教材中略有差异;查询有时也归入广义 DML。
SQL语言 - 查询
SELECT [ALL|DISTINCT] <目标表达式> [, <目标表达式>]…
FROM <表名> [,<表名>]…
[ORDER BY <列名2> [ASC|DESC ] … ];
子查询与除法的 SQL 写法。 IN 判断值是否属于子查询结果,EXISTS 判断子查询是否至少返回一行;子查询引用外层行的列时称为**相关子查询**。沿用前面的 Completion、Required,假设人员和课程标识均非 NULL,查询至少完成一门必修课的人:
此处内层条件引用外层的 c.course;SELECT 1 只表达“找到一行”,并不统计行数。结果是甲、乙、丙。若要完成**全部**必修课,则把条件改写为“不存在一门必修课,是这个人没有完成的”:
最内层查询寻找“此人完成了此课”的记录;内层 NOT EXISTS 找出缺课,外层 NOT EXISTS 排除有缺课的人,结果为甲、丙。DISTINCT 去掉同一人的重复输出。Required 为空时,两段 SQL 分别返回空集、Completion 中的全部人员,符合“至少一个”与“所有”的不同含义。若业务候选人应来自完整人员表,就应将外层改为从人员表取人;空要求下,连没有完成记录的人也会满足全部要求。
注意 NOT IN 的 NULL 陷阱。 例如 'B' NOT IN ('A',NULL) 的结果是 UNKNOWN,WHERE 会将该行排除,不能据此判断 B 已在集合中。NOT EXISTS 只检查子查询有没有满足条件的行,但比较条件遇到 NULL 仍受三值逻辑约束;二者不能不加条件地互换,应先明确标识是否允许 NULL,以及空值在业务中代表什么。
分组查询
SQL语言 – 分组查询
[GROUP BY <列名1> [HAVING <条件表达式> ] ]
| 功能 | SQL 与边界 |
|---|---|
| 排序 | ORDER BY 列 ASC/DESC,默认 ASC;无 ORDER BY 不保证顺序 |
| 行数 | COUNT(*) 包含有 NULL 的行 |
| 非空值个数 | COUNT(列) 忽略该列 NULL |
| 不同值个数 | COUNT(DISTINCT 列) 去重并忽略 NULL |
| 总和/平均 | SUM(列)、AVG(列) 通常忽略 NULL |
| 最大/最小 | MAX(列)、MIN(列) 通常忽略 NULL |
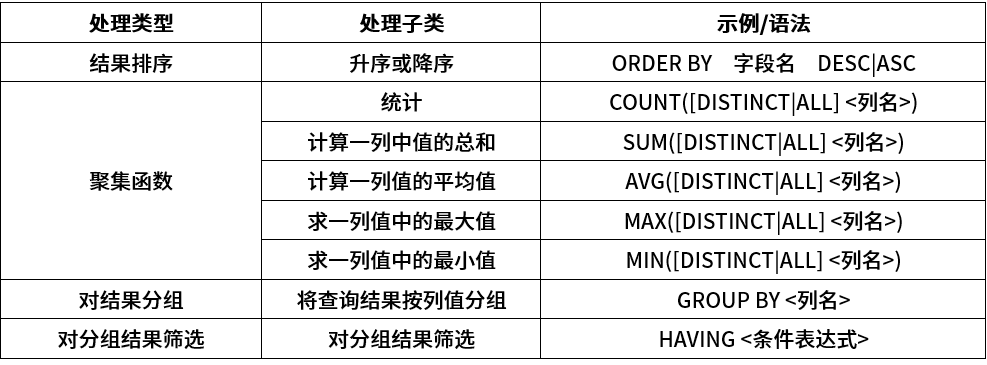
| 分组/组筛选 | GROUP BY/HAVING |
逻辑理解顺序:FROM/JOIN → WHERE → GROUP BY → HAVING → SELECT → DISTINCT → ORDER BY;优化器实际执行可不同。WHERE 保留条件为 TRUE 的行,NULL = NULL 不是 TRUE,应使用 IS NULL。
完整语法骨架(方括号表示可选,不是要输入的字符):
课件把分组语句单独列出,实际 GROUP BY、HAVING 应放在 ORDER BY 前;SELECT 中未聚合的列通常必须符合分组规则,不要依赖某些 DBMS 对非标准查询的宽松处理。
例如阅读记录 ReadLog(user_id,book_id,minutes) 中,同一用户可能多次阅读同一本书。下面先排除零分钟记录,再按用户分组,只保留读过至少两本不同书的用户:
AS 后面是结果别名;GROUP BY 改变统计单位,ORDER BY 只改变结果排列。某用户的书号为 A、A、B 时,COUNT(*)=3、COUNT(DISTINCT book_id)=2;若阅读分钟数为 10、10、20,SUM(minutes)=40,不能为了去重书号而顺带把累计时长改成 SUM(DISTINCT minutes)=30。WHERE 检查明细行,HAVING 才能在本层查询中检查 COUNT 等组统计。
存储函数:返回类型、局部变量与结果
存储函数按参数计算并返回一个值,函数头的 RETURNS 声明返回类型,函数体的 DECLARE 声明局部变量,SELECT ... INTO 将结果赋给变量,RETURN 返回值。它们分别对应 Kotlin 的返回类型、局部变量、赋值和 return,不能混填。下例为 SQL/PSM 风格示意,具体分隔符、函数定义语法与权限依 DBMS 调整:
参数加 p_、局部变量加 v_ 并为列加表别名,可避免参数和列同名导致比较含义不明。函数通常以返回值参与表达式;存储过程通常作为一组操作被调用,其参数和结果机制依 DBMS。Android 常用 SQLite 支持查询和应用注册函数,但不支持上述 CREATE FUNCTION ... BEGIN ... END 式存储程序,不能直接把教材片段放进 Room 的 SQL 执行。
例题 18:关系代数转 SQL
给定关系R(A,B,C,D,E)与S(B,C,F,G),那么与表达式π 2,4,6,7 (σ 2< 7 (R⋈S))等价的SQL语句如下:
SELECT( )FROMR, SWHERE( );
A、R.B,D,F,G B、R.B,E,S.C,F,G
C、R.B,R.D,S.C,F D、R.B,R.C,S.C,F
A、R.B=S.B OR R.C = S.C OR R.B <S.G B、R.B=S.B OR R.C = S.C OR R.B <S.C
C、R.B=S.B AND R.C = S.C AND R.B <S.G D、R.B=S.B AND R.C = S.C AND R.B <S.C
参考答案与解析(本笔记补充,非官方)
A、C。 R⋈S 合并同名列 B、C 后,列顺序为 (A,B,C,D,E,F,G);投影 2、4、6、7 即 B、D、F、G,附加条件为 B<G。
自然连接要对**所有同名列取 AND**,不能取 OR。经典关系代数投影会去重;题干骨架没写 DISTINCT,上述补全式才在没有额外唯一性保证时严格对应集合语义。
例题 19:至少三个不同项目
供应商关系Supp、项目关系Proj和零件关系Part的关系模式如下:
Supp(供应商号,供应商名,地址,电话) Proj(项目号,项目名,负责人,电话)
Part(零件号,零件名)
给定关系模式SP_P(供应商号,项目号,零件号,数量)查询至少供应了3个项目(包含3项)的供应商,输出其供应商号和供应零件数量的总和,并按供应商号降序排列。
SELECT 供应商号,SUM(数量) FROM( )
GROUP BY 供应商号
( )
ORDER BY 供应商号DESC;
A、Supp B、Proj C、Part D、SP_P
A、HAVING COUNT(项目号)>2 B、WHERE COUNT(项目号)>2
C、HAVING COUNT(DISTINCT(项目号))>2 D、WHERE COUNT(DISTINCT(项目号))>3
参考答案与解析(本笔记补充,非官方)
D、C。 必须按供货明细 SP_P 分组,在每个供应商内数“不同项目”,不能数明细行。一个供应商给同一项目供三个零件,仍然只供应一个项目。
>=3 与选项的 >2 等价。HAVING 筛选组,WHERE 在分组前筛选行,不能在本查询层的 WHERE 中直接使用 COUNT。SUM 累计的是该供应商全部供货行的数量,不要改成 SUM(DISTINCT 数量)。
权限控制
授权与撤权语句
授权语句 GRANT <权限>[, · · · n]
ON <对象类型><对象名>
TO <用户>[, · · · n]
WITH GRANT OPTION
WITH GRANT OPTION 子句,获得权限的用户还可以将权限赋给其他用户
收回权限语句 REVOKE <权限>[, · · · n]
ON <对象类型><对象名>
FROM <用户>[, · · · n]
GRANT 指定对象、操作与接收者,列级 UPDATE(列名) 只授予相应列的更新权限;可选的 WITH GRANT OPTION 允许受权者转授同一权限。撤权时,RESTRICT 通常在存在相关依赖授权时拒绝撤销,CASCADE 则按依赖关系级联处理;若用户另有独立授权路径,权限是否仍有效还要综合判断。它们与视图检查选项、普通行级筛选分别解决不同问题。
例题 20:可转授权
要将部门表Dept中name列的修改权限赋予用户Ming,并允许Ming将该权限授予他人。实现该要求的SQL语句如下:
GRANT UPDATE(name) ON TABLE Dept TO Ming( );
A、FOR ALL B、CASCADE
C、WITH GRANT OPTION D、WITH CHECK OPTION
参考答案与解析(本笔记补充,非官方)
C。 完整语句为:
WITH GRANT OPTION 允许受权者继续转授相应权限;WITH CHECK OPTION 用于可更新视图的检查约束,CASCADE 常见于级联撤权/删除,FOR ALL 不符合该授权语法。具体授权语法取决于 DBMS,此处按课件的标准 SQL 风格表述。
专项题库练习(17 题)
本小节对应题库练习共 17 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 004
来源:知识点练习「数据库系统」第 4 题(原站入口)。
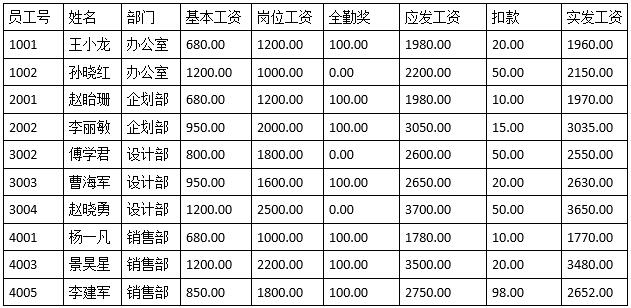
某企业2014年5月的员工工资见下表。需要查询员工人数大于2的部门,以及各符合条件部门的应发工资平均值。补全下列SQL的(4)、(5)、(6):
请作答:第 4 题。
-
A. 部门,AVG(应发工资)AS平均工资
-
B. 姓名,AVG(应发工资)AS平均工资
-
C. 部门,平均工资AS AVG(应发工资)
-
D. 姓名,平均工资AS AVG (应发工资)
答案与解析
平台答案:A。
整理解析
选 A。输出按部门汇总,选择列应为部门和 AVG(应发工资),AS 后面写结果列别名“平均工资”。姓名不是所需分组键,不能用它代替部门;C、D又把表达式与别名位置倒置。原选项中的中文括号等排版照录,真正执行SQL时应采用合法的SQL标点和标识符写法。
题目 005
来源:知识点练习「数据库系统」第 5 题(原站入口)。
某企业2014年5月的员工工资见下表。需要查询员工人数大于2的部门,以及各符合条件部门的应发工资平均值。补全下列SQL的(4)、(5)、(6):
请作答:第 5 题。
-
A. ORDER BY 姓名
-
B. ORDER BY部门
-
C. GROUP BY 姓名
-
D. GROUP BY 部门
答案与解析
平台答案:D。
整理解析
选 D。先用 GROUP BY 部门把同部门员工放在一组,再为每组统计人数及平均工资。ORDER BY 只改变结果排列,不产生汇总分组;按姓名分组也不对应本题按部门统计的目标。
题目 006
展开题目 006(先作答,再查看解析)
来源:知识点练习「数据库系统」第 6 题(原站入口)。
某企业2014年5月的员工工资见下表。需要查询员工人数大于2的部门,以及各符合条件部门的应发工资平均值。补全下列SQL的(4)、(5)、(6):
请作答:第 6 题。
-
A. WHERE COUNT(姓名)>2
-
B. WHERE COUNT(DISTINCT(部门) )>2
-
C. HAVING COUNT(姓名) >2
-
D. HAVING COUNT(DISTINCT(部门))>2
答案与解析
平台答案:C。
整理解析
选 C。人数是分组聚合结果,要用 HAVING COUNT(姓名)>2 筛选;WHERE 用于分组前筛选明细行。纠错:平台把 HAVING 说成分组前限制,先后关系倒置。原表姓名均非空,因此该COUNT等于人数;若允许空姓名,统计行数宜用COUNT(*)。每个部门组中COUNT(DISTINCT 部门)为1,不能筛出人数大于2的组。按原表,设计部与销售部各3人,应发工资均值分别为8950/3≈2983.33、8030/3≈2676.67。
题目 009
展开题目 009(先作答,再查看解析)
来源:知识点练习「数据库系统」第 9 题(原站入口)。
给定关系模式R(A,B,C,D)与S(C,D,E)。与关系代数式 π_{1,3,5}(σ_{2='软件工程'}(R⋈S)) 等价的SQL为:
另需从关系代数表达式中选出效率最高者(11),查询条件为B='信息'且E='北京',输出A、B、E。
请作答:第 9 题。
-
A. A,C,S.C
-
B. A,B,E
-
C. A,R.C,E
-
D. A,R.C,S.D
答案与解析
平台答案:C。
整理解析
选 C,即A、R.C、E。原页已核实原式为自然连接R⋈S。共同属性C、D合并后列序为A、B、C、D、E,所以投影第1、3、5列得到A、C、E;SQL中用R.C消除同名列歧义,并须同时约束R.C=S.C、R.D=S.D及B='软件工程'。经典关系代数投影会去重,严格对应SQL时还需DISTINCT或结果唯一性前提。
题目 010
展开题目 010(先作答,再查看解析)
来源:知识点练习「数据库系统」第 10 题(原站入口)。
给定关系模式R(A,B,C,D)与S(C,D,E)。与关系代数式 π_{1,3,5}(σ_{2='软件工程'}(R⋈S)) 等价的SQL为:
另需从关系代数表达式中选出效率最高者(11),查询条件为B='信息'且E='北京',输出A、B、E。
请作答:第 10 题。
-
A. B=软件工程 OR R.C=S.C AND R.D=S.D
-
B. B=’软件工程‘OR R.C=S.C AND R.D=S.D
-
C. B=’软件工程‘OR R.C=S.C OR R.D=S.D
-
D. B=’软件工程‘AND R.C=S.C AND R.D=S.D
答案与解析
平台答案:D。
整理解析
选 D。原页已核实原式使用自然连接,因此R和S的同名列C、D必须分别相等,同时还要满足B='软件工程',三个条件用AND连接。用OR会放入仅满足部分条件的行。选项中的弯引号保留原样,实际SQL字符串通常使用成对的半角单引号。
题目 011
展开题目 011(先作答,再查看解析)
来源:知识点练习「数据库系统」第 11 题(原站入口)。
给定关系模式R(A,B,C,D)与S(C,D,E)。与关系代数式 π_{1,3,5}(σ_{2='软件工程'}(R⋈S)) 等价的SQL为:
另需从关系代数表达式中选出效率最高者(11),查询条件为B='信息'且E='北京',输出A、B、E。
请作答:第 11 题。
-
A. π1,2,7(σ2=’信息‘∧3=5∧4=6∧7=’北京‘(R×S))
-
B. π1,2,7(σ3=5∧4=6(σ2=’信息‘(R)×σ3=’北京‘(S)))
-
C. π1,2,7(σ3=5∧4=6∧2=’信息‘(R×σ7=’北京‘(S)))
-
D. π1,2,7(σ3=5∧4=6∧7=’北京‘(σ2=’信息‘(R)×S))
答案与解析
平台答案:B。
整理解析
按选择下推、缩小中间结果的逻辑优化口径选 B。先在R上按第2列B筛选,在S上按第3列E筛选;笛卡儿积后列序为A、B、R.C、R.D、S.C、S.D、E,所以用3=5且4=6连接,再投影1、2、7列。原页已核实,C确写σ第7列='北京'并直接作用于只有3列的S,这是原题错误,保留7,不能改成3后让错误消失。B避免先扩大结果再筛选,但实际物理性能还取决于索引、数据分布和优化器,不能保证所有系统都严格更快。
题目 031
展开题目 031(先作答,再查看解析)
来源:知识点练习「数据库系统」第 31 题(原站入口)。
DBA利用DBMS的授权功能,为不同用户配置访问权限,其主要目的是什么( )?
-
A. 正确性
-
B. 安全性
-
C. 一致性
-
D. 完整性
答案与解析
平台答案:B。
整理解析
选 B。授权控制谁能访问哪些对象、执行哪些操作,直接服务于数据库安全性。完整性约束则主要限制数据应满足的合法性规则。
题目 040
展开题目 040(先作答,再查看解析)
来源:知识点练习「数据库系统」第 40 题(原站入口)。
企业工程项目数据库有Supp(供应商号,供应商名,地址,电话)、Proj(项目号,项目名,负责人,电话)、Part(零件号,零件名),E-R图见下图。每个供应商可给多个项目供应多种零件,每个项目也可由多个供应商供应多种零件。联系SP_P须独立建表,其联系类型为(40)。
给定SP_P(供应商号,项目号,零件号,数量),查询至少供应3个项目(包括恰好3个)的供应商,输出供应商号和供应数量总和,并按供应商号降序排列:
请作答:第 40 题。
-
A. *:*:*
-
B. 1:*:*
-
C. 1:1:*
-
D. 1:1:1
答案与解析
平台答案:A。
整理解析
平台选 A,按题目通常意图将供应商、项目、零件建成多对多对多的三元供应联系。已查看原图,它只画了三个实体、SP_P联系和数量属性,没有标注基数。严格的三元基数需考察固定另外两方时第三方有几个实例;只说每一方都可涉及多个实体,并不能排除某一实体对唯一决定第三方。故A按未另加这种唯一性约束的常见场景理解,不把图上不存在的*标记补画进去。
题目 041
展开题目 041(先作答,再查看解析)
来源:知识点练习「数据库系统」第 41 题(原站入口)。
企业工程项目数据库有Supp(供应商号,供应商名,地址,电话)、Proj(项目号,项目名,负责人,电话)、Part(零件号,零件名),E-R图见下图。每个供应商可给多个项目供应多种零件,每个项目也可由多个供应商供应多种零件。联系SP_P须独立建表,其联系类型为(40)。
给定SP_P(供应商号,项目号,零件号,数量),查询至少供应3个项目(包括恰好3个)的供应商,输出供应商号和供应数量总和,并按供应商号降序排列:
请作答:第 41 题。
-
A. Supp
-
B. Proj
-
C. Part
-
D. SP_P
答案与解析
平台答案:D。
整理解析
选 D。SP_P同时含供应商号、项目号及实际供应数量,才能按供应商汇总数量并统计其项目数。实体表Supp、Proj、Part各自只描述实体本身,无法单独完成这项供应记录统计。
题目 042
展开题目 042(先作答,再查看解析)
来源:知识点练习「数据库系统」第 42 题(原站入口)。
企业工程项目数据库有Supp(供应商号,供应商名,地址,电话)、Proj(项目号,项目名,负责人,电话)、Part(零件号,零件名),E-R图见下图。每个供应商可给多个项目供应多种零件,每个项目也可由多个供应商供应多种零件。联系SP_P须独立建表,其联系类型为(40)。
给定SP_P(供应商号,项目号,零件号,数量),查询至少供应3个项目(包括恰好3个)的供应商,输出供应商号和供应数量总和,并按供应商号降序排列:
请作答:第 42 题。
-
A. HAVING COUNT(项目号)>2
-
B. WHERE COUNT(项目号)>2
-
C. HAVING COUNT(DISTINCT(项目号))>2
-
D. WHERE COUNT(DISTINCT(项目号))>3
答案与解析
平台答案:C。
整理解析
选 C。同一供应商可能向同一项目提供多种零件,必须COUNT(DISTINCT 项目号)才能得到项目数,而不是供应明细行数。分组后的数量条件放在HAVING中;至少3个等价于>2,不能误写成>3。SUM(数量)仍累计该供应商所有供应记录的数量。
题目 049
展开题目 049(先作答,再查看解析)
来源:知识点练习「数据库系统」第 49 题(原站入口)。
给定R(A,B,C,D,E)和S(B,C,F,G)。将关系代数表达式 π_{2,4,6,7}(σ_{2<7}(R⋈S)) 转成下列SQL,分别选择投影列(49)和条件(50):
请作答:第 49 题。
-
A. R.B,D,F,G
-
B. R.B,E,S.C,F,G
-
C. R.B,R.D,S.C,F
-
D. R.B,R.C,S.C,F
答案与解析
平台答案:A。
整理解析
选 A。自然连接合并同名B、C后,列序为A、B、C、D、E、F、G;第2、4、6、7列就是B、D、F、G。SQL同时列出R和S时,B需写成R.B或S.B以消除歧义。限定:经典关系代数按集合投影去重,SQL默认保留重复;若要求完全一致且不能保证结果唯一,应使用SELECT DISTINCT。本题选项只考列及条件,未给DISTINCT。
题目 050
展开题目 050(先作答,再查看解析)
来源:知识点练习「数据库系统」第 50 题(原站入口)。
给定R(A,B,C,D,E)和S(B,C,F,G)。将关系代数表达式 π_{2,4,6,7}(σ_{2<7}(R⋈S)) 转成下列SQL,分别选择投影列(49)和条件(50):
请作答:第 50 题。
-
A. R.B=S.B OR R.C = S.C OR R.B < S.G
-
B. R.B=S.B OR R.C = S.C OR R.B < S.C
-
C. R.B=S.B AND R.C = S.C AND R.B < S.G
-
D. R.B=S.B AND R.C = S.C AND R.B < S.C
答案与解析
平台答案:C。
整理解析
选 C。自然连接要求R.B=S.B且R.C=S.C;连接结果第2列是B,第7列是G,因此额外筛选为R.B<S.G。三个条件必须同时成立,用AND连接,不能用OR,也不能把第7列错认成S.C。若按经典关系代数要求去重,还需考虑第49题说明的DISTINCT。
题目 051
展开题目 051(先作答,再查看解析)
来源:知识点练习「数据库系统」第 51 题(原站入口)。
教师表Teacher(T_no, T_name, Dept_name, Tel)依次存储教师号、姓名、学院名和电话。下面定义函数Dept_count,传入学院名(varchar(20))并返回该学院的教师人数。补全(51)、(52)。
请作答:第51题。
-
A. returns integer
-
B. returns d_count integer
-
C. declare integer
-
D. declare d_count integer
答案与解析
平台答案:A。
整理解析
函数头在参数表之后声明返回类型,应填returns integer,选A;d_count是在函数体内声明的局部变量。原片段是教材式伪SQL,AS是否需要、分号及参数名解析规则依数据库方言而定,不能把平台“AS可缺省”推广到所有数据库。题中Dept_ name按前述字段名Dept_name理解;实际实现宜将参数改用不同名称,避免与列同名。
题目 052
展开题目 052(先作答,再查看解析)
来源:知识点练习「数据库系统」第 52 题(原站入口)。
教师表Teacher(T_no, T_name, Dept_name, Tel)依次存储教师号、姓名、学院名和电话。下面定义函数Dept_count,传入学院名(varchar(20))并返回该学院的教师人数。补全(51)、(52)。
请作答:第52题。
-
A. returns integer
-
B. returns d_count integer
-
C. declare integer
-
D. declare d_count integer
答案与解析
平台答案:D。
整理解析
需要声明接收COUNT(*)结果的变量d_count及其类型,填declare d_count integer,选D;之后SELECT INTO赋值,RETURN返回计数。Q51选A、Q52选D,平台解析中的“A、D”对应两个小问。题面省略了方言相关的完整语法,Dept_ name按已给字段名整理;实际SQL应消除参数与列同名的歧义。
题目 063
展开题目 063(先作答,再查看解析)
来源:知识点练习「数据库系统」第 63 题(原站入口)。
把Dept表name列的UPDATE权限授予Ming,并允许Ming继续把该权限授予其他用户,应补入什么子句?
-
A. FOR ALL
-
B. CASCADE
-
C. WITH GRANT OPTION
-
D. WITH CHECK OPTION
答案与解析
平台答案:C。
整理解析
WITH GRANT OPTION使受权者可以把所获权限继续授予他人,选C。WITH CHECK OPTION用于约束通过视图进行的更新,CASCADE用于某些撤销或删除操作的级联处理,不表示允许转授权。
题目 068
展开题目 068(先作答,再查看解析)
来源:知识点练习「数据库系统」第 68 题(原站入口)。
已知R(A,B,C,D)与S(B,C,E,F),要把π1,5,7(σ2=5(R×S))写成下列SQL,补全(68)、(69)。
请作答:第68题。
-
A. R.A,R.B,S.F
-
B. R.A,S.B,S.E
-
C. R.A,S.E,S.F
-
D. R.A,S.B,S.F
答案与解析
平台答案:B。
整理解析
笛卡尔积按R后S排列为R.A、R.B、R.C、R.D、S.B、S.C、S.E、S.F,第1、5、7列是R.A、S.B、S.E,选B。注意经典关系代数投影会去重,SQL默认保留重复行;若要求严格的集合语义等价,完整查询应写SELECT DISTINCT。题面未给保证投影唯一的条件,平台省略了这一差别。
题目 069
展开题目 069(先作答,再查看解析)
来源:知识点练习「数据库系统」第 69 题(原站入口)。
已知R(A,B,C,D)与S(B,C,E,F),要把π1,5,7(σ2=5(R×S))写成下列SQL,补全(68)、(69)。
请作答:第69题。
-
A. WHERE R.B=S.B
-
B. HAVING R.B=S.B
-
C. WHERE R.B=S.E
-
D. HAVING R.B=S.E
答案与解析
平台答案:A。
整理解析
笛卡尔积第2列是R.B,第5列是S.B,因此筛选条件为WHERE R.B=S.B,选A。这里仅对B做等值连接,不能自行增加C列相等条件。严格对应集合语义的关系代数还需在SELECT后加DISTINCT,以消除投影产生的重复行。
并发控制
事务的特性
原子性(Atomicity):事务是原子的,要么都做,要么都不做。
一致性(Consistency):事务执行的结果必须保证数据库从一个一致性状态变到另一个一致性状态。
隔离性(Isolation):约束并发事务的相互影响和数据可见性。原文把它概括为“成功提交前对其他事务不可见”,适用于禁止脏读的级别,但不能覆盖所有隔离级别;完整对照见本节末尾。
持久性(Durability):一旦事务成功提交,即使数据库崩溃,其对数据库的更新操作也永久有效。
提交与回滚的边界。 在显式事务中,COMMIT 提交当前事务,ROLLBACK 撤销当前事务尚未提交的数据库修改。例如余额原为 80,事务中改为 65,提交前回滚会恢复为 80;若已成功提交为 65,之后另一事务的回滚不能撤销这次提交。要修正已提交的数据,需另作更新等处理。SAVEPOINT 可标记事务内的位置,回滚到保存点只撤销该点之后的修改,事务仍可继续;例如先改为 65、设保存点、再改为 50,回滚到该点会回到 65。以上针对支持事务的数据库操作;已发出的邮件等外部动作不会随数据库回滚自动撤销,DDL 是否隐式提交等细节则依 DBMS 而定。
预写日志、恢复与故障分类
数据页先在内存缓冲区修改,之后才写回数据文件;日志记录恢复需要的修改信息。预写日志 WAL 要求某次修改的日志先持久化,才能把对应的脏数据页写到持久存储;采用同步持久提交时,确认提交前还需把恢复该事务所需的日志和提交信息可靠保存。不是“写进内存日志缓冲区”就足够。
因此,已提交事务的数据页尚未落盘,系统仍可根据日志 REDO(重做);未提交事务的修改如果已写出,则需按恢复机制 UNDO(撤销),或利用相应版本机制使其不生效。检查点记录恢复进度等信息以减少重启扫描范围,不等于每次都把全部数据页立即写完。例如日志已持久记录“余额从 40 改为 55 并提交”,故障时数据页还为 40,恢复可以重做为 55;持久性依靠可靠恢复信息,并不要求每次提交都立即刷完所有数据页。
| 故障 | 影响与典型处理 |
|---|---|
| 事务故障 | 某事务计算错误、违反约束或被选为死锁牺牲者;通常中止并回滚该事务 |
| 系统故障 | 断电、操作系统或 DBMS 崩溃,内存状态丢失,但持久文件通常仍在;利用日志等恢复 |
| 介质故障 | 磁盘损坏等导致持久数据文件丢失或损坏;需备份和可用日志等重建,只有内存缓冲或损坏盘上的日志不够 |
分类看故障范围和原因:若题设某个表达式计算失败,仅中止当前事务,应按事务故障分析;不能看到“程序出错”就自动判为整个系统故障。ACID 中原子性强调未完成时整体撤销,持久性强调已提交后能保留,两者对应不同恢复目标。
例题 21:提交后恢复
事务的( )是指,当某个事务提交(COMMIT)后,对数据库的更新操作可能还停留在服务器磁盘缓冲区而未写入到磁盘时,即使系统发生故障,事务的执行结果仍不会丢失。
A、原子性 B、一致性 C、隔离性 D、持久性
参考答案与解析(本笔记补充,非官方)
D(持久性)。 即使数据页仍在缓冲区,数据库也可通过已持久化的预写日志在故障后重做。提交的持久性承诺依赖数据库配置和可靠存储;不能把“数据页未落盘”等同于“提交一定丢失”。
并发问题
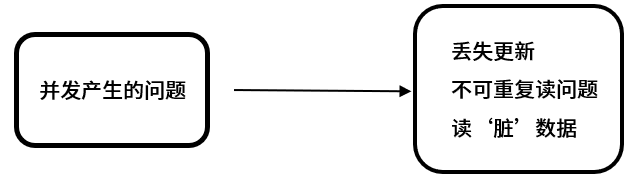
| 现象 | 判定依据,不只数读取次数 |
|---|---|
| 丢失更新 | 后写使用旧读值,覆盖另一事务已产生的更新 |
| 不可重复读 | 同一事务再读同一数据,值因其他事务修改而变化 |
| 脏读 | 读到其他事务尚未提交的数据,即使只读一次也可能发生 |
| 幻读(补充) | 重复条件查询时,符合条件的行集合发生变化 |
不可重复读通常针对已提交的并发修改;未提交修改还涉及脏读。仅看到“读两次/读一次”不能完成判定,必须看写入和提交时序。
更新丢失
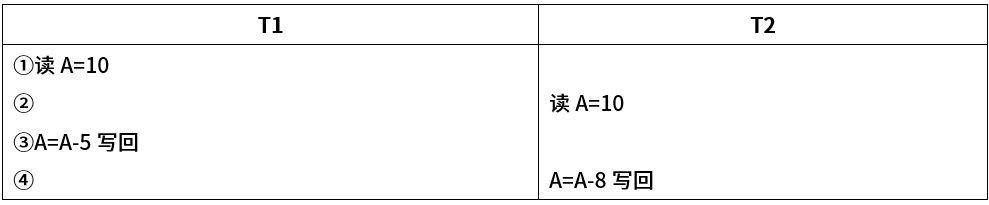
本图中 T1、T2 都读到旧值 10;T1 算出 5 并写回,T2 仍以旧值 10 计算 10−8=2,覆盖 5。最终为 2;若两个减法正确串行执行应为 10−5−8=−3,T1 的减 5 丢失。
不可重复读(读两遍)
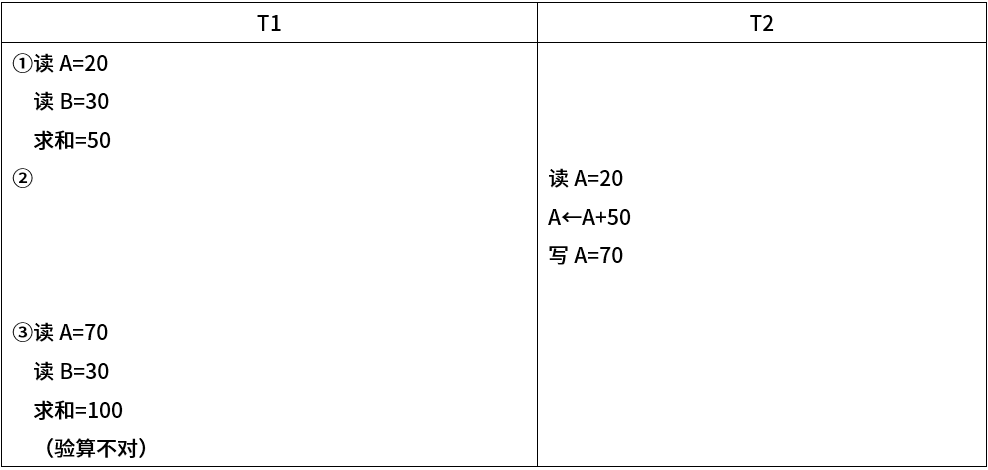
T1 先读取 A=20、B=30,总和 50;T2 把 A 增加 50 并写为 70;T1 再读得到 70+30=100。若 T2 已提交,这是不可重复读;图未标提交点,故“已提交”是此分类的默认假设。
读“脏”数据(读1遍)
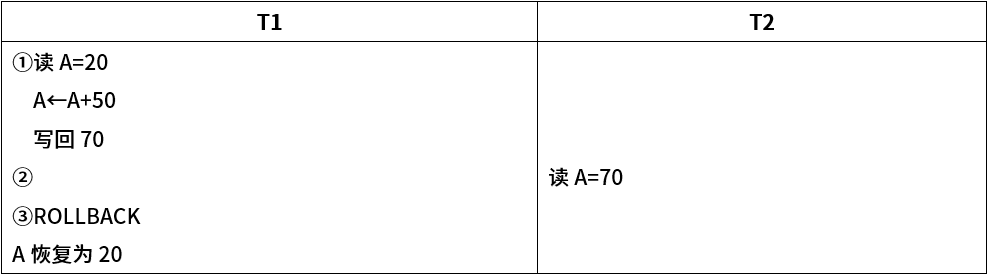
T1 把 A 从 20 改为 70 尚未提交;T2 读到 70;随后 T1 回滚恢复 20。T2 使用了从未提交成功的值,构成脏读。并不要求 T1 事后一定回滚,读取未提交数据时就已是脏读。
封锁协议
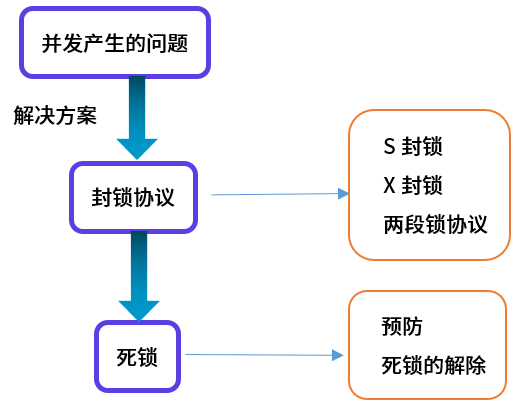
| 已有锁\其他事务申请 | S 锁 | X 锁 |
|---|---|---|
| S 锁 | 兼容 | 不兼容 |
| X 锁 | 不兼容 | 不兼容 |
以上描述针对相同数据对象上、不同事务的锁请求。锁粒度、锁升级、意向锁、MVCC 快照读等还会影响真实系统行为。
X锁(写锁/排他锁/独占锁)的加锁规则:
若事务T对数据对象A加上X锁,其他事务不能再对A添加任意锁。
S锁(共享锁/读锁)的加锁规则:
若事务T对数据对象A加上S锁,其他事务只能对A再加S锁,不能再对A添加X锁。
例题 22:并发时序分析
系统中有三个事务T1、T2、T3分别对数据R1和R2进行操作,其中R1和R2的初值R1=120、R2=50。假设事务T1、T2、T3操作的情况如下图所示,图中T1与T2间并发操作( )问题,T2与T3间并发操作( )问题。
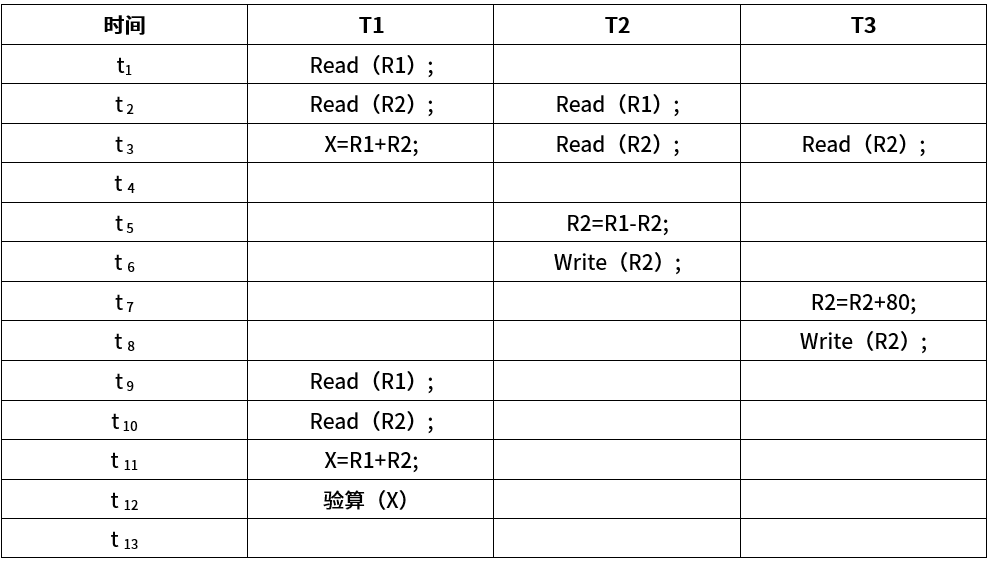
A、不存在任何 B、存在T1不能重复读的
C、存在T1丢失修改的 D、存在T2读“脏”数据的
A、不存在任何 B、存在T2读“脏”数据的
C、存在T2丢失修改的 D、存在T3丢失修改的
参考答案与解析(本笔记补充,非官方)
B、C。 依时间顺序跟踪事务的局部读值与数据库当前值,不能把 T3 的旧读值自动替换成 T2 后来写入的值。
| 时间 | T1 | T2 | T3 | 数据库 R2 |
|---|---|---|---|---|
| t1 | 读 R1=120 | — | — | 50 |
| t2 | 读 R2=50 | 读 R1=120 | — | 50 |
| t3 | X=120+50=170 | 读 R2=50 | 读 R2=50 | 50 |
| t4 | — | — | — | 50 |
| t5 | — | 局部 R2=120−50=70 | — | 50 |
| t6 | — | 写 R2=70 | — | 70 |
| t7 | — | — | 局部 R2=50+80=130 | 70 |
| t8 | — | — | 写 R2=130 | 130 |
| t9 | 再读 R1=120 | — | — | 130 |
| t10 | 再读 R2=130 | — | — | 130 |
| t11 | X=120+130=250 | — | — | 130 |
| t12 | 验算 X,170≠250 | — | — | 130 |
| t13 | — | — | — | 130 |
T2 在两次读取间修改了 R2(T3 又覆盖它),T1 不能重复读;即使只考虑 T1、T2,第二次总和也会从 170 变成 190。T2、T3 都基于旧值 50 计算,T3 最后写入 130,覆盖了 T2 写入的 70,因此 T2 丢失修改。两个串行顺序分别得到 150 和 −10,实际 130 与二者均不等。
图中未给 COMMIT/ROLLBACK,不能据此确定所有读取是否为脏读;T2 读取发生在其他事务写入之前,尤其不能选“T2 读脏数据”。
例题 23:共享锁与排他锁
若事务T1对数据D1加了共享锁,事务T2T3分别对数据D2和数据D3加了排它锁,则事务( )。
A、T1对数据D2D3加排它锁都成功,T2T3对数据D1加共享锁成功
B、T1对数据D2D3加排它锁都失败,T2T3对数据D1加排它锁成功
C、T1对数据D2D3加共享锁都成功,T2T3对数据D1加共享锁成功
D、T1对数据D2D3加共享锁都失败,T2T3对数据D1加共享锁成功
参考答案与解析(本笔记补充,非官方)
D。 D2、D3 已有其他事务持有的 X 锁,T1 再申请 S 或 X 均不能获准;D1 已有 S 锁,其他事务可共享持有 S 锁,但不能获准 X 锁。实际 DBMS 中可能等待或按策略回滚,不一定立即报错;题目“失败”表示当前不兼容。
封锁协议、隔离级别与适用边界(补充)
| 传统封锁协议 | 基本要求 | 在该锁模型下防止的问题 |
|---|---|---|
| 一级 | 修改前取得 X 锁,持有至事务结束 | 丢失更新;读后计算再写回时,锁必须覆盖旧值读取至写回全过程 |
| 二级 | 一级基础上,读前加 S 锁,读完可释放 | 进一步防止脏读 |
| 三级 | 一级基础上,S 锁也持有至事务结束 | 进一步防止不可重复读 |
如果先无锁读旧值,再分别加 X 锁写回,一级口号本身不能阻止“旧值覆盖”。只锁已有记录也不能普遍防止幻读,还需谓词/范围锁等机制。
两阶段封锁(2PL):扩展阶段只取得锁不释放;收缩阶段只释放不再申请。在相应数据项锁模型下,它保证冲突可串行化,但仍可能死锁。严格 2PL 把 X 锁持有至提交或回滚;持有所有 S、X 锁至结束通常称为强严格/严谨 2PL。不要把“两阶段”与“二级封锁”混为一谈。
死锁可通过统一加锁顺序等方式预防,或检测等待图中的环后回滚牺牲事务。超时只是工程处置策略,本身不证明死锁。
| SQL 隔离级别 | 脏读 | 不可重复读 | 幻读 |
|---|---|---|---|
| Read uncommitted | 标准允许 | 允许 | 允许 |
| Read committed | 禁止 | 允许 | 允许 |
| Repeatable read | 禁止 | 禁止 | 标准仍允许,具体实现可能额外阻止 |
| Serializable | 禁止 | 禁止 | 禁止,并要求效果等价于某个串行执行 |
这是常用标准现象对照,不能据此穷尽写偏差、丢失更新等所有异常;特定 DBMS 的 MVCC、快照读、锁定读可能有不同实现。隔离性也不能一律简化为“所有级别下未提交数据绝不可见”,读未提交在标准中允许脏读。
专项题库练习(8 题)
本小节对应题库练习共 8 道题目,题目覆盖本节考点,答案与解析默认折叠。
题目 001
来源:知识点练习「数据库系统」第 1 题(原站入口)。
为保证数据库数据安全、可靠且有效,事务对插入、删除和修改的相关内容先写入(1);系统正常工作时,再按一定时间间隔把数据库缓冲区内容写入(2)。发生故障后,使用现场数据及相关文件恢复系统状态。
请作答:第 1 题。
-
A. 索引文件
-
B. 数据文件
-
C. 日志文件
-
D. 数据字典
答案与解析
平台答案:C。
整理解析
选 C。先写日志使恢复过程能够知道哪些修改已经发生,并按恢复策略重做或撤销。严格的预写日志规则要求:对应日志先持久化,才可将修改后的数据页写入持久存储;提交记录也须按持久性要求处理。不能只把日志暂存在易失缓冲区就认为已经满足该规则。平台未提供解析,本说明为独立推导。
题目 002
来源:知识点练习「数据库系统」第 2 题(原站入口)。
为保证数据库数据安全、可靠且有效,事务对插入、删除和修改的相关内容先写入(1);系统正常工作时,再按一定时间间隔把数据库缓冲区内容写入(2)。发生故障后,使用现场数据及相关文件恢复系统状态。
请作答:第 2 题。
-
A. 索引文件
-
B. 数据文件
-
C. 日志文件
-
D. 数据字典
答案与解析
平台答案:B。
整理解析
选 B。数据库缓冲区中的修改页最终要写回持久的数据文件;日志文件记录恢复所需的变更信息,职责不同。题目的定时写回是简化描述,实际系统还可能因缓存压力、检查点等触发刷页,也不一定在一次检查点中刷清全部缓冲区。该材料两小问均无平台解析。
题目 003
来源:知识点练习「数据库系统」第 3 题(原站入口)。
多个事务并发运行时,一个事务的更新从开始到成功提交之前,对其他事务保持不可见。按事务性质分类,这体现什么( )?
-
A. 原子性
-
B. 一致性
-
C. 隔离性
-
D. 持久性
答案与解析
平台答案:C。
整理解析
选 C。限制其他事务看见本事务尚未提交的中间结果,体现隔离性。原子性强调事务整体完成或整体撤销,持久性强调提交后结果不丢失。限定:实际数据库允许不同隔离级别,读未提交可能读到未提交数据,不能把题述保证套用于所有隔离配置。
题目 037
来源:知识点练习「数据库系统」第 37 题(原站入口)。
当前T1在D1上持有共享锁,T2在D2上、T3在D3上分别持有排他锁。在这些锁未释放时,T1的加锁情况为(37),T2的加锁情况为(38)。
请作答:第 37 题。
-
A. D2、D3加排它锁都成功
-
B. D2、D3加共享锁都成功
-
C. D2加共享锁成功,D3加排它锁失败
-
D. D2、D3加排它锁和共享锁都失败
答案与解析
平台答案:D。
整理解析
选 D。D2、D3分别被其他事务的排他锁占用,均与T1申请的共享锁、排他锁不兼容。因此T1的四种申请都不能立即获准。选项所谓“失败”应按当前不能授予理解,具体DBMS也可能让事务排队等待,并不必然立即报错或中止。
题目 038
来源:知识点练习「数据库系统」第 38 题(原站入口)。
当前T1在D1上持有共享锁,T2在D2上、T3在D3上分别持有排他锁。在这些锁未释放时,T1的加锁情况为(37),T2的加锁情况为(38)。
请作答:第 38 题。
-
A. D1、D3加共享锁都失败
-
B. D1、D3加共享锁都成功
-
C. D1加共享锁成功,D3加排它锁失败
-
D. D1加排它锁成功,D3加共享锁失败
答案与解析
平台答案:C。
整理解析
选 C。T2申请D1共享锁时,与T1已有共享锁相容;申请D3排他锁时,与T3已有排他锁冲突。纠错:本题平台答案字段为C,解析末尾却沿用了第37题的“选D”,该结尾不适用于本小问。
题目 064
来源:知识点练习「数据库系统」第 64 题(原站入口)。
事务T1已对D1加共享锁,T2、T3分别对D2、D3加排它锁。在这些锁仍持有时,以下加锁结果哪项正确?( )
-
A. T1对数据D2D3加排它锁都成功,T2T3对数据D1加共享锁成功
-
B. T1对数据D2D3加排它锁都失败,T2T3对数据D1加排它锁成功
-
C. T1对数据D2D3加共享锁都成功,T2T3对数据D1加共享锁成功
-
D. T1对数据D2D3加共享锁都失败,T2T3对数据D1加共享锁成功
答案与解析
平台答案:D。
整理解析
共享锁之间兼容,排它锁与其他事务的共享锁、排它锁都不兼容。因此T1不能立即获得D2、D3上的共享锁,而T2、T3可在D1已有共享锁时再加共享锁,选D。选项“失败”表示当前不能获准,实际系统通常可让请求等待。
题目 070
来源:知识点练习「数据库系统」第 70 题(原站入口)。
事务已COMMIT,但更新的数据页可能仍在服务器磁盘缓冲区、尚未写入磁盘;此后即使系统故障,已提交结果仍应保留。这是哪项事务性质?( )
-
A. 原子性
-
B. 一致性
-
C. 隔离性
-
D. 持久性
答案与解析
平台答案:D。
整理解析
提交后的结果能够在故障恢复后保留,属于持久性,选D。数据页可稍后刷盘,但提交前必须依赖已持久化的日志或其他可靠机制保存恢复所需信息,仅留在易失缓冲区并不能保证持久性。平台把提交前修改始终对其他事务不可见当作通用隔离定义也过于绝对,具体可见性取决于隔离级别。
题目 096
来源:知识点练习「数据库系统」第 96 题(原站入口)。
事务程序A计算表达式x/y;已知y=0会使该表达式计算失败,这属于哪类故障?( )
-
A. 系统故障
-
B. 事务故障
-
C. 介质故障
-
D. 死机
答案与解析
平台答案:B。
整理解析
这是事务内部计算引起的事务故障,选B,通常需中止并回滚该事务。平台把错误称为“被除数为0”写反了:y是除数,问题是除数为0;被除数x为0且除数非零并不会因此出错。
章节回顾
(1)了解数据库模式、了解分布式数据库、数据仓库等相关扩展知识。
(2)了解数据库设计过程。熟悉E-R图图示,掌握E-R图转关系模式的原则。
(3)掌握关系代数(并、交、差、笛卡尔积、投影、选择、自然连接)。
(4)熟悉函数依赖、部分函数依赖、传递函数依赖等概念,熟悉候选码\候选键、主码\主键、外键的概念,掌握候选码的求取,区分主属性和非主属性概念。
(5)了解规范化相关的问题描述和作用,掌握1NF、2NF、3NF、BCNF的判断区分。
(6)掌握模式分解对于无损、保持函数依赖的判断。
(7)了解常用的SQL语言语法,比如select用法。
(8)了解事务的特性、事务并发可能产生的问题、封锁协议(S锁和X锁)。
(9)了解数据完整性分类(实体完整性、参照完整性、用户自定义完整性等(原回顾首项“数据完整性”应为“实体完整性”))。
解题关键词与检查顺序
关键词用于定位考点,最终仍要检查前提:
| 题干信号 | 优先想到 | 必须补的判断 |
|---|---|---|
| 视图/基本表/文件 | 外/概念/内模式 | 按题干次序配对 |
| 存储改变、聚簇索引 | 物理独立性、内模式 | 映射是模式↔内模式 |
| 多维、上卷、下钻 | OLAP | 区别日常 OLTP 与 ETL 装载 |
| 局部模型合并 | E-R 冲突 | 名字、属性域还是结构不同 |
| 列号与自然连接 | 先写输出属性顺序 | 同名列全部相等并去重,再解释列号 |
| 候选码 | 属性闭包 | 覆盖全部属性且最小,列出所有候选键 |
| 第二范式 | 非主属性、部分依赖 | 检查所有候选键,而非只检查主键 |
| 第三范式/BCNF | 非平凡函数依赖 | 先判左部超键;3NF 还可允许右部为主属性 |
| 保持依赖 | 各子模式投影依赖的并集 G | 对每条原 X→Y 求 X⁺(在 G 下) |
| 无损分解 | 先看属性是否覆盖 U | 二元才直接用交集决定一边的判据,多元需逐步证明或 chase |
| 至少几个项目/不同对象 | COUNT(DISTINCT ...) | HAVING 筛选组,不能按明细行冒充对象数 |
| 并发异常 | 按时间记录局部读值与数据库写值 | 提交状态、覆盖关系、第二次读取结果 |
| S/X 锁 | S-S 相容,其余不相容 | 相同对象、不同事务,结合持锁时长 |
依赖保持与无损是两个独立维度;“规范化后范式更高”不能替代这两项证明。对二元分解 R→R1,R2,必须先满足 R1∪R2=R,再检查 (R1∩R2)→R1 或 (R1∩R2)→R2 是否属于 F⁺。
课件来源
来源:《【2026版本】软件设计师考试精讲班视频教程讲义电子版》,希赛网。下列课件由 Obsidian Web Clipper 提取;本篇在原材料基础上整理并补充解析。
| 课件 | chapterId | 原图数量 |
|---|---|---|
| 课程内容提要 | 161777 | 1 |
| 数据库体系结构 | 161779 | 2 |
| 数据仓库 | 161780 | 1 |
| 数据库设计 | 161781 | 15 |
| 关系代数 | 161782 | 8 |
| 规范化理论 | 161783 | 8 |
| SQL语言 | 161784 | 2 |
| 并发控制 | 161785 | 6 |
| 章节回顾 | 161786 | 0 |
图片来源、原链接、尺寸与 SHA-256 见本地图片清单。原课件中的第三方品牌/网站导航已移除。